
به اسامی افرادی که در اطرافتان هستند توجه کنید؛ احتمالا هرکدامشان داستانی کاملا مجزا و جالب دارند. بعضی از پدرها و مادرها اسم فرزند خود را از داستانهای اساطیری انتخاب میکنند (سهراب، رستم و ...)، برخی دیگر از اسامی ائمه (ع) و الگوهای مذهبی (فاطمه، علی، محمد و ...)، برخی براساس روز یا ماه تولد فرزندشان (مهرداد و تیرداد و ...) و برخی هم از اسامی ترکیبی.
همه سناریوهای محتمل مانند سناریوهای توصیفشده در بالا نشانگر این هستند که اسم اشخاص به نظر یک تابع تصادفی از تجربیات، سلایق و دیگر خصوصیات شخصی والدین و یا عوامل محیطیست و طبیعتا نباید الگوی مشخصی در آن وجود داشته باشد. در واقع به نظر میرسد پدر و مادر کاملا آگاهانه و براساس ترجیحات خود اسم فرزندشان را انتخاب میکنند.
در این متن میخواهم این تلنگر را بزنم که شاید این آگاهی و انتخاب توهمی بیش نباشد و توزیع اسامی افراد از یک الگوی کاملا تعینی و قوی پیروی کند. تمرکز من در این مسئله روی توزیع فراوانی اسامی در یک جامعه دلخواه است؛ به این معنا که برای مثال در یک بازه زمانی مشخص (مثلا یک سل) چه تعداد از نوزادان به یک اسم مشخص نامگذاری شدهاند. برای این منظور با مراجعه به دادههای گزارششده از سوی سازمان ثبت احوال توانستم داده مربوط به فراوانی اسمهای نوزادان پسر و دختر در سالهای مختلف را بهدست آورم.
ابتدا نگاهی داشته باشیم به نمودار خام این دادهها:
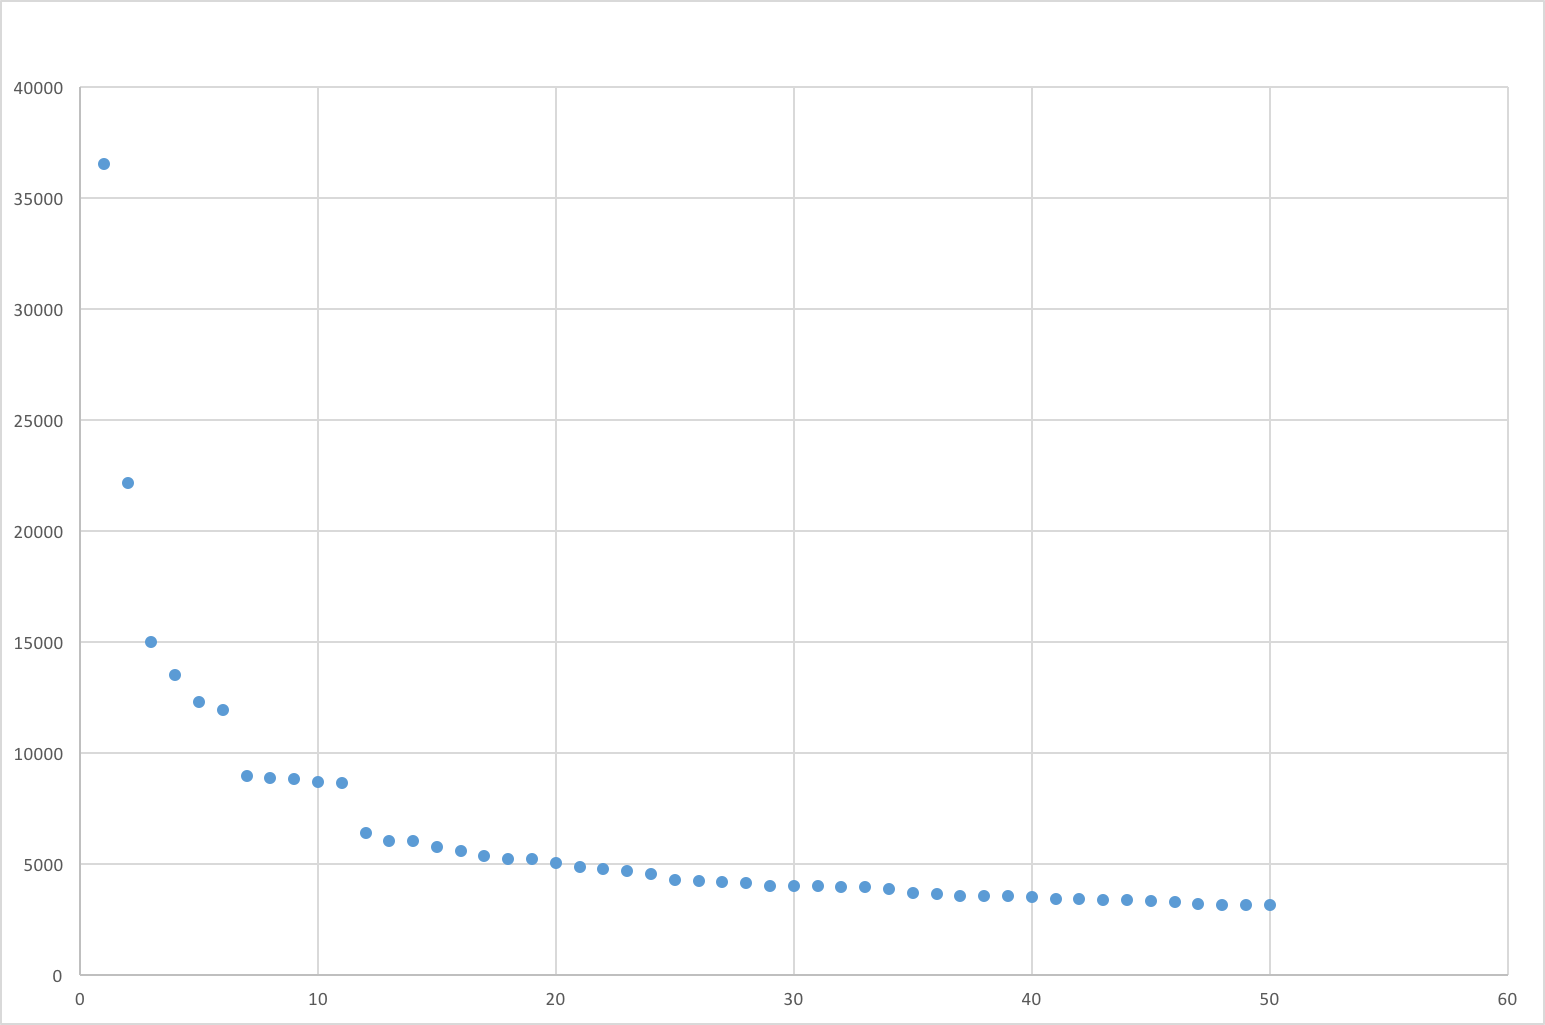
محور عمودی در نمودار بالا تعداد تکرار یک اسم و نمودار افقی رتبه آن اسم در بین اسامی پرتکرار را نشان میدهد. نمودار بالا از داده ۵۰ اسم برتر دختران در سال ۱۳۹۶ تهیه شده است. برای مثال رتبه اول در سال ۱۳۹۶ برای اسم فاطمه با تعداد ۳۶۵۳۹ نفر ثبت شده، در نتیجه یک نقطه با مختصه افقی ۱ و مختصه عمودی ۳۶۵۳۹ در نمودار دیده میشود.
در نگاه اول در نمودار بالا الگوی مشخصی نمیتوان مشاهده کرد اما اگر از هر دو داده بالا (تعداد و رتبه) لگاریتم بگیریم به نمودار زیر میرسیم:
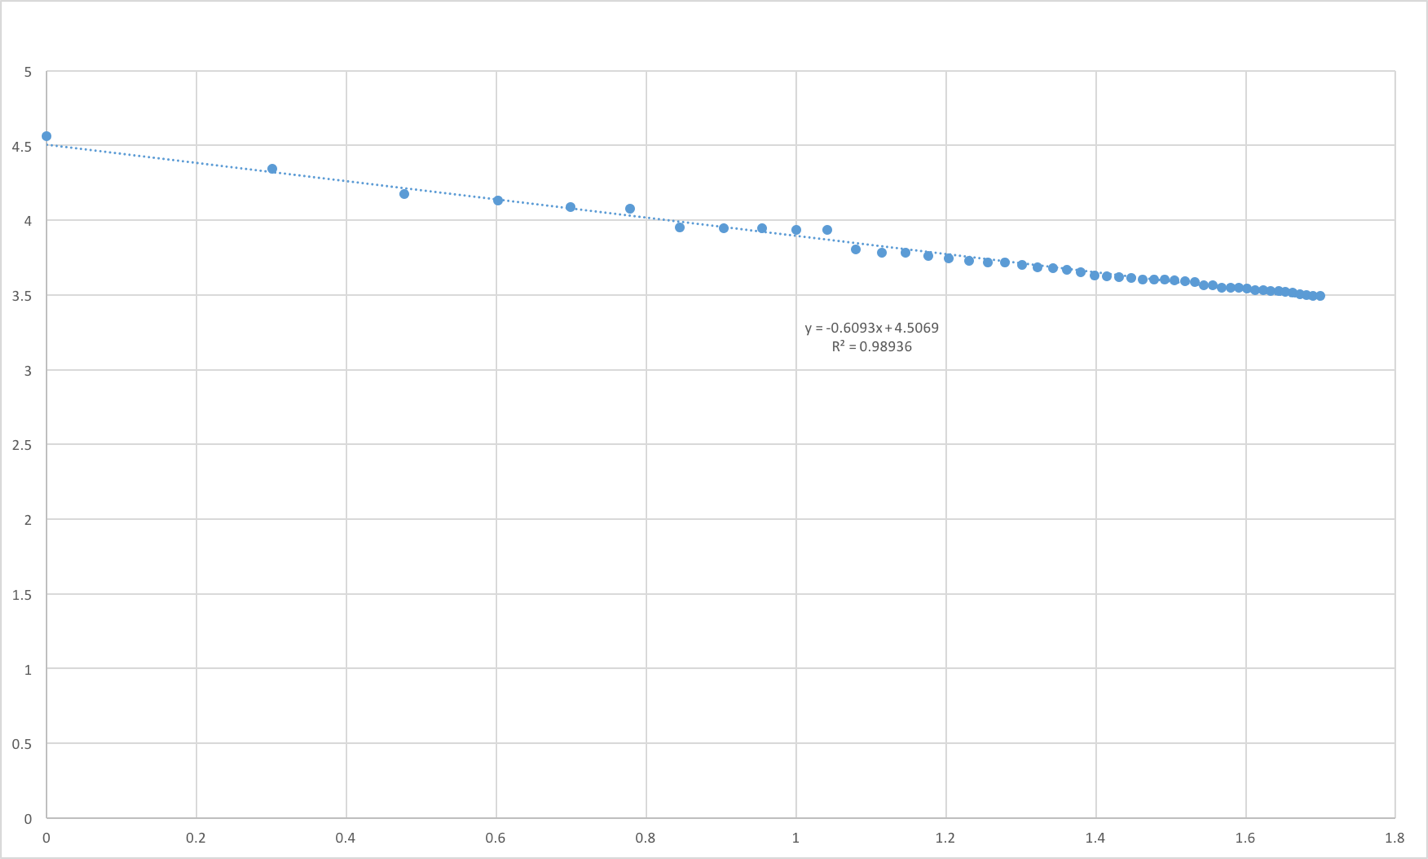
همانطور که مشاهده میکنید یک رابطه خطی بسیار تمیز و دقیق بین لگاریتم فراوانی و لگاریتم رتبه در اسامی دختران سال ۱۳۹۶ وجود دارد. این رابطه حکایت از آن دارد که بین تعداد افراد دارنده یک اسم و رتبه آن اسم یک رابطه توانی برقرار است.
اما آیا این رابطه فقط محدود به دختران یا محدود به سال ۱۳۹۶ است؟
به نمودارهای زیر توجه کنید:
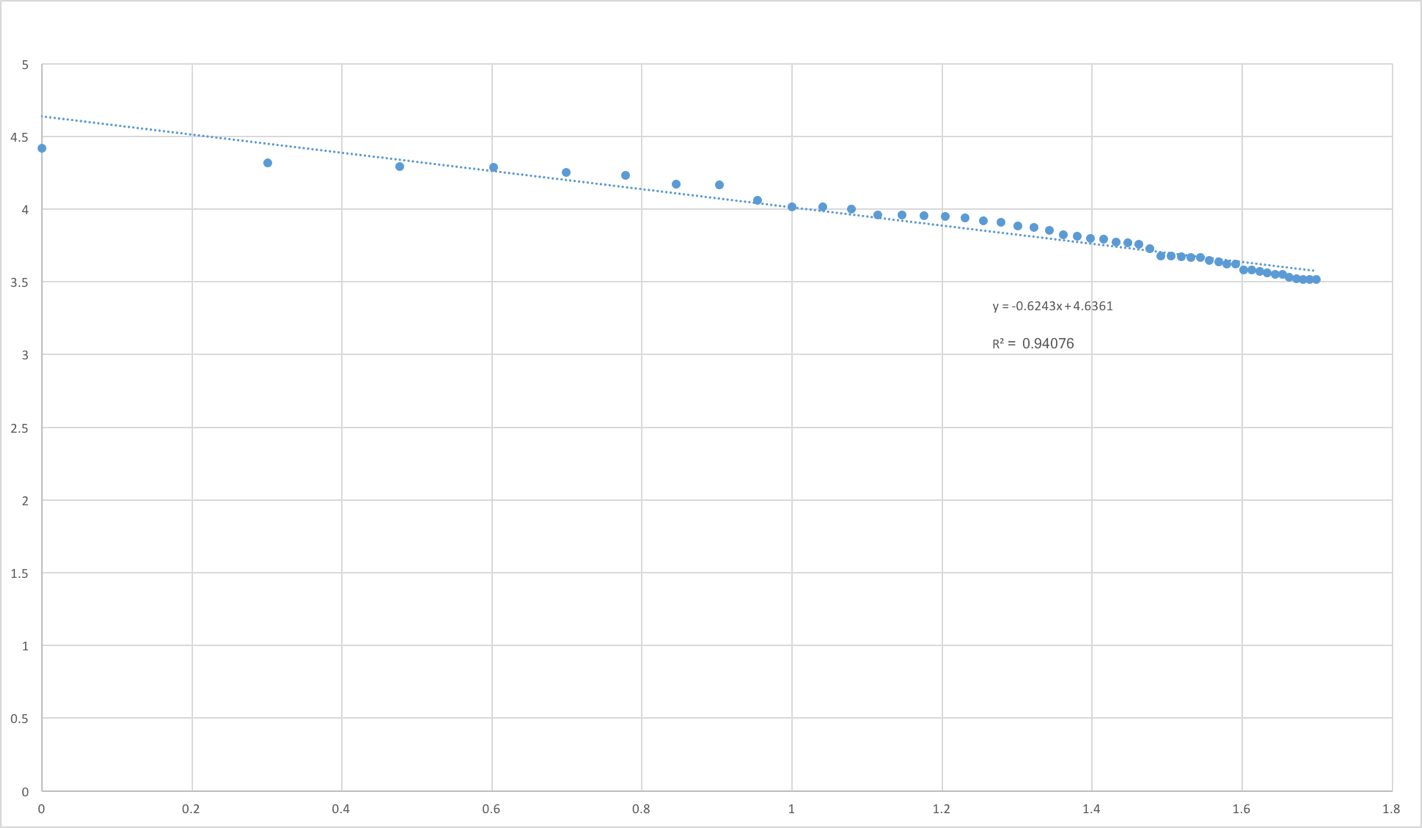
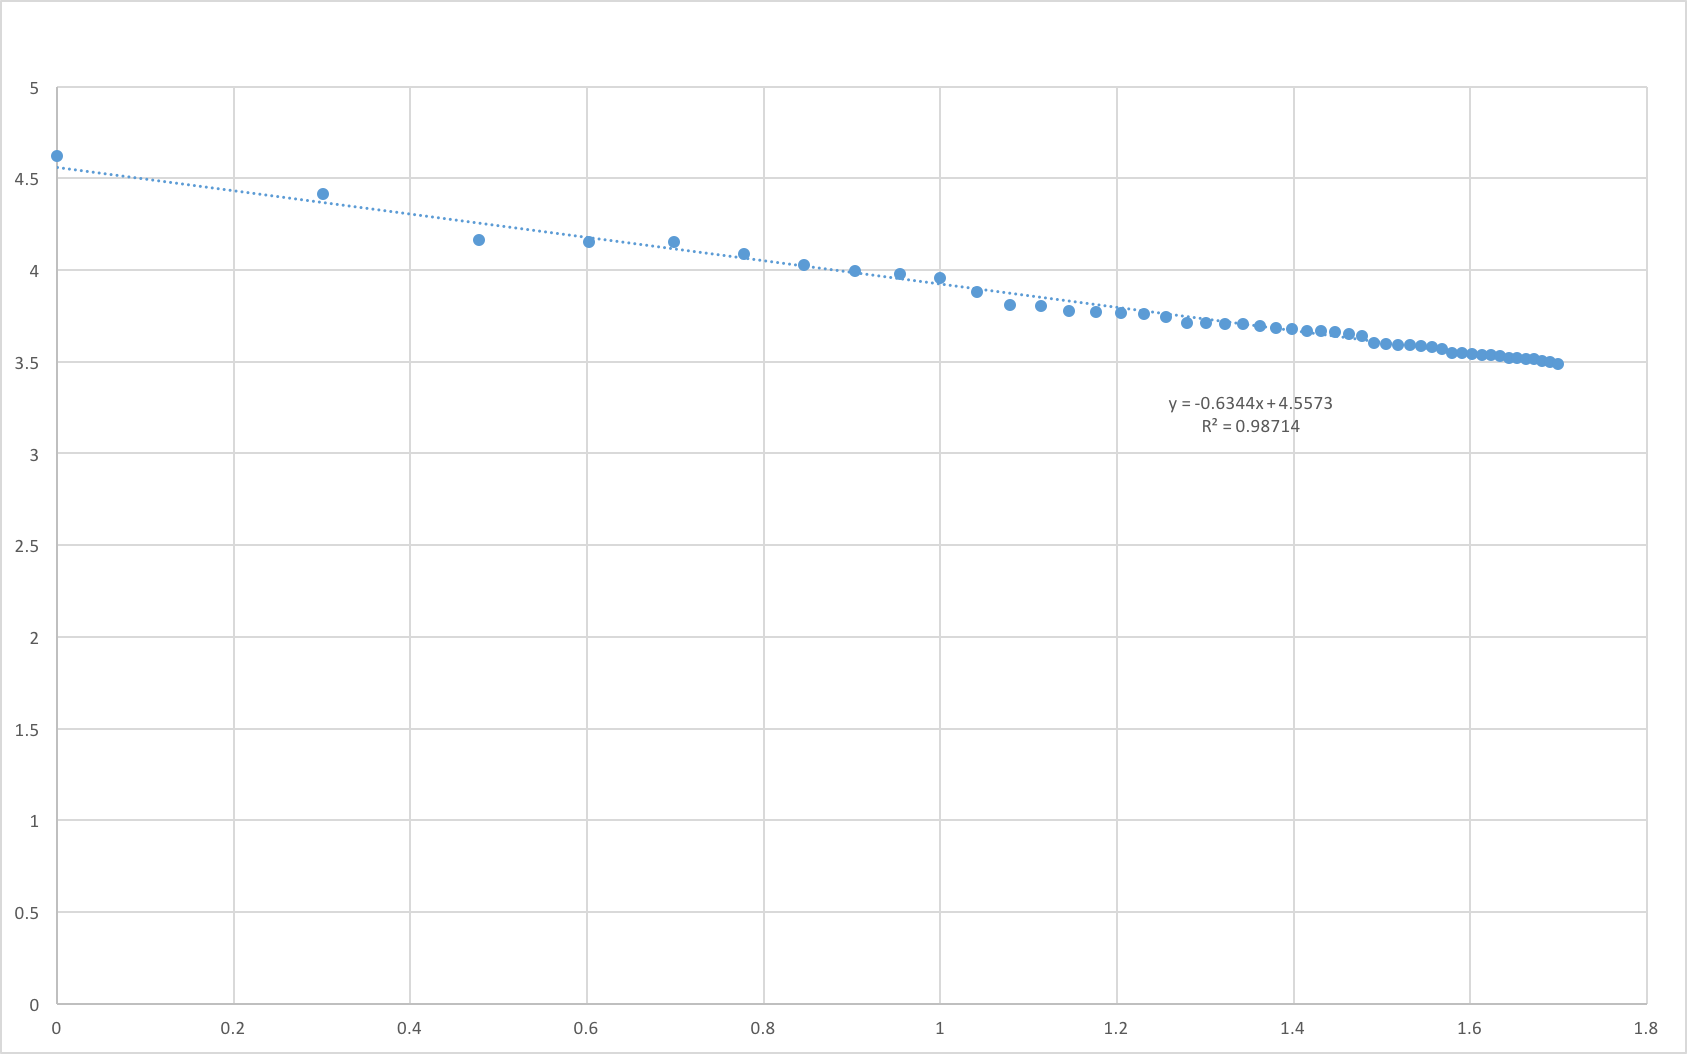
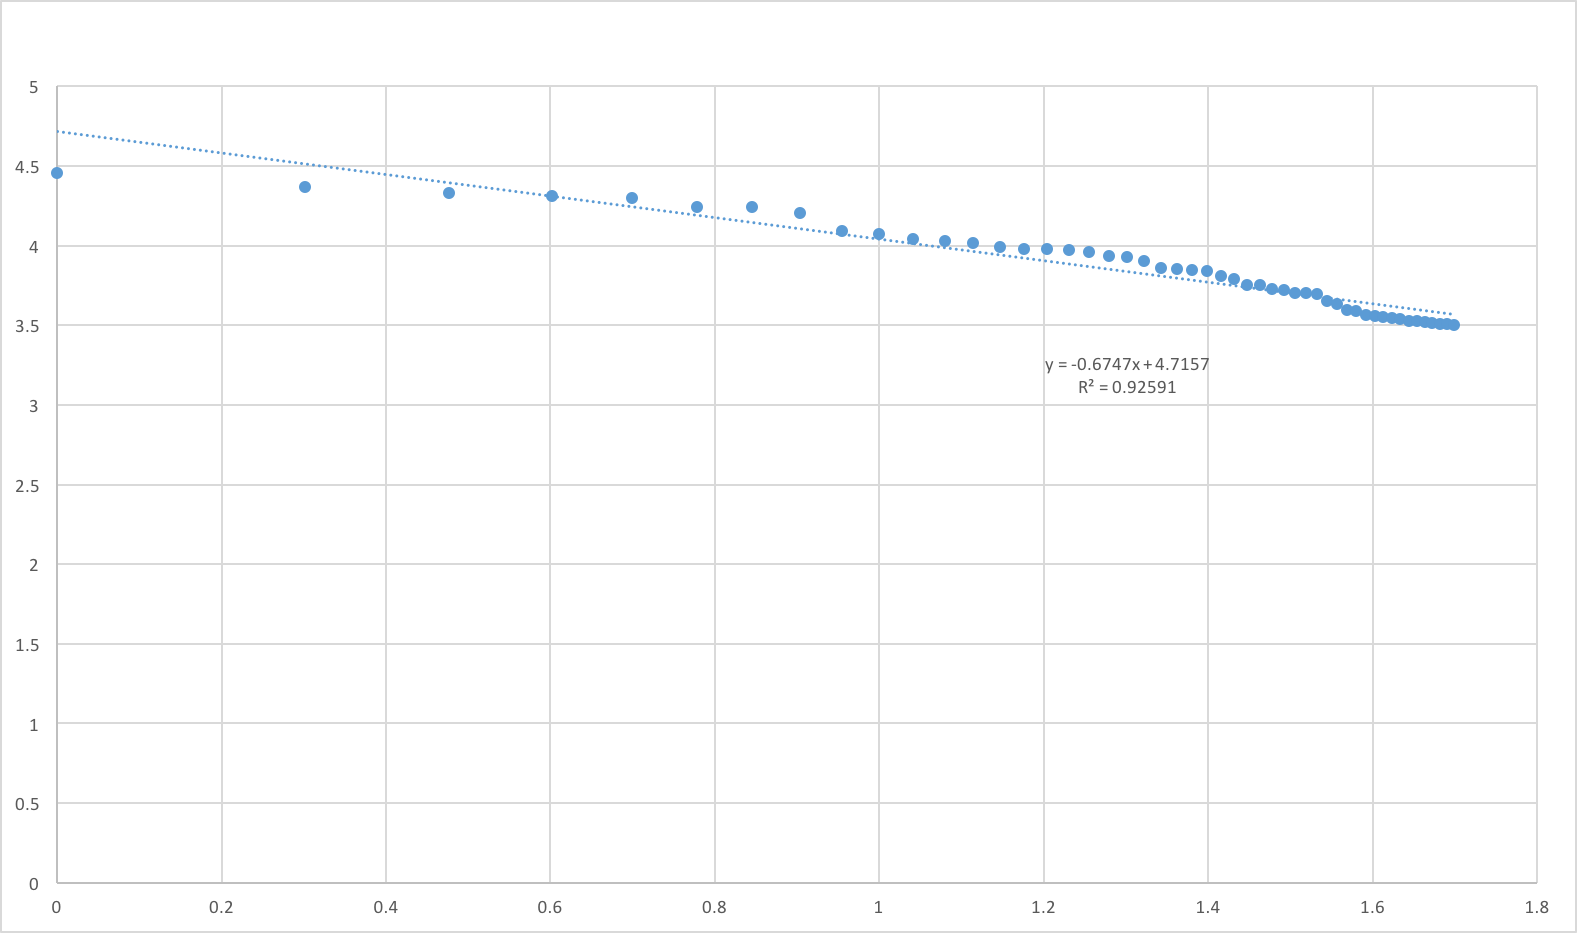
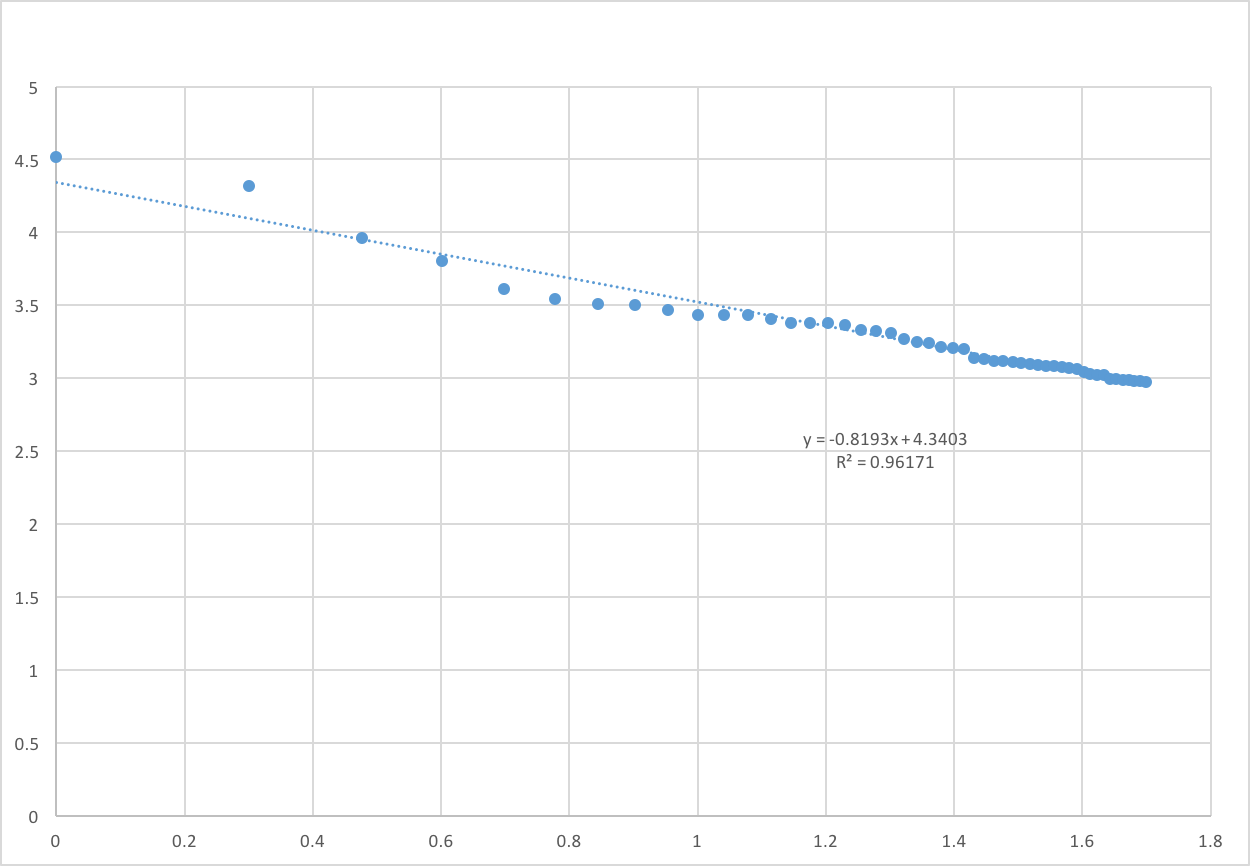
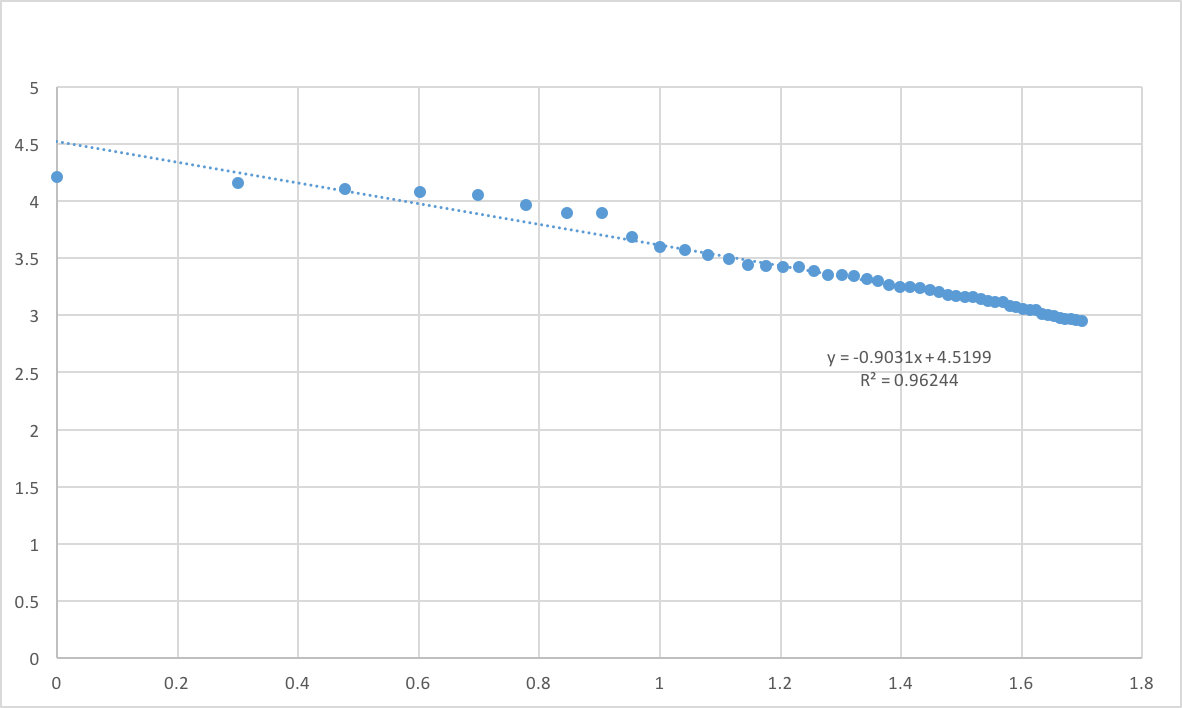
همانطور که مشاهده میکنید این الگو در هردو جنس و حتی در سال ۱۳۸۰ نیز معتبر و درست به نظر میرسد. شگفتانگیز است که چنین رابطه دقیقی بر تابع توزیع اسامی یک جامعه وجود داشته باشد؛ مسئلهای که در نگاه اول کاملا بدون قاعده و تصادفی به چشم میآید.
رابطه بالا از این نظر نیز جالب است که با توجه به معادله بهدستآمده میتوان تعداد نسبتا دقیق افرادی را که در یک جامعه دارای اسم خاصی هستند، پیشبینی کرد؛ مسئلهای که تصمیم مستقل و منحصربهفرد والدین یک نوزاد برای انتخاب اسم فرزندشان را کمی زیر سوال میبرد. اما چهطور چنین الگویی در چنین مسئله عجیبی شکل گرفته است؟
محبوبیت محبوبیت میآورد
میتوان توانی بودن تابع توزیع اسامی را با استدلالی مناسب اثبات کرد اما این اثبات از حوصله این بحث خارج است و در اینجا سعی میکنم استدلال را به صورت کیفی تا حد امکان بسط دهم. مسئله را میتوان با ضربالمثل معروف «هر که بامش بیش، برفش بیشتر» شروع کرد. والدین چهطور اسم فرزندشان را انتخاب میکنند؟
هنگام نامگذاری در ذهن پدر و مادر مجموعهای از اسامی وجود دارد که قرار است از بین آنها اسم فرزند انتخاب شود. این اسامی برگرفته از نامهاییست که پدر و مادر در زندگی خود با آنها مواجه شدهاند؛ اسمی که هرگز آن را نشنیدهاند، امکان حضور در مجموعه اسامی ذهن آنها را ندارد، مگر در حالات بسیار نادر.
اگر در یک جامعه یک اسم به هر دلیلی در یک زمان پرطرفدار باشد، افراد آن جامعه با دفعات بیشتری با آن اسم مواجه میشوند و در فضای ذهنیشان این اسم برجستهتر میشود و در نتیجه «احتمال» انتخاب این اسم از سوی آنها نیز افزایش پیدا میکند. پس اسامی پرطرفدار بیشتر انتخاب میشوند و محبوبیتشان بیشتر هم میشود. دلیل ابتدایی محبوبیت یک اسم میتواند ارادت خاص یک جامعه به نام یک الگو یا قهرمان ملی مذهبی باشد اما مکانیزمی که این تابع توزیع را به سمت تابع توزیع توانی میل میدهد، همان مکانیزمیست که در بالا توضیح داده شد.
اگر به نمودار سال ۱۳۸۰ و ۱۳۹۶ دقت کنید، میبینید که شیب خط در سال ۱۳۸۰ نسبت به سال ۱۳۹۶ به میزان قابلتوجهی بیشتر است. شاید دلیل این اتفاق این باشد که در سال ۱۳۸۰ هنوز شبکههای مجازی و اینترنت مانند این روزها گسترش پیدا نکرده بود و روابط افراد محدود به جوامع محلی و نزدیکان خود بوده است. در نتیجه اثر تکرار یک اسم در ذهن افراد شدیدتر از سال ۱۳۹۶ به نظر میرسد.
شاید شنیده باشید که ۸۰ درصد ثروت جهان در دست ۲۰ درصد پولدار جامعه است. در بین اسامی هم در سال ۱۳۹۶، اسامی فاطمه، زهرا، حلما، زینب و یسنا حدود ۳۰ درصد جمعیت نوزادان دختر سال را تشکیل دادهاند. این شباهت از آنجاست که در مسئله درآمد و دارایی افراد نیز، افرادی که دارایی بیشتری دارند، تواناییشان برای افزایش دارایی هم بیشتر خواهد بود.

