
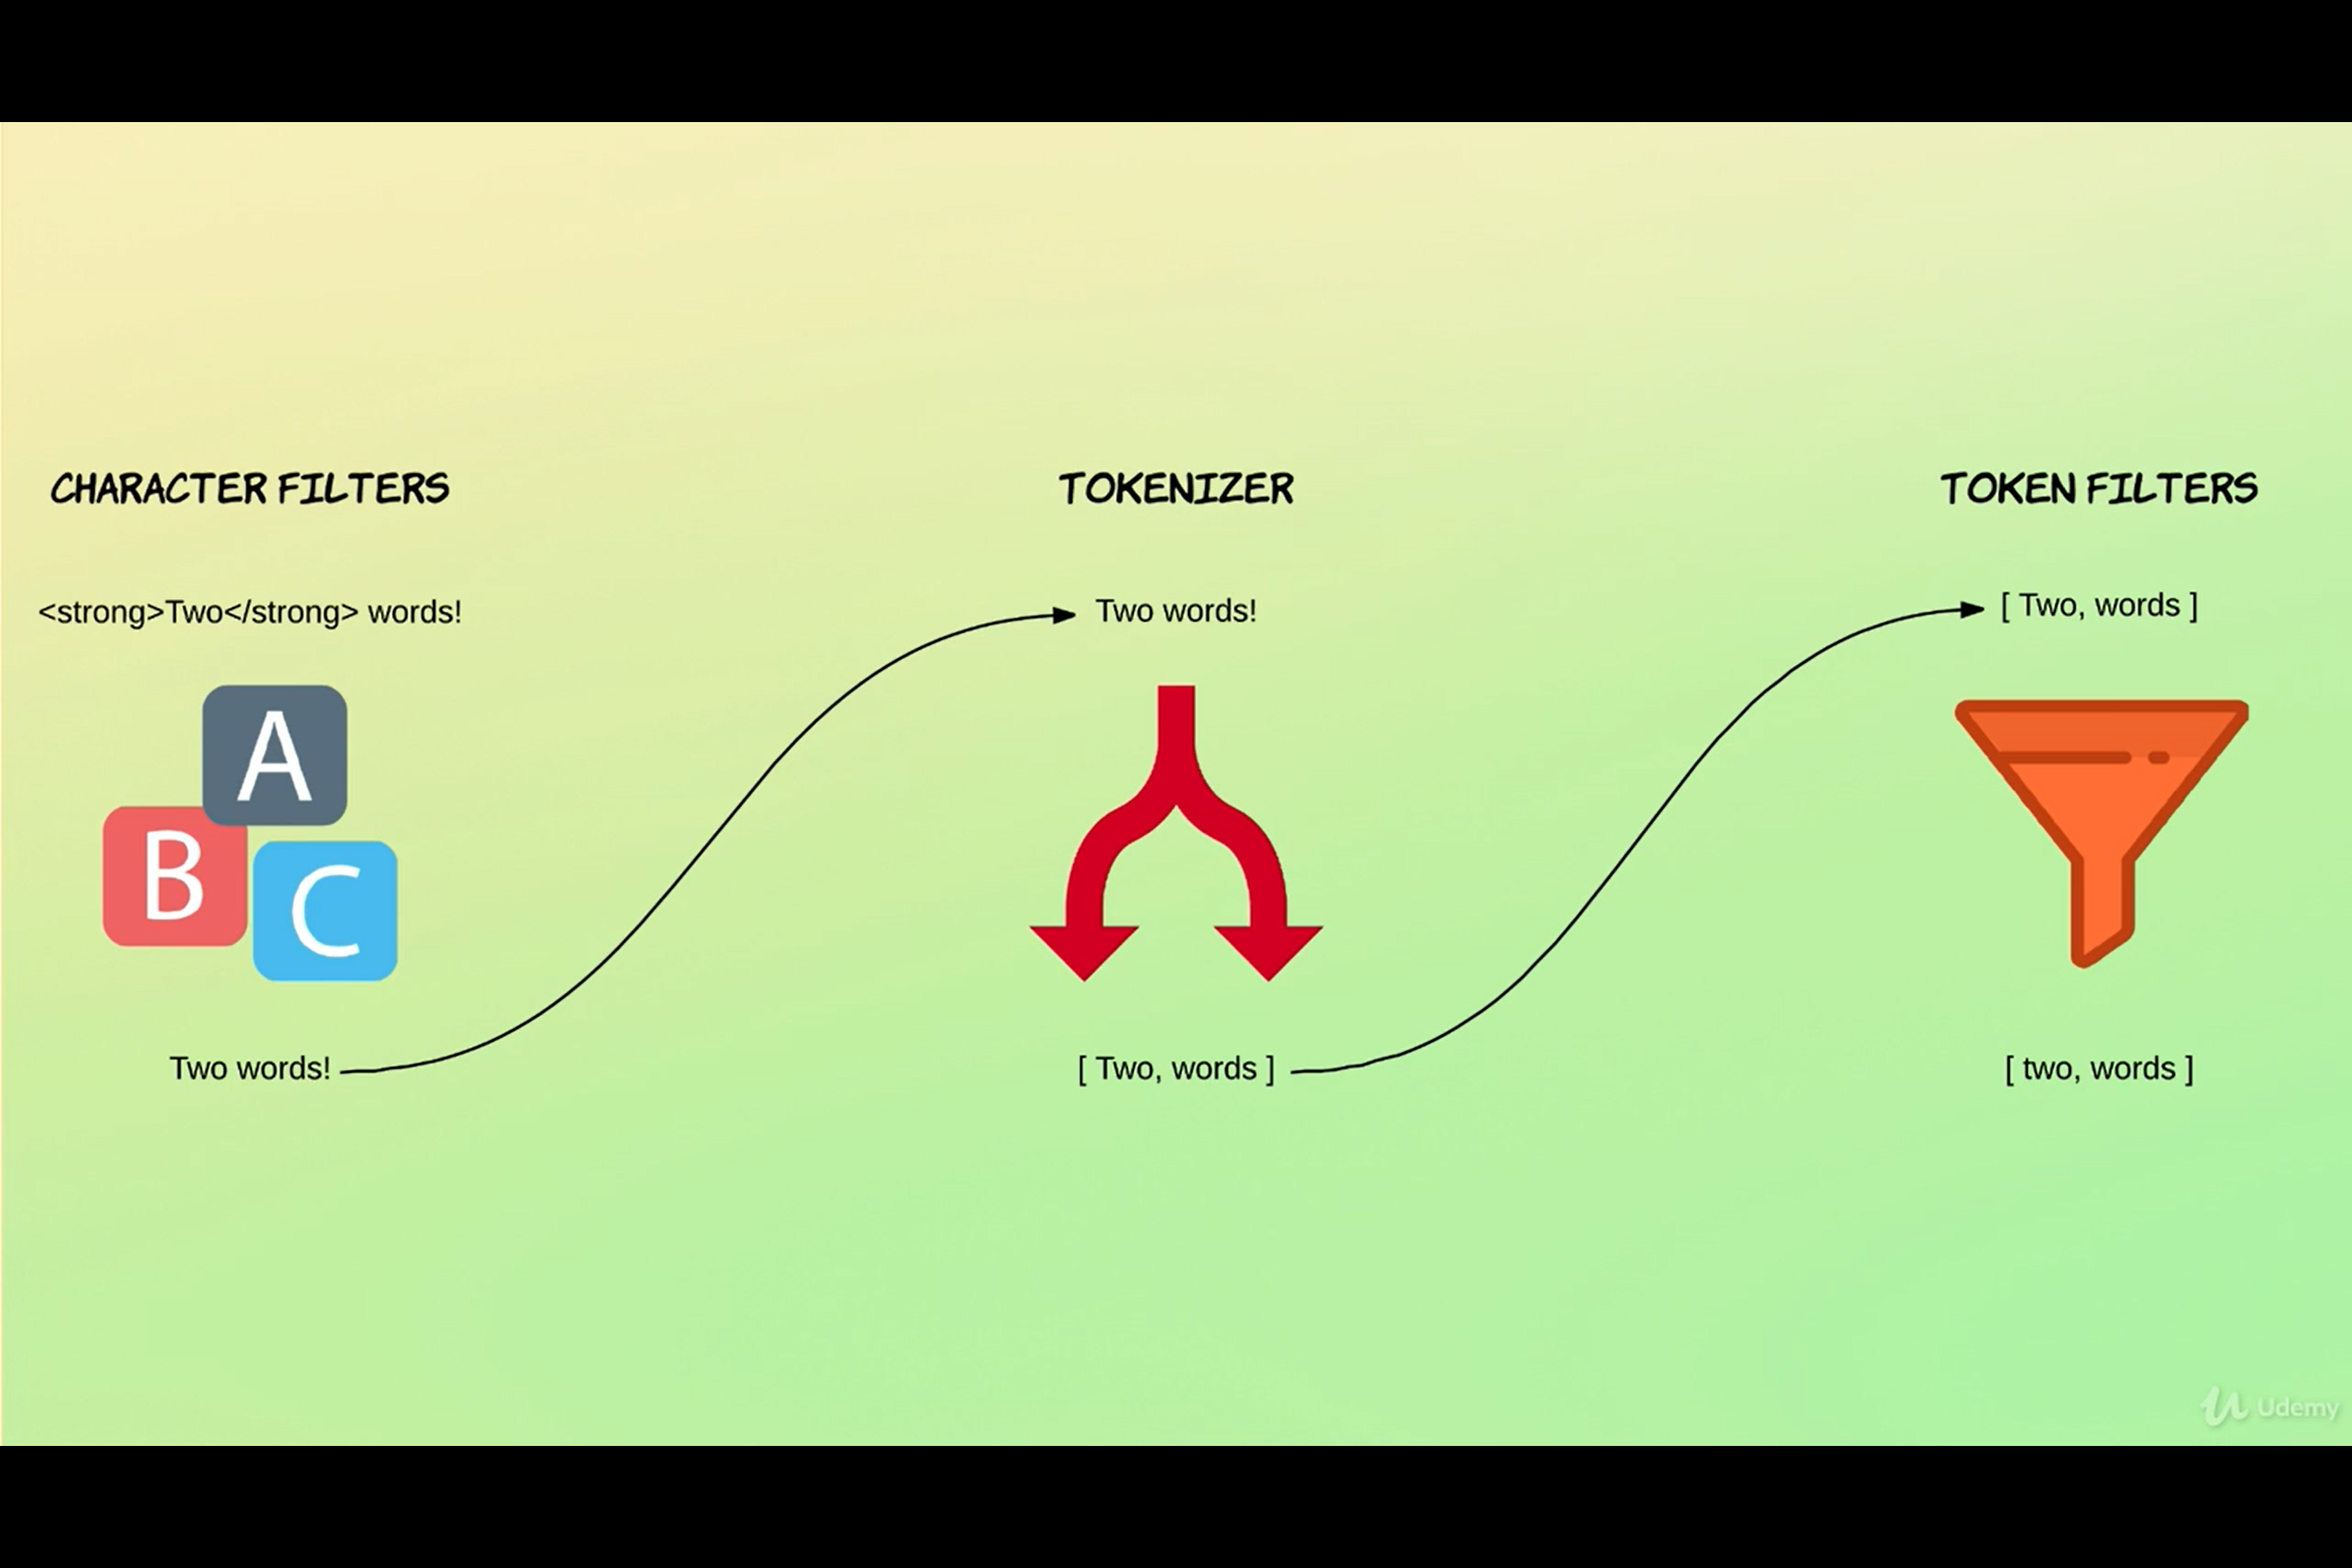
inverted index:
Elasticsearch از ساختاری به اسم inverted index استفاده می کند.این ساختار برای سریعتر انجام دادن عمل full-text search ایجاد شده است. inverted index شامل تمام کلمات به همراه documentی است که در آن وجود دارد.برای مثال دو جمله زیر را در نظر بگیرید
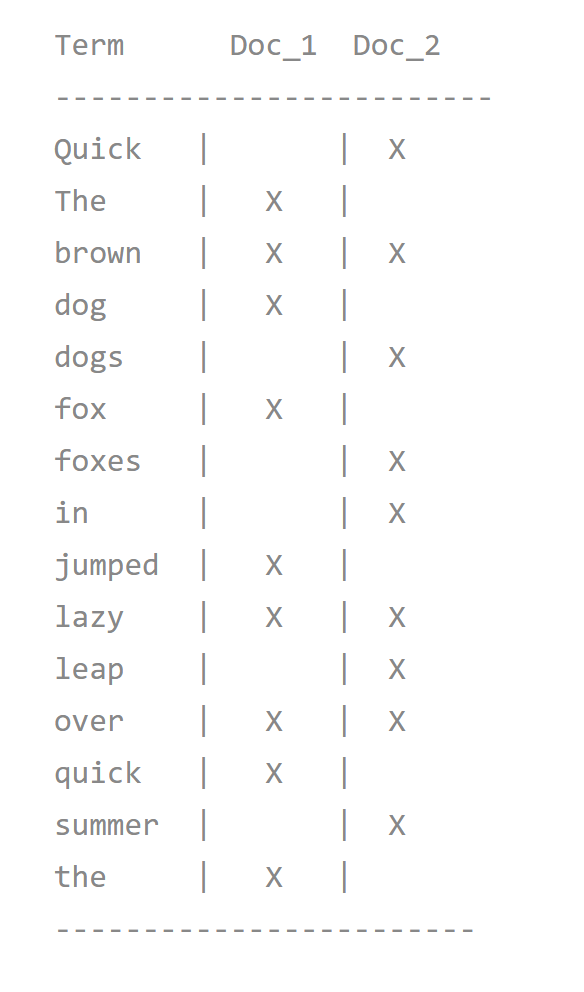
حالا اگر کلمه quick brown برای جستجو به elastic-search ارسال شود با دو داکیومنت به صورت زیر مچ می شود.
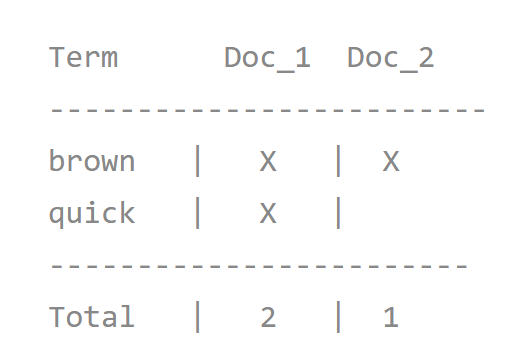
دو داکیومنت بالا مچ می شود ولی داکیومنت اولی بیشتر مچ هست ولی در حال حاضر داری مشکلاتی هستیم:
با توجه به مشکلات بالا +Quick +fox نمیتواند با داکیومنت خاصی مچ شود.
نکته:"+" به معنای این است که کلمه حتما در داکیومنت وجود داشته باشد.
quick fox و Quick foxes در دو داکیومنت وجود دارد ولی با توجه به کلمه بالا با هیچ داکیومنتی مچ نمی شود.
اگر ما کلمات را normalize کنیم در این صورت ممکن است که درخواست کاربر با چیزی که واقعا در ایندکس وجود دارد یکسان نباشد ولی می تواند درخواست کاربر را مچ کند.
با این تفاسیر اگر در کلمات تغییرات زیر اعمال شود جستجو می تواند بهتر انجام شود:
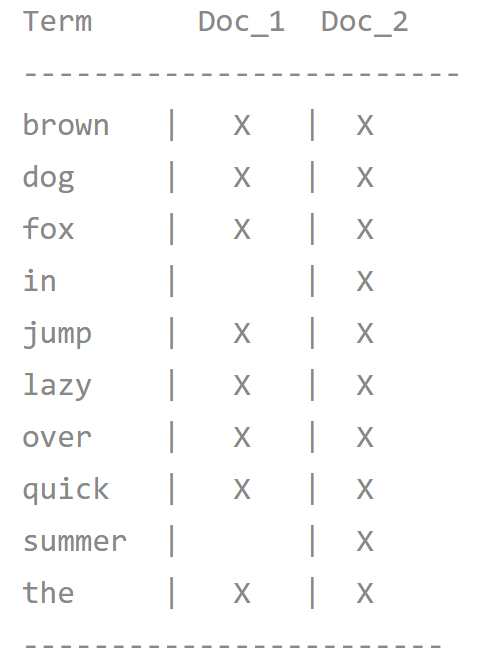
همچنان کوئری +Quick +fox جواب نمیدهد ولی +quick +fox
This process of tokenization and normalization is called analysis, which we discuss in the next section.
Character filter:حذف اضافه و یا تغییر کاراکتر های را Character filter می گویند.برای مثال حذف htmlاز متن و همچنین تغییر کاراکتر های عربی و فارسی به انگلیسی(اعداد)
Tokenizer:شکستن جمله به توکن های مجزا که معمولا اشاره به کلمات دارد.
Token filter:گرفتن توکن ها از فاز Tokenizer و همچنین انجام lowercasing و حذف stopwords و اضافه کردن مواردی مثل synonyms و ...
نکته این امکان وجود دارد که از analyzing api به صورت مجزا استفاده کنیم.
Analyzers
Elastic search به همراه تعداد زیادی Analyzers آماده عرضه می شود:
نکته:امکان اضافه کردن Analyzers برای یک ایندکسی که از قبل وجود دارد و در آن داکیومنت ذخیره شده است وجود دارد.فقط باید به این نکته توجه داشت که برای اینکه داکیومنت هایی که از قبل موجود هستند اصلاح شوند نیاز است مجدد ایندکس شوند.
نکته:بهتر است که stop word ها در فرایند Tokenizer حذف نشوند. قبل تر این کار برای گرفتن نتیجه بهتر انجام می شد ولی امروزه با توجه به وجود الگوریتم های مناسب در elastic search پیشنهاد نمی شود.

