
در دنیای یادگیری ماشین، رگرسیونها یکی از ابزارهای مهم هستند که برای مدلسازی و پیشبینی متغیرهای پیوسته استفاده میشوند. این الگوریتمها انواع گوناگونی دارند که هرکدام ویژگیها و محدودیتهای خاص خود را دارند. در این مقاله، به بررسی انواع رگرسیونها در دنیای یادگیری ماشین میپردازیم.
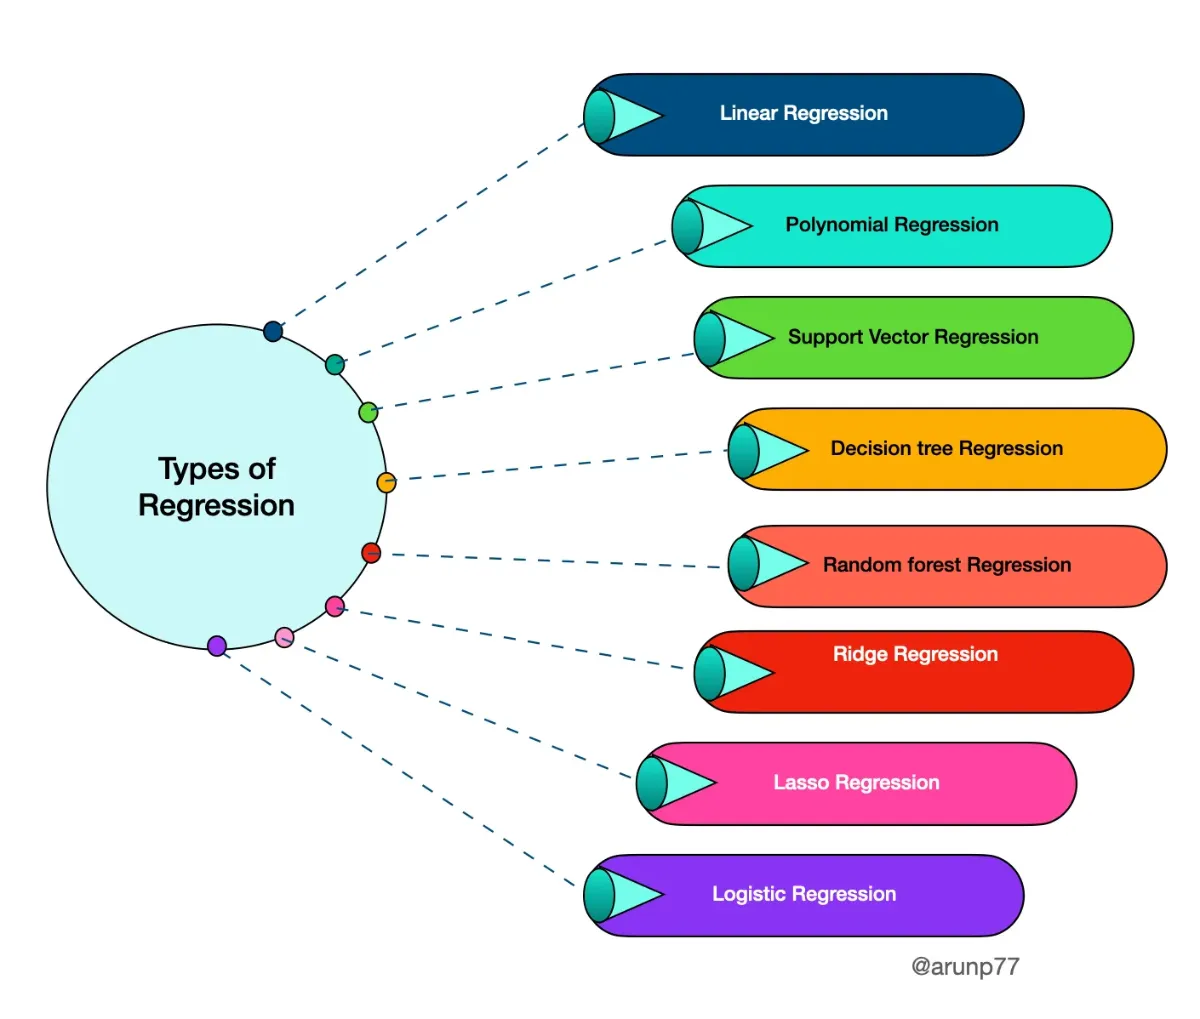
رگرسیون خطی یکی از سادهترین و پراستفادهترین الگوریتمهای رگرسیون است. در این روش، ارتباط خطی بین ویژگیهای ورودی و متغیر پیشبینی شده بررسی میشود. الگوریتم سعی دارد خطی بهترین متناسب با دادهها را پیدا کند.
در مواجهه با دادههایی که ارتباط غیرخطی دارند، از رگرسیون چندجملهای استفاده میشود. این روش از یک چندجمله درجه بالا برای مدلسازی ارتباط بین متغیرهای ورودی و خروجی استفاده میکند.
رگرسیون لجستیک برای مسائل دستهبندی بین دو گروه متفاوت استفاده میشود. با اعمال تابع لجستیک به ترکیب خطی از ویژگیها، احتمال تعلق به هر گروه محاسبه میشود.
رگرسیون Ridge و Lasso به منظور مدلسازی و کنترل برازش اضافی (overfitting) به کار میروند. این روشها از افزودن جملات جریمه به تابع هدف استفاده میکنند تا از اهمال پارامترهای غیرضروری جلوگیری کنند.
درخت تصمیم به صورت تجزیه و تحلیل درختی از قوانین تصمیم برای پیشبینی مقادیر پیوسته استفاده میشود. این روش یک ساختار درختی از تصمیم ایجاد میکند که به تفکیک متغیرهای ورودی به گروههایی که بهترین پیشبینی را دارند، میپردازد.
استفاده از شبکههای عصبی برای مسائل رگرسیون نیز شایع است. این روش با بهرهگیری از لایههای مختلف شبکه عصبی، توانایی بالایی در مدلسازی ارتباطات پیچیده و غیرخطی دارد.
در دنیای یادگیری ماشین، تنوع بسیاری از الگوریتمهای رگرسیون وجود دارد که هرکدام برای شرایط و ویژگیهای خاصی مناسب هستند. انتخاب رگرسیون مناسب بر اساس خصوصیات دادهها و مسئله مورد نظر، نقش اساسی در بهبود عملکرد مدل و دقت پیشبینیها دارد.
رگرسیون، به عنوان یکی از روشهای محبوب در یادگیری ماشین، اغلب با مدلسازی ارتباطات خطی میان ویژگیهای ورودی و متغیر پیشبینی شده مرتبط میشود. اما در بسیاری از مواقع، ارتباطات بین متغیرها به صورت غیرخطی هستند و نیاز به استفاده از روشهای رگرسیون غیرخطی را ایجاب میکنند. در این جا، سه نوع رگرسیون غیرخطی، یعنی رگرسیون درجه سوم، رگرسیون نمایی دوگانه، و رگرسیون سینوسی را معرفی میکنیم.
رگرسیون درجه سوم یکی از انواع پیشرفته رگرسیون غیرخطی است. در این روش، از یک چندجمله درجه سوم برای مدلسازی ارتباطات استفاده میشود. این چندجمله با توجه به دادههای ورودی، توانایی بهتری در تعیین الگوهای پیچیدهتر را دارد و میتواند از تغییرات غیرخطی در دادهها به خوبی عیبیابی کند.
رگرسیون درجه سوم با افزودن جملات پلینومیال به مدل، امکان نمایش روابط پیچیدهتری را فراهم میکند.
رگرسیون درجه سوم یکی از انواع رگرسیونهای غیرخطی است که از توابع چندجملهای درجه سوم برای تخمین مقادیر پیشبینی شده استفاده میکند. این نوع رگرسیون امکان مدلسازی ارتباطات غیرخطی و پیچیدهتری را نسبت به رگرسیونهای خطی ارائه میدهد.
مزایا:
چگونگی استفاده:
مثال عملی:برای فهم بهتر، مثالی از استفاده از رگرسیون درجه سوم را در پیش میبریم. فرض کنید میخواهیم رابطه بین زمان و تغییرات دما را مدل کنیم. با استفاده از رگرسیون درجه سوم، میتوانیم این رابطه را به نحوی دقیقتر مدل کنیم تا تغییرات پیچیدهتری که در زمان رخ میدهند را ارائه دهیم.
نکته:رگرسیون درجه سوم یک ابزار قدرتمند در دسته رگرسیونهای غیرخطی است که از توابع چندجملهای برای تقریب بهتر مدل استفاده میکند. با این که این نوع رگرسیون قدرتمند است، باید با دقت از آن استفاده شود و از بیشبرازش (Overfitting) جلوگیری شود.
رگرسیون نمایی دوگانه یک مدل پیشرفتهتر از رگرسیون نمایی است. در این روش، از یک تابع نمایی دوگانه برای مدلسازی استفاده میشود. این تابع قادر به نمایش ارتباطات غیرخطی با توانایی بالاست و میتواند به خوبی با تغییرات دادهها سازگاری یابد.
رگرسیون نمایی دوگانه یک روش پیشرفته در زمینه یادگیری ماشین است که برای مدلسازی ارتباطات پیچیده و غیرخطی بین متغیرها استفاده میشود. این نوع رگرسیون از توابع نمایی دوگانه به عنوان ابزار اصلی برای تخمین پارامترها و پیشبینی متغیر وابسته بهره میبرد. در این آموزش، به گامهای مدلسازی با رگرسیون نمایی دوگانه میپردازیم.
گام 1: تعریف مدل رگرسیون نمایی دوگانه:رگرسیون نمایی دوگانه از توابع نمایی دوگانه برای مدلسازی استفاده میکند. فرض کنید متغیر وابسته را با YY و متغیرهای وابسته را با X1,X2,...,XnX1,X2,...,Xn نشان دهیم. مدل رگرسیون نمایی دوگانه به صورت زیر تعریف میشود:
Y=β0×eβ1×X1+β2×X2+...+βn×Xn+ϵY=β0×eβ1×X1+β2×X2+...+βn×Xn+ϵ
که در اینجا β0,β1,β2,...,βnβ0,β1,β2,...,βn پارامترهای مدل و ϵϵ عامل خطا (error term) هستند.
گام 2: جمعآوری دادهها و پیشپردازش:ابتدا دادههای مورد نیاز برای مدلسازی را جمعآوری کنید. سپس، به پیشپردازش دادهها بپردازید، که شامل حذف مقادیر ناپذیرفتنی، تبدیل متغیرها به صورت نمایی دوگانه، و نرمالسازی ممکن است.
گام 3: انتخاب و تنظیم مدل:با توجه به مجموعه داده و ساختار مسئله، مدل رگرسیون نمایی دوگانه را انتخاب کنید. سپس با استفاده از الگوریتمهای بهینهسازی، پارامترهای مدل (β0,β1,β2,...,βnβ0,β1,β2,...,βn) را تنظیم کنید.
گام 4: ارزیابی مدل:با استفاده از دادههای آموزش، مدل را ارزیابی کنید. از معیارهای ارزیابی مانند میانگین خطای مربعات (MSE) یا R-squared برای ارزیابی عملکرد مدل استفاده کنید.
گام 5: پیشبینی:با داشتن یک مدل بهینه، میتوانید از آن برای پیشبینی مقادیر جدید استفاده کنید. وارد کردن متغیرهای ورودی جدید به مدل، مقدار پیشبینی شده برای متغیر وابسته را دریافت خواهید کرد.
نکته:رگرسیون نمایی دوگانه یک ابزار قدرتمند است که میتواند به مدلسازی ارتباطات پیچیده بین متغیرها کمک کند. با انجام گامهای فوق و تنظیم دقیق پارامترها، میتوانید مدلی دقیق و قابل اعتماد برای پیشبینی و تحلیل دادهها ایجاد کنید.
رگرسیون سینوسی یک روش خاص برای مدلسازی ارتباطات غیرخطی است. در این روش، از توابع سینوسی و کسینوسی برای تعیین الگوهای نوسانی در دادهها استفاده میشود. این نوع رگرسیون به ویژه در مواقعی که ارتباطات با دورههای زمانی یا فرکانسهای خاص مرتبط هستند، موثر است.
این نوع رگرسیون به ویژه در مواردی که تغییرات با دورههای زمانی یا فرکانسهای خاص مرتبط هستند، مؤثر است. در این آموزش، به جزئیات مدلسازی با رگرسیون سینوسی میپردازیم.
گام 1: تعریف مدل رگرسیون سینوسی:رگرسیون سینوسی از توابع سینوسی به صورت زیر برای تخمین متغیر وابسته استفاده میکند:
Y=β0+β1×sin(ω1×X+ϕ1)+β2×sin(ω2×X+ϕ2)+...+βn×sin(ωn×X+ϕn)+ϵY=β0+β1×sin(ω1×X+ϕ1)+β2×sin(ω2×X+ϕ2)+...+βn×sin(ωn×X+ϕn)+ϵ
که در اینجا β0,β1,β2,...,βnβ0,β1,β2,...,βn پارامترهای مدل، ω1,ω2,...,ωnω1,ω2,...,ωn فرکانسهای سینوسی، ϕ1,ϕ2,...,ϕnϕ1,ϕ2,...,ϕn زاویههای فاز، و ϵϵ عامل خطا (error term) هستند.
گام 2: جمعآوری دادهها و پیشپردازش:مانند سایر مدلهای رگرسیون، ابتدا دادههای مورد نیاز برای مدلسازی را جمعآوری کنید. سپس به پیشپردازش دادهها بپردازید که ممکن است شامل نرمالسازی متغیرها، حذف مقادیر ناپذیرفتنی، و تبدیل متغیرها به شکل سینوسی باشد.
گام 3: انتخاب و تنظیم مدل:با توجه به مجموعه داده و ساختار مسئله، مدل رگرسیون سینوسی را انتخاب کنید. سپس با استفاده از الگوریتمهای بهینهسازی، پارامترهای مدل (β0,β1,β2,...,βnβ0,β1,β2,...,βn, ω1,ω2,...,ωnω1,ω2,...,ωn, ϕ1,ϕ2,...,ϕnϕ1,ϕ2,...,ϕn) را تنظیم کنید.
گام 4: ارزیابی مدل:با استفاده از دادههای آموزش، مدل را ارزیابی کنید. از معیارهای ارزیابی مانند میانگین خطای مربعات (MSE) یا R-squared برای ارزیابی عملکرد مدل استفاده کنید.
گام 5: پیشبینی:با داشتن یک مدل بهینه، میتوانید از آن برای پیشبینی مقادیر جدید استفاده کنید. وارد کردن متغیرهای ورودی جدید به مدل، مقدار پیشبینی شده برای متغیر وابسته را دریافت خواهید کرد.
نکته:رگرسیون سینوسی یک ابزار مناسب برای مدلسازی دادههایی با دورههای زمانی یا فرکانسهای خاص است. با انجام گامهای معرفی شده، میتوانید به دقت و اثباتی عالی مدلی با قابلیت پیشبینی مناسب ایجاد کنید.
در دنیای یادگیری ماشین، استفاده از رگرسیون غیرخطی ضروری است زیرا ارتباطات بین متغیرها اغلب به صورت غیرخطی و پیچیده هستند. رگرسیون درجه سوم، رگرسیون نمایی دوگانه، و رگرسیون سینوسی از جمله روشهای مؤثری هستند که با توجه به نوع داده و الگوهای موجود، میتوانند دقت پیشبینیها را افزایش دهند.
در فرآیند یادگیری ماشین، انتخاب مدل مناسب یکی از گامهای حیاتی است که تأثیر زیادی بر عملکرد نهایی مدل دارد. در این مقاله، به بررسی و توضیح روشهای مختلف انتخاب مدل رگرسیون خواهیم پرداخت، از جمله روش جستجوی گرادیان، روش جستجوی تصادفی و روش جستجوی پروانهای.
روش جستجوی گرادیان یکی از روشهای پرکاربرد برای انتخاب مدل است. در این روش، از الگوریتمهای بهینهسازی مانند گرادیان نزولی برای یافتن پارامترهای بهینه مدل استفاده میشود. این روش با تنظیم پارامترها به سمت کمینه کردن تابع هدف، مدلی با دقت بالا و عملکرد بهینه ایجاد میکند.
روش جستجوی گرادیان یک الگوریتم بهینهسازی است که در حوزه یادگیری ماشین و بهبود مدلها بسیار مؤثر است. این روش بر اساس مفهوم گرادیان یا مشتق جزئی است و از آن برای بهینهسازی توابع هدف در فضای پارامترها استفاده میشود. در این آموزش، به جزئیات استفاده از روش جستجوی گرادیان برای بهینهسازی مدلها میپردازیم.
گام 1: تعریف تابع هدف:ابتدا باید یک تابع هدف (تابعی که باید بهینه شود) تعریف کنید. این تابع معمولاً معیاری است که ما میخواهیم بهینه کنیم، مثلاً کمینه کردن خطای مدل یا ماکزیمم کردن امتیاز تابعی.
گام 2: محاسبه گرادیان:بعد از تعریف تابع هدف، گرادیان آن را محاسبه میکنیم. گرادیان نشاندهنده جهت افزایش سریعتر یا کاهش سریعتر تابع هدف است. این گرادیان با استفاده از مشتقات جزئی تابع نسبت به هر پارامتر محاسبه میشود.
گام 3: انجام جستجوی گرادیان:الگوریتم شروع به جستجوی گرادیان میکند و به سمت جهت کاهش گرادیان حرکت میکند. این انتقال به مقداری به نام "اندازه گام" یا "نرخ یادگیری" بستگی دارد که توسط کاربر تعیین میشود.
گام 4: بهروزرسانی پارامترها:پس از انجام جستجوی گرادیان، پارامترهای مدل با استفاده از اندازه گام و گرادیان بهروزرسانی میشوند. این بهروزرسانی با هدف بهبود کارایی تابع هدف انجام میشود.
گام 5: ادامه بهینهسازی:این گامها به صورت مکرر انجام میشوند تا بهینهسازی به حداکثر برسد یا تا زمانی که معیار متوقف شدن (مانند تعداد تکرارها یا کمیتی مشخص از خطا) فراهم شود.
نکته:روش جستجوی گرادیان یک ابزار قدرتمند در جهت بهبود مدلها و بهینهسازی پارامترها است. با تنظیم مراحل مختلف این روش و انتخاب مناسب اندازه گام، میتوان به سرعت و با کارایی بالا به بهینهسازی مدلها پرداخت.
در روش جستجوی تصادفی، مختصات فضای پارامترها به صورت تصادفی تغییر میکنند و عملکرد مدل بر اساس هر تغییر ارزیابی میشود. این روش ممکن است به عنوان یک راهکار سریع برای جستجوی مدلهای مناسب استفاده شود، اما ممکن است به دلیل تصادفی بودن فرآیند، به جوابهای متفاوتی منجر شود.
روش جستجوی تصادفی یک روش ساده و موثر در بهینهسازی مسائل بهینهسازی است که بر اساس تولید تصادفی نقاط در فضای جستجو عمل میکند. این روش به خصوص در مسائلی که فضای جستجو پیچیده است و توابع هدف غیرخطی هستند، مورد استفاده قرار میگیرد. در این آموزش، به جزئیات استفاده از روش جستجوی تصادفی برای بهینهسازی مسائل پیچیده میپردازیم.
گام 1: تعریف تابع هدف:مرحله اول تعریف تابع هدف است. این تابع معیاری است که ما میخواهیم بهینه کنیم. این ممکن است یک تابع خطی یا غیرخطی باشد و به دنبال کمینه کردن یا ماکزیمم کردن مقدار آن هستیم.
گام 2: انجام جستجوی تصادفی:در این مرحله، نقاط تصادفی در فضای جستجو تولید میشوند. این نقاط به عنوان نقاط آزمایشی برای ارزیابی تابع هدف استفاده میشوند. تعداد نقاط تصادفی ممکن است به تعداد تعیینشدهای یا به صورت پویا افزایش یابد.
گام 3: ارزیابی تابع هدف:هر نقطه تصادفی در مرحله قبل به تابع هدف اعمال میشود و مقدار تابع در آن نقطه محاسبه میشود. این مرحله بهعنوان ارزیابی نتایج جستجوی تصادفی استفاده میشود.
گام 4: بهروزرسانی نقاط بهتر:نقاطی که بهترین نتایج را از نظر تابع هدف داشتهاند، بهروزرسانی میشوند. این نقاط میتوانند به عنوان تقریب بهینهسازی مسئله مدنظر ما باشند.
گام 5: ادامه جستجو:مراحل 2 تا 4 تا زمانی که به یک شرط متوقف شدن (مثلاً تعداد تکرارها یا دستیابی به یک خطای معین) ادامه مییابد. در هر مرحله، نقاط تصادفی جدید تولید میشوند و مراحل ارزیابی و بهروزرسانی تکرار میشوند.
نکته:روش جستجوی تصادفی علاوه بر سادگی، میتواند برای بهینهسازی در مسائل پیچیده نیز مؤثر باشد. با توجه به ماهیت تصادفی این روش، ممکن است به حل مسائل بهینهسازی در فضاهای پیچیده کمک کند.
روش جستجوی پروانهای بر اساس اصل بهینهسازی بازیابی عصبی از طبیعت استفاده میکند. این روش از تصادف و یادگیری تقویتی برای تنظیم پارامترها و بهبود عملکرد مدل استفاده میکند. با شبیهسازی فرآیندهای طبیعی، این روش میتواند به جستجوی مدلهای بهینه کمک کند.
روش جستجوی پروانهای یکی از روشهای بهینهسازی در حوزه یادگیری ماشین و مسائل بهینهسازی است که از الهام گرفتن از حرکت پروانهها برای جستجوی بهینهترین نقطه استفاده میکند. این روش به دلیل قابلیت اکتشافی و اکتسابی که دارد، در مسائل پیچیده مورد استفاده قرار میگیرد. در این آموزش، به جزئیات استفاده از روش جستجوی پروانهای برای بهینهسازی مسائل پیچیده میپردازیم.
گام 1: تعریف تابع هدف: ابتدا باید تابع هدف (تابعی که میخواهیم بهینه کنیم) را تعریف کنیم. این تابع ممکن است کمینه یا ماکزیمم یک معیار مشخص باشد.
گام 2: تعریف فضای جستجو: فضای جستجو، مجموعه پارامترهایی است که برای بهینهسازی در نظر گرفته میشوند. هر پروانه در این فضا یک مکان مشخص دارد که بر اساس آن مقدار تابع هدف محاسبه میشود.
گام 3: حرکت پروانهها: پروانهها در فضای جستجو به صورت تصادفی حرکت میکنند. این حرکتها شامل جابجایی تصادفی و اکتشافی به همراه یادگیری از نتایج گذشته میشود.
گام 4: ارزیابی تابع هدف: بعد از هر حرکت پروانه، مقدار تابع هدف در موقعیت جدید محاسبه میشود. این مقدار میزان کیفیت مکان فعلی را نشان میدهد.
گام 5: بهروزرسانی مکان بهتر: پروانهها مکان بهترین حالتها را بهروزرسانی میکنند. این بهروزرسانی به عنوان فرصتی برای بهبود جستجوی بهینهتر انجام میشود.
گام 6: ادامه جستجو: مراحل 3 تا 5 تا زمانی که به یک شرط متوقف شدن (مثلاً تعداد تکرارها یا دستیابی به یک خطای معین) ادامه مییابد. در هر مرحله، پروانهها حرکت میکنند و مکانهای بهترین حالتها بهروزرسانی میشوند.
نکته:روش جستجوی پروانهای با استفاده از خصوصیات حرکت پروانهها، به صورت تصادفی و همزمان، بهینهسازی در فضاهای پیچیده را امکانپذیر میسازد. با تنظیم پارامترهای مرتبط با حرکت پروانهها، میتوان به دقت و کارایی بالاتری در جستجوی بهینهترین حالتها دست یافت.
انتخاب مدل مناسب یک چالش مهم در یادگیری ماشین است. روشهای انتخاب مدل متنوعی وجود دارند، و هرکدام با ویژگیها و محدودیتهای خود متفاوتند. روش جستجوی گرادیان با دقت و تعداد تنظیمات کمینه کمک میکند، در حالی که روش جستجوی تصادفی سرعت بالایی دارد و روش جستجوی پروانهای از تجربه طبیعت الهام گرفته است. انتخاب روش مناسب بستگی به ویژگیهای دادهها و مسئله مورد نظر دارد.
مدلهای رگرسیون، که در تحلیل و پیشبینی روابط بین متغیرها استفاده میشوند، نیاز به ارزیابی دقت و عملکرد دارند. در اینجا سه روش ارزیابی مدل رگرسیون، شامل روش خطای میانگین مربعات (Mean Squared Error - MSE)، روش ضریب تعیین (Coefficient of Determination - R-squared) و روش اوک (Mean Absolute Error - MAE) توضیح داده خواهد شد.
این روش یکی از معروفترین و پراستفادهترین روشهای ارزیابی مدلهای رگرسیون است. MSE میانگین مربعات اختلاف بین مقادیر پیشبینی شده توسط مدل و مقادیر واقعی را نشان میدهد. فرمول MSE به صورت زیر است:
\[ MSE = \frac{1}{n} \sum_{i=1}^{n} (y_i - \hat{y}_i)^2 \]
که \(n\) تعداد نمونههاست، \(y_i\) مقدار واقعی، و \(\hat{y}_i\) مقدار پیشبینی شده توسط مدل میباشد.
این روش به ما میگوید که چه میزان از تغییرات متغیر وابسته توسط متغیرهای مستقل توسط مدل توضیح داده میشود. مقادیر R-squared بین 0 و 1 قرار دارند. مقدار 1 نشاندهنده تطابق کامل مدل با دادهها و مقدار 0 نشاندهنده عدم توانایی مدل در توضیح تغییرات متغیر وابسته است.
این روش از میانگین مطلق اختلاف بین مقادیر پیشبینی شده و مقادیر واقعی استفاده میکند. MAE به صورت زیر محاسبه میشود:
\[ MAE = \frac{1}{n} \sum_{i=1}^{n} |y_i - \hat{y}_i| \]
که همچنان \(n\) تعداد نمونهها، \(y_i\) مقدار واقعی، و \(\hat{y}_i\) مقدار پیشبینی شده توسط مدل میباشد.
این سه روش از جمله معیارهای مهمی هستند که در ارزیابی دقت مدلهای رگرسیون به کار میروند. هرکدام از این روشها نکات ویژه خود را دارند و انتخاب بین آنها معمولاً به ویژگیها و ماهیت دادهها بستگی دارد.
رگرسیون یکی از ابزارهای اصلی در تحلیل داده است که در زمینههای مختلف برای پیشبینی و توضیح روابط میان متغیرها استفاده میشود. در زیر، کاربردهای رگرسیون در سه زمینه مختلف، یعنی اقتصاد، پزشکی و علوم اجتماعی را توضیح میدهیم:
در هر یک از این زمینهها، استفاده از روشهای رگرسیون به محققان و تحلیلگران کمک میکند تا روابط پیچیدهتر و ابهامزا در دادهها را مورد بررسی قرار دهند و به دقت بیشتری در پیشبینی و توضیح روابط بین متغیرها دست یابند.
در اینجا چند کتاب در مورد رگرسیون معرفی شده است:
این کتاب یکی از محبوبترین کتابهای یادگیری ماشین است که به طور جامع به موضوعات مختلف یادگیری ماشین، از جمله رگرسیون، میپردازد. این کتاب برای مخاطبان با دانش مقدماتی ریاضی مناسب است.
این کتاب نسخهای از کتاب قبلی است که به طور خاص به کاربردهای رگرسیون در R میپردازد. این کتاب برای مخاطبان با دانش مقدماتی ریاضی و R مناسب است.
این کتاب نسخهای پیشرفتهتر از کتاب قبلی است که به طور عمیقتری به مباحث رگرسیون میپردازد. این کتاب برای مخاطبان با دانش پیشرفته ریاضی مناسب است.
این کتاب یک کتاب مرجع جامع در مورد رگرسیون خطی است. این کتاب برای مخاطبان با دانش پیشرفته ریاضی مناسب است.
این کتاب یک کتاب مرجع جامع در مورد رگرسیون لجستیک است. این کتاب برای مخاطبان با دانش پیشرفته ریاضی مناسب است.
البته، انتخاب کتاب مناسب به اهداف شما بستگی دارد. اگر میخواهید در مورد رگرسیون به طور کلی اطلاعات کسب کنید، کتابهای اول و دوم مناسب هستند. اگر میخواهید کاربردهای رگرسیون را در R یاد بگیرید، کتاب سوم مناسب است. اگر میخواهید به طور عمیقتری به مباحث رگرسیون بپردازید، کتابهای چهارم و پنجم مناسب هستند.
برای دانلود برخی از کتابهای بالا از گوگل درایو من روی لینک های زیر کلیک کنید.
https://drive.google.com/file/d/11r6mpzA6LVYHN19SMcGW29SFO16xd-zX/view?usp=drive_link
https://drive.google.com/file/d/1hCAFkd4HrdDVLvFRSh-rOrOeujB_gJYP/view?usp=drive_link
https://drive.google.com/file/d/1ZezTjKSz2-YBbwEqhqTcZi3aiBbGnX81/view?usp=drive_link
https://drive.google.com/file/d/1hEZ4RlE3nZaZ59ruw1RU_blLSSVpXH-4/view?usp=drive_link
https://drive.google.com/file/d/13xXRQ0znnV8-geODC2IlAghdVz2GbeNc/view?usp=drive_link

