
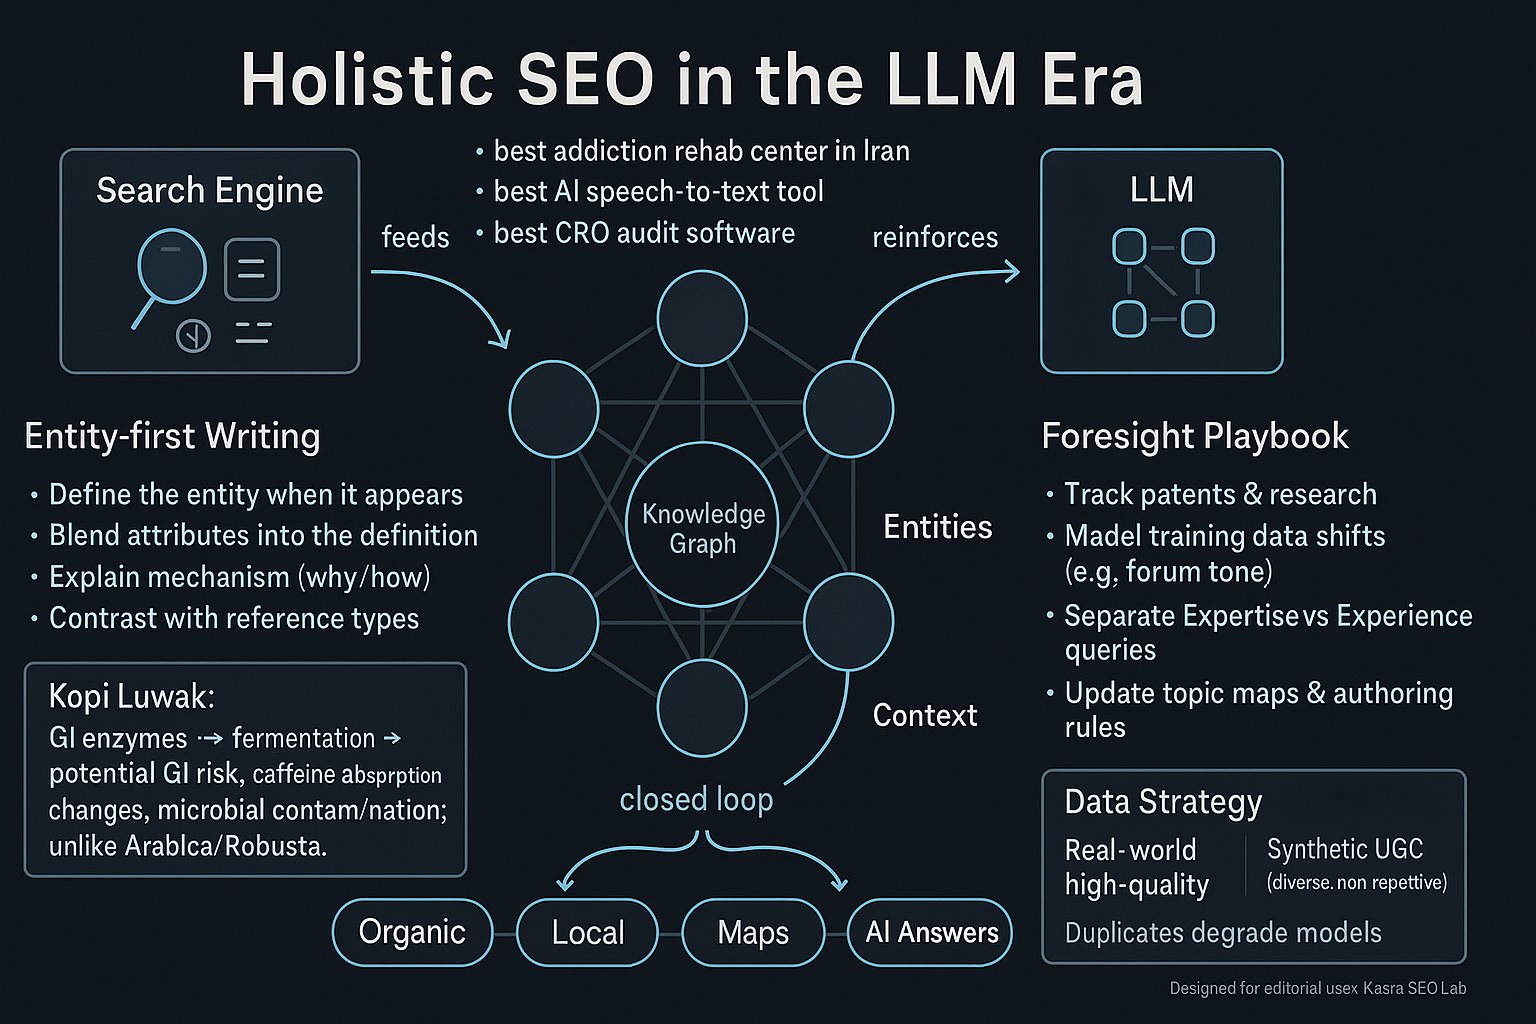
سئو در عصر مدلهای زبانی بزرگ: نقشه راه «موجودیتمحور» از گراف دانش تا اجرا
امروز دیگر موتور جستوجو را نمیتوان فقط یک الگوریتم رتبهبندی ساده دانست. گوگل و مدلهای زبانی بزرگ (LLM) مثل GPT، برای درک معنای واقعی پرسشها و پاسخها، به چیزی مشترک متکی هستند: گراف دانش. این ساختار مثل یک نقشه هوشمند، موجودیتها (برندها، اشخاص، محصولات و مکانها) و ارتباطشان را شناسایی و سازماندهی میکند.
برای سئوکاران و صاحبان کسبوکار، اهمیت این موضوع روشن است: اگر محتوا نتواند موجودیتها را به درستی تعریف کند و ویژگیهایشان را همراه با زمینه توضیح دهد، شانس دیده شدن در نتایج رقابتی پایین میآید؛ حتی اگر متن طولانی یا پرجزئیات باشد.
این تحول باعث شکلگیری مفهومی به نام Holistic SEO یا سئوی جامع شده است؛ جایی که دیگر نمیتوان مرزی میان سئوی سنتی، محلی و سئوی مرتبط با هوش مصنوعی کشید. همه چیز به صورت یک حلقه واحد عمل میکند و موفقیت تنها با رویکردی یکپارچه و موجودیتمحور امکانپذیر است.
مدلهای زبانی و موتورهای جستوجو هر دو به بازنمایی ساختاری دانش نیاز دارند؛ یعنی شبکهای از موجودیتها (اشخاص، برندها، محصولات، مکانها، مفاهیم) و روابط میان آنها. وقتی کاربر میپرسد «بهترین مرکز ترک اعتیاد ایران»، سیستم باید:
موجودیتها را تشخیص دهد (کلینیکها، نهادها، شهرها، پزشکان).
ویژگیها و سیگنالها را بخواند (شهرت، نتایج درمان، آدرس، NAP).
پیوندها را تحلیل کند (استنادها، نقدها، داده ساختاریافته).
در کانتکست جستار رتبهبندی کند (قصد کاربر، بُعد محلی، اعتماد).
نتیجه این است که هرچقدر «بازنمایی متنی موجودیت» در محتوای شما شفافتر و سازگارتر باشد، احتمال همخوانی با گراف دانش و برگشت دادهشدن در نتایج ارگانیک و پاسخهای AI بیشتر است.
سیستم ابتدا از روی نشانهها (نام، لقب، شناسه، ویژگیهای پایدار) موجودیت را میشناسد. سپس اهمیت درونمتنی را میسنجد: جایگاه در تیتر/لید، فاصله واژگانی با مفاهیم مرتبط، سازگاری با اسکیما و همنشینی با دادههای دیگر وب. اینطور نیست که صرفاً ذکر نام کافی باشد؛ باید تعریف کاربردی، ویژگیهای اولویتدار، روابط تمایزبخش و سیگنالهای اعتماد در کنار هم دیده شوند.
نمونه فشرده:
«ابزار تبدیل گفتار به متن با هوش مصنوعی» → موجودیتهای نرمافزار/برند، مدل زبانی، زبان/لهجههای پشتیبانیشده، دقت، تأخیر (Latency)، قیمتگذاری، API، حریم خصوصی، مقایسه با رقبای مرجع.
«نرمافزار CRO Audit» → موجودیت محصول، متدولوژی آزمایش (A/B، Split)، شاخصها (CR، INP، LCP)، یکپارچگی با Analytics، خروجیهای اجرایی و تمایز نسبتبه ابزارهای وب آنالیتیکس.
امروز چهار بُعد به صورت حلقهای همدیگر را تغذیه میکنند:
رگانیک ⇄ محلی: امتیازها و رضایت کاربران روی پک محلی اثر میگذارد؛ حضور محلی قوی هم CTR و تعامل ارگانیک را بالا میبرد.
ارگانیک ⇄ نقشهها: ثبات NAP، دستهبندی و اسکیما فهم نتایج وب را بهبود میدهد و به کشف/ایندکس کمک میکند.
ارگانیک ⇄ پاسخهای AI: محتوای موجودیتمحور سوخت پاسخهای مولد است و تقاضا/کلیک را به ارگانیک برمیگرداند.
محلی/نقشهها ⇄ پاسخهای AI: داده دقیق پروفایلهای محلی، Q&A و تصاویر واقعی، کیفیت پاسخهای AI را بالا میبرد و برعکس، نمایش AI ترافیک محلی را تقویت میکند.
پیام عملی این بخش این است که «AI SEO»، «Local SEO» و «Traditional SEO» مرزهای مصنوعیاند؛ برنامه باید یکپارچه، دادهمحور و موجودیتمحور باشد.
معرفی کاربردی موجودیت: چیست، در کدام دامنه تعریف میشود، برای چه مسئلهای بهکار میرود.
ویژگیهای اولویتدار: ۳–۵ خصیصه کلیدی با واحد و معیار روشن.
چرایی/سازوکار: چرا این ویژگیها مهماند و چگونه حاصل میشوند.
تمایز: تفاوت با نمونههای مرجع، رقبای شاخص یا روشهای جایگزین.
گواهها: استنادها، دادههای ساختاریافته، نشانههای اعتماد.
نکته: اگر تیتر/پرسش شامل موجودیت نامدار است، تعریف و ویژگیها را همزمان بیاورید؛ تعریف دایرةالمعارفی جدا، بعد از ۲۰۲۳ کفایت نمیکند.
ذکر نام موجودیت بدون تعریف کاربردی.
فهرست ویژگیها بدون معیار/واحد/مرجع.
مقایسه بدون چارچوب ثابت (سیب با پرتقال).
فقدان داده ساختاریافته و ناسازگاری NAP.
بدون اسکیما، بخش بزرگی از تلاشهای شما به هدر میرود. حداقلها:
Organization یا LocalBusiness: نام قانونی، نام تجاری، NAP، لوگو، SameAs، AreaServed.
Product/SoftwareApplication: نام، توصیف، دستهبندی، سیستمعامل/پلتفرم، ویژگیها، Offer/Price و AggregateRating.
Service: دامنه خدمت، مناطق پوشش، شرایط.
FAQPage و HowTo: پاسخهای شفاف/گامبهگام.
BreadcrumbList: کمک به فهم سلسله مراتب.
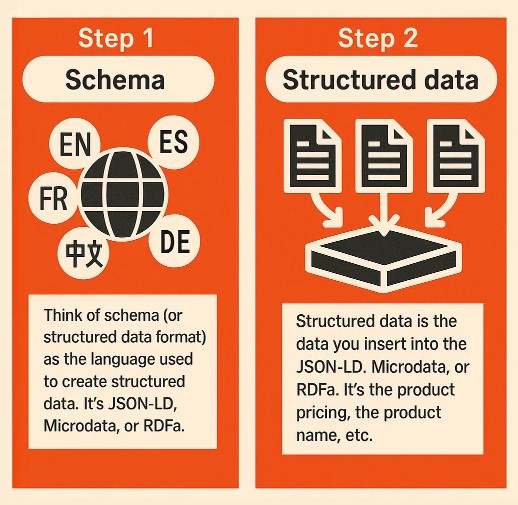
اسکیما و داده ساختاریافته: زبان قراردادی ماشین
توصیه: اسکیما را با محتوا همسو کنید؛ هرگز چیزی را که در صفحه نیست، در اسکیما نیاورید.
برای هر موجودیت راهبردی (برند، محصول، خدمت، شخص، مکان)، یک صفحه مرجع بسازید که:
تعریف کاربردی، ویژگیها، روابط، نسخه/مدلها، پرسشهای متداول و منابع را یکجا دارد.
به خوشههای موضوعی مرتبط لینک میدهد (و از آنها لینک میگیرد).
اسکیما، NAP و دادههای شناسنامهای منسجم دارد.
از مرکز (هاب) به خوشهها (Subtopics) و سناریوهای استعمال (Use-Cases) منشعب شوید:
آگاهی (Awareness): چیستی، مزایا/معایب، مقایسه سطح بالا.
ارزیابی (Consideration): شاخصها، چکلیست خرید، جدول ویژگیها.
تصمیم (Decision): پلنهای قیمت، شرایط، دمو/Case Study، Proof.
پس از خرید (Retention): راهنما، عیبیابی، پایگاه دانش.
قاعده این است که هر خوشه باید یک «هدف جستوجوی غالب» و یک «موجودیت/روابط روشن» داشته باشد.
اگر بُعد محلی برای شما حیاتی است:
NAP یکپارچه در وبسایت، نقشهها و دایرکتوریها.
Category درست در نقشه.
تصاویر واقعی و پرسش و پاسخ در پروفایل.
بازخوردهای کیفی با جزئیات (نه صرفاً ستاره).
صفحه لوکال لندینگ برای هر شهر/شعبه با محتوای متمایز (کپی تکراری = سم).
Coverage–Intent: چند درصد جستارهای کلیدی خوشه پوشش داده شده و با هدف درست جواب داده میشوند؟
Entity Match Rate: درصد صفحاتی که موجودیتهای کلیدی را درست معرفی کردهاند.
Query-to-Entity Distance: فاصله واژگانی/مفهومی میان جستارهای هدف و موجودیتهای متن.
Local Lift: همبستگی بین بهبود سیگنالهای محلی و رشد کلیکهای ارگانیک.
A/B در محتوا: تفاوت CTR/Engagement با لید بازنویسیشده موجودیت محور.
نگاشت خوشه ↔ جستار ↔ موجودیت ↔ صفحه (Spreadsheet/DB).
ثبت تغییرات (تعریف/ویژگی/اسکیما) و اثر بر رتبه/کلیک.
رصد صفحات جمعبندی رقبا (Round-Up/Compare) و پاسخهای AI.
برای اینکه غافلگیر نشوید:
پتنتها و مقالات تحقیقاتی شرکتهای جستوجو/مدلهای زبانی را پیگیری کنید.
به «پوشش داده» و «نوع گفتار» حساس باشید: لحن فرومی/مکالمهای، تجربه میدانی و زمینهسازی مرحلهبهمرحله معمولاً وزن میگیرند.
تفکیک جستارهای تخصصمحور (نیازمند مرجع و استناد) و تجربهمحور (کِی و چگونه انجام دادی؟) را در معماری محتوا اعمال کنید.
داده واقعی باکیفیت منبعی کمیاب و ارزشمند است؛ اما برای پوشش شکافها همیشه کافی نیست. اینجاست که داده مصنوعی وارد میشود: اگر متنوع و کنترلشده تولید شود، میتواند مانند مکملی کارآمد عمل کند. ولی تولید تکراری و چرخه خودتغذیهگر بهسرعت کیفیت مدل را فرسایش میدهد.
در سناریوهای کمنمونه که داده واقعی کمیاب یا به سختی در دسترس است.
برای پرسشهای پرتکرار پشتیبانی که نیاز به آموزش مدل روی پاسخهای یکنواخت دارند.
در دادهافزایی داخلی برای آزمون، اعتبارسنجی یا شبیهسازی شرایط خاص.
تکرار الگوها که باعث میشود مدل تنوع زبانی و مفهومی را از دست بدهد.
تحریف واقعیت در صورتی که داده مصنوعی بر فرضیات نادرست بنا شده باشد.
تضاد با شواهد؛ وقتی خروجی مدل با دادههای واقعی سازگار نباشد، اعتماد کاربر خدشهدار میشود.
استفاده از داده مصنوعی به صورت محدود و هدفمند، نه جایگزین کامل.
برچسبگذاری شفاف تا تمایز داده واقعی و مصنوعی روشن باشد.
ارزیابی مداوم با دادههای واقعی برای جلوگیری از انحراف.
و مهمتر از همه: داده مصنوعی هیچ وقت نباید جای تعامل اصیل کاربران را بگیرد؛ آن تعاملها تنها منبع اعتماد و غنای واقعیاند.
فهرست موجودیتهای کلیدی: برند/شخص/محصول/خدمت/مکان/مفهوم.
شناسنامه هر موجودیت: تعریف کاربردی، ۵ ویژگی اولویتدار، روابط تمایزبخش، نشانههای اعتماد، URL مرجع (هاب).
طراحی هاب موجودیت و خوشههای پیرامونی (Awareness→Decision→Retention).
افزودن اسکیماهای پایه و سازگاری با محتوا (Organization ،Product ،Service ،FAQ ،HowTo ،Breadcrumb).
بازنویسی لیدها و معرفیها با الگوی موجودیتمحور.
افزودن جداول خلاصه، مقایسههای همتراز و FAQ واقعی.
تولید ۸–۱۲ محتوای خوشهای با اهداف جستوجوی متمایز.
استانداردسازی NAP، انتخاب Category درست، بهروزرسانی تصاویر/پرسشوپاسخ.
ساخت صفحات لندینگ شهری/شعبهای با محتوای یکتا و Case محلی.
سنجش Coverage–Intent ،Entity Match Rate ،CTR، کلیکهای محلی/ارگانیک.
شناسایی صفحات کماثر، ادغام/بهروزرسانی/حذف طبق چارچوب KUMR.
برنامه بهبود برای فصل بعد (Feature Backlog: اسکیماهای پیشرفته، دادههای ساختاریافته رویداد/Article، ویدیو).
تعریف کاربردی برای هر موجودیت حیاتی دارید؟
۳–۵ ویژگی با معیار روشن ذکر شدهاند؟
تمایز با نمونههای مرجع/رقبا فهرست شده است؟
واژگان هویتی و معادلهای رایج در متن آمدهاند؟
لید/تیتر موجودیتمحور است؟
اسکیما با محتوا همسو است و خطا ندارد؟
NAP در همهجا یکسان است؟
صفحه هاب موجودیت دارید؟
کلسترها هدف جستوجوی یکتا دارند؟
جداول خلاصه و FAQ واقعی گنجانده شده؟
لینکسازی درونسایتی هاب↔خوشه پایدار است؟
تصاویر/ویدیوها توصیف و داده ALT مناسب دارند؟
نشانههای اعتماد (جایزه، مشتری شاخص، گواهی) مستند شده؟
لاگ تغییرات محتوا/اسکیما ثبت میشود؟
شاخصهای Coverage–Intent و CTR پایش میشوند؟
صفحات کمکیفیت برچسبگذاری و KUMR (Keep ،Update ،Merge ،Remove) اجرا شده؟
صفحات محلی محتوای یکتا دارند؟
پاسخهای کوتاه قابل استخراج برای AI دارید؟
از جدولهای مقایسه با معیار ثابت استفاده میکنید؟
برنامه بازبینی فصلی برای پتنتها/مقالات دارید؟
تعریف بدون کاربرد: «X چیست؟» بدون اینکه بگویید «برای چه» و «چرا مهم است».
ویژگی بدون معیار: فهرست مزایا بدون عدد/مبنای مقایسه.
اسکیما بیپشتوانه: نشانهگذاریِ چیزی که در متن نیست.
کلسترهای آبکی: چندین صفحه برای یک قصد واحد؛ همخواری کلمات کلیدی.
NAP ناپایدار: اختلاف آدرس/تلفن بین نقشهها و وبسایت.
کپیکاری محلی: لندینگ شهری تکراری با فقط تعویض نام شهر.
تکیه بر داده مصنوعی تکراری: متنهای همالگو که اثر منفی روی اعتماد میگذارند.
سئو در سال ۲۰۲۵ دیگر شبیه گذشته «صفحهمحور» یا «کلمهکلیدیمحور» نیست، بلکه یک اکوسیستم حلقهای و موجودیتمحور است. موتورهای جستوجو و مدلهای زبانی بزرگ هر دو روی یک گراف دانش مشترک حرکت میکنند؛ جایی که وبسایت، نقشههای محلی، سیگنالهای کاربران و پاسخهای مولدی هوش مصنوعی همدیگر را تغذیه میکنند. برای موفقیت پایدار باید به چند اصل توجه داشت:
۱) تعریف کاربردی موجودیتها: فقط توضیح دایرةالمعارفی کافی نیست. هر موجودیت (محصول، خدمت، برند یا مکان) باید با هدف، کاربرد و ارزش پیشنهادی روشن معرفی شود. این تعریف باید بلافاصله قابل فهم و قابل استخراج توسط موتور جستوجو باشد.
۲) ترکیب ویژگیها با دادههای قابل سنجش: هر ویژگی باید پشتوانه عددی، مقیاس یا شاخص داشته باشد. وقتی از سرعت، دقت یا امنیت صحبت میکنید، معیار اندازهگیری و چرایی اهمیت آن را هم بیاورید. این کار هم برای کاربر شفافیت میآورد، هم برای الگوریتم سیگنال اعتماد ایجاد میکند.
۳) همسویی داده ساختاریافته با محتوا: اسکیما باید دقیقاً همان چیزی را بازتاب دهد که در محتوا آمده است. همچنین NAP (نام، آدرس، تلفن) در همه بسترها باید یکپارچه باشد. کوچکترین ناهماهنگی، سیگنالهای اعتماد را تخریب میکند.
۴) معماری مبتنی بر هاب و کلستر: سایت باید بر اساس هابهای موجودیت (Entity Hubs) و کلسترهای موضوعی ساخته شود. هر خوشه محتوایی باید یک قصد جستوجوی مشخص داشته باشد و با هاب مرکزی در ارتباط باشد. این معماری به موتور جستوجو کمک میکند جایگاه شما را در نقشه دانش دقیقتر ببیند.
۵) یادگیری از پتنتها و مقالات پژوهشی: آینده سئو را نمیتوان صرفاً با تجربه گذشته حدس زد. باید به پتنتها، اسناد فنی و مقالات تحقیقاتی شرکتهای بزرگ توجه کرد. تغییرات SERP و قوانین نگارش، معمولاً از همین مسیرها به تدریج وارد میشوند.
۶) داده واقعی و داده مصنوعی: رشد داده واقعی به تنهایی کافی نیست، اما داده مصنوعی تکراری هم خطرناک است. ترکیب داده واقعی با داده مصنوعی متنوع و کنترلشده، هم به غنای مدلهای زبانی کمک میکند و هم مانع از افت کیفیت نتایج میشود.
اگر این ستونها را درست بچینید، حضور شما فقط به رتبه در SERP محدود نمیشود؛ بلکه در پاسخهای مولدی هوش مصنوعی، در نقشههای محلی و در برداشت کاربران از برندتان هم دیده خواهید شد. در این نقطه است که سئو از یک «تکنیک بازاریابی» فراتر میرود و به مزیت رقابتی پایدار تبدیل میشود؛ مزیتی که به سختی توسط رقبا قابل کپیبرداری خواهد بود.
تهیه شده توسط تیم تخصصی سئو سید احسان خسروی (مدیر، متخصص و مشاور استراتژیک سئو)

