
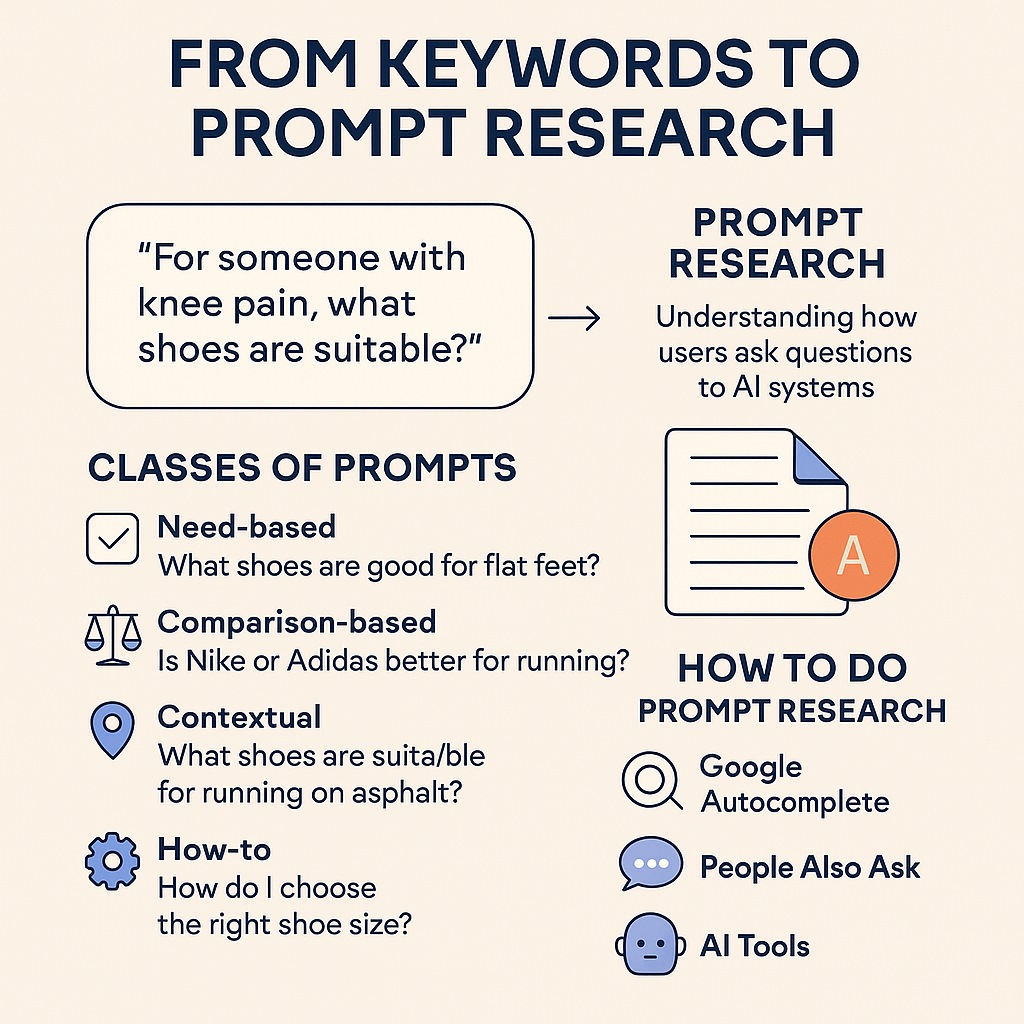
جستجو دیگر شبیه قبل نیست. کاربر بهجای آنکه بنویسد «خرید کفش ورزشی»، مستقیماً سراغ یک مدل هوش مصنوعی میرود و با زبان خودش میپرسد: «برای کسی که زانو درد داره چه کفشی مناسبه؟». همین جابهجایی کوچک، همهچیز را عوض میکند. در این فضا، «پرامپت» واحد نیت است و «پرامپت ریسرچ» فرآیندی میباشد برای کشف اینکه کاربر دقیقاً چگونه سؤالش را مطرح میکند تا ما محتوایی بسازیم که همان سؤال را بیواسطه جواب دهد. این نگاه با برچسبهایی مثل Prompt-Aligned SEO هم شناخته میشود، اما مهمتر از نام، پیامی است که حمل میکند: محتوایی شانس دیدهشدن دارد که به زبان پرامپت کاربر پاسخ بدهد، نه صرفاً به زبان کیوردهای سنتی.
این یعنی بازی از «جمعآوری کلمات» به «شناخت الگوی پرسش» منتقل میشود و اگر بخواهیم عملگرایانه حرف بزنیم، تیغی که مو را از ماست بیرون میکشد، همین است: همزبانی ساختاری و زبانی با طریقه سؤالکردن کاربر.
اگر کیورد ریسرچ را «فهرست کلمات» بدانیم، پرامپت ریسرچ «نقشه» است؛ نقشهای که از خود پرسش شروع میکند، به ماژول پاسخ میرسد و سپس به نقاط اتصال و استناد ختم میشود. خروجی آن نباید صرفاً یک لیست بلندبالا از سؤالها باشد. خروجی بالغ، نقشه پرامپت→پاسخ است؛ برای هر پرامپت مشخص میکنید:
پاسخ صریح ۱–۲ جملهای دقیقاً چیست؛
چرا این پاسخ معتبر است (منطق و معیارها)؛
چه مثال واقعی یا سناریویی آن را روشن میکند؛
و در چه شرایطی این پاسخ درست نیست.
وقتی چنین نقشهای داشته باشید، تولید محتوا از حالت «الهام لحظهای» خارج میگردد و تبدیل میشود به «مونتاژ ماژولهای استاندارد» که مدلهای هوش مصنوعی به راحتی خلاصه و نقلوقولشان میکنند.
کیورد ریسرچ به طور طبیعی به دنبال «واژه» است؛ پرامپت ریسرچ به دنبال «نحوه گفتن مسئله». این تفاوت را در سه سطح میشود دید:
سطح زبانی: کاربر با عبارتهای طبیعی، محاورهای و طولانی سؤال میپرسد. هممعناسازی صرف (synonym) کافی نیست؛ باید همان واژهها و همان چینش را در تیتر و هدینگها ببینیم.
سطح ساختاری: پاسخ باید مثل یک «کپسول» آماده استخراج باشد؛ یعنی ترتیب منطقی ثابت داشته باشد تا مدل به محض خواندن، بتواند بخشهای کلیدی را بیرون بکشد.
سطح نیتی: باید بفهمیم کاربر دقیقاً چه کاری میخواهد انجام دهد: تصمیم، مقایسه، یادگیری، یا حل یک مسئله فوری. این نیت، اسکلت پاسخ را انتخاب میکند.
در عمل، بیشتر پرسشها در چهار کلاس جا میگیرند. مزیت این طبقهبندی این است که برای هر کلاس، یک الگوی پاسخ استاندارد دارید و محتوایتان از نظر ساختاری همگن میماند.
کاربر دنبال حل مستقیم یک درد یا مسئله است: «برای کف پای صاف چه کفشی خوبه؟».
الگوی پاسخ: تشخیص نیاز را روشن کنید، معیارهای انتخاب را صورتبندی کنید، ۳–۵ گزینه واقعی را با دلیل کوتاه معرفی کنید و حتماً مرزهای عدمتناسب را بگویید (چه زمانی این انتخاب بد است).
بین چند گزینه مردد است: «نایک بهتره یا آدیداس برای دویدن؟».
الگوی پاسخ: سناریوی استفاده را مشخص کنید، یک ماتریس معیار بسازید (نهایستا، بلکه مرتبط با سناریو) و نتیجه را برای تیپهای کاربر تفکیک کنید.
پرسش وابسته به موقعیت است: «روی آسفالت چه کفشی مناسبه؟».
الگوی پاسخ: شرط محیطی یا وضعیت کاربر را توضیح دهید، اثر آن را بر معیارها نشان دهید و پیشنهاد را متناسب با بودجه/وزن/سابقه آسیب ارائه کنید.
کاربر میخواهد روش انجام یک کار را یاد بگیرد: «چطور سایز مناسب کفش ورزشی انتخاب کنم؟».
الگوی پاسخ: پارامترها را معرفی کنید، گامها را با اعداد مرجع بنویسید، و در پایان چکلیست خطاهای رایج را بیاورید تا تصمیم را مقاوم کنید.
این الگوها یک حسن دیگر هم دارند: اگر چند نفر در تیم مینویسند، خروجیها از نظر ریتم و شکل، یکپارچه باقی میمانند و «قابلیت خلاصهسازی» توسط مدلها بالا میرود.
برای ساختن نقشه پرامپت→پاسخ به داده واقعی نیاز دارید، نه حدس. مسیرهای قابل اتکایی وجود دارد:
شروع ساده و مؤثر. همین که دو سه کلمه اول را تایپ میکنید، پیشنهادها شکلهای متنوع همان نیت را جلوی چشمتان میگذارند. اینجا به «زبان مردم» نزدیک میشوید. واژههایی که در تکمیل خودکار تکرار میشوند، همان چیزهایی هستند که در تیتر/H2 باید زنده بمانند.
PAA معدن الگوهای پرسش است. مزیتش این است که شاخههای جانبی نیت را هم میبینید؛ سؤالهایی که کاربر «بعد از این سؤال» میپرسد. از همینجا میشود مسیر حرکت کاربر را حدس زد و در متن پوشش داد تا «بیرون پریدن» کاربر کم گردد.
زبان محاوره، اپیزودهای واقعی و «مدیفایرهای زندگی» (وزن، بودجه، درد زانو و تجربه بد قبلی) در انجمنها بهتر از هرجای دیگری دیده میشود. این مدیفایرها سوخت داستانهای کوتاه و سناریوهای شما هستند.
همان سؤالها را در GPT/Gemini/Perplexity بپرسید و ببینید چه پاسخی به صورت پیشفرض داده میشود و چه نوع محتوایی cite میشود. این تست، فقط «کنجکاوی» نیست؛ یک بازخورد ساختاری است: ترتیب بیان، لحن غالب و نوع استناد را از دل همین پاسخها استخراج کنید و به معماری محتوایتان منتقل نمایید.
اگر به باکس جستجوی داخلی سایت، لاگهای چت یا تیکتهای پشتیبانی دسترسی دارید، اینها طلا هستند. سؤالهایی که مشتری واقعی میپرسد، همان پرامپتهایی است که باید در متن دیده شوند. یک ساعت مرور تیکتها، گاهی از ده ابزار بیرونی نتیجه کاربردیتر میدهد.
مهمترین تغییر این است که «کپسول پاسخ» بسازید. به زبان ساده: هر بخش از متن باید بتواند بدون شما و بدون مقدمه، خودش را معرفی کند و جواب بدهد. این کار را با یک اسکلت ثابت انجام میدهیم:
حکم صریح ۱–۲ جملهای: جواب کجاست؟ همین ابتدا بگویید.
منطق و معیارها: چرا این جواب درست است؟ کوتاه و دقیق.
مثال واقعی: یک سناریو که فهم را سریع میکند.
قیود و هشدارها: چه زمانی این توصیه درست نیست.
این اسکلت را برای هر کلاس از پرامپتها کمی شخصیسازی کنید، اما ریتم را ثابت نگه دارید. ریتم ثابت، همان چیزی است که مدلها به راحتی «میفهمند» و «خلاصه» میکنند.
فرض کنید کاربر غالباً میپرسد «برای زانو درد چه کفشی مناسبه؟». اگر شما تیتر بزنید «بهترین کفش برای مشکلات مفصلی»، از نظر انسانی قابل درک است، اما از نظر مطابقت نیتی یک گام عقبترید. تیتر و هدینگها را با همان واژههای پرتکرار بسازید؛ در متن میتوانید با واژههای علمیتر آن را غنی کنید، اما قفل ورودی باید همان زبان پرسش باشد. همین جزئیات کوچک تعیین میکند که محتوایتان در جوابهای AI بهعنوان منبع همراستا تشخیص داده شود یا نه.
در مطالب Comparison-based، معیارها را از دل پرامپت و سناریو بیرون بکشید. اگر بحث درباره کفش دویدن باشد، «وزن کاربر»، «نوع پا»، «سطح دویدن»، «دوام»، «قیمت» معیارهاییاند که تصمیم را واقعی میکنند. مهم این است که همه مطالب مقایسهای شما از یک ماتریس ثابت پیروی کنند تا خروجیها قابل قیاس باشند. آن وقت مدلها هم راحتتر میتوانند از متن شما خلاصه بسازند.
مدلها وقتی به حدس و گمان تکیه نمیکنند که با شاهد طرف باشند. شاهد میتواند عدد، استاندارد، روش سنجش یا حتی نتیجه یک مطالعه قابل ارجاع باشد. لازم نیست متن را با رفرنس خفه کنید؛ کافی است ساختار «ادعا → شاهد کوتاه» را در جاهای حساس پخش کنید. این کار هم اعتماد کاربر را زیاد میکند، هم احتمال cite شدن را.
سؤالات متداول را بر محور همان چهار کلاس ببندید. هر سؤال باید یک پاسخ ۴–۶ خطی فشرده داشته باشد که با الگوی «اگر… آنگاه…» جمع میشود. این فرم، برای مدلها extract-friendly است و برای کاربر هم نقش «میانبر تصمیم» را بازی میکند.
یک چرخه یک هفتهای تعریف کنید: جمعآوری ۲۰–۳۰ پرامپت از Autocomplete ،PAA، انجمنها، تست AI و دادههای اولشخص. بعد آنها را در چهار کلاس برچسب بزنید و موارد هممعنا را ادغام کنید تا به ۱۰–۱۲ «پرامپت محوری» برسید.
برای هر پرامپت محوری، کپسول پاسخ را بنویسید: حکم صریح، معیارها، مثال و قیود. اگر موضوع مقایسهای است، مصداقها را روی یک ماتریس معیار یکسان پیاده کنید تا با بقیه صفحات همخوان بماند.
هدینگها را با همان واژههای پرکاربرد در پرامپتها نامگذاری کنید. یک لایه «پل» میان بخشها اضافه کنید: جملات کوتاهی که نشان میدهد سؤال بعدی کاربر چیست و او را به بخش مرتبط میبرد. این پلها، نرخ پرش را کم میکنند.
متن را با صدای انسانی بخوانید. اگر حس کردید لحن به «گزارش فنی بیروح» نزدیک شده، یک مثال کوتاه یا وضعیت واقعی اضافه کنید. قرار نیست شوخی کنیم؛ کافی است داستان واقعیت را بگوییم.
دو یا سه پرامپت محوری را همانگونه که در صفحه پوشش دادهاید، در GPT/Gemini/Perplexity بپرسید. اگر پاسخ مدل با ترتیب و لحن شما همموج بود و منبع مشابهی را cite کرد، احتمال همترازی خوب است. اگر نه، تیتر و مقدمه هر بخش را اصلاح کنید.
پس از انتشار، بهجای وسواس صرف روی رتبه، «نرخ دیدهشدن در پاسخهای AI»، «کیفیت اسنیپت»، «زمان تعامل» و «جریان کلیک از پاسخهای AI/جستجوی ترکیبی» را هم بسنجید. این KPI ها نشان میدهد در اکوسیستم جدید کجا ایستادهاید.
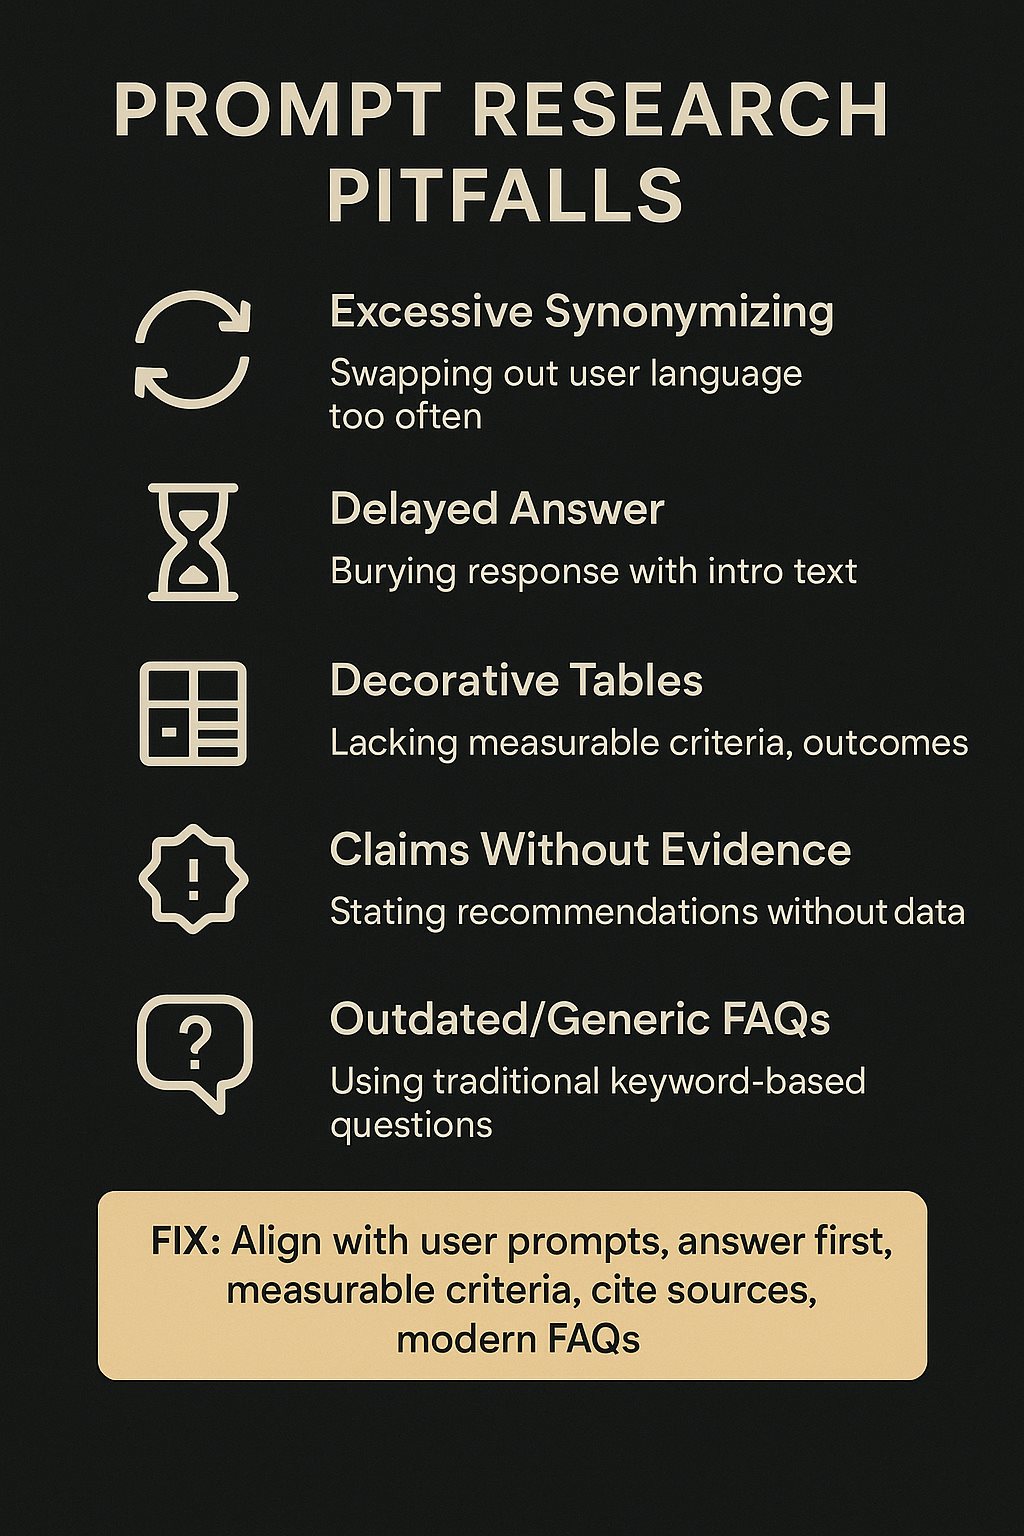
مترادفکاری افراطی: به امید پوشش بیشتر، واژههای کاربر را عوض مینماییم و زبان او را گم میکنیم.
فاصله زیاد بین سؤال و جواب: مقدمهچینیهای طولانی که پاسخ را دیر نشان میدهند. مدلها هم حوصلهشان سر میرود.
جدولهای تزئینی: ماتریسهای مقایسهای بدون معیارهای قابل سنجش و بدون نتیجه تفکیکی.
ادعای بیشاهد: توصیههای کلی که نه عدد دارند، نه منبع.
FAQ کلیشهای: پرسشهایی که از همان کیوردهای قدیمی آمدهاند و به زبان پرامپت امروز نوشته نشدهاند.
چگالی پاسخ مستقیم را بالا ببرید: هر بخش را با جملهای شروع کنید که اگر همان را تنها نقل کنند، هنوز معنی بدهد.
واژگان «آستانهای» را نشانه بگیرید: واژههایی که در Autocomplete و PAA زیاد تکرار میشوند (مثل «برای زانو درد»، «روی آسفالت»، «برای وزن بالا») را در هدینگها و لید پاراگرافها حفظ کنید.
سناریو را جدی بگیرید: خواننده با خودش میگوید «من همینیام که اینجا نوشته». این اثر، مهمتر از هر ترفند فنی است.
مپس FAQ را از متن جدا نکنید: هر بار که پاسخ فشردهای نوشتید، همان را در انتهای صفحه به صورت سؤال و جواب کوتاه تکرار کنید تا قابل استخراج باشد.
آزمون پیوسته: هر ماه، سه پرامپت محوری را در مدلها تکرار کنید؛ اگر پاسخها از متنهای دیگری cite میشود، به ساختار و زبان همان صفحات نگاه نمایید و فاصله خودتان را کم کنید.
اگر بخواهید فردا همین را در تیم اجرا کنید، این خطوط راهنما کمک میکند:
ده پرامپت از چهار مسیر (Autocomplete ،PAA، انجمنها و تست AI) جمع کنید.
برای هر پرامپت، کپسول پاسخ را در ۱۴۰–۱۸۰ کلمه بنویسید: حکم، معیار، مثال و قید.
هدینگها را با همان جملهبندی رایج کاربر بسازید.
اگر موضوع قابلیت مقایسه دارد، ماتریس معیار را یکبار برای همیشه تعریف کنید و در همه صفحات مشابه نگه دارید.
در انتها یک FAQ همراستا اضافه کنید؛ هر پاسخ ۴–۶ خط.
پس از انتشار، سه پرامپت محوری را در مدلها بپرسید و تطابق لحن/ترتیب پاسخ را با متن خود بسنجید. اگر لازم بود، تیترها و لیدها را اصلاح کنید.
پرامپت ریسرچ «ابزار جدید» نیست؛ «زاویه دید جدید» است. بهجای شکار کیورد، الگوی پرسش را شکار کن. بهجای پرکردن صفحه با کلمات هممعنا، همان زبانی را بهکار ببر که کاربر با آن میپرسد. پاسخ را صریح و بیحاشیه بده؛ با معیارهای روشن، مثال واقعی و ذکر محدودیتها. وقتی ساختار متن با پرامپتهای واقعی همتراز باشد، هم کاربر زودتر به جواب میرسد، هم مدلهای هوش مصنوعی راحتتر خلاصه میکنند و احتمال cite شدن بالا میرود. KPI ها را هم با این واقعیت تازه میزان کن: ظهور در پاسخهای AI و کیفیت اسنیپت، درست کنار رتبه و کلیک، باید سنجیده شود.
این مسیر، ساده نیست؛ اما اگر یکبار نقشه پرامپت→پاسخ را برای موضوعات اصلی برندت بسازی، باقی راه تبدیل میشود به نگهداری و بهروزرسانی. و این همان جایی است که محتوا، بهجای مسابقه بیپایان روی واژهها، تبدیل میشود به پاسخ واقعی برای پرسشهای واقعی.
تهیه شده توسط تیم تخصصی سئو سید احسان خسروی (مدیر، متخصص و مشاور استراتژیک سئو)

