
در بسیاری از پروژههای سئو، دادههای ساختاریافته جزو بخشهایی هستند که یک بار پیادهسازی میشوند و بعد ماهها یا حتی سالها کسی سراغ خروجی واقعی آنها نمیرود. افزونه یا توسعهدهنده کد را ایجاد میکند، تست اولیه بدون خطا تمام میشود و از آن لحظه به بعد فرض میکنیم Schema همواره همان چیزی است که انتظار داریم. تغییر تازه گوگل در نحوه استخراج JSON-LD یادآوری خوبی است که این فرض همیشه امن نیست، مخصوصاً وقتی داده قبل از رسیدن به صفحه از چند لایه CMS، Template، API یا تابع Escape عبور میکند.
گوگل در ۲۱ اوت ۲۰۲۶ اعلام کرد برای نزدیکترکردن Parser خود به استانداردهای JSON، استخراج JSON-LD را تغییر داده و اکنون فقط یک مرحله HTML unescaping انجام میدهد. نتیجه عملی این تغییر آن است که Entityهای دو بار Escape شده، مانند & یا ✔، دیگر تا رسیدن به کاراکتر اصلی باز نمیشوند. گوگل همچنین توصیه کرده سایتها به قواعد استاندارد JSON یا Unicode hexadecimal escapeهایی مانند \u0026 تکیه کنند.
این تغییر در نگاه اول بسیار کوچک به نظر میرسد. نه الگوریتم رتبهبندی جدیدی معرفی شده، نه نوع تازهای از Rich Result آمده و نه قابلیت شناختهشدهای حذف شده است. بااینحال، همین تغییر سطح پایین میتواند در سایتهایی که Structured Data آنها از چند لایه پردازشی عبور میکند باعث شود مقدار نهایی بعضی Propertyها با چیزی که صاحب سایت تصور میکند متفاوت شود.
در برخی گزارشها این تغییر به این شکل خلاصه شده که «دیگر نباید در JSON-LD از & استفاده کرد چون گوگل آن را Decode نمیکند». این بیان دقیق نیست. گوگل گفته یک مرحله HTML unescaping انجام میدهد. بنابراین اگر مقدار شامل یک & باشد، همان یک مرحله میتواند آن را به & تبدیل کند.
مشکلی که خود گوگل مشخصاً درباره آن هشدار داده Double Escaping است. فرض کنید نام یک فروشگاه «کتاب & هنر» باشد. اگر اولین لایه پردازش کاراکتر & را به & تبدیل کند و لایه دوم دوباره همان Ampersand را Encode کند، خروجی نهایی به & تبدیل میشود. Parser قبلی گوگل ممکن بود چند مرحله آن را باز کند تا دوباره به & برسد، اما رفتار جدید پس از یک مرحله متوقف میشود؛ در نتیجه مقدار باقیمانده میتواند هنوز & باشد.
با وجود این، حتی استفاده از HTML Entity یکمرحلهای داخل JSON-LD بهترین معماری نیست. دلیلش ساده است: JSON قواعد Escape مخصوص خود را دارد و HTML Entity بخشی از آن استاندارد نیست. بخش ۷ استاندارد RFC 8259 توضیح میدهد رشتههای JSON چگونه باید Escape شوند و اجازه میدهد کاراکتر Unicode مستقیماً یا با توالی \uXXXX نمایش داده شود.
بنابراین اگر قرار است یک Ampersand در مقدار JSON داشته باشیم، "کیف & کفش" کاملاً طبیعی است. اگر به هر دلیل نیاز به نمایش Escape شده داریم، "کیف \u0026 کفش" نیز معتبر است. اضافهکردن یک لایه HTML Encoding به دادهای که درواقع JSON است معمولاً فقط Complexity غیرضروری تولید میکند.
در بسیاری از موارد توسعهدهنده مستقیماً & نمینویسد. Double Escaping معمولاً محصول یک Pipeline است. داده ممکن است ابتدا در دیتابیس ذخیره شود، سپس توسط CMS پردازش شود، بعد از یک Helper مخصوص HTML عبور کند و در نهایت Template نیز برای امنیت خروجی را دوباره Escape کند.
هر مرحله بهتنهایی ممکن است منطقی به نظر برسد. اگر همان مقدار قرار بود در HTML معمولی داخل صفحه چاپ شود، Escape کردن آن حتی میتواند بخشی از طراحی امن سیستم باشد. مشکل زمانی شکل میگیرد که همان Pipeline برای دادهای استفاده شود که مقصد آن یک <script type="application/ld+json"> است.
JSON و HTML دو Context متفاوتاند. چیزی که برای قرارگرفتن در متن HTML نیاز به Escape دارد الزاماً داخل JSON به همان نوع Escape نیاز ندارد. وقتی توسعهدهنده این Contextها را از هم جدا نکند، همان داده ممکن است یک بار برای HTML و بار دیگر برای Template Escape شود.
این خطا در سایتهای بزرگتر جدیتر است، زیرا ممکن است یک Template واحد هزاران Product، Article یا Organization را تولید کند. در چنین حالتی یک Bug کوچک در Serialization بهجای یک URL روی دهها هزار صفحه تکثیر میشود.
اولین گروه سایتهایی هستند که Structured Data را دستی داخل Template یا functions.php تولید کردهاند. وقتی Propertyها با Concatenation رشتهها ساخته شوند و برنامهنویس مجبور باشد خودش درباره Escape تصمیم بگیرد، احتمال خطا بیشتر میشود. روش امنتر معمولاً ساخت Object یا Array و سپردن Serialization به یک JSON Encoder استاندارد است.
گروه دوم سایتهاییاند که Schema را از طریق Tag Manager تزریق میکنند. در چنین معماریای داده ممکن است ابتدا از DOM خوانده شود، سپس داخل متغیر قرار گیرد و بعد به یک رشته JSON تبدیل شود. اگر دادهای که از DOM گرفته شده قبلاً Entity داشته باشد و در مرحله دیگری دوباره Encode شود، مشکل پدید میآید.
گروه سوم پروژههایی هستند که اطلاعات Structured Data را از API، Feed یا دیتابیس دریافت میکنند. در اینجا سؤال مهم این است که داده در کدام لایه Escape شده است. یک API ideally باید داده را براساس قرارداد خودش تحویل دهد و لایه نمایش نیز بر اساس Context مقصد Serialization صحیح را انجام دهد. اگر همه لایهها تصور کنند وظیفه Escape بر عهده آنهاست، Double Encoding تقریباً اجتنابناپذیر میشود.
در وردپرس نیز توابعی مثل esc_html و htmlspecialchars در جای درست کاملاً مفیدند، اما استفاده از آنها روی دادهای که قرار است به JSON Encoder داده شود میتواند خروجی ناخواسته ایجاد کند. مسئله خود تابع نیست؛ مسئله استفاده از Escape مخصوص Context اشتباه است.
نباید از این آپدیت نتیجه گرفت تمام سایتهایی که از افزونههای شناختهشده استفاده میکنند Schema خراب دارند. افزونههای بزرگ معمولاً Serialization و Escape خروجی را خودشان مدیریت میکنند و نصب استاندارد آنها الزاماً در معرض چنین خطایی نیست.
اما اسم افزونه تضمین نمیکند خروجی نهایی سالم است. بسیاری از سایتها روی خروجی افزونه Filter اعمال کردهاند، Propertyهای اختصاصی اضافه کردهاند، بخشی از داده را از Custom Field میگیرند یا Theme در مرحله دیگری روی رشته پردازش انجام میدهد. حتی ممکن است افزونه ثالث دیگری همان داده را قبل از رسیدن به Schema تغییر دهد.
برای همین بهترین روش تشخیص، حدسزدن از روی نام CMS نیست. Source واقعی چند صفحه را بررسی کنید. چیزی که Googlebot دریافت میکند مهمتر از چیزی است که Dashboard افزونه نشان میدهد.
این تغییر نکته مهمتری درباره Audit Structured Data نشان میدهد. بسیاری از تیمها فقط میپرسند آیا JSON Syntax معتبر است یا نه. اگر Parser خطا ندهد، Issue بسته میشود.
اما کد میتواند از نظر Syntax کاملاً Valid باشد و درعینحال مقدار اشتباهی داشته باشد.
فرض کنیم JSON زیر بدون خطای Syntax Parse شود:
"name": "Smith & Sons"
از دید Parser، این فقط یک رشته است و چیزی در Grammar JSON مانع وجود حروف & نمیشود. سؤال مهمتر این است که آیا منظور ما واقعاً نام «Smith & Sons» بوده یا «Smith & Sons».
Structured Data قرار است موجودیت واقعی صفحه را توصیف کند. اگر مقدار Schema با محتوای visible صفحه تفاوت معنایی پیدا کند، اعتبارسنجی Syntax بهتنهایی این مشکل را نشان نمیدهد.
گوگل نیز در مستندات Structured Data تأکید میکند اطلاعات Markup باید دقیق، مرتبط و نماینده محتوایی باشند که کاربر روی صفحه میبیند.
بنابراین Audit حرفهای دو مرحله دارد: نخست بررسی Validity و سپس بررسی Data Accuracy.
سادهترین نقطه شروع مشاهده Source واقعی صفحه است، نه فقط DOM داخل DevTools. بلوکهای دارای application/ld+json را پیدا کنید و فیلدهای متنی را بررسی کنید. name، headline، description، reviewBody، نام Brand و متن FAQ یا Product Description معمولاً جاهایی هستند که کاراکترهای خاص بیشتری دارند.
بهخصوص دنبال الگوهایی باشید که نشاندهنده چند مرحله Encoding هستند. &amp; نمونه واضح است. الگوهایی مانند &#...; نیز در هشدار رسمی گوگل ذکر شدهاند. هدف فقط پیدا کردن Ampersand نیست؛ باید ببینیم مقدار قبل از رسیدن به Google Parser چند بار تبدیل شده است.
در سایت بزرگ، بررسی دستی چند URL کافی نیست. بهتر است Crawler یا Script خروجی JSON-LD را استخراج و Propertyهای مشکوک را در سطح Template پیدا کند. اگر مسئله در Template باشد، یک Fix میتواند هزاران URL را اصلاح کند.
گوگل خودش توصیه میکند Structured Data در زمان توسعه با Rich Results Test بررسی شود و پس از Deployment نیز گزارشهای Rich Result در Search Console مانیتور شوند.
این ابزار برای بررسی Eligibility و مشکلات فنی بسیار مفید است، اما نباید تنها مرحله Audit باشد. ممکن است Structured Data Parse شود و ابزار هیچ Syntax Error بزرگی گزارش نکند، درحالیکه مقدار یک رشته همان Entity Text اشتباه باشد.
پس هنگام استفاده از Rich Results Test فقط دنبال علامت سبز نباشید. Parsed Data را باز کنید و ببینید Google واقعاً چه مقدارهایی استخراج کرده است. اگر Product Name، Organization Name یا Description با صفحه اصلی متفاوت است، Issue هنوز وجود دارد.
Search Console نیز برای تشخیص الگوهای بزرگتر مفید است. اگر بعد از Deploy تغییر Template، تعداد خطاها یا Warningهای Structured Data تغییر کرد، آن زمان باید نسخه خروجی قبل و بعد از تغییر مقایسه شود.
در خبر اصلی هیچ ادعایی درباره تغییر Core Ranking وجود ندارد. این یک تغییر Parser برای استخراج JSON-LD است. بنابراین نباید از آن تیتر «Google Update جدید باعث افت رتبه سایتهای دارای &amp; میشود» ساخت.
گوگل توضیح میدهد Structured Data میتواند صفحه را برای نمایشهای غنیتر واجد شرایط کند، اما حتی Markup صحیح نیز تضمین نمیکند Rich Result نمایش داده شود. همچنین Manual Action مربوط به Structured Data میتواند Eligibility برای Rich Result را از بین ببرد بدون اینکه الزاماً رتبه عادی Web Search را تغییر دهد.
ریسک عملی این آپدیت بیشتر Data Quality و Eligibility است. اگر Google Property مورد نیاز را بهدرستی نفهمد، Structured Data ممکن است اطلاعاتی غیر از چیزی که انتظار داشتید ارائه کند. تأثیر دقیق بسته به نوع Schema و Property آسیبدیده متفاوت خواهد بود.
برای همین در اولویتبندی Fix، Templateهایی را جلوتر قرار دهید که واقعاً Rich Result فعال دارند یا Structured Data نقش مهمی در توصیف Product، Event، Recipe، Organization یا دیگر موجودیتهای اصلی آنها دارد.
پاسخ حرفهایتر این است که Context را اصلاح کنیم، نه اینکه Search & Replace کور روی کل سایت اجرا کنیم. HTML Entity در HTML کاربرد خودش را دارد. مشکل زمانی است که داده HTML-escaped بدون نیاز وارد JSON-LD شود یا چند بار Escape شود.
برای Structured Data بهتر است یک Source of Truth تمیز داشته باشیم و هنگام Serialization از JSON Encoder استاندارد استفاده کنیم. در زبانهای برنامهنویسی مدرن تقریباً همیشه ابزار استانداردی برای این کار وجود دارد.
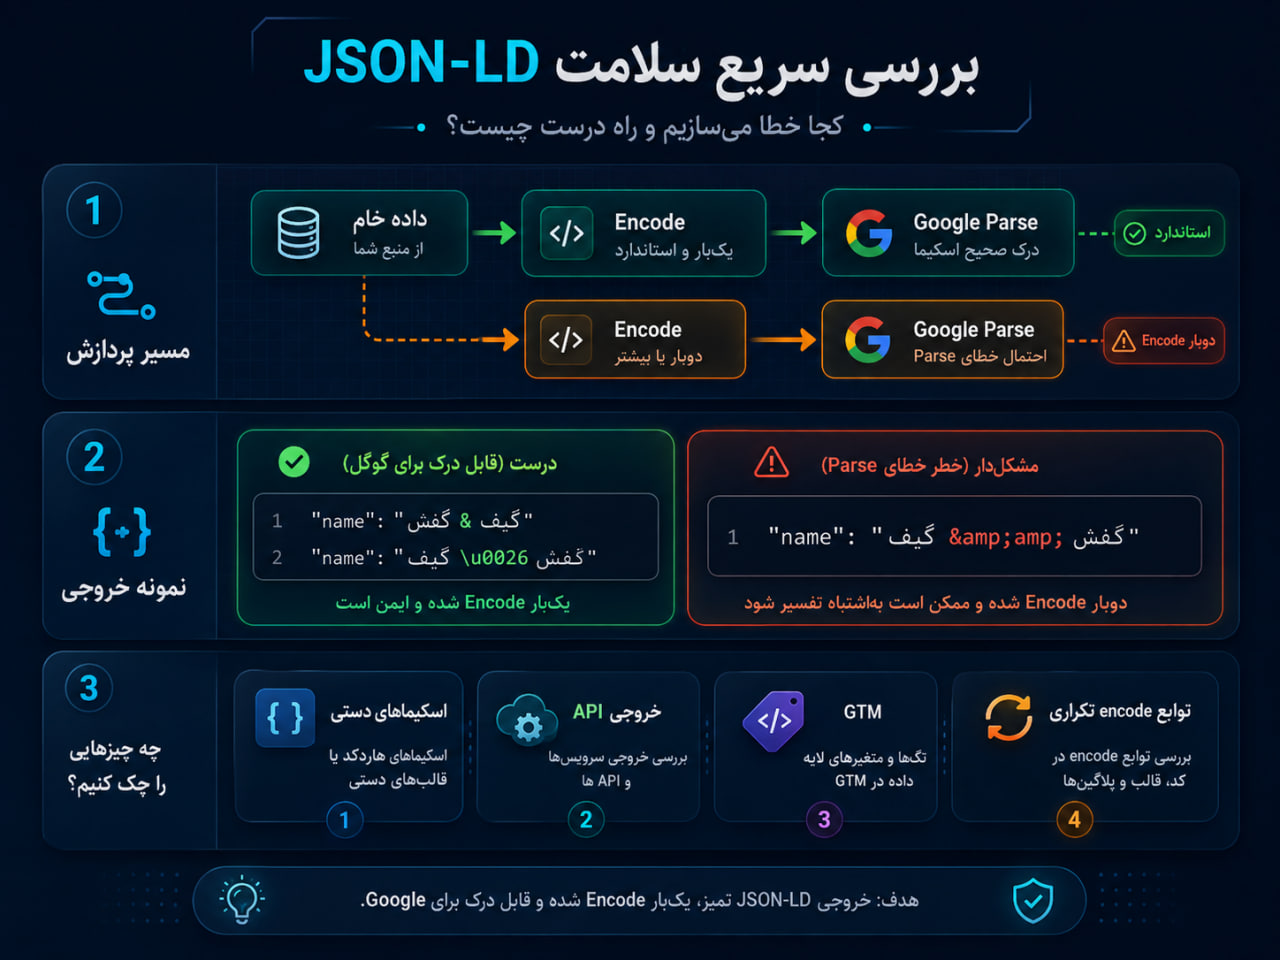
اگر مقدار & دارد، همان کاراکتر در JSON معتبر است. اگر نیاز خاصی برای Escape وجود دارد، JSON Unicode Escape مانند \u0026 انتخاب واضحی است. RFC 8259 اجازه نمایش Unicode و مجموعه Escapeهای تعریفشده JSON را میدهد.
راهی که بهتر است حذف شود، ساخت دستی رشته JSON با مخلوطکردن HTML Escaping و String Concatenation است.
فروشگاهها Structured Data را در مقیاس بسیار بزرگ تولید میکنند. نام محصول، Brand، Offer، Price، Description، Availability و Reviewها میتوانند از چند سیستم مختلف بیایند. ERP، PIM، دیتابیس فروشگاه، افزونه SEO و Theme همه ممکن است بخشی از Pipeline باشند.
اگر نام محصول دارای & باشد و یک سیستم آن را Encode کند، سیستم دوم ممکن است فرض کند رشته خام دریافت کرده و دوباره Encode انجام دهد. نتیجه روی تمام Variantها و صفحات مشابه تکرار میشود.
برای همین فروشگاهها بهتر است Audit را در سطح Template انجام دهند، نه فقط چند Product تصادفی. محصولی را پیدا کنید که نام یا Description آن کاراکترهای خاص دارد و همان را بهعنوان تست مرزی استفاده کنید.
همچنین بعد از هر Migration، تغییر Theme یا نصب ابزار Schema جدید، Structured Data باید دوباره اعتبارسنجی شود. چیزی که در نسخه قبلی سالم بوده ممکن است با اضافهشدن یک لایه جدید Processing تغییر کند.
استفاده از Tag Manager برای Schema در بعضی پروژهها به تیم SEO اجازه میدهد بدون Deploy توسعهدهنده تغییراتی اعمال کند، اما همین انعطاف یک ریسک هم دارد: Data Path دشوارتر دیده میشود.
ممکن است مقدار از HTML صفحه خوانده شود، با JavaScript پردازش شود، داخل Object قرار گیرد و سپس به Script جدید تزریق شود. هر مرحله فرصت جدیدی برای تبدیل Encoding است.
اگر از این روش استفاده میکنید، فقط کد Container را بررسی نکنید. خروجی Rendered نهایی و Parsed Data را نیز تست کنید. هدف این است که ببینید بعد از تمام Transformها چه چیزی واقعاً به Googlebot میرسد.
همچنین بهتر است Transformها مستند شوند. اگر معلوم نباشد کدام لایه مسئول Escape است، چند ماه بعد توسعهدهنده دیگری ممکن است برای «امنترکردن» خروجی مرحله جدیدی اضافه کند و همان Double Escaping را ایجاد کند.
درس مهندسی این تغییر فراتر از Schema است. داده قبل از نمایش باید براساس Context مقصد Encode شود. مقدار خام دیتابیس میتواند به HTML، JSON، URL، JavaScript یا SQL برود و هرکدام قواعد Escape متفاوتی دارند.
یک تابع عمومی با نامی مانند sanitizeEverything() معمولاً راهحل خوبی نیست، چون هیچ Encoding واحدی برای تمام Contextها وجود ندارد.
برای JSON-LD باید Object داده ساخته شود و Encoder مخصوص JSON آن را Serialize کند. برای HTML باید Escaping مناسب HTML انجام شود. برای URL از Percent Encoding مربوط به URL استفاده شود.
این جداسازی هم امنیت را بهتر میکند و هم احتمال خرابی Data Integrity را کاهش میدهد.
برای شروع لازم نیست کل سایت بازنویسی شود. ابتدا Templateهای اصلی را مشخص کنید: Homepage، Product، Article، Category، Local Business و هر صفحهای که Structured Data مهم دارد.
از هر Template چند URL انتخاب کنید که حاوی کاراکترهای خاص باشند. Source را بررسی و بلوک JSON-LD را استخراج کنید. بعد Parsed JSON را با محتوای Visible صفحه مقایسه کنید.
اگر Double Escaping پیدا شد، بهجای اصلاح دستی URLها، مسیر تولید Property را دنبال کنید تا بفهمید اولین Encode کجا و Encode دوم کجا اتفاق میافتد. Fix باید در همان Pipeline انجام شود.
سپس دوباره Source را بگیرید، Rich Results Test را اجرا کنید و چند روز بعد Search Console را مانیتور کنید.
برای سایت بزرگ میتوان همین Check را وارد QA هر Release کرد تا خرابی Template قبل از انتشار گسترده شناسایی شود.
این تغییر نشان میدهد Structured Data باید مثل هر بخش دیگری از زیرساخت سایت نگهداری شود. Google Parser تغییر میکند، Schema.org تکامل پیدا میکند، Rich Resultها اضافه یا حذف میشوند و خود CMS نیز مرتب تغییر میکند.
پس داشتن یک Validation در زمان راهاندازی کافی نیست. Schema باید در Monitoring دورهای سایت حضور داشته باشد.
Google Search Central نیز مستقیماً توصیه میکند Markup در Development تست شود و پس از Deployment با Rich Result Status Reportها پایش شود، چون Template یا Serving Issue میتواند بعدها دادهای را که قبلاً درست بوده خراب کند.
برای تیمهای بزرگ این کار میتواند بخشی از Regression Testing باشد. نمونه URLهای اصلی بعد از تغییر Theme، CMS، Checkout، Product Feed یا Template بهصورت خودکار بررسی شوند.
تغییر تازه گوگل درباره JSON-LD در ظاهر فقط یک جزئیات Parser است: از این پس فقط یک مرحله HTML unescaping انجام میشود. اما همین جزئیات مرز مهمی را روشن میکند. Google Parser قرار نیست برای همیشه خطاهای Encoding سایت را جبران کند.
مهمترین ریسک، دادههای Double-escaped هستند. اگر مقدار & در Pipeline شما ابتدا به & و سپس به &amp; تبدیل شده باشد، یک مرحله Decode دیگر برای رسیدن به مقدار اصلی کافی نیست.
راهحل نیز پیچیده نیست: HTML Encoding را با JSON Encoding قاطی نکنید. داده را تا حد امکان خام و دقیق نگه دارید، JSON را با Serializer استاندارد تولید کنید و در صورت نیاز از Escapeهای رسمی JSON مانند Unicode Escape استفاده کنید.
از دید سئو، مهمترین سؤال بعد از این آپدیت این نیست که «Schema من Error دارد یا نه؟» سؤال دقیقتر این است:
مقداری که Google Parser از Schema من استخراج میکند، واقعاً همان اطلاعاتی است که روی صفحه و در دیتابیس من وجود دارد؟
تهیه شده توسط تیم تخصصی سئو سید احسان خسروی (مدیر، متخصص و مشاور استراتژیک سئو)

