
فرض کنید در یک تصویر از دادههای جستوجو، نام question_fringe_score را میبینید. چند وقت بعد تصویری دیگر به شما نشان میدهند که در آن encodedDaftScore کنار توضیحی دربارهٔ «سندِ مرتبط با موضوع حاشیهای» آمده است. واکنش طبیعی این است که این دو را به هم وصل کنیم و بپرسیم آیا گوگل اول سؤال کاربر را میسنجد، سپس صفحهها را از نظر همان موضوع ارزیابی میکند؟ پرسش جذابی است، اما پاسخ آن از خود دو تصویر بیرون نمیآید.
این متن بر دو منبع تکیه دارد. Search Engine Roundtable در سپتامبر ۲۰۲۵ کشف مرتبط با question_fringe_score را گزارش کرد. شان اندرسون در سپتامبر ۲۰۲۶ تصویری از فیلد encodedDaftScore در دادههای مرتبط با سند منتشر کرد. آنها از دو مسیر متفاوت به بحث «fringe» میرسند. یکی تصویری از دادهٔ یک پرسوجو را به میان میآورد و دیگری بخشی از توصیف یک ساختار داده را. برای فهم اهمیت ماجرا، باید هر مسیر را جداگانه دنبال کنیم و بعد دربارهٔ نقاط تماس احتمالیشان حرف بزنیم.
گزارش Search Engine Roundtable به نوشتهٔ مارک ویلیامز-کوک دربارهٔ دادههایی اشاره میکند که از یک بهرهبرداری فنی به دست آمده بودند. در تصویری که او منتشر کرده، نام question_fringe_score در کنار دادههای یک سؤال مشخص دیده میشود. بنابراین دستکم میتوان گفت چنین نامی در آن نمونه حضور داشته است. این گزاره کوچکتر از جملهٔ «گوگل همهٔ سؤالها را با همین روش رتبهبندی میکند» است و باید کوچک بماند.
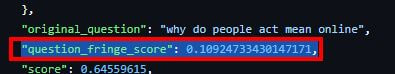
ویلیامز-کوک احتمال داده بود که این امتیاز شاید فاصلهٔ یک سؤال را از فضای موضوعات آشنا یا میزان غیرمعمول بودن آن بیان کند. برای کسی که با دادههای جستوجو کار میکند، این فرضیه نامعقول نیست. برخی پرسشها کوتاه و رایجاند، برخی بسیار خاص و کمتکرار. با وجود این، معنای روزمرهٔ واژهٔ «حاشیهای» را نمیتوان بهصورت خودکار معنای یک متغیر فنی دانست. از نام متغیر نمیفهمیم ورودیهای مدل چیست، مقدار بالاتر چه معنایی دارد یا خروجی در کجا مصرف میشود.
گزارش، نظر دیگری را هم بازتاب میدهد که میگوید واژهٔ «fringe» در بخشهایی نزدیک به طبقهبندی ایمنی دیده میشود. این برداشت بهجای تمرکز صرف بر کمتکرار بودن سؤال، به احتمال ارزیابی موضوعات حساس یا ادعاهای مسئلهدار نگاه میکند. بحث از همینجا پیچیده میشود: اگر دو تفسیر با یک نام سازگار باشند، برای انتخاب یکی از آنها به شواهدی بیش از یک اسکرینشات احتیاج داریم.
یک مقدار نمونه به ما نمیگوید این فیلد برای تمام پرسوجوها محاسبه میشود. نشان نمیدهد مقدار صفر یا یک دقیقاً چه معنایی دارد. مشخص نمیکند اثر احتمالی آن فقط در تشخیص نوع جستوجوست یا در انتخاب نتایج نیز نقشی دارد. حتی اگر در مسیر پردازش جستوجو حضور داشته باشد، هنوز ممکن است کاربرد آن به شرایط ویژهای محدود باشد. تحلیل خوب باید این سؤالهای بیپاسخ را حفظ کند، نه اینکه با حدس بهسرعت پرشان کند.
در فضای سئو معمولاً فشار زیادی برای تبدیل هر یافته به اقدام اجرایی وجود دارد. این فشار قابل درک است؛ مدیر سایت میخواهد بداند چه چیزی را تغییر دهد. اما ارزش یک کشف فنی همیشه در تولید فوری یک دستورالعمل نیست. گاهی ارزش آن در این است که سؤال پیشین را دقیقتر کنیم. در اینجا پرسش بهتر این است که «fringe» در سطح پرسوجو به چه نوع ویژگی اشاره دارد و آیا شاهدی از نحوهٔ استفاده از آن وجود دارد؟
شان اندرسون در پست خود به encodedDaftScore اشاره میکند. تصویر همراه پست، این فیلد را در ساختاری با نام QualityFringeFringeQueryPriorPerDocData نشان میدهد و برای DAFT توضیح «Document About Fringe Topic» میآورد. عبارت «سند دربارهٔ موضوع حاشیهای» مهم است، زیرا موضوع آن به خود صفحه یا سند برمیگردد. همین تفاوت، بحث را از بررسی سؤال کاربر به بررسی محتوایی که ممکن است در نتایج ظاهر شود گسترش میدهد.
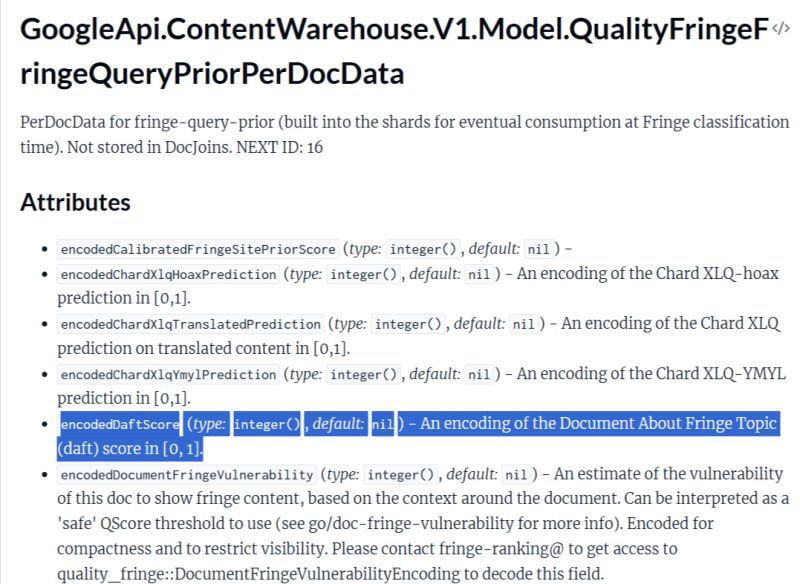
در همان تصویر، فیلدهای دیگری نیز نزدیک به DAFT دیده میشوند که نامشان به موضوعات حساس و پیشبینی محتوای فریبآمیز اشاره دارد. این همجواری میتواند برای شکل دادن فرضیه دربارهٔ نقش مجموعهٔ داده مفید باشد. اما ترتیب قرار گرفتن نامها در یک تصویر، نمودار جریان تصمیمگیری نیست. نمیتوان از آن نتیجه گرفت که هر سند ابتدا بهعنوان موضوع حاشیهای برچسب میخورد، سپس بهطور خودکار جریمه میشود. «توصیف یک داده» و «اثبات اثر نهایی» دو مرحلهٔ متفاوتاند.
واژهٔ «Document» همچنین مانع یک سادهسازی دیگر میشود. گاهی در بحثهای عمومی، امتیاز پرسوجو و امتیاز صفحه طوری توضیح داده میشوند که گویی یک عدد واحد در دو جا نمایش یافته است. شواهد در دسترس چنین چیزی را ثابت نمیکنند. شاید این فیلدها در یک چارچوب مشترک مصرف شوند، شاید هم فقط نامگذاری نزدیک دارند. برای دانستن، باید اطلاعاتی دربارهٔ مسیر مصرف و رابطهٔ آنها داشته باشیم.
به یک مثال فرضی فکر کنیم. سایتی ممکن است مقالهای دربارهٔ یک ادعای پزشکی نادر بنویسد و با استناد به شواهد توضیح دهد که چرا آن ادعا تأیید نشده است. سایت دیگری ممکن است همان ادعا را با تیتر قطعی به خواننده توصیه کند. هر دو صفحه دربارهٔ موضوعی مشابهاند، اما کارکرد آنها یکسان نیست. صرف حضور نام یک موضوع در متن نمیگوید صفحه در حال حمایت از آن است، آن را نقد میکند یا فقط خبری دربارهاش میدهد.
همین تمایز برای موضوعات مالی، تاریخی، علمی و سیاسی نیز مهم است. محتوای دقیق دربارهٔ یک موضوع غیررایج میتواند به کاربر کمک کند. حذف یا سطحیکردن چنین محتواهایی فقط به این دلیل که ممکن است «fringe» تلقی شوند، راهبرد معقولی نیست. از دو منبع مورد بررسی نیز چنین توصیهای درنمیآید. اگر چیزی برای نویسنده کاربرد داشته باشد، ضرورت روشن نوشتن موضع، ارائهٔ شاهد و مشخص کردن حدود ادعاست.
برای پاسخ، چهار پرسش باید روشن شود. اول، هر مقدار دقیقاً چگونه محاسبه میشود؟ دوم، کجا ذخیره و در چه شرایطی خوانده میشود؟ سوم، هنگام استفاده چه تصمیمی را تغییر میدهد؟ چهارم، آیا اثر آن را میتوان در نتایج قابل مشاهده از عوامل دیگر جدا کرد؟ تصویر پرسوجو به این چهار سؤال پاسخ نمیدهد. تصویر فیلد DAFT نیز با وجود توضیح مفیدش، پاسخ کامل آنها نیست.
وقتی میگوییم یک فیلد «در دادهها وجود دارد»، از یک مشاهده حرف میزنیم. وقتی میگوییم «احتمالاً به ارزیابی موضوعات حساس کمک میکند»، فرضیهای دربارهٔ کاربردش داریم. وقتی میگوییم «باعث افت رتبهٔ فلان صفحه شده»، وارد ادعای علّی دربارهٔ یک نتیجهٔ مشخص میشویم. هر مرحله شواهد بیشتری لازم دارد. خطای رایج این است که جملهٔ سوم را با تکیه بر جملهٔ اول منتشر کنیم.
نباید فراموش کرد که گزارش نخست در سال ۲۰۲۵ و پست دوم در سال ۲۰۲۶ منتشر شدهاند. موضوع گزارش اول به بهرهبرداری فنی و نمونهٔ داده مربوط است و موضوع پست دوم به توصیف فیلدی در دادههای منتشرشدهٔ سال ۲۰۲۴. پس این ترکیب را نباید بهعنوان اعلام رسمی یک قابلیت تازهٔ گوگل در سپتامبر ۲۰۲۶ معرفی کرد. تاریخ انتشار تحلیل با تاریخ ایجاد داده و تاریخ استفادهٔ احتمالی از آن یکی نیست.
در شرایط فعلی، چنین تشخیصی پشتوانهٔ کافی ندارد. اگر سایتی دربارهٔ یک موضوع حساس افت ترافیک پیدا کند، دهها توضیح ممکن وجود دارد: تغییر نیاز کاربران، تغییر نتایج، رقابت، ضعف شواهد صفحه، مشکلات فنی یا عوامل دیگر. نسبت دادن افت به یک فیلد که مقدارش را برای سایت خود نمیبینیم و نحوهٔ استفاده از آن را نمیدانیم، بررسی را به حدس وابسته میکند.
مسیر بهتر این است که نخست دادههای قابل مشاهده را مرتب کنیم. کدام صفحهها افت کردهاند؟ کدام پرسوجوها تغییر داشتهاند؟ آیا افت فقط برای یک موضوع است یا سراسر سایت دیده میشود؟ آیا متن صفحه در فاصلهٔ زمانی مورد بررسی تغییر کرده است؟ آیا نتیجههای رقیب پاسخ دقیقتری میدهند؟ پاسخ این سؤالها شاید علت قطعی را آشکار نکند، اما دستکم تصمیم اصلاح محتوا را بر پایهٔ شواهدی قرار میدهد که میتوانیم بررسی کنیم.
اگر مسئول یک سایت محتوایی هستید، از صفحات دارای ادعاهای پرپیامد شروع کنید. مطلبی دربارهٔ درمان بیماری، انتخاب مالی مهم یا ادعایی که میتواند رفتار کاربر را عوض کند، به بررسی بیشتری نیاز دارد. ابتدا ادعای اصلی را در یک جمله بنویسید. سپس ببینید شواهد صفحه واقعاً همان ادعا را پشتیبانی میکنند یا فقط با آن ارتباطی دور دارند. ممکن است مشکل در نبود شواهد باشد؛ ممکن است هم شواهد وجود داشته باشند اما عنوان، نتیجه را بیش از حد قطعی نشان دهد.
در مرحلهٔ بعد، مرز متن را برای خواننده روشن کنید. اگر دربارهٔ فرضیهای علمی مینویسید، آن را فرضیه بنامید. اگر ادعای فردی را گزارش میکنید، گزارش کردن را با تأیید کردن مخلوط نکنید. اگر نتیجهٔ پژوهشی شرایط و محدودیتهایی دارد، همانها را در بخش مرتبط توضیح دهید. این کار صرفاً برای موتور جستوجو نیست؛ به مخاطب امکان میدهد تصمیم خود را با تصویر دقیقتری از موضوع بگیرد.
هویت نویسنده یا بررسیکننده نیز باید واقعی و مرتبط باشد. افزودن نام یک متخصص بدون مشارکت او، مسئلهٔ اعتبار را حل نمیکند. در برخی صفحهها لازم است نوشته بهوسیلهٔ فردی با دانش حوزه بررسی شود؛ در برخی دیگر، ارائهٔ روشن منابع و توضیح روش بررسی اهمیت اصلی را دارد. معیار ثابت، صداقت دربارهٔ کاری است که واقعاً انجام شده است. هیچکدام از دو فیلد مورد بحث مجوز ساختن نشانههای ظاهری تخصص نیستند.
برخی ناشران نگراناند که نوشتن دربارهٔ یک ادعای گمراهکننده، خود صفحه را در همان دسته قرار دهد. از دادههای مورد بحث نمیتوان چنین نتیجهای گرفت. با این حال، صفحهٔ انتقادی باید از ابتدا روشن کند چه ادعایی بررسی میشود و نتیجهٔ بررسی چیست. نقل طولانیِ ادعای نادرست بدون زمینه، ممکن است خواننده را گیج کند؛ نقد مستند و دقیق، کارکرد متفاوتی دارد.
این تمایز به طراحی عنوان و مقدمه هم مربوط است. اگر مقالهای در حال رد کردن یک ادعای بیاساس است، عنوان مبهم یا هیجانانگیز نباید طوری نوشته شود که انگار همان ادعا را تأیید میکند. در متن هم باید شواهد نزدیک به ادعا قرار گیرند، نه اینکه خواننده پس از چند صفحه به توضیح اصلی برسد. چنین تصمیمهایی به کیفیت ارتباط با مخاطب کمک میکنند، مستقل از اینکه DAFT در عمل چگونه استفاده شود.
ما تعریف کامل question_fringe_score را از تصویر نمونه در اختیار نداریم. نمیدانیم encodedDaftScore چه ورودیهایی دارد، مقدارش چگونه تفسیر میشود و چه زمانی مصرف میشود. رابطهٔ مستقیم این دو فیلد نیز از دو منبع ثابت نشده است. مهمتر از همه، هیچیک بهتنهایی وزن، آستانه یا اثر مشخصی بر رتبهٔ یک صفحه را اثبات نمیکنند. بیان این ندانستهها ضعف تحلیل نیست؛ شرط تحلیل دقیق است.
در عین حال، میتوانیم از همین شواهد به نتیجهای محدود ولی مفید برسیم: واژهٔ «fringe» در بیش از یک سطح از دادههای مورد بحث دیده شده است و تحلیل آن فقط با تعریف «سؤال کمتکرار» ممکن است ناقص باشد. این نتیجه، دعوتی به پژوهش دقیقتر است. اگر در آینده سندی دربارهٔ نحوهٔ اتصال پرسوجو به دادهٔ سند یا اثر آن بر نتایج منتشر شود، میتوان فرضیهها را دوباره سنجید.
داستان question_fringe_score و encodedDaftScore از آن خبرهایی است که هم برای متخصص فنی جذاب است و هم برای تولیدکنندهٔ محتوا وسوسهٔ نتیجهگیری سریع دارد. پاسخ حرفهای این نیست که سرنخها را کنار بگذاریم؛ باید آنها را در اندازهٔ واقعیشان نگه داریم. یک نمونهٔ پرسوجو و یک توصیف فیلد سند دیدهایم. هنوز نقشهٔ قطعی رابطه و اثرشان را نداریم.
برای کار امروز، راه روشنتری وجود دارد: صفحههای حساس را با نگاه به دقت، شواهد، زمینه و صداقت در بیان عدم قطعیت بازبینی کنیم. اگر صفحهای را تغییر میدهیم، دلیل تغییر باید مشکلی باشد که در خود صفحه یا دادههای قابل مشاهده پیدا کردهایم. نام جذاب یک فیلد میتواند پرسش پژوهشی خوبی بسازد؛ بهتنهایی تشخیص مشکل سایت یا نسخهٔ درمان آن نیست.
منابع:
گزارش Search Engine Roundtable:
https://www.seroundtable.com/google-question-fringe-score-40112.html
پست شان اندرسون در لینکدین:
تهیه شده توسط تیم تخصصی سئو سید احسان خسروی (مدیر، متخصص و مشاور استراتژیک سئو)

