
در سادهترین مدل ذهنی سئو، خزنده موتور جستوجو موجودی است که وارد URL میشود، HTML را دریافت میکند، لینکها را پیدا میکند و به صفحه بعد میرود. این مدل برای توضیح اولیه Crawl مناسب است، اما وب مدرن بسیار پیچیدهتر از مجموعهای از فایلهای HTML ثابت است. بخش بزرگی از سایتهای امروزی پس از دریافت HTML اولیه، با JavaScript به APIها متصل میشوند، اطلاعات تازه میگیرند، وضعیتها را تغییر میدهند و حتی عملیات نوشتنی روی Backend انجام میدهند.
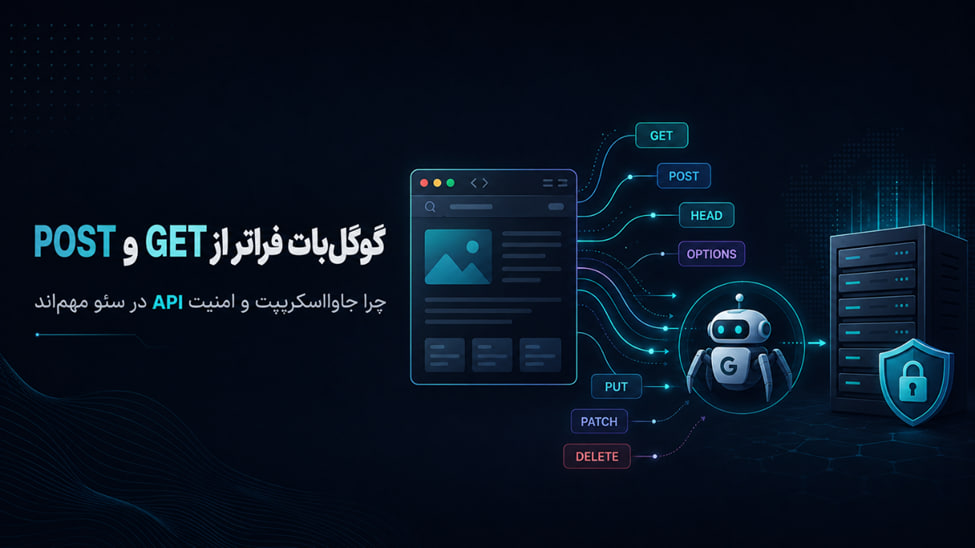
نکتهای که گری ایلیس مطرح کرده دقیقاً به همین بخش کمتر دیدهشده از Crawl مربوط میشود. طبق گفته او، کرولرهای گوگل فقط به درخواستهای GET و POST محدود نیستند. روشهایی مانند HEAD، OPTIONS، PUT، PATCH و DELETE نیز در Requestهای مشاهدهشده وجود دارند، هرچند مجموع آنها کمتر از ۱.۵ درصد کل درخواستهای کرولرهای گوگل را تشکیل میدهد.
عدد کمتر از ۱.۵ درصد از یک جهت آرامشبخش است؛ قرار نیست تصور کنیم Googlebot مرتب با DELETE وارد Endpointهای سایتها میشود. اما از جهت معماری فنی، همین درصد کوچک یک پیام مهم دارد: موتور Rendering میتواند رفتار JavaScript صفحه را دنبال کند و اگر خود کد Client درخواست خاصی را ایجاد کند، آن Request ممکن است بخشی از فرایند Render شود.
اگر فقط تیتر خبر را ببینیم، ممکن است به نتیجه اشتباهی برسیم: «Googlebot میتواند DELETE بفرستد، پس ممکن است دادههای سایت را پاک کند.» این برداشت بیش از چیزی است که منبع میگوید.
نکته اصلی این است که JavaScript اجراشده در صفحه میتواند Request را آغاز کند. موتور Rendering گوگل نیز برای درک محتوای صفحات JavaScript-heavy بخشی از این کد را اجرا میکند. بنابراین اگر همان کدی که در Browser واقعی اجرا میشود به API خاصی درخواست PATCH، PUT یا DELETE بفرستد، Renderer نیز ممکن است همان جریان را طی کند.
از نظر معماری وب، این مسئله عجیب نیست. مرورگرهای امروزی صرفاً فایل دریافت نمیکنند. برنامههای Web Application دائماً با Backend در تعاملاند. یک دکمه میتواند اطلاعات کاربر را تغییر دهد، یک Form میتواند Resource جدید بسازد و یک Event میتواند دادهای را حذف کند.
مسئله زمانی ایجاد میشود که چنین عملیاتی بدون کنترل مناسب در سمت Server قابل اجرا باشند.
برای درک بهتر موضوع، لازم نیست وارد جزئیات بسیار عمیق پروتکل شویم، اما تفاوت Methodها مهم است. GET معمولاً برای دریافت Resource استفاده میشود. HEAD مشابه GET است، با این تفاوت که معمولاً Body پاسخ دریافت نمیشود و Headerها اهمیت بیشتری دارند. OPTIONS میتواند درباره قابلیتها و Methodهای قابل استفاده یک Endpoint اطلاعات بدهد.
در معماریهای RESTful، PUT اغلب برای جایگزینی یا ثبت وضعیت یک Resource، PATCH برای تغییر بخشی از آن و DELETE برای حذف Resource به کار میرود. این تعریفها الزام مطلق برای تمام APIهای دنیا نیستند، اما الگوی رایج طراحیاند.
از منظر سئو، تا مدتها تقریباً تمام تمرکز روی GET بود، چون خزنده عمدتاً محتوا را دریافت میکرد. اما وقتی Search Engine وارد مرحله Rendering میشود، دیگر فقط یک Reader ساده نیست؛ بخشی از محیطی را اجرا میکند که برنامهنویس سایت طراحی کرده است.
این همان نقطهای است که JavaScript SEO از بحث Rendering متن و لینکها فراتر میرود.
صفحات زیادی محتوای کامل خود را در HTML اولیه قرار نمیدهند. HTML پایه ممکن است فقط Shell برنامه باشد و بعد از اجرا، JavaScript با API ارتباط برقرار کند، محتوای مقاله، محصول، لیست قیمت یا رابط کاربری را بسازد.
اگر موتور جستوجو فقط HTML خام را ببیند، در بعضی سایتها بخش مهمی از محتوا را از دست میدهد. به همین دلیل Rendering در فرایند پردازش صفحات JavaScript اهمیت پیدا میکند.
اما اجرای JavaScript یک تفاوت بنیادی با خواندن HTML دارد. کد میتواند رفتار داشته باشد. میتواند Timer ایجاد کند، API را فراخوانی کند، وضعیت Session را بخواند یا Eventهای مختلف را مدیریت کند. همین قابلیت است که زمینه Requestهای غیر GET را میسازد.
منبع دقیقاً همین نکته را مطرح میکند: بخشی از Methodهای غیرمعمول دیدهشده از JavaScriptهایی میآیند که خودشان Request را آغاز کردهاند.
فرض کنیم یک پنل مدیریت یا Web App داریم که هنگام بازشدن صفحه، کد JavaScript وضعیت یک Draft را تغییر میدهد. توسعهدهنده به هر دلیل از PATCH استفاده کرده است. اگر Endpoint فقط براساس وجود Request تغییر را بپذیرد و کنترل احراز هویت مناسبی نداشته باشد، هر محیطی که همان کد را اجرا کند میتواند Request را ایجاد کند.
در مثال خطرناکتر، فرض کنیم یک اسکریپت اشتباه هنگام Render یک DELETE Request برای Resource خاص میفرستد. اگر Server صرفاً Endpoint را در دسترس قرار داده و Authorization واقعی ندارد، مسئله بسیار بزرگتر از SEO است.
در این حالت Googlebot عامل اصلی مشکل نیست. هر Browser، Bot، ابزار تست یا سیستم Automation دیگری که به صفحه برسد و کد را اجرا کند نیز میتواند همان اتفاق را رقم بزند.
از این منظر، خبر گری ایلیس بیشتر از اینکه درباره «رفتار عجیب Googlebot» باشد، درباره کیفیت طراحی Web Application است.
یکی از قواعد بنیادی معماری Web این است که Client قابل اعتماد نیست. هر Requestی که Browser میتواند ارسال کند، از نظر فنی میتواند توسط ابزار، Script یا Client دیگری نیز ساخته شود.
پس Server نباید تصمیم امنیتی مهم را براساس این فرض بگیرد که «این Request فقط وقتی ارسال میشود که کاربر فلان دکمه را بزند». دکمه صرفاً یک Interface است؛ Request اصلی میتواند مستقل از رابط ساخته شود.
برای PUT، PATCH و DELETE، سمت Server باید بررسی کند چه کسی Request را ارسال کرده، آیا مجوز تغییر Resource را دارد، آیا Resource مربوط به همان حساب است و آیا عملیات در شرایط فعلی مجاز است.
این بخش از تحلیل یک نکته اجرایی امنیتی است که از پیام منبع نتیجه میشود؛ خود خبر صرفاً بر لزوم محافظت سمت Server در برابر Requestهای حساس تأکید دارد.
ممکن است سؤال شود این موضوع بیشتر امنیت Backend است تا SEO. پاسخ این است که هر دو لایه در سایتهای JavaScript-heavy بههم نزدیک شدهاند.
Technical SEO قدیمی بیشتر با Status Code، robots.txt، Sitemap، Canonical و لینکهای داخلی سر و کار داشت. این موارد همچنان مهماند، اما در برنامههای مدرن باید بدانیم Google هنگام Render چه چیزی اجرا میکند.
اگر JavaScript برای ساخت محتوای اصلی پنج API را فراخوانی کند، وضعیت همان APIها بخشی از Crawlability واقعی صفحه میشود. اگر یکی از آنها با خطا پاسخ دهد، شاید محتوا ناقص Render شود. اگر API نیازمند Cookie خاص باشد، Renderer ممکن است نتیجه متفاوتی ببیند. اگر Endpoint نوشتنی باشد، مسئله حتی فراتر میرود.
در نتیجه Technical SEO باید از «بررسی HTML خروجی» به «بررسی رفتار Rendering» گسترش پیدا کند.
برای تحلیل یک سایت JavaScript-heavy، یکی از مفیدترین ابزارها همان Network Panel مرورگر است. با Reload کردن صفحه میتوان دید چه Requestهایی ارسال میشوند، Method هر Request چیست، چه Status Codeهایی دریافت میشوند و کدام Endpointها برای ساخت محتوا ضروریاند.
در یک Audit پیشرفتهتر، میتوان Requestها را براساس Method دستهبندی کرد. GETهای مربوط به محتوا در یک گروه، POSTها در گروه دیگر و PUT/PATCH/DELETEها جدا بررسی شوند.
وجود PUT یا DELETE بهتنهایی نشانه مشکل نیست. برنامه ممکن است کاملاً معتبر از آنها استفاده کند. سؤال اصلی این است که چه Eventی Request را ایجاد میکند و Server تحت چه شرایطی آن را قبول میکند.
اگر Request حساس فقط پس از ورود کاربر و اقدام صریح او ارسال میشود و Server مجوز را کنترل میکند، معماری منطقی است. اگر صرف Load صفحه عمومی آن را ایجاد میکند، باید بررسی بیشتری انجام شود.
در بسیاری از پروژههای SEO، Log Analysis صرفاً برای فهم رفتار Crawl استفاده میشود: Googlebot چند بار آمده، چه URLهایی را دیده، چه Status Codeهایی دریافت کرده و Crawl Budget کجا مصرف شده است.
این منبع نشان میدهد میتوان سؤال دیگری هم اضافه کرد: Googlebot با چه HTTP Methodهایی به سرور رسیده است؟
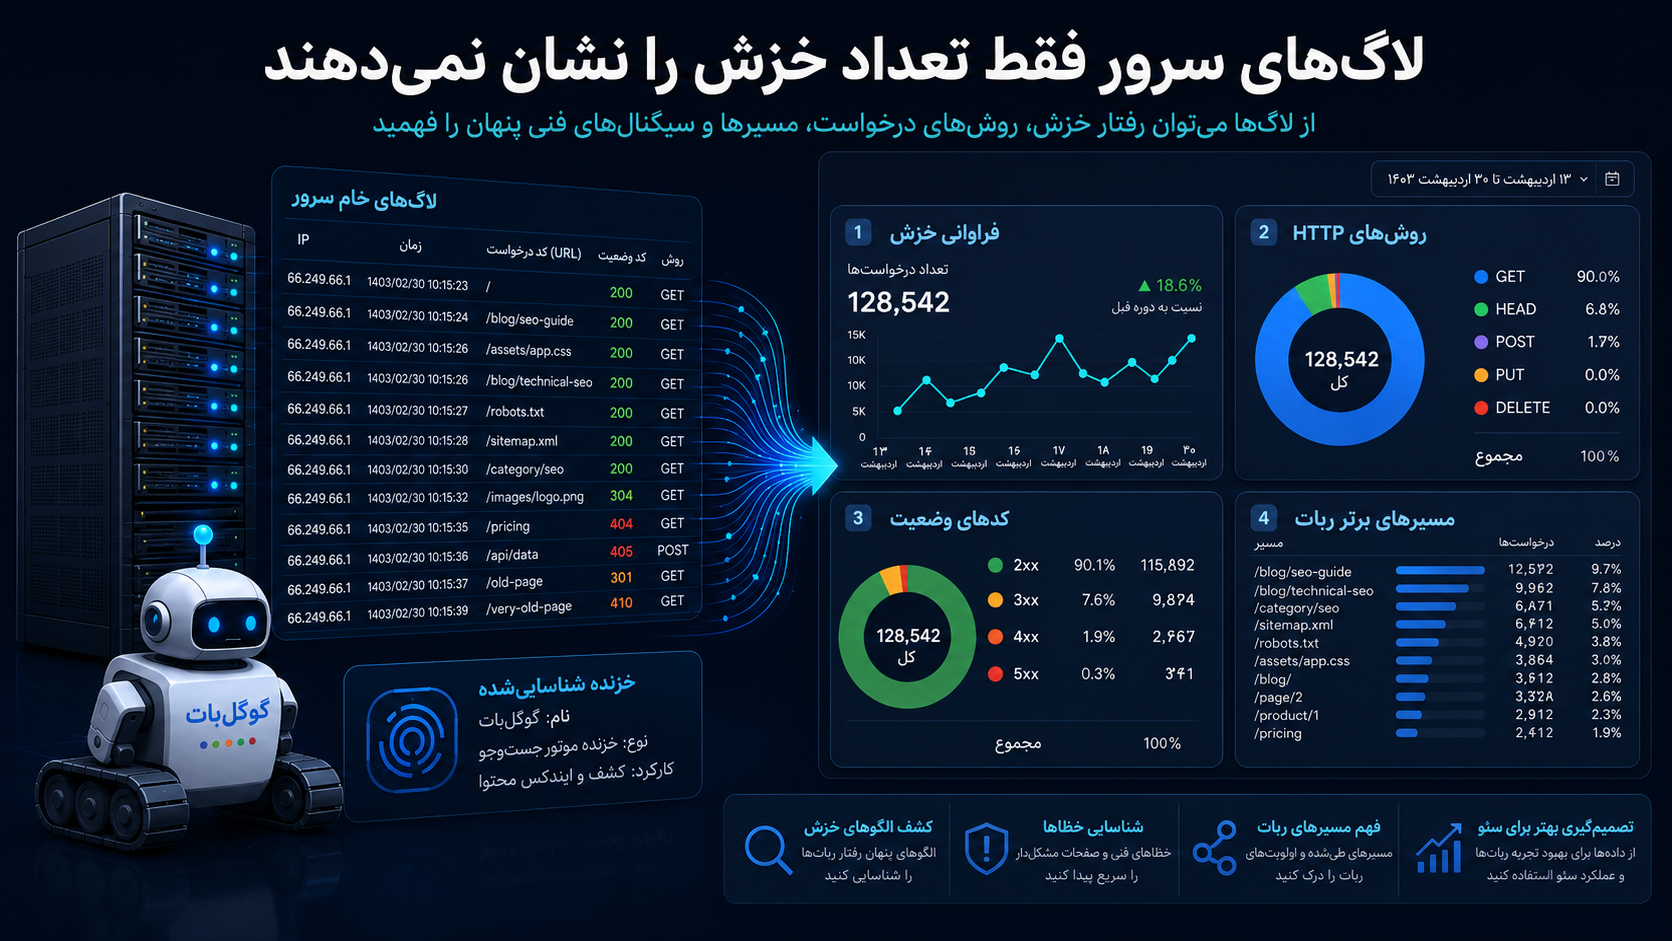
اگر Log Server امکان ثبت Method را دارد، میتوان درخواستهای غیر GET را جدا کرد و بررسی کرد کدام URL یا API مقصد آنها بودهاند. با توجه به اینکه گری ایلیس سهم این Requestها را کمتر از ۱.۵ درصد کل درخواستها اعلام کرده، در بیشتر سایتها احتمالاً حجم زیادی نخواهند داشت؛ همین موضوع بررسی آنها را سادهتر میکند.
وجود چند Request محدود OPTIONS یا HEAD ممکن است کاملاً بیخطر باشد. اما اگر PUT یا DELETE روی Endpointهای حساس دیده میشود، ارزش بررسی دارد که چه JavaScriptی آنها را ایجاد کرده است.
در سایتهای سنتی، بخش زیادی از عملیات حساس پشت Form و Backend قرار داشت و Navigation بیشتر Requestهای GET ایجاد میکرد. در Single Page Applicationها، Client نقش بسیار بزرگتری دارد.
React، Vue یا Angular خودشان علت مشکل نیستند. مسئله معماریای است که معمولاً با این Frameworkها ساخته میشود: Front-end دائماً با API ارتباط دارد و State صفحه از طریق Requestهای متعدد مدیریت میشود.
در چنین محیطی ممکن است یک صفحه عمومی، حتی بدون Interaction آشکار کاربر، چندین Endpoint را فراخوانی کند. همه این Endpointها بخشی از تجربه Rendering محسوب میشوند.
بنابراین در Audit سئو بهتر است سؤال فقط این نباشد که «Googlebot JavaScript را Render میکند؟» سؤال دقیقتر این است: «اگر JavaScript اجرا شود، چه Side Effectهایی ایجاد میکند؟»
یک اصل طراحی خوب این است که صرف مشاهده یا Render یک صفحه تا حد امکان نباید عملیات مخرب یا برگشتناپذیر ایجاد کند.
بازکردن یک مقاله نباید چیزی را حذف کند. مشاهده صفحه محصول نباید وضعیت Inventory را تغییر دهد. اجرای اولیه Component نباید Resource مهمی را Patch کند، مگر اینکه واقعاً بخشی از یک Workflow کنترلشده باشد.
اگر عملیات حساس به Event انسانی نیاز دارد، آن Event باید در Client و Server هر دو بهدرستی مدیریت شود.
این موضوع نه فقط برای Botها، بلکه برای Pre-rendererها، Accessibility Tools، Browser Extensions، Test Automation و سیستمهای مختلفی که صفحه را پردازش میکنند مهم است.
از منبع نمیتوان چنین توصیه عمومیای استخراج کرد. خبر نمیگوید تمام Requestهای PUT، PATCH یا DELETE از Googlebot باید Block شوند. همچنین ممکن است بعضی Requestها بخشی کاملاً مشروع از Rendering یا API عمومی باشند.
راهکار بهتر، امنکردن Endpoint براساس منطق خود برنامه است.
اگر Request نیازمند Authentication است، Server باید Authentication بخواهد. اگر کاربر باید Permission خاصی داشته باشد، Server باید Permission را بررسی کند. اگر عملیات حساس است، سازوکار مناسب برای جلوگیری از اجرای ناخواسته لازم است.
تصمیم امنیتی نباید بر User-Agent بنا شود، چون مسئله فقط Googlebot نیست.
وجود OPTIONS در میان Methodهای ذکرشده چندان عجیب نیست، زیرا Web Applicationها ممکن است برای بعضی درخواستهای Cross-Origin ابتدا Preflight انجام دهند. این بخش بیشتر به رفتار طبیعی Browser و API مربوط است تا اقدام خاص موتور جستوجو.
از منظر Technical SEO، مشاهده OPTIONS میتواند نشان دهد Renderer نیز در حال اجرای همان جریان شبکهای است که Browser واقعی طی میکند.
این نکته دید خوبی درباره ماهیت Google Rendering میدهد: در بسیاری از سناریوها نباید آن را فقط یک Parser پیشرفته HTML تصور کنیم؛ با محیطی روبهرو هستیم که بخشهایی از رفتار صفحه را اجرا میکند.
یکی از خطرهای انتشار چنین خبرهایی تیترهای ترسناک است: «Googlebot میتواند DELETE کند؛ مراقب باشید اطلاعاتتان پاک نشود.» این تیتر جذاب است، اما Context اصلی را حذف میکند.
خود منبع میگوید مجموع Methodهای ذکرشده کمتر از ۱.۵ درصد درخواستهای کرولرهای گوگل را تشکیل میدهند. بنابراین این رفتار بخش بسیار کوچکی از Crawl است.
پیام واقعی باید متناسب با همین اندازه باشد. این موضوع بهانهای برای بازطراحی اضطراری تمام سایتها نیست. برای اکثر سایتهای ساده احتمالاً مسئله عملی خاصی ایجاد نمیکند.
اما برای Web Applicationهایی که JavaScript سنگین و APIهای نوشتنی دارند، یک Check کوچک میتواند ارزشمند باشد.
برای شروع، چند Template اصلی سایت را در Browser باز کنید و Network را ثبت کنید. Methodهای غیر GET و POST را فیلتر کنید و ببینید چه Endpointهایی فراخوانی میشوند.
بعد برای PUT، PATCH و DELETE مشخص کنید چه چیزی Request را Trigger میکند. اگر صرف Page Load باعث ایجاد آن میشود، علت را بررسی کنید. اگر Request بعد از Action کاربر ایجاد میشود، مطمئن شوید Server مجوز را مستقل از Client کنترل میکند.
در مرحله بعد Server Log را بررسی کنید. ببینید User-Agentهای مربوط به Googlebot یا Rendering روی همین مسیرها دیده میشوند یا نه. وجود Request الزاماً مشکل نیست؛ هدف فهمیدن جریان واقعی است.
در نهایت اگر Endpoint حساس است، مسئله را با تیم Backend و Security بررسی کنید. اینجا دیگر اصلاح Meta Tag یا robots.txt پاسخ مناسبی نیست.
این خبر نمونه خوبی از تغییر مرز تخصص Technical SEO است. وب مدرن از صفحه به Application نزدیکتر شده است. بنابراین Search Engine نیز برای فهم صفحه باید با بخشهایی از Application تعامل کند.
متخصص سئویی که فقط HTML Source را بررسی میکند ممکن است بخشی از واقعیت را نبیند. Rendered DOM، Network Requests، API Dependency، Client-side Error و Server Log بهتدریج بخشی از Toolset تحلیل فنی شدهاند.
این به معنی تبدیل متخصص SEO به Backend Engineer نیست، اما توانایی گفتوگو با تیم توسعه اهمیت بیشتری پیدا میکند.
سؤالهای سئو بهتدریج از «آیا Google این لینک را میبیند؟» به «برای دیدن این لینک چه کدی باید اجرا شود و آن کد چه Requestهایی ایجاد میکند؟» تغییر کردهاند.
گفته گری ایلیس درباره HEAD، OPTIONS، PUT، PATCH و DELETE در Crawl گوگل در نگاه اول یک نکته عجیب درباره HTTP به نظر میرسد، اما پیام اصلی آن درباره JavaScript است. موتور Rendering میتواند کد صفحه را اجرا کند و همان کد ممکن است Requestهایی فراتر از دریافت ساده محتوا ایجاد کند.
با توجه به اینکه مجموع این Methodها کمتر از ۱.۵ درصد درخواستهاست، نباید ماجرا را به یک بحران عمومی SEO تبدیل کرد. اما سایتهایی که Web Application پیچیده، JavaScript سنگین و Endpointهای حساس دارند باید یک اصل را جدی بگیرند: امنیت و مجوز عملیات باید در سمت Server تعریف شوند.
Googlebot نباید بتواند فقط بهدلیل Render کردن یک صفحه عمومی، کاری مخرب انجام دهد. درواقع هیچ Client دیگری هم نباید بتواند.
از دید سئو، درس بزرگتر این است که Crawl مدرن دیگر فقط درباره دریافت HTML نیست. هرچه وب بیشتر به نرمافزار تبدیل میشود، Technical SEO نیز باید رفتار نرمافزار را بیشتر بفهمد.
تهیه شده توسط تیم تخصصی سئو سید احسان خسروی (مدیر، متخصص و مشاور استراتژیک سئو)

