
جستوجو همیشه به معنای پیدا کردن «بهترین یک چیز» نیست. گاهی از موتور جستوجو یک فهرست میخواهیم که اجزایش در کنار هم معنا پیدا کنند. درخواست «وسایل کمپینگ» نمونه خوبی است. اگر سامانه ده چادر معرفی کند، بهظاهر ده پاسخ مرتبط داده است؛ اما برای یک سفر، چراغ، کیسهخواب و اجاق هم لازم است. در پژوهش تازه گوگل ریسرچ، کیفیت جستوجو به همین پرسش وابسته میشود: آیا مجموعه نتیجهها در کنار هم نیاز کاربر را پوشش میدهند؟
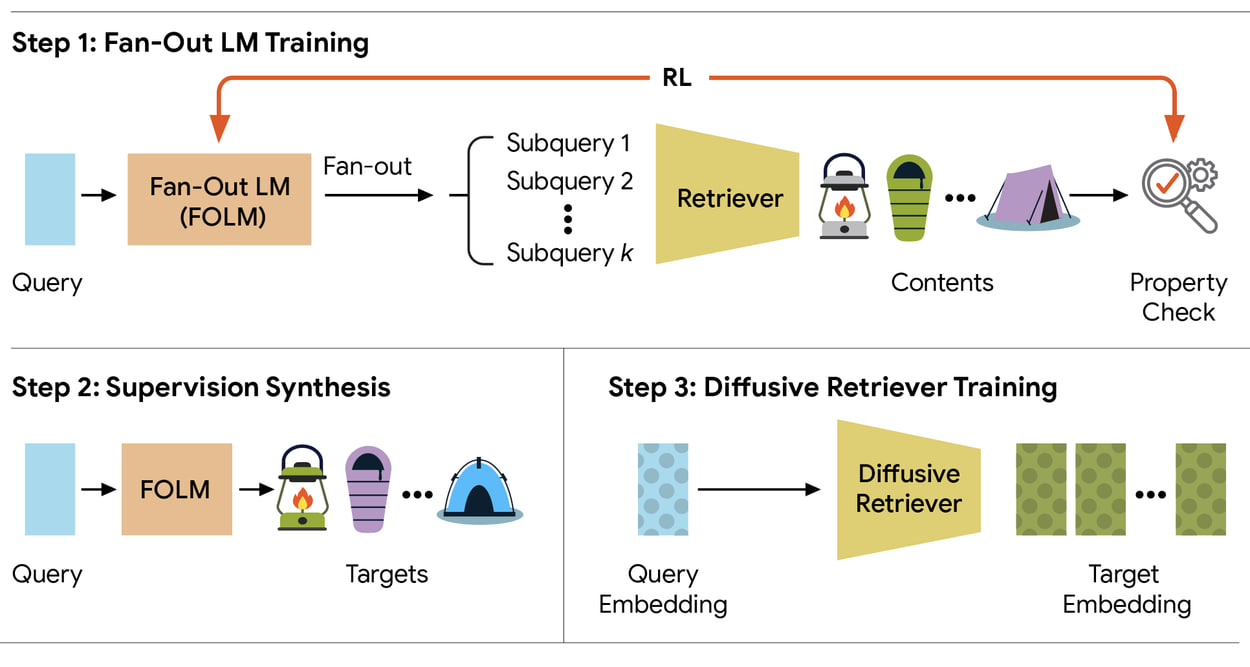
پژوهشگران در چارچوب «بازیابی برای آموزش» روشی را آزمایش کردهاند که بخش دشوار طراحی مسیرهای جستوجو را در مرحله آموزش انجام میدهد. هنگام دریافت درخواست واقعی، مدل کوچکتری آن آموخته را با سرعت بیشتر اجرا میکند. این تصویر کلی روش است؛ اما جذابیت مقاله در جزئیات آن نهفته است. نویسندگان توضیح میدهند چرا مدل زبانی معمولی به دام عبارتهای مترادف میافتد، چگونه پاداش طراحی میکنند تا مدل از دادههای واقعی دور نشود، و چرا سرعت یک مرحله خاص را نباید با سرعت کل موتور جستوجو یکی گرفت.
فرض کنید کسی برای یک مهمانی دنبال «استایل بوهمی» باشد. اگر نتیجهها فقط چند پیراهن با رنگهای نزدیک نشان دهند، شاید هر پیراهن به موضوع مربوط باشد؛ ولی از کفش، کت و سایر اجزای استایل خبری نیست. گوگل در مقاله خود از نمونهای در همین حوزه پوشاک استفاده میکند تا نشان دهد ارتباط موردی با کیفیت یک مجموعه برابر نیست. یک فهرست میتواند از تکتک اجزای مناسب ساخته شده باشد و در عین حال، به دلیل تکرار، انتخابهای مفیدی پیش روی کاربر نگذارد.
این تفاوت را در پیشنهاد موسیقی نیز میتوان فهمید. شنونده ممکن است قطعاتی با حالوهوای مشخص بخواهد، اما فهرستی از چند آهنگ تقریباً یکسان برای شنیدن طولانی خستهکننده باشد. از آن طرف، قطعاتی بسیار نامرتبط انسجام فهرست را از بین میبرند. در هر دو مثال، سامانه باید چیزی را بسنجد که متعلق به یک مورد منفرد نیست: رابطه نتیجهها با یکدیگر. مفاهیمی مانند تنوع و مکملبودن، وقتی معنا دارند که کل مجموعه را ببینیم.
پژوهشگران این نوع مسئله را «بازیابی مجموعهای» مینامند. این اصطلاح ممکن است پیچیده به نظر برسد، اما پرسش پشت آن ساده است: اگر خروجی چند مورد باشد، آیا باید هر مورد را جداگانه خوب بدانیم، یا کیفیت جمع را نیز بسنجیم؟ پاسخ روشن است؛ کسی که برای سفر آماده میشود، از فهرستی شامل چند وسیله متفاوت و هماهنگ بیشتر سود میبرد. دشواری از جایی شروع میشود که بخواهیم این شهود انسانی را به هدفی قابل آموزش برای مدل تبدیل کنیم.
برای پوشش چند جنبه از یک درخواست، سامانه میتواند آن را به چند پرسوجوی فرعی بشکند. از «وسایل کمپینگ» به «چادر»، «کیسهخواب»، «چراغ» و «اجاق» برسد و بعد نتیجههای هر مسیر را کنار هم بگذارد. این همان ایده گسترش پرسوجو است. گوگل پیشتر توضیح داده که برخی قابلیتهای جستوجوی هوش مصنوعی نیز برای سؤالهای پیچیده از چند جستوجوی مرتبط استفاده میکنند. اما داشتن چنین ایدهای با اجرای سریع و دقیق آن در یک مجموعه داده مشخص فرق دارد.
مدل زبانی آماده ممکن است به جای کشف جنبههای مکمل، فقط عبارت اصلی را بازنویسی کند. «پوشاک بوهمی جشنواره»، «لباس جشنواره بوهمی» و «مد جشنواره با سبک بوهمی» سه رشته متفاوتاند، اما شاید هر سه به یک دسته نزدیک از نتیجهها برسند. در متن پژوهش، این وضعیت بهعنوان فروپاشی به بازنویسیهای مترادف توصیف میشود. فراوانی عبارتها بهتنهایی تنوع نتیجه نمیسازد؛ باید دید جستوجو واقعاً به چه قلمروهای متفاوتی از داده دسترسی پیدا کرده است.
مشکل دیگری هم وجود دارد. مدل میتواند مسیرهایی خلاقانه و متنوع پیشنهاد کند که در دادههای مورد جستوجو هیچ نتیجهای ندارند. اگر فروشگاه چادر سبک خاصی را عرضه نمیکند، گسترش درخواست به آن کالا هرچند از نظر زبانی معقول باشد، به کاربر کمک نمیکند. بنابراین مسیر خوب باید سه ویژگی را با هم داشته باشد: به خواسته اولیه مربوط باشد، نسبت به مسیرهای دیگر تفاوت معنادار داشته باشد و در دادههای موجود چیزی برای بازیابی پیدا کند.
یک راه این است که برای هر جستوجو از مدل زبانی قدرتمندی بخواهیم ابتدا فکر کند و بعد مسیرهای مناسب را فهرست کند. مدل میتواند چند احتمال را بررسی کند، موارد تکراری را کنار بگذارد و از نظر منطقی به خروجی خوبی برسد. اما این روش بهای زمانی دارد. مدلهای زبانی خروجی را بهصورت ترتیبی میسازند؛ هر مرحله برنامهریزی و هر بخش متن قبل از مرحله بعد تولید میشود. هزینه زمانی هنگامی بیشتر به چشم میآید که سامانه در مقیاس زیاد و برای درخواستهای همزمان کار کند.
در یک گفتوگوی طولانی شاید چند لحظه انتظار قابل قبول باشد. اما وقتی کسی روی نوار جستوجو میزند و انتظار دارد همانجا کالا، موسیقی یا تصویر مرتبط ببیند، تأخیر مسئله دیگری است. مقاله گوگل این مانع را گلوگاه استنتاج مینامد: مدلی که برای پیدا کردن مسیرها خوب فکر میکند، هنگام استفاده زنده کند و پرهزینه میشود. پژوهشگران نمیخواهند کیفیت را قربانی سرعت کنند؛ میخواهند زمان انجام بخش پرهزینه کار را عوض کنند.
ایده اصلی را میتوان با تمرین پیش از اجرا توضیح داد. راهنمایی که پیشتر هزاران بار مسئلههای مشابه را بررسی کرده، لازم نیست هنگام هر درخواست دوباره تمام مسیرهای ناموفق را امتحان کند. البته مدل رایانهای مانند انسان تجربه شخصی ندارد؛ این فقط یک تشبیه برای فهم جابهجایی محاسبه است. در روش پژوهشگران، آزمودن پاداشها و کشف مسیرهای مناسب آفلاین انجام میشود و نتیجه آن به مدلی منتقل میشود که پاسخ زنده را سریعتر میسازد.
گام نخست، آموزش مدل زبانی با یادگیری تقویتی است. مدل از یک درخواست کلی، چند مسیر فرعی پیشنهاد میکند و به خاطر کیفیت مجموعه آنها پاداش میگیرد. تفاوت این پاداش با امتیازدادن ساده به هر نتیجه در آن است که میتواند تکراریبودن کل فهرست را تشخیص دهد. در آزمایشها، مدل زبانی برای هر درخواست ده مسیر فرعی تولید میکرد. این عدد یک تنظیم پژوهشی است و برای ساختار مقالههای وب نسخه عمومی تجویز نمیکند.
گام دوم، ساخت نمونههای آموزشی با کمک همان مدل آموزشدیده است. مدل جفتهایی از درخواست و مجموعه هدف تهیه میکند تا مدل بعدی بتواند رفتار مطلوب را بیاموزد. این نمونهها پیش از درخواست کاربران ساخته میشوند؛ بنابراین زمان لازم برای ساخت آنها به زمان پاسخگویی زنده اضافه نمیشود. متن پژوهش میگوید برای تهیه این جفتها در چارچوب مورد بررسی از برچسبهای دستی استفاده نشده است. این ادعا فقط درباره این مرحله مشخص است و ارزیابی انسانی یک محصول را نفی نمیکند.
گام سوم، آموزش یک بازیاب مبتنی بر روش انتشار با حدود ۵۳٫۹ میلیون پارامتر است. بازیاب از نمایش عددی درخواست به مجموعهای از نمایشهای هدف میرسد. برای مخاطب عمومی، نکته مهم این است که مدل به جای نوشتن چند پرسوجوی متنی پشت سر هم، چند جهت بازیابی را به شکل موازی ایجاد میکند. مسیرهای مناسب قبلاً در دوره آموزش کشف شدهاند؛ هنگام استفاده، مدل کوچکتر رفتار حاصل را اجرا میکند و به گامهای متنی طولانی مدل بزرگ نیاز ندارد.
پژوهشگران برای مدل زبانی سه شرط تعریف کردهاند. نخست، مسیرها باید به موارد قابل یافتن در پایگاه داده نزدیک باشند. دوم، کل مسیرها باید از نظر معنایی متنوع باشند. سوم، همه آنها باید به خواسته اولیه ارتباط داشته باشند. اگر فقط شرط اول را در نظر بگیریم، ممکن است مدل رشتههایی عجیب اما قابل انطباق با دادهها بسازد. اگر فقط ارتباط را اضافه کنیم، باز هم میتواند یک عبارت را با چند شکل تقریباً یکسان تکرار کند.
برای جلوگیری از این میانبرها، تنوع نقش مهارکننده دارد. مقاله از معیار وندی برای سنجش تنوع مجموعه استفاده میکند؛ معیاری که در تابع پاداش آزمایش به کار رفته است. نتیجه جالب است: خواستن «تنوع بیشتر» کافی نیست، چون تنوع بیارتباط نیز کیفیت نمیآورد. مدل باید در محدودهای کار کند که هم به درخواست وفادار باشد، هم در داده واقعی چیزی پیدا کند و هم فهرستش از چند نسخه نزدیک یک پاسخ تشکیل نشده باشد.
این بخش را نباید با راهنمایی رسمی برای رتبهبندی صفحات اشتباه گرفت. سه شرط، اجزای هدف آموزشی یک مدل بازیابی آزمایشیاند. پژوهش گوگل نگفته است موتور جستوجوی عمومی دقیقاً همین پاداش را برای سایتها محاسبه میکند. میتوان از روش طراحی پاداش درس عمومی گرفت: هر معیاری اگر بهتنهایی دنبال شود، ممکن است نتیجه نامطلوب بدهد. اما این درس، جای مدرک درباره شیوه رتبهبندی صفحات وب را نمیگیرد.
پژوهش روی دادههای پوشاک و فهرستهای موسیقی انجام شده است. در این دو حوزه، ترکیب موارد بخشی از کیفیت پاسخ است. نویسندگان همچنین دو وضعیت را آزمودهاند: یکی جستوجوی باز که پاسخ درست یگانهای ندارد و دیگری وضعیتی که یک مجموعه مرجع ضعیف برای مقایسه فراهم است. وجود مرجع ضعیف به این معنی است که ممکن است چند مجموعه متفاوت، هرکدام از جهتی پاسخ پذیرفتنی به یک درخواست باشند.
گوگل گزارش میکند روش پیشنهادی در معیارهای کیفیت بازیابی از چند روش مقایسهای بهتر بوده است. مدل کوچکتر برای مرحله گسترش جستوجو نیز در شرایط آزمایش حدود ۱۲ تا ۲۰ برابر رویکردهای ترتیبیِ مقایسهشده سرعت داشته است. این عدد از عنوانهای خبری بزرگی مانند «جستوجوی گوگل بیست برابر سریع شد» پشتیبانی نمیکند؛ چون نه زمان کل محصول اندازهگیری شده و نه آزمایش روی همه پرسشهای وب صورت گرفته است. نسبت سرعت، نام مرحله و دامنه آزمون باید همیشه با هم گفته شوند.
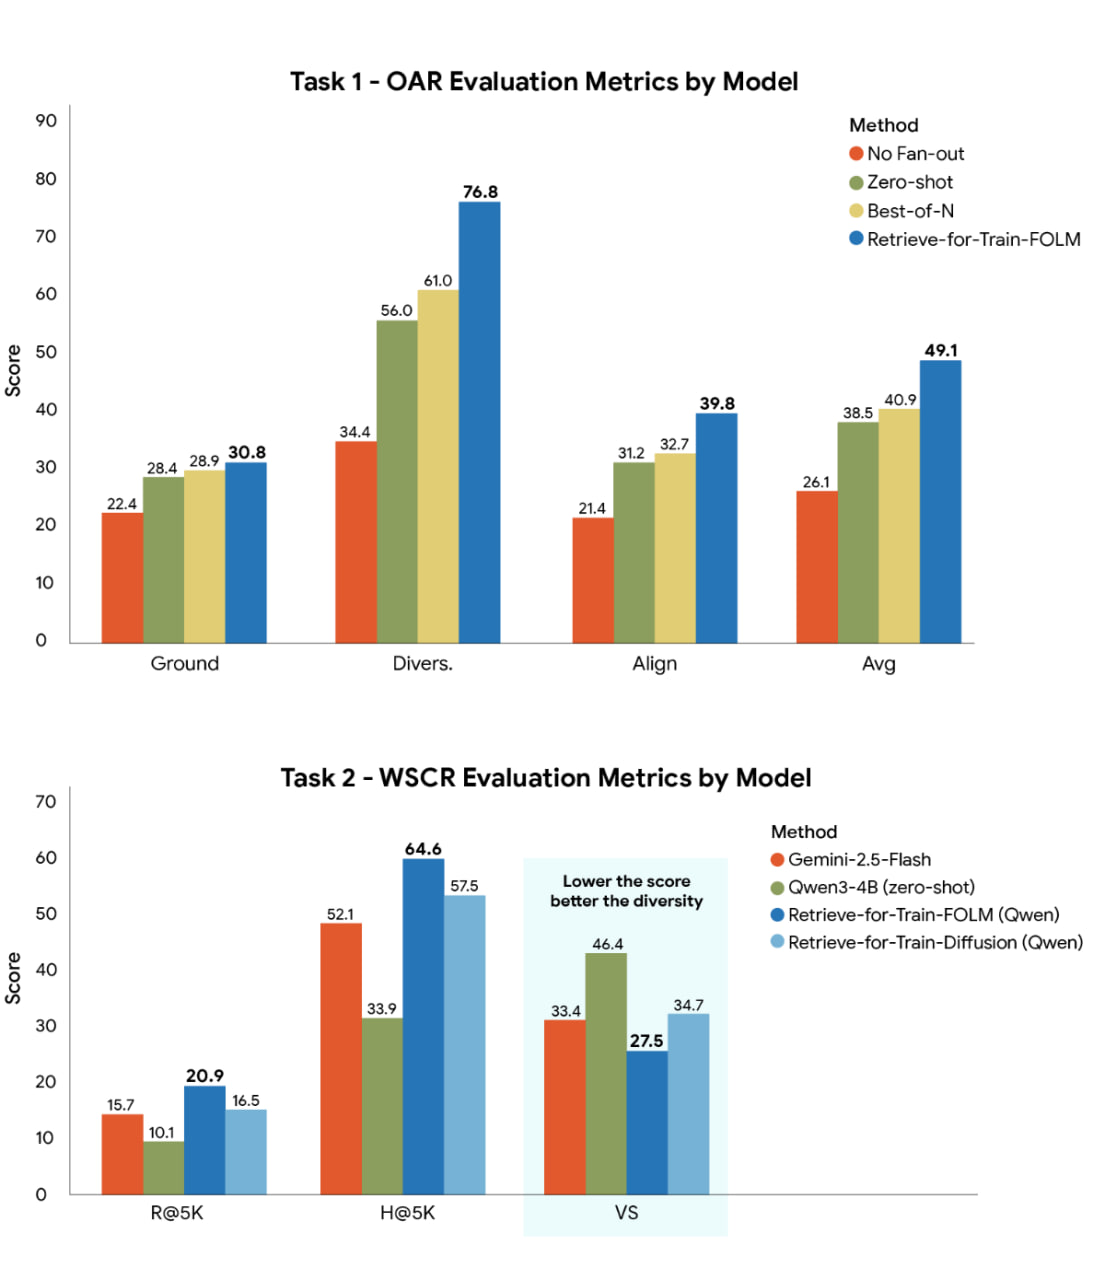
نمودار نتیجهها نیز برای خواندن دقیق به نام معیارها نیاز دارد. تنوع، ارتباط، قابلیت بازیابی و بازیافت موارد مناسب، جنبههای متفاوتاند. اگر یک ستون بهتر باشد، باید پرسید آن ستون چه چیزی را سنجیده و در کدام نوع مسئله گزارش شده است. هیچیک از ستونهای این نمودار درباره رتبه یک سایت خبری یا شمار ارجاعهای پاسخهای هوش مصنوعی به یک ناشر نیست. این مرزبندی شاید از خود عدد سرعت کمتر هیجانانگیز باشد، اما خبر درست را از برداشت شتابزده جدا میکند.
از این پژوهش نمیتوان دستورالعمل مستقیم سئو بیرون کشید، اما میتوان یک سؤال مفید برای کار تحریریه گرفت: آیا مجموعه پاسخهای ما، مجموعهای مکمل است؟ اگر درباره «شروع دویدن» ده مقاله داشته باشیم و همه فقط یک تعریف مقدماتی را بازگو کنند، تعداد صفحات زیاد شده اما نیازهایی مانند برنامه تمرین، انتخاب کفش و پیشگیری از فشار بیش از اندازه بیپاسخ ماندهاند. این نمونه برای توضیح کار محتواست و در آزمایش گوگل وجود ندارد.
برای استفاده از این پرسش، ابتدا نیاز اصلی خواننده را مشخص کنید. سپس زیرموضوعهایی را نگه دارید که واقعاً به تصمیم یا فهم او کمک میکنند. صفحهای که به سؤال اصلی جواب نمیدهد اما از ده موضوع حاشیهای حرف میزند، فقط ظاهراً متنوع است. برعکس، صفحهای که عنوانهای فراوان دارد اما زیر همه آنها یک مفهوم را تکرار میکند، پوشش واقعی ندارد. تعادل میان ارتباط و تنوع، یک معیار تحریریه است؛ نه عامل رتبهبندی تازهای که مقاله پژوهشی اعلام کرده باشد.
میتوان این بررسی را با چند سؤال کوتاه انجام داد:
پاسخ این پرسشها باید از محتوای واقعی سایت به دست آید. اگر داده دستاول وجود ندارد، تحلیل دقیق منبع معتبر بهتر از ساختن تجربه یا نتیجه آزمایش جعلی است. اگر موضوعی به یک مقاله مستقل نیاز ندارد، افزودن صفحه تازه صرفاً برای پرکردن خوشه محتوایی ممکن است خواننده را میان پاسخهای تکراری سرگردان کند. این تصمیمها به هدف مخاطب و داده سایت بستگی دارند و از نمودارهای پژوهش به شکل خودکار استخراج نمیشوند.
نخست اینکه استفاده از همین چارچوب در جستوجوی عمومی گوگل اعلام نشده است. گوگل در معرفی برخی محصولات خود درباره گسترش پرسوجو صحبت کرده، اما وجود یک ایده مشترک میان مقاله و محصول به معنی اجرای دقیق همان مدل نیست. دوم اینکه آزمونها بر مجموعههای پوشاک و موسیقی انجام شدهاند، نه بر رتبهبندی زنده صفحات وب. سوم اینکه سرعت گزارششده به یک مرحله محدود است و نمیدانیم در هر محصول واقعی، آن مرحله چه سهمی از زمان کل پاسخ خواهد داشت.
برای سایتها، سند مناسب تصمیمهای اجرایی همچنان راهنمای رسمی جستوجوی گوگل است. آن راهنما بر اصولی مانند دسترسپذیری فنی، محتوای مفید، ساختار روشن و امکان یافتن متن مهم تأکید میکند. پژوهش حاضر میتواند فهم ما را از مسئله بازیابی عمیقتر کند، اما وعدهای درباره افزایش بازدید یا استناد به صفحه خاصی نمیدهد. اگر روزی آزمایش مستقلی اثر روش را بر محصولات جستوجو نشان دهد، آن وقت میتوان درباره پیامدهایش برای ناشران دقیقتر حرف زد.
پژوهش «بازیابی برای آموزش» میگوید ساخت مجموعهای خوب از نتیجهها نیازمند توجه به رابطه میان آنهاست. برای رسیدن به این هدف، پژوهشگران یادگیری پرهزینه را پیش از لحظه جستوجو انجام دادهاند و اجرای زنده را به مدل کوچکتری سپردهاند. بهبود کیفیت و سرعت گزارششده در آزمایشهای پوشاک و موسیقی معنا دارد؛ نتیجههای فراتر از آن هنوز به شواهد جداگانه نیاز دارند.
برای خواننده حوزه محتوا، ارزش مقاله در یک جمله ساده خلاصه میشود: وقتی کسی یک مسئله چندوجهی دارد، پاسخهای زیاد اما شبیه به هم به اندازه پاسخهای مکمل مفید نیستند. اگر این فهم را با دقت علمی همراه کنیم، نه از یک پژوهش فنی «قانون جدید سئو» میسازیم و نه فرصت فکرکردن بهتر به نیاز واقعی مخاطب را از دست میدهیم.
تهیه شده توسط تیم تخصصی سئو سید احسان خسروی (مدیر، متخصص و مشاور استراتژیک سئو)

