
صفحهای را تصور کنید که از نظر بسیاری از معیارهای شناختهشده سئو وضعیت مناسبی دارد: عبارت هدف در عنوان و متن استفاده شده، ساختار محتوا منظم است، چند لینک معتبر به صفحه اشاره میکنند و موضوع نیز با جستوجوی کاربر مرتبط بهنظر میرسد. بااینحال، وقتی نتایج گوگل را بررسی میکنید، آن صفحه نه در رتبه اول، بلکه پایینتر از چند رقیب ظاهراً ضعیفتر قرار گرفته است.
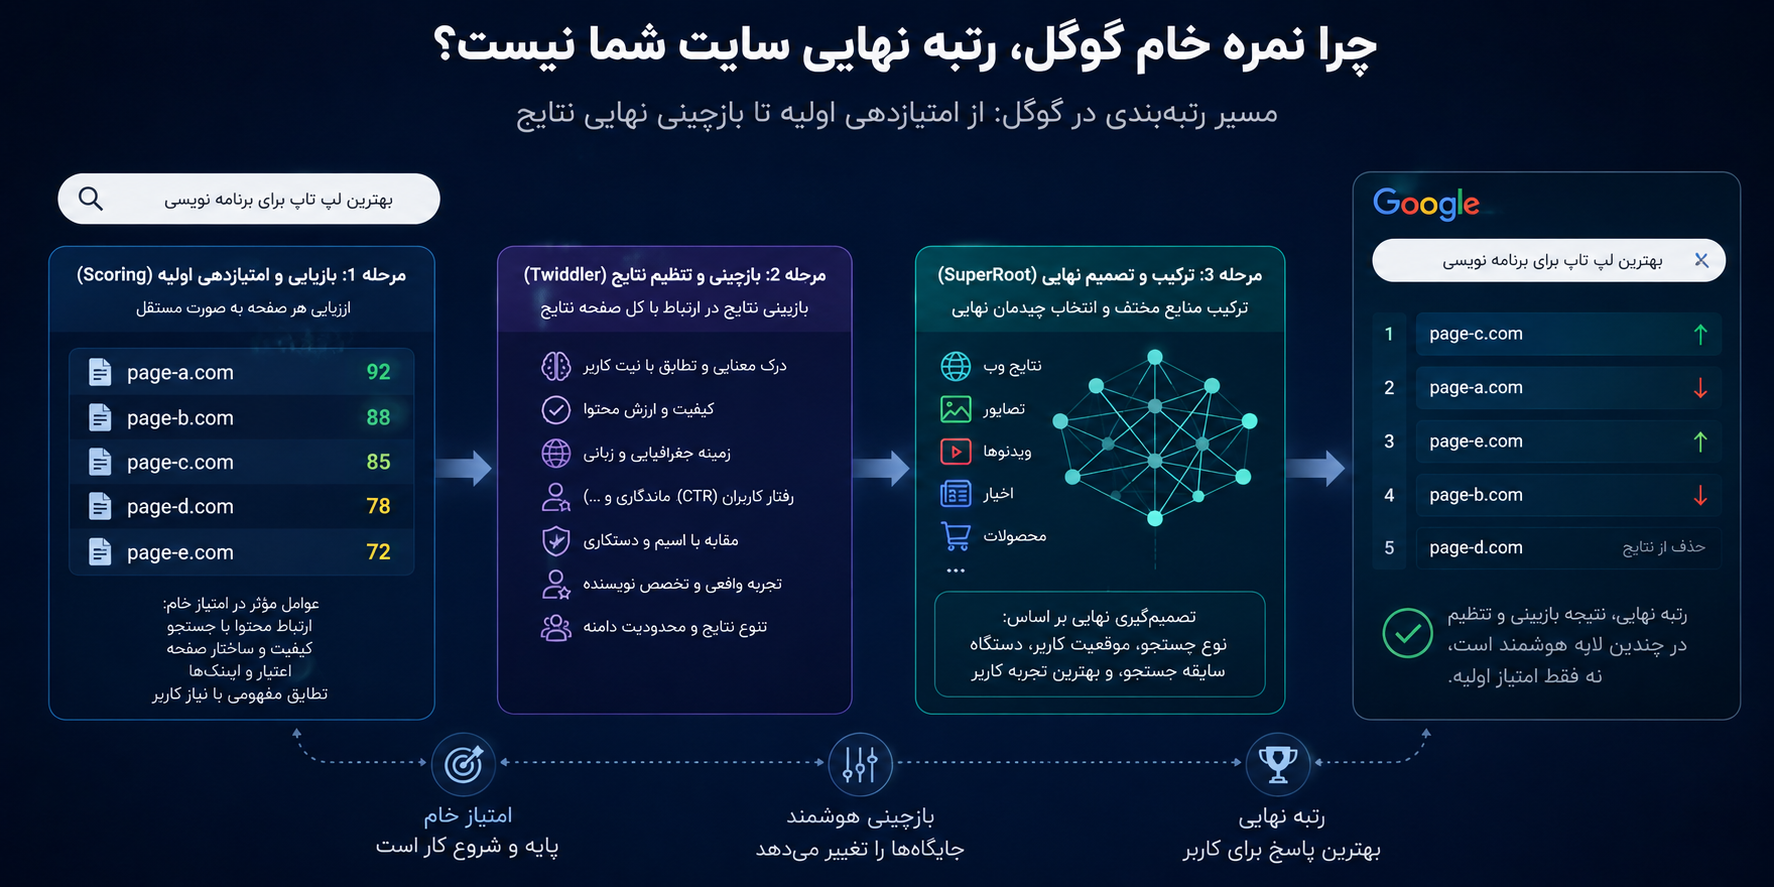
در چنین شرایطی، معمولاً تحلیلها به مجموعهای از توضیحات تکراری محدود میشوند: «بکلینک کافی نیست»، «مقاله کوتاه است»، «تعداد کلمات کلیدی کم است» یا «اعتبار دامنه پایین است». هرکدام از این موارد ممکن است بخشی از مسئله باشند، اما یک فرض پنهان در تمام این تحلیلها وجود دارد: اینکه گوگل هر صفحه را یکبار امتیازدهی میکند و نتایج نهایی دقیقاً براساس همان امتیاز چیده میشوند.
اسناد فنی منتشرشده درباره معماری جستوجوی گوگل، در کنار شهادتهای ارائهشده در پرونده ضدانحصار ایالات متحده، تصویر پیچیدهتری نشان میدهند. در این تصویر، رتبهبندی گوگل یک محاسبه تکمرحلهای نیست؛ بلکه فرایندی چندلایه است که در آن اسناد ابتدا بازیابی و امتیازدهی میشوند و سپس مجموعه نتایج میتواند چندین بار فیلتر، مقایسه و بازچینی شود.
بنابراین، امتیازی که یک صفحه در ابتدای مسیر دریافت میکند، الزاماً همان جایگاهی نیست که کاربر در صفحه نتایج مشاهده خواهد کرد.
نکته مرکزی این مقاله: در سئوی مدرن، بالا بردن امتیاز اولیه کافی نیست؛ صفحه باید در لایههای بعدی ارزیابی و بازچینی نیز شایستگی خود را حفظ کند.
مدل ساده رتبهبندی میگوید گوگل برای هر سند یک امتیاز محاسبه میکند، سپس صفحات را از بیشترین امتیاز تا کمترین مرتب میکند. این مدل برای درک ابتدایی موتورهای جستوجو مفید است، اما نمیتواند بسیاری از تغییرات واقعی صفحه نتایج را توضیح دهد.
برای مثال، ممکن است یک دامنه چند صفحه بسیار مرتبط با یک عبارت داشته باشد. اگر گوگل تنها براساس امتیاز مستقل صفحات تصمیم بگیرد، احتمال دارد بخش بزرگی از نتایج توسط همان دامنه اشغال شود. در عمل، موتور جستوجو باید عواملی مانند تنوع منابع، نوع محتوا، موقعیت جغرافیایی، تازگی، کیفیت تجربه و الگوهای رفتاری را نیز در نظر بگیرد.
همچنین صفحه نتایج فقط شامل لینکهای آبی سنتی نیست. تصویر، ویدئو، خبر، محصول، نقشه، پاسخ مستقیم و قالبهای دیگر ممکن است برای یک جستوجو مناسب باشند. در نتیجه، گوگل علاوه بر انتخاب بهترین سند، باید درباره ترکیب نهایی صفحه نیز تصمیم بگیرد.
همین موضوع نشان میدهد که دو پرسش متفاوت در فرایند جستوجو مطرح است:
این صفحه بهتنهایی تا چه اندازه با جستوجوی کاربر مرتبط است؟
این صفحه در کنار سایر نتایج، چه جایگاهی باید داشته باشد؟
پرسش اول به امتیازدهی اولیه نزدیک است؛ پرسش دوم وارد قلمرو بازچینی نتایج میشود.
در راهنمای داخلی «Twiddler Quick Start Guide» که به معماری SuperRoot مربوط است، میان امتیازدهی اولیه و بازچینی نتایج تفاوت مشخصی دیده میشود. براساس این سند، چارچوب توییدلر روی یک توالی از پیش مرتبشده عمل میکند؛ یعنی برخلاف موتور امتیازدهی اولیه که نتایج را تا حدی بهصورت مستقل ارزیابی میکند، توییدلر با کل فهرست رتبهبندیشده سروکار دارد.
در مرحله نخست، سیستم باید مشخص کند کدام اسناد اساساً با کوئری ارتباط دارند و هرکدام چه امتیاز اولیهای دریافت میکنند. عواملی مانند تطابق واژگانی، ارتباط معنایی، اعتبار لینکها، ساختار سند و سیگنالهای دیگر میتوانند در این مرحله دخیل باشند.
هدف این بخش، ساختن یک فهرست اولیه از پاسخهای محتمل است. اما این فهرست هنوز الزاماً برای نمایش مستقیم به کاربر آماده نیست.
لایه بازچینی، صفحه را فقط بهعنوان یک سند منفرد نمیبیند. این لایه میتواند بررسی کند که حضور آن نتیجه چه اثری بر ترکیب کلی صفحه دارد، آیا نتیجه مشابه دیگری پیش از آن قرار گرفته، آیا تعداد زیادی صفحه از یک دامنه دیده میشود یا آیا نوع دیگری از محتوا پاسخ بهتری ارائه میدهد.
در سند فنی توییدلر، این چارچوب بهعنوان بخشی از SuperRoot توصیف شده است؛ درحالیکه Universal Packer وظیفه ترکیب نتایج متعلق به منابع یا پیکرههای مختلف، مانند وب و تصویر، را بر عهده دارد.
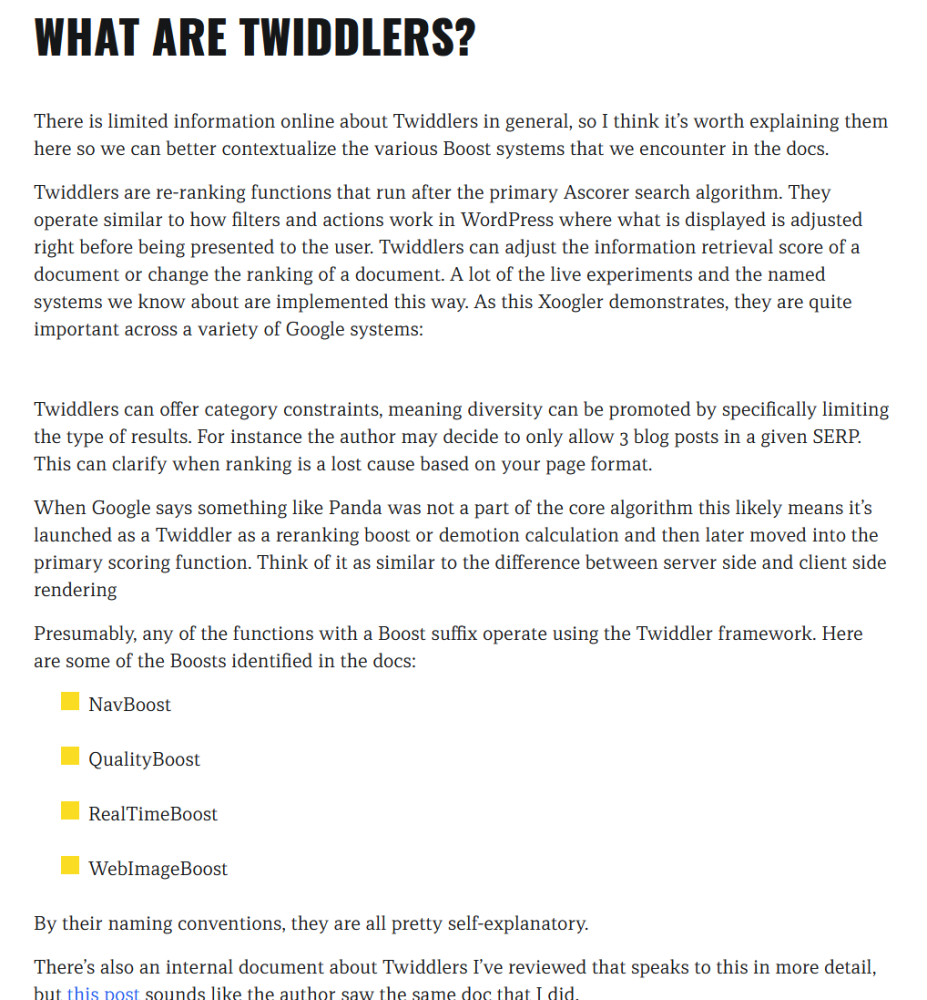
نکته مهم این است که سند منتشرشده به سال ۲۰۱۸ مربوط است. بنابراین نباید با قطعیت فرض کرد که تمام نامها، تعداد اجزا یا جزئیات اجرایی آن بدون تغییر در سیستم فعلی گوگل باقی ماندهاند. ارزش این سند بیشتر در آشکار کردن یک اصل معماری است: رتبهبندی اولیه و چیدمان نهایی الزاماً یک مرحله واحد نیستند.
توییدلر را میتوان بهصورت ساده یک تنظیمکننده رتبه دانست؛ اما نقش آن فقط افزودن یا کمکردن یک عدد نیست. سند فنی نشان میدهد که توییدلرها میتوانند پیشنهادهایی برای تغییر ترتیب نتایج ارائه دهند و چارچوب مرکزی، این پیشنهادها و محدودیتها را با یکدیگر هماهنگ کند.
در عمل، نتیجه این پردازش میتواند یکی از حالتهای زیر باشد:
یک صفحه چند جایگاه ارتقا پیدا کند؛
یک صفحه به رتبههای پایینتر منتقل شود؛
نتیجهای از بخش قابل نمایش حذف شود؛
تعداد نتایج متعلق به یک دسته یا دامنه محدود شود؛
نوع دیگری از محتوا جای بخشی از نتایج وب را بگیرد.
در راهنمای فنی، دو نوع کلی برای توییدلرها بیان شده است:
Predoc Twiddler روی پاسخهای سبکتر و قبل از دریافت همه جزئیات سند اجرا میشود. این نوع میتواند روی تعداد بیشتری از نتایج و با سرعت بالاتر عمل کند.
Lazy Twiddler پس از دریافت اطلاعات کاملتر درباره بخشی از نتایج فعال میشود. در این مرحله، سیستم داده بیشتری در اختیار دارد، اما پردازش روی مجموعه محدودتری از اسناد انجام میشود.
این تفکیک از نظر سئو اهمیت دارد؛ زیرا نشان میدهد حذف یا تنزل یک نتیجه میتواند در نقاط مختلف خط پردازش اتفاق بیفتد. صفحهای ممکن است در یک مرحله وارد فهرست شود، اما در مرحلهای دیگر جایگاه خود را از دست بدهد.
یکی از مفاهیم قابلتوجه در سند توییدلر، محدودیت دستهای است. سیستم میتواند برای یک گروه خاص از نتایج محدودیت تعیین کند؛ برای مثال، تعداد نتایج متعلق به یک قالب یا یک منبع را کنترل کند.
این موضوع به درک بهتر «تنوع دامنه» کمک میکند. حتی اگر سه صفحه از یک سایت امتیازهای اولیه بالایی داشته باشند، نمایش هر سه در رتبههای نخست همیشه بهترین تجربه برای کاربر نیست. ممکن است موتور جستوجو ترجیح دهد منابع متفاوتی را ارائه کند تا کاربر با دیدگاهها و گزینههای بیشتری روبهرو شود.
در چنین سناریویی، پایین آمدن صفحه دوم یک دامنه الزاماً به معنای ضعیف بودن آن صفحه نیست؛ ممکن است نتیجه محدودیتی باشد که روی ترکیب کلی صفحه اعمال شده است.
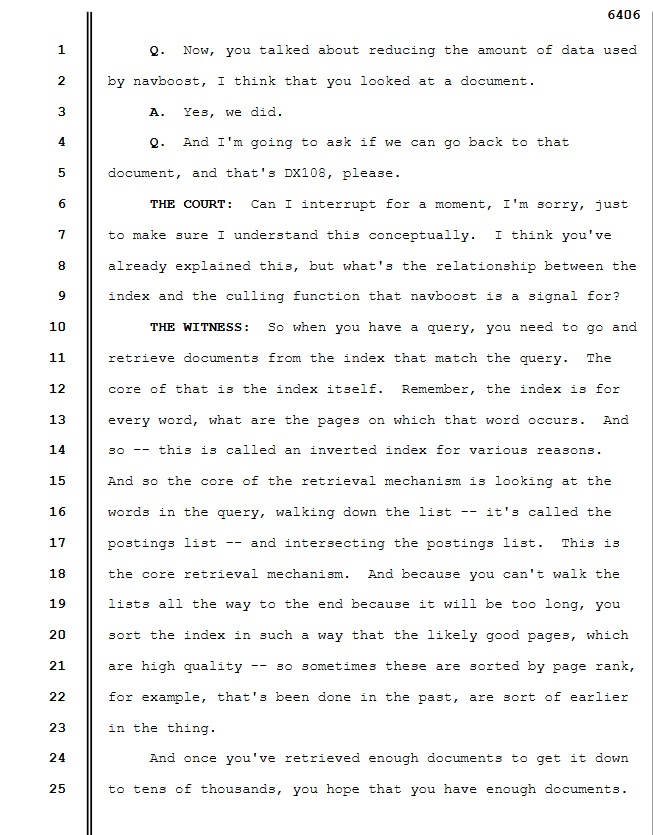
در بحث رفتار کاربر، یکی از پرتکرارترین نامها NavBoost است. شهادت پاندو نایک، از مدیران ارشد جستوجوی گوگل، نشان داد که NavBoost از دادههای مرتبط با کوئری و سند استفاده میکند و در بخشهای مختلف فرایند بازیابی و رتبهبندی نقش دارد. متن دادگاه همچنین به استفاده از دادههای کوئری و کلیک در آموزش برخی مدلهای رتبهبندی اشاره میکند.
اما تبدیل این اطلاعات به جمله ساده «هرچه نرخ کلیک بیشتر باشد، رتبه بالاتر میرود» برداشت دقیقی نیست. دادههای رفتاری باید در زمینه خود تفسیر شوند.
برای نمونه، کلیک بالا ممکن است نتیجه یک عنوان گمراهکننده باشد. کاربر وارد صفحه میشود، پاسخ را پیدا نمیکند و بلافاصله به نتایج بازمیگردد. در مقابل، صفحهای دیگر ممکن است کلیک کمتری دریافت کند، اما کاربرانی که وارد آن میشوند نیاز خود را بهطور کامل برطرف کنند.
بنابراین، تحلیل رفتار کاربر باید فراتر از یک شاخص منفرد باشد و به مسیر کامل جستوجو توجه کند:
کاربر با چه عبارتی وارد شده است؟
پس از کلیک چه رفتاری دارد؟
آیا دوباره همان موضوع را جستوجو میکند؟
آیا برای یافتن پاسخ به نتیجه دیگری مراجعه میکند؟
آیا جستوجوی بعدی او نشان میدهد نیاز قبلی برطرف شده است؟
یکی از ظرافتهای مهم این است که سیستمهای رفتاری ممکن است تنها در پایان مسیر فعال نباشند. شهادت دادگاه نشان میدهد NavBoost میتواند در کاهش مجموعه عظیم اسناد به مجموعهای کوچکتر نیز نقش داشته باشد و دادههای آن براساس زمینههایی مانند دستگاه یا موقعیت تفکیک شود.
این یعنی استفاده از داده رفتاری را نباید صرفاً یک «اصلاح نهایی رتبه» تصور کرد. چنین دادههایی ممکن است در انتخاب اسنادی که اصلاً به مراحل بعدی میرسند نیز اثرگذار باشند.
یکی از اشتباههای رایج در تحلیل سئو این است که برای همه افتها یک نسخه ثابت تجویز شود. اگر معماری رتبهبندی چندلایه باشد، دلایل تنزل نیز میتوانند به خانوادههای متفاوتی تعلق داشته باشند.
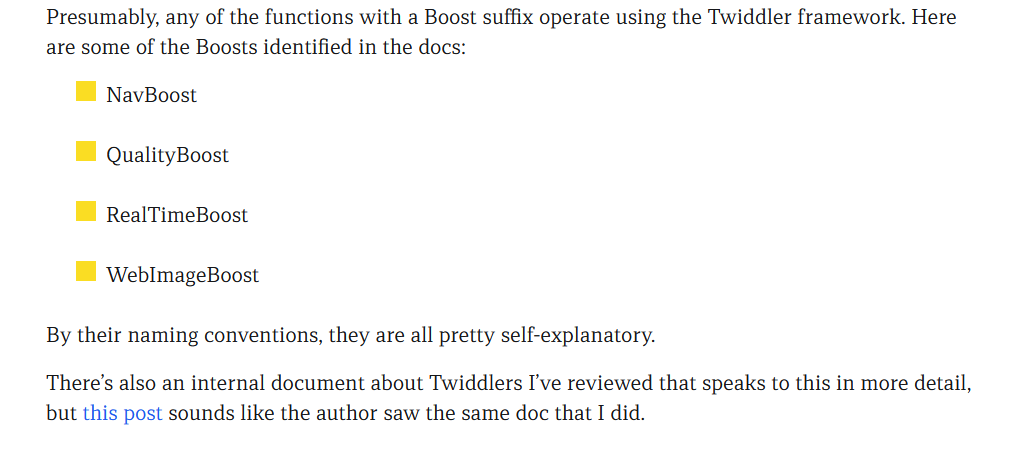
در تحلیل اسناد منتشرشده، نامهایی مانند NavBoost، QualityBoost، RealTimeBoost و WebImageBoost دیده شده است. این نامها نشان میدهند که تنظیمات بعدی ممکن است حول اهداف متفاوتی طراحی شوند؛ هرچند نباید صرف وجود یک نام داخلی را معادل یک «فاکتور رتبهبندی مستقل و قابلاندازهگیری» دانست.
برای تحلیل کاربردی، میتوان لایههای مؤثر بر بازچینی را در چند خانواده مفهومی بررسی کرد. این تقسیمبندی یک مدل آموزشی است، نه نامگذاری رسمی کامل گوگل.
در سئوی سنتی، گاهی ارتباط صفحه با جستوجو از طریق تعداد تکرار یک عبارت اندازهگیری میشود. اما سیستمهای مدرن جستوجو باید معنای پرسش، روابط میان مفاهیم و هدف احتمالی کاربر را درک کنند.
ممکن است یک صفحه کلمه کلیدی را بارها تکرار کند، اما به پرسش واقعی کاربر پاسخ ندهد. برای مثال، کاربری که «بهترین لپتاپ برای تدوین» را جستوجو میکند، صرفاً فهرستی از لپتاپها نمیخواهد. او احتمالاً به اطلاعاتی درباره پردازنده، کارت گرافیک، حافظه، نمایشگر، عملکرد نرمافزارهای تدوین و نسبت قیمت به کارایی نیاز دارد.
صفحهای که فقط مشخصات چند محصول را کنار هم قرار داده، ممکن است از نظر واژگانی مرتبط باشد، اما از نظر معنایی پاسخ کاملی ارائه نکند.
برای بررسی این لایه باید پرسید:
کاربر در چه مرحلهای از تصمیمگیری قرار دارد؟
چه مسئلهای پشت عبارت جستوجو پنهان است؟
چه اطلاعاتی برای تکمیل پاسخ ضروری است؟
آیا ساختار صفحه با ترتیب ذهنی نیاز کاربر هماهنگ است؟
آیا صفحه پاسخ مستقیم دارد یا کاربر باید میان توضیحات اضافی آن را پیدا کند؟
کلمه کلیدی همچنان اهمیت دارد، اما بیشتر بهعنوان نشانهای برای توصیف موضوع؛ نه جایگزینی برای درک کامل هدف جستوجو.
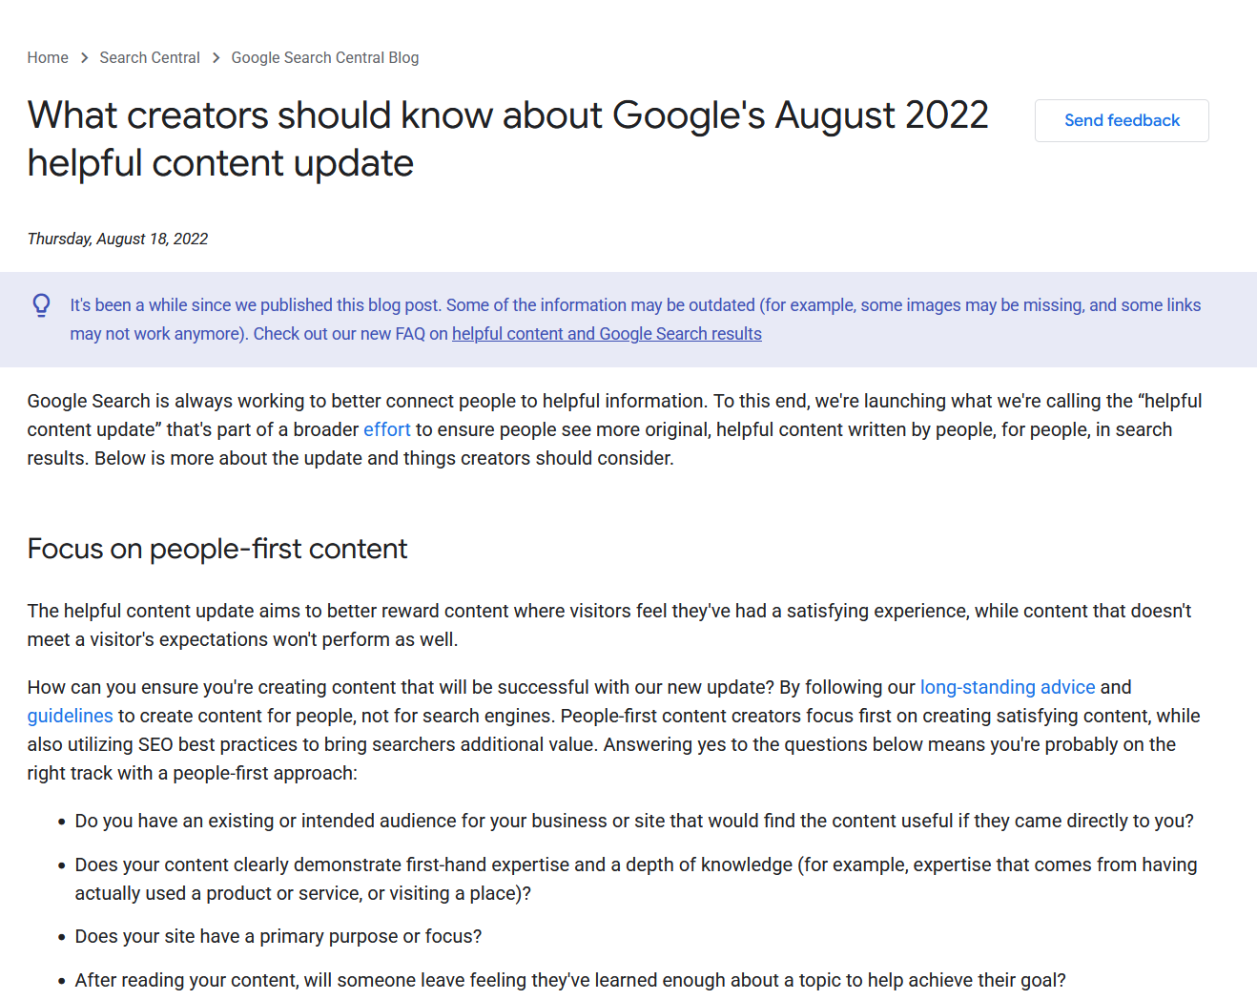
گوگل در راهنمای رسمی تولید محتوای مفید تأکید میکند که محتوا باید ابتدا برای انسان ساخته شود و تجربه رضایتبخشی برای مخاطب ایجاد کند، نه اینکه صرفاً با هدف دستکاری رتبه تولید شود. همچنین در راهنمای سیستمهای رتبهبندی آمده است که سیستم محتوای مفید در مارس ۲۰۲۴ در سیستمهای اصلی رتبهبندی ادغام شد.
بنابراین، «محتوای مفید» را نباید فقط نام یک بهروزرسانی تاریخی دانست. مفهوم اصلی آن در ارزیابی گستردهتر کیفیت و ارزش صفحه ادامه پیدا کرده است.
یک مقاله میتواند پنجهزار کلمه داشته باشد، اما اطلاعات تازهای ارائه نکند. طول زیاد متن بهتنهایی نشانه عمق نیست. گاهی مقالهای هزارکلمهای با داده اختصاصی، تصویر واقعی، مثال اجرایی و جمعبندی روشن، ارزش بیشتری از یک متن طولانی و تکراری دارد.
گوگل نیز در راهنمای محتوای مردممحور سؤالهایی مطرح میکند که به رضایت مخاطب، تجربه دستاول، تمرکز اصلی سایت و کافیبودن اطلاعات برای رسیدن کاربر به هدف مربوط میشوند.
محتوای دارای ارزش افزوده میتواند شامل این موارد باشد:
تجربه واقعی از اجرای یک روش؛
داده یا آزمایش اختصاصی؛
مقایسهای که قبلاً به این شکل انجام نشده است؛
تصویر، نمودار یا ویدئوی تولیدشده توسط نویسنده؛
تحلیل اشتباههای رایج؛
توضیح محدودیتها و شرایط استثنا؛
ارائه چارچوب تصمیمگیری، نه فقط اطلاعات پراکنده.
نتیجه مناسب برای یک کاربر در تهران ممکن است برای کاربری در برلین مناسب نباشد. زبان، کشور، شهر، دستگاه و حتی نوع نیاز محلی میتوانند ترکیب نتایج را تغییر دهند.
برای جستوجوهای محلی، عواملی مانند فاصله، محدوده خدمات، زبان صفحه و اطلاعات کسبوکار اهمیت بیشتری پیدا میکنند. در جستوجوهای عمومی نیز تفاوت موبایل و دسکتاپ میتواند بر رفتار کاربران و قالب مطلوب پاسخ اثر بگذارد.
این موضوع یک نتیجه عملی دارد: هنگام بررسی رتبه، نباید صرفاً از یک دستگاه، یک موقعیت و یک حساب کاربری نتیجهگیری کلی کرد. دادههای سرچ کنسول، تفکیک کشورها، دستگاهها و عبارتهای جستوجو میتوانند تصویر دقیقتری ارائه دهند.
گاهی افتی که در نگاه اول سراسری بهنظر میرسد، فقط به یک کشور، دستگاه یا گروه خاص از کوئریها مربوط است.
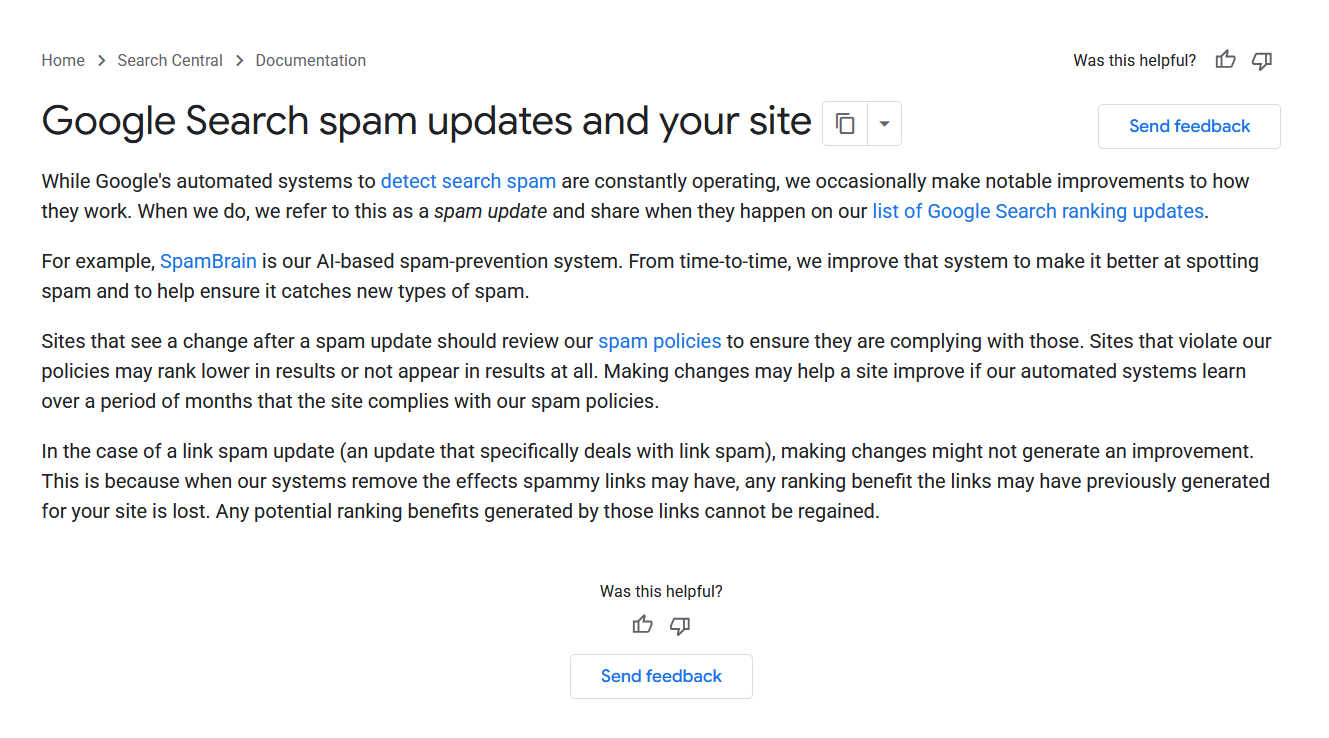
گوگل SpamBrain را یک سیستم مبتنی بر هوش مصنوعی برای مقابله با اسپم معرفی میکند. سیاستهای رسمی گوگل نیز تصریح میکنند که روشهای طراحیشده برای فریب کاربران یا دستکاری سیستمهای جستوجو میتوانند باعث افت رتبه یا حذف از نتایج شوند.
در این لایه، صرفاً تعداد لینکها یا حجم محتوا اهمیت ندارد؛ منشأ و الگوی ایجاد آنها نیز مطرح است.
برای مثال:
آیا لینکها از صفحات مرتبط و واقعی آمدهاند؟
آیا انکرها بهصورت غیرطبیعی تکرار شدهاند؟
آیا تعداد زیادی صفحه کمارزش بهصورت انبوه ساخته شده است؟
آیا محتوا برای نمایش به موتور جستوجو با چیزی که کاربر میبیند متفاوت است؟
آیا صفحات واسطه فقط برای هدایت کاربر به مقصد دیگری ایجاد شدهاند؟
آیا سایت از اعتبار دامنه میزبان برای انتشار محتوای نامرتبط سوءاستفاده میکند؟
نکته مهم این است که خنثیشدن لینک اسپم همیشه به شکل «جریمه آشکار» دیده نمیشود. ممکن است سیستم فقط ارزشی را که قبلاً به لینکها نسبت داده شده بود حذف کند. در این حالت، سایت افت میکند، اما علت واقعی افت اضافهشدن یک سیگنال منفی نیست؛ بلکه حذف امتیاز مصنوعی قبلی است. راهنمای رسمی بهروزرسانیهای اسپم نیز توضیح میدهد که در برخی موارد، مزایای ایجادشده توسط لینکهای اسپم از بین میروند و الزاماً قابلبازیابی نیستند.
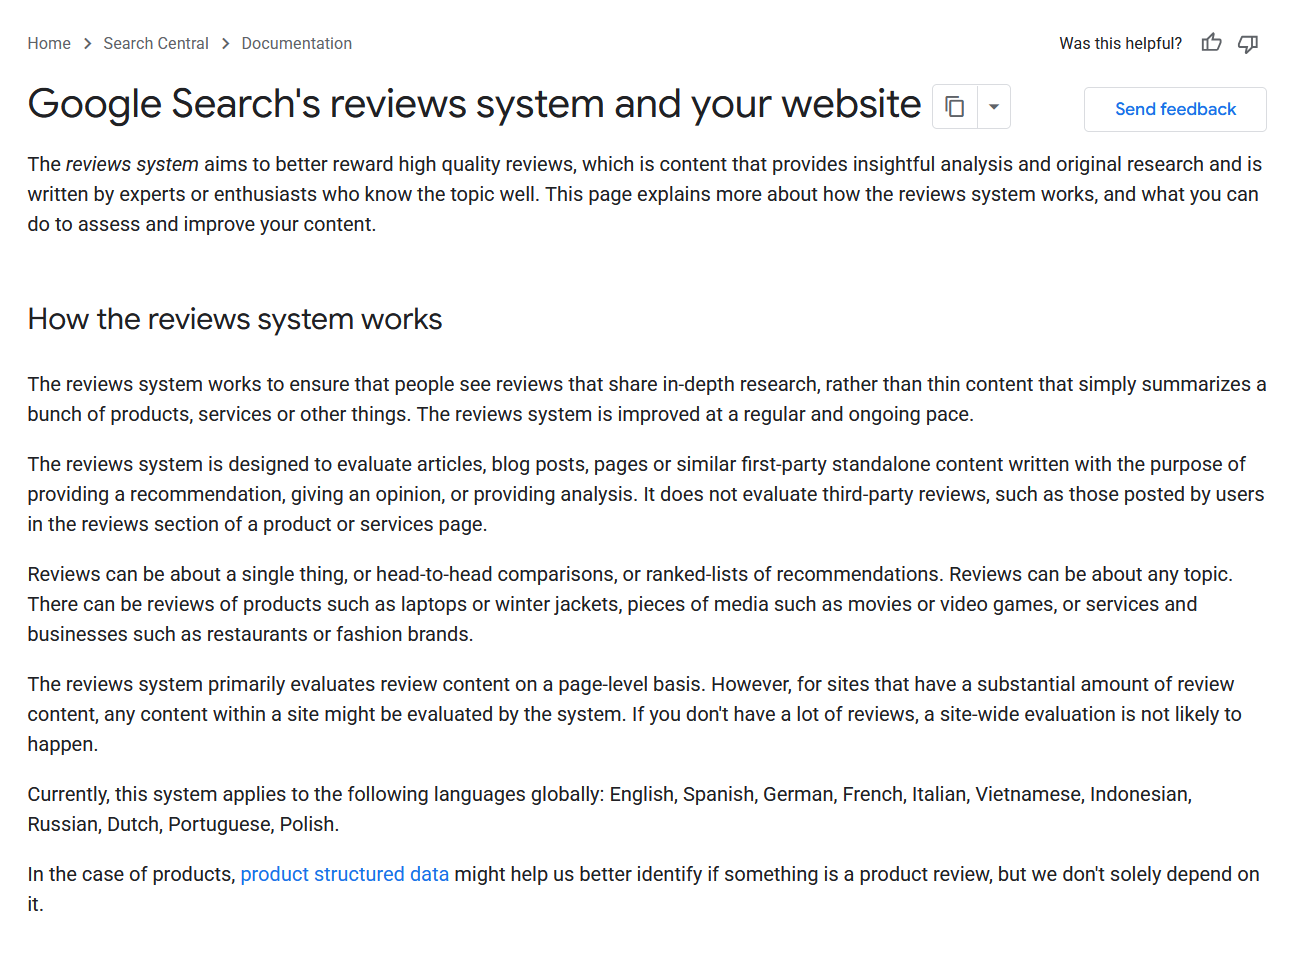
در برخی انواع محتوا، مخصوصاً نقد محصول و خدمات، کاربر فقط به مشخصات عمومی نیاز ندارد. او میخواهد بداند محصول در استفاده واقعی چگونه عمل کرده، چه محدودیتهایی دارد و برای چه فردی مناسب یا نامناسب است.
راهنمای رسمی سیستم نقد و بررسی گوگل میگوید این سیستم بهدنبال محتوایی است که تحلیل عمیق، پژوهش اصیل و دانش واقعی نویسنده را نشان دهد. راهنمای نوشتن نقدهای باکیفیت نیز بر شواهد دستاول، توضیح مزایا و معایب و تمرکز بر کیفیت و اصالت بهجای طول متن تأکید میکند.
برای اثبات تجربه واقعی میتوان از این عناصر استفاده کرد:
عکسها و ویدئوهای اختصاصی؛
نتایج آزمایش یا اندازهگیری؛
توضیح شرایط استفاده؛
مقایسه با گزینههایی که واقعاً بررسی شدهاند؛
بیان مشکلات و محدودیتهای محصول؛
مشخصکردن مخاطب مناسب و نامناسب؛
ارائه جزئیاتی که معمولاً در صفحه سازنده وجود ندارد.
این اصل فقط به نقد محصول محدود نیست. در مقاله آموزشی نیز تجربه اجرای واقعی، نمایش خطاها و ارائه نتیجه آزمایش میتواند محتوا را از بازنویسی عمومی منابع دیگر متمایز کند.
ممکن است صفحه از نظر اطلاعاتی قوی باشد، اما کاربر برای رسیدن به پاسخ اصلی مجبور شود از چند تبلیغ، پنجره بازشو، بنر و بخش غیرضروری عبور کند. در این شرایط، مسئله فقط زیبایی طراحی نیست؛ دسترسی به محتوای وعدهدادهشده مختل شده است.
گوگل از سالها قبل در توضیح الگوریتم چیدمان صفحه اعلام کرده بود صفحاتی که بخش بالای صفحه را بیش از حد با تبلیغات پر میکنند و محتوای اصلی را پایین میبرند، ممکن است عملکرد ضعیفتری در جستوجو داشته باشند. راهنمای فعلی گوگل نیز توصیه میکند از میانصفحهها و پنجرههایی که دید کاربر را مسدود میکنند، پرهیز شود.
فرض کنید دو مقاله تقریباً اطلاعات یکسانی درباره «هزینه طراحی سایت» ارائه میکنند.
در صفحه اول، کاربر پس از ورود ابتدا با یک پنجره عضویت، تبلیغ تمامصفحه، بنر فروش دوره و چند پاراگراف مقدمه عمومی مواجه میشود. جدول قیمتها پس از چندین اسکرول دیده میشود.
در صفحه دوم، خلاصه قیمت و عوامل مؤثر از همان ابتدای صفحه در دسترس است و توضیحات تکمیلی در ادامه قرار گرفتهاند.
حتی اگر امتیازهای اولیه این دو صفحه نزدیک باشند، صفحه دوم تجربه روشنتر و رضایتبخشتری ایجاد میکند. گوگل نیز تصریح میکند که تجربه صفحه یک سیگنال واحد نیست و سیستمهای اصلی از مجموعهای از سیگنالها استفاده میکنند؛ همچنین در جستوجوهایی که چند صفحه محتوای مشابه و مفید دارند، تجربه بهتر میتواند اهمیت بیشتری پیدا کند.
هیچ ابزار عمومی وجود ندارد که به شما بگوید یک صفحه دقیقاً توسط کدام توییدلر ارتقا یا تنزل یافته است. بنابراین، تحلیل باید براساس الگوهای داده و آزمایش کنترلشده انجام شود.
موارد زیر میتوانند نشان دهند مشکل به ارتباط، دسترسی یا اعتبار اولیه مربوط است:
صفحه برای عبارتهای اصلی تقریباً هیچ ایمپرشنی ندارد؛
گوگل عبارت یا موضوع صفحه را بهدرستی درک نکرده است؛
صفحه ایندکس نشده یا نسخه دیگری بهعنوان کانونیکال انتخاب شده است؛
لینکسازی داخلی ضعیف است؛
عنوان، هدینگ و بدنه درباره موضوعات متفاوت صحبت میکنند؛
صفحه در مقایسه با رقبا پوشش مفهومی بسیار محدودی دارد.
این موارد میتوانند احتمال مشکل در ارزیابیهای کیفی یا بازچینی را افزایش دهند:
صفحه مدتی رتبه مناسب دارد، اما بهتدریج افت میکند؛
رتبه در کشورها یا دستگاههای مختلف تفاوت زیادی دارد؛
چند صفحه از یک دامنه برای یک موضوع با یکدیگر رقابت میکنند؛
صفحه ایمپرشن بالایی دارد، اما کلیک یا رضایت پس از ورود ضعیف است؛
محتوای اصلی زیر تبلیغ، پاپآپ یا مقدمه طولانی پنهان است؛
رقبا اطلاعات اختصاصی، تجربه واقعی یا قالب مناسبتری ارائه میکنند؛
صفحه برای کوئریهای فرعی رتبه دارد، اما برای نیاز اصلی کاربر جایگاه خوبی نمیگیرد.
این نشانهها حکم قطعی نیستند. هدف آنها ساختن فرضیههای قابلآزمایش است.
بهجای تغییر همزمان دهها عامل، بهتر است تحلیل افت رتبه مرحلهای انجام شود.
ابتدا مطمئن شوید صفحه قابل خزش و ایندکس است، کانونیکال اشتباه ندارد، محتوای اصلی در نسخه رندرشده دیده میشود و لینکهای داخلی مناسبی دریافت میکند.
نتایج فعلی را از نظر قالب و هدف تحلیل کنید. آیا گوگل مقاله آموزشی، صفحه محصول، فهرست مقایسهای، ویدئو یا نتیجه محلی نمایش میدهد؟ ممکن است صفحه شما خوب باشد، اما قالب آن با نیاز غالب کاربران هماهنگ نباشد.
یک جمله بنویسید که توضیح دهد صفحه شما چه چیزی دارد که پنج نتیجه اول ندارند. اگر پاسخ فقط «مقاله ما طولانیتر است» باشد، احتمالاً مزیت واقعی هنوز ساخته نشده است.
با ابزارهای تحلیل رفتار، ضبط نشست و دادههای تحلیلی بررسی کنید کاربر چگونه در صفحه حرکت میکند. هدف، افزایش مصنوعی زمان حضور نیست؛ هدف این است که موانع رسیدن به پاسخ شناسایی شوند.
آیا چند صفحه درباره یک موضوع مشابه دارید؟ آیا صفحه مناسب از لینکهای داخلی کافی برخوردار است؟ آیا سایت در این حوزه تمرکز و سابقه محتوایی دارد یا مقاله بهصورت منفرد در میان موضوعات نامرتبط منتشر شده است؟
اگر همزمان عنوان، متن، طراحی، لینکها و ساختار صفحه را تغییر دهید، مشخص نخواهد شد کدام تغییر مؤثر بوده است. اصلاحات را براساس اولویت انجام دهید و نتیجه را در یک بازه منطقی بررسی کنید.
درک معماری چندلایه رتبهبندی گوگل، استراتژی محتوا را از «پرکردن چکلیست» به «ساختن بهترین پاسخ ممکن» تغییر میدهد.
تیم محتوا نباید فقط از خود بپرسد چند بار کلمه کلیدی استفاده شده یا مقاله چند کلمه دارد. پرسشهای مهمتر عبارتاند از:
آیا مسئله کاربر در همان ابتدای صفحه روشن میشود؟
آیا محتوا اطلاعاتی دارد که از منابع دیگر کپی نشده است؟
آیا نویسنده تجربه یا تخصص خود را اثبات میکند؟
آیا قالب ارائه با نوع جستوجو هماهنگ است؟
آیا صفحه روی موبایل نیز قابلاستفاده است؟
آیا محتوای اصلی بدون مزاحمت در دسترس است؟
آیا عنوان وعدهای میدهد که بدنه واقعاً آن را برآورده میکند؟
آیا کاربر پس از مطالعه هنوز مجبور است همان پرسش را جستوجو کند؟
این پرسشها بهجای تمرکز بر یک عدد فرضی، کل تجربه جستوجو را هدف قرار میدهند.
«هر افت رتبهای از کمبود بکلینک است»
بکلینک میتواند در اعتبار و کشف صفحه نقش داشته باشد، اما نمیتواند ضعف جدی در هدف جستوجو، کیفیت، تجربه صفحه یا اصالت محتوا را همیشه جبران کند.
«هرچه متن طولانیتر باشد، رتبه بهتر میشود»
هیچ طول ثابتی برای همه کوئریها وجود ندارد. طول محتوا باید تابع پیچیدگی نیاز کاربر باشد. پاسخ ساده را نباید برای رسیدن به عددی خاص کش داد.
«افزایش زمان حضور همیشه هدف درستی است»
اگر کاربر برای دریافت یک پاسخ کوتاه وارد شده، حل سریع نیاز او میتواند تجربه مطلوبی باشد. نگهداشتن اجباری کاربر با پنهانکردن پاسخ یا تقسیم غیرضروری محتوا، الزاماً نشانه کیفیت نیست.
«بهینهسازی یک فاکتور، رتبه را تضمین میکند»
رتبه حاصل تعامل چندین سیستم و محدودیت است. حتی بهترین امتیاز در یک لایه نمیتواند موفقیت در تمام مراحل را تضمین کند.
«نام سیستمهای داخلی، فرمول رتبهبندی را آشکار میکند»
شناخت نامهایی مانند Twiddler یا NavBoost برای ساخت مدل ذهنی مفید است، اما وزنها، تعامل سیستمها و نسخه فعلی آنها در دسترس عمومی نیست. این اسناد باید برای فهم معماری استفاده شوند، نه ساختن فرمولهای قطعی و تجاری.
مهمترین نتیجه تحلیل معماری چندلایه گوگل این نیست که سئوکارها باید فهرست بلندتری از نام الگوریتمها حفظ کنند. نتیجه واقعی این است که رتبهبندی گوگل را نمیتوان به یک امتیاز خام، یک فاکتور یا یک چکلیست ثابت تقلیل داد.
یک صفحه ممکن است در ارزیابی اولیه مرتبط و معتبر تشخیص داده شود، اما در مراحل بعد به دلایل مختلف جایگاه خود را از دست بدهد: پاسخ رقیب با هدف کاربر هماهنگتر است، تجربه صفحه بهتر است، منابع متنوعتری باید نمایش داده شوند، محتوای صفحه ارزش تازهای ندارد یا الگوهای اسپم اعتبار ظاهری آن را تضعیف کردهاند.
از سوی دیگر، صفحهای که شاید در ابتدا قدرتمندترین پروفایل لینک را ندارد، میتواند با پاسخ دقیق، تجربه مناسب، شواهد واقعی و ارزش اطلاعاتی منحصربهفرد، در ارزیابیهای بعدی عملکرد بهتری نشان دهد.
پس هنگام افت رتبه، نخستین سؤال نباید این باشد که «کدام فاکتور را بیشتر کنیم؟» سؤال دقیقتر این است:
صفحه در کدام بخش از مسیر انتخاب، امتیازدهی، مقایسه و بازچینی نتایج، مزیت خود را از دست داده است؟
پاسخ به این پرسش، مسیر بهینهسازی را از حدسزدن به تحلیل تبدیل میکند. گاهی راهحل، لینکسازی و تقویت اعتبار است؛ گاهی بازنویسی محتوا براساس هدف جستوجو؛ گاهی حذف تبلیغات و موانع دسترسی؛ و گاهی افزودن تجربه، داده و تحلیل اختصاصی.
در نهایت، رتبه پایدار زمانی شکل میگیرد که صفحه نهفقط برای سیستم امتیازدهی، بلکه برای انسانی که پشت عبارت جستوجو قرار دارد، بهترین و قابلاعتمادترین پاسخ باشد.
تهیه شده توسط تیم تخصصی سئو سید احسان خسروی (مدیر، متخصص و مشاور استراتژیک سئو)

