
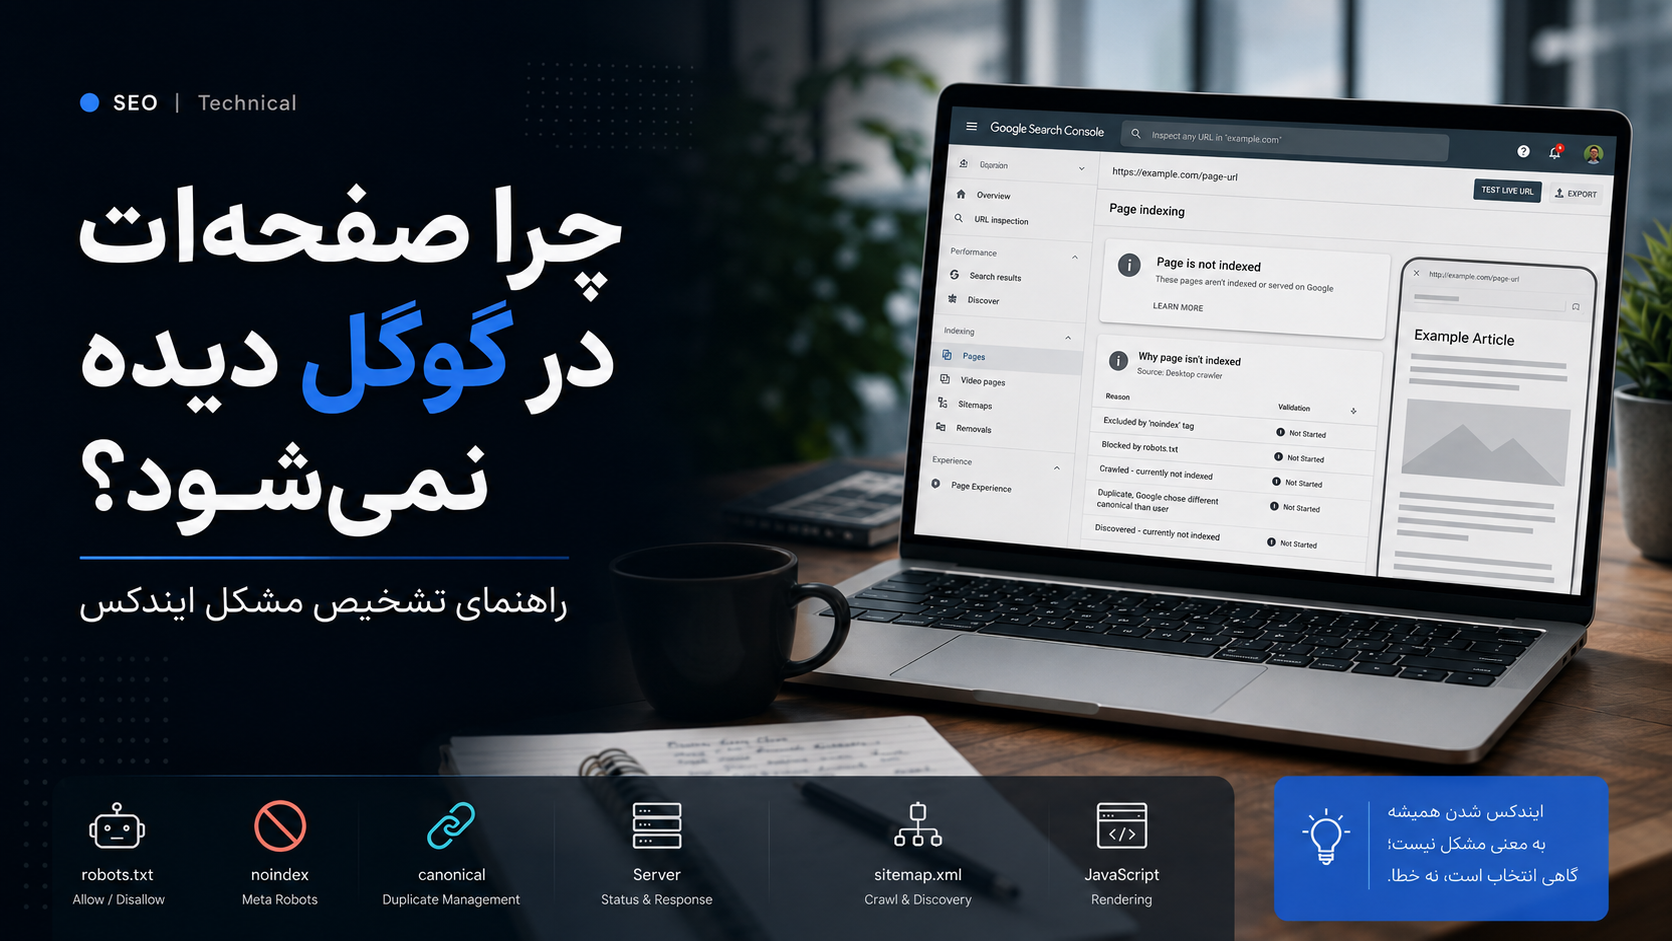
انتشار یک صفحه به این معنا نیست که گوگل آن را خواهد دید، بررسی خواهد کرد و در نتایج جستوجو نمایش خواهد داد. میان فشردن دکمه «انتشار» و ظاهرشدن یک URL در گوگل، چند مرحله مستقل وجود دارد و صفحه میتواند در هرکدام از آنها متوقف شود.
بعضی صفحات اصلاً کشف نمیشوند. برخی کشف شدهاند، اما Googlebot نمیتواند به سرور دسترسی پیدا کند. گروهی بهدلیل تنظیمات robots.txt یا noindex کنار گذاشته میشوند. در سایتهای جاوااسکریپتی نیز ممکن است چیزی که کاربر میبیند با محتوایی که گوگل رندر میکند تفاوت داشته باشد.
حتی عبور موفق از تمام موانع فنی نیز ایندکسشدن را تضمین نمیکند. گوگل صراحتاً میگوید پیروی از الزامات فنی، تضمینی برای خزش، ایندکس یا نمایش یک صفحه نیست. موتور جستوجو پس از پردازش URL باید تصمیم بگیرد آیا این صفحه، در مقایسه با نسخههای مشابه و سایر صفحات وب، ارزش نگهداری در ایندکس را دارد یا نه.
بنابراین، در بررسی ایندکس نشدن صفحات نباید مستقیماً سراغ بازنویسی مقاله برویم. ابتدا باید بفهمیم صفحه دقیقاً پشت کدام دروازه متوقف شده است.
درک درست مشکل از شناخت مسیر جستوجوی گوگل آغاز میشود. براساس مستندات رسمی، فرایند کلی گوگل سه مرحله دارد:
خزش یا Crawling: گوگل صفحه را پیدا و محتوای آن را دریافت میکند.
ایندکس یا Indexing: محتوا، تصاویر، دادهها و نشانههای صفحه تحلیل میشوند و در صورت انتخاب، اطلاعات در ایندکس ذخیره میشود.
ارائه یا Serving: صفحه ذخیرهشده برای جستوجوهای مرتبط، همراه با سایر نتایج ارزیابی میشود.
هر URL الزاماً هر سه مرحله را طی نمیکند. ممکن است صفحه کشف شود، اما خزیده نشود؛ خزیده شود، اما وارد ایندکس نشود؛ یا ایندکس باشد، اما برای عبارت موردنظر نمایش داده نشود.
همین تفکیک اهمیت زیادی دارد. وقتی صفحه هنوز کشف نشده، افزایش تعداد کلمات مقاله کمکی نمیکند. زمانی که noindex روی صفحه باقی مانده، دریافت بکلینک راهحل اصلی نیست. اگر گوگل URL دیگری را کنونیکال تشخیص داده باشد، درخواست مکرر ایندکس نیز مسئله را حل نمیکند.
قبل از خزش، صفحه باید کشف شود. گوگل فهرست مرکزی و ازپیشآمادهای از تمام صفحات وب ندارد؛ URLهای تازه معمولاً از طریق لینک صفحات شناختهشده، نقشه سایت یا مسیرهای دیگری که خزنده میتواند دنبال کند، کشف میشوند.
صفحهای که هیچ لینک داخلی به آن نمیرسد، اصطلاحاً صفحه یتیم است. ممکن است URL آن در Sitemap قرار داشته باشد، اما جایگاه نامشخص آن در معماری سایت، اهمیت و ارتباطش را مبهم میکند.
نقشه سایت ابزار مفیدی است، ولی نباید آن را جایگزین لینکسازی داخلی دانست. Sitemap به گوگل میگوید URL وجود دارد؛ درحالیکه لینکهای داخلی علاوه بر ایجاد مسیر کشف، رابطه صفحه را با بخشهای دیگر سایت روشن میکنند.
در URL Inspection ببینید آیا گوگل برای صفحه، Referring page یا Referring sitemap شناسایی کرده است. سپس این پرسشها را پاسخ دهید:
آیا از یک صفحه دستهبندی معتبر به URL لینک داده شده است؟
آیا مقاله از صفحات مرتبط دیگر لینک داخلی دریافت میکند؟
آیا URL در Sitemap درست و قابلدسترسی قرار دارد؟
آیا لینکها در HTML واقعی وجود دارند یا فقط پس از تعامل کاربر ساخته میشوند؟
آیا صفحه از منو، آرشیو، Breadcrumb یا صفحات هاب قابلدسترسی است؟
در سایتهای بزرگ، صفحات عمیق ممکن است از صفحه اصلی چندین کلیک فاصله داشته باشند. هرچه مسیر کشف طولانیتر و ضعیفتر باشد، احتمال تأخیر در خزش نیز افزایش پیدا میکند.
شناختهشدن URL بهمعنای دسترسی موفق خزنده نیست. مشکلات DNS، خطاهای شبکه، قطعی هاست، پاسخهای 5xx، محدودیتهای فایروال و زمان پاسخ بسیار طولانی میتوانند مانع دریافت صفحه شوند.
گوگل هنگام مشاهده خطاهای مکرر سرور، نرخ خزش را کاهش میدهد تا فشار بیشتری به سایت وارد نکند. اگر URLهای ایندکسشده برای مدتی طولانی در دسترس نباشند، ممکن است بهتدریج از ایندکس کنار گذاشته شوند.
ممکن است سایت برای شما باز شود، ولی Googlebot با پاسخ متفاوتی روبهرو شود. دلایل متداول عبارتاند از:
مسدودشدن IPهای گوگل توسط فایروال یا CDN؛
اعمال محدودیت شدید درخواست؛
خطاهای متناوب سرور؛
تفاوت پاسخ بر اساس User-Agent؛
مشکلات DNS یا گواهی SSL؛
پاسخ 200 برای صفحهای که در عمل محتوای خطا دارد.
در گزارش Crawl Stats، بخش Host status و توزیع پاسخهای HTTP را بررسی کنید. افزایش خطاهای 5xx یا دسترسناپذیری robots.txt نشانهای است که باید پیش از ویرایش محتوا، زیرساخت بررسی شود.
عبارت «بودجه خزش» در بسیاری از پروژهها بیش از حد استفاده میشود. گوگل این موضوع را عمدتاً برای سایتهای بسیار بزرگ یا سایتهایی که تعداد زیادی URL با تغییرات روزانه دارند مهم میداند. یک وبسایت چندصد یا چندهزارصفحهای معمولاً نباید هر تأخیر ایندکس را به Crawl Budget نسبت دهد.
برای اغلب سایتهای کوچک و متوسط، دلایل محتملتر عبارتاند از:
لینکسازی داخلی ضعیف؛
تولید تعداد زیادی URL تکراری؛
پاسخ کند یا ناپایدار سرور؛
محتوای کمارزش؛
صفحات فیلتر و پارامترهای بیهدف؛
یا نبود تقاضای کافی برای خزش دوباره.
یکی از رایجترین خطاهای فنی، اشتباهگرفتن کنترل خزش با کنترل ایندکس است.
فایل robots.txt مشخص میکند خزنده اجازه درخواستکردن یک مسیر را دارد یا نه. در مقابل، دستور noindex به گوگل میگوید صفحه خزیدهشده را در نتایج نگه ندارد.
اگر URL را در robots.txt مسدود کنید، Googlebot ممکن است نتواند وارد صفحه شود و در نتیجه دستور noindex داخل HTML یا هدر HTTP را نبیند. گوگل در راهنمای رسمی خود تأکید میکند که برای مؤثربودن noindex، صفحه باید برای خزنده قابلدسترسی باشد.
فرض کنید صفحهای باید از نتایج حذف شود. مدیر سایت همزمان این دو اقدام را انجام میدهد:
User-agent: *
Disallow: /example-page/
و در همان صفحه نیز قرار میدهد:
<meta name="robots" content="noindex">
از نگاه مدیر سایت، دو لایه محافظتی ایجاد شده است؛ اما از نگاه گوگل، دسترسی به صفحه مسدود شده و احتمالاً دستور noindex هرگز خوانده نمیشود.
راه درست به هدف بستگی دارد:
برای جلوگیری از خزش: robots.txt
برای جلوگیری از ایندکس: noindex
برای جلوگیری از دسترسی عمومی: احراز هویت یا محدودیت دسترسی
برای URL حذفشده: پاسخ مناسب 404 یا 410
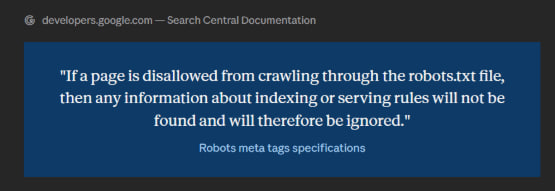
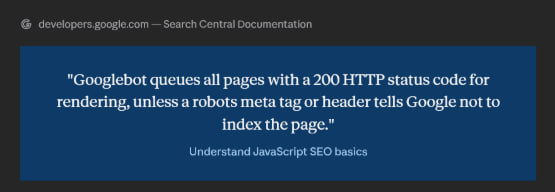
در سایتهای مبتنی بر JavaScript، HTML اولیه ممکن است فقط یک پوسته خالی باشد و محتوای اصلی پس از اجرای اسکریپت ساخته شود. گوگل JavaScript را با نسخهای جدید از Chromium رندر میکند، اما وابستگی کامل محتوا به اجرای سنگین اسکریپت همچنان میتواند کشف و پردازش را دشوارتر کند.
مشکل زمانی جدی میشود که عناصر مهم زیر در HTML رندرشده دیده نشوند:
متن اصلی مقاله؛
عنوان و توضیحات مهم؛
لینکهای داخلی؛
Pagination؛
اطلاعات محصول و قیمت؛
دادههای ساختاریافته؛
یا وضعیت واقعی صفحه.
همچنین نباید noindex را در HTML اولیه قرار داد و انتظار داشت JavaScript بعداً آن را حذف کند. ممکن است گوگل پیش از اجرای کامل اسکریپت، دستور اولیه را پردازش کرده باشد.
در URL Inspection از Test Live URL و سپس View Tested Page استفاده کنید. این ابزار امکان مشاهده HTML رندرشده و تصویری از نسخهای را میدهد که سیستم بازرسی گوگل دیده است.
محتوای رندرشده را با صفحه مرورگر مقایسه کنید. اگر بخش اصلی در خروجی وجود ندارد، مشکل محتوایی نیست؛ مشکل در شیوه ارائه محتوا به خزنده است.
وجود چند آدرس برای یک محتوای مشابه در بسیاری از سایتها طبیعی است. پارامترهای فیلتر، نسخههای HTTP و HTTPS، آدرسهای دارای Slash، صفحات چاپی و URLهای مرتبسازی میتوانند نسخههای مختلفی از یک محتوا ایجاد کنند.
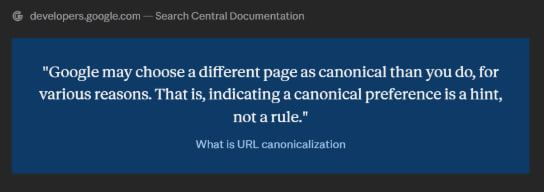
گوگل صفحات مشابه را در یک خوشه قرار میدهد و سپس یک URL را بهعنوان نسخه نماینده یا Canonical انتخاب میکند. تگ rel="canonical" سیگنالی قوی برای اعلام ترجیح مدیر سایت است، اما دستور قطعی محسوب نمیشود. گوگل ممکن است براساس مجموعه سیگنالها، URL دیگری را انتخاب کند.
سیگنالهای رایج انتخاب نسخه اصلی شامل موارد زیر هستند:
ریدایرکت دائمی؛
تگ rel="canonical"؛
حضور URL در Sitemap؛
لینکسازی داخلی؛
نسخه HTTPS؛
و کاملبودن یا مناسببودن صفحه.
تناقض میان این سیگنالها تصمیمگیری را دشوار میکند. برای مثال، Sitemap ممکن است URL شماره یک را معرفی کند، Canonical به URL شماره دو اشاره کند و لینکهای داخلی بیشتر به URL شماره سه برسند.
Alternate page with proper canonical tag معمولاً یعنی گوگل صفحه را نسخه جایگزین تشخیص داده و Canonical تعیینشده را پذیرفته است.
Duplicate without user-selected canonical یعنی چند نسخه مشابه وجود دارد، ولی سایت انتخاب روشنی ارائه نکرده و گوگل خودش نسخه اصلی را تعیین کرده است.
در URL Inspection، مقدار Google-selected canonical را با User-declared canonical مقایسه کنید.
سختترین وضعیت زمانی است که URL:
کشف شده است؛
پاسخ 200 دارد؛
اجازه خزش و ایندکس دارد؛
درست رندر میشود؛
و مشکل Canonical نیز ندارد؛
اما همچنان در وضعیت Crawled – currently not indexed باقی میماند.
این پیام الزاماً به معنای وجود یک خطای فنی نیست. سرچ کنسول میگوید URL خزیده شده، اما در زمان فعلی وارد ایندکس نشده است. گوگل نیز تضمین نمیکند هر صفحهای که پردازش میشود در ایندکس ذخیره شود. کیفیت، طراحی صفحه، متادیتا و شباهت به سایر محتواها میتوانند در این تصمیم مؤثر باشند.
در این مرحله باید بهجای جستوجوی یک تگ خراب، ارزش کلی URL را بررسی کرد:
آیا صفحه پاسخ مستقلی دارد؟
آیا فقط بازنویسی چند نتیجه موجود است؟
آیا چند صفحه سایت یک هدف مشابه را دنبال میکنند؟
آیا محتوا نازک، خودکار یا الگووار است؟
آیا صفحه از بخشهای مرتبط سایت لینک دریافت میکند؟
آیا کاربر دلیل مشخصی برای انتخاب این صفحه دارد؟
آیا URL بخشی ضروری از معماری سایت است؟
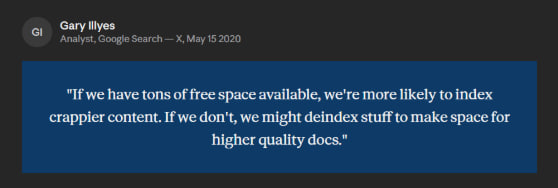
ایندکسشدن یک مجوز دائمی نیست. صفحهای که امروز در گوگل حضور دارد ممکن است در آینده بهدلیل تغییر محتوا، ایجاد نسخه بهتر، کاهش کیفیت کلی سایت یا تغییر ارزیابی سیستمها از ایندکس کنار گذاشته شود.
مقاله منبع به گفتوگوها و توضیحات متفاوت نمایندگان گوگل درباره افزایش URLهای حذفشده از ایندکس اشاره میکند. این بحث نشان میدهد نباید وضعیت ایندکس را یک تصمیم ثابت و کاملاً قابلپیشبینی دانست.
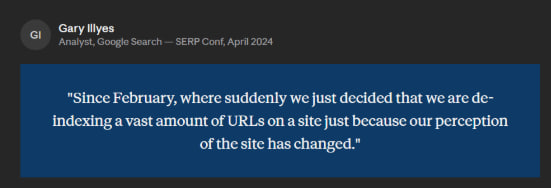
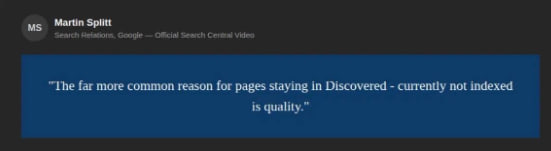
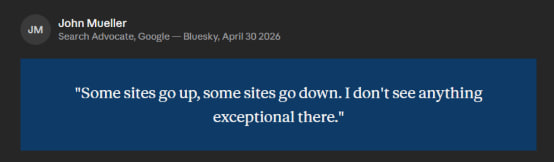
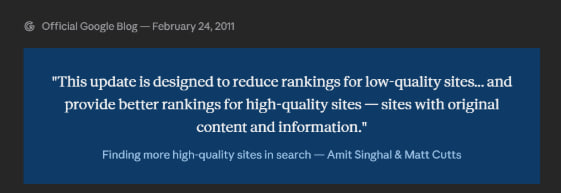
در تاریخ جستوجوی گوگل، سیستمها و سیاستهای مختلفی برای مقابله با محتوای کمارزش، تکراری، اسپم یا سوءاستفادهگر معرفی شدهاند. پاندا نمونه تاریخی مهمی بود که با هدف کاهش نمایش سایتهای کمکیفیت و تقویت محتوای اصیل و عمیق معرفی شد.
اما اشتباه است اگر کیفیت را فقط با طول مقاله بسنجیم. یک صفحه طولانی میتواند متورم و تکراری باشد و یک صفحه کوتاه ممکن است پاسخ دقیق و کاملی ارائه دهد.
در ارزیابی یک URL به این عناصر توجه کنید:
اصالت و ارزش افزوده؛
پاسخدادن به هدف جستوجو؛
تجربه یا تحلیل دستاول؛
ساختار روشن و دسترسی سریع به پاسخ؛
منابع قابلاعتماد؛
نبود تبلیغات و عناصر مزاحم بیشازحد؛
و هماهنگی با موضوع اصلی سایت.
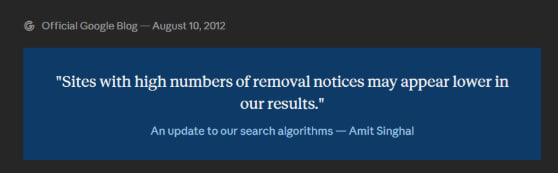
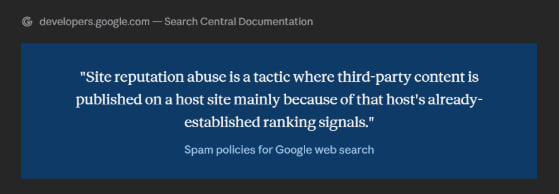
گوگل در سیاستهای فعلی اسپم نیز روشهایی مانند تولید انبوه محتوای کمارزش، سوءاستفاده از اعتبار سایت، Cloaking و صفحات واسطه را هدف قرار میدهد. بنابراین، سالمبودن تگهای فنی نمیتواند تضمین کند صفحهای که ارزش واقعی ندارد در ایندکس باقی بماند.
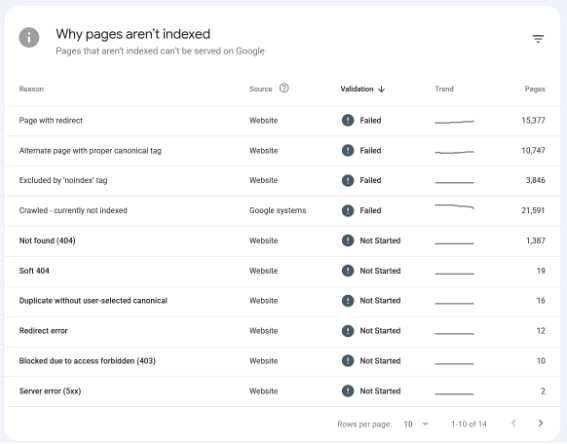
گزارش Page Indexing فقط فهرستی از خطاها نیست. بعضی وضعیتها کاملاً طبیعیاند؛ برای مثال، صفحهای که عمداً noindex شده یا نسخه جایگزین یک URL کنونیکال است، لزوماً مشکل ندارد.
ستون Source در گزارش اهمیت زیادی دارد. این ستون نشان میدهد علت وضعیت بیشتر به تنظیمات سایت مربوط است یا تصمیم سیستمهای گوگل. مستند رسمی سرچ کنسول نیز پیشنهاد میکند هر دلیل را جداگانه بررسی کنید و فقط مواردی را اصلاح کنید که با تصمیم موردنظر شما مغایرت دارند.
Page with redirect: URL به مقصد دیگری هدایت میشود.
Server error (5xx): مشکل زیرساخت یا پاسخ سرور.
Blocked by robots.txt: مانع خزش.
Excluded by noindex: دستور جلوگیری از ایندکس.
Alternate page with proper canonical: نسخه جایگزین معتبر.
Duplicate without user-selected canonical: نبود سیگنال روشن برای نسخه اصلی.
Crawled – currently not indexed: خزیدهشده، اما فعلاً انتخابنشده.
Discovered – currently not indexed: URL شناخته شده، اما هنوز خزیده نشده است.
بهجای اجرای تغییرات تصادفی، این ترتیب را دنبال کنید:
با URL Inspection مشخص کنید صفحه برای گوگل شناخته شده است یا نه. نسخه ایندکسشده، آخرین زمان خزش و Canonical انتخابشده را ببینید.
Sitemap، لینکهای داخلی، دستهبندی، Breadcrumb و صفحات هاب را بررسی کنید. URL نباید فقط از طریق یک فرم جستوجو یا اسکریپت مخفی قابلدسترسی باشد.
کد HTTP، زنجیره ریدایرکت، زمان پاسخ و تفاوت نسخه موبایل و دسکتاپ را بررسی کنید. لاگ سرور در پروژههای بزرگ تصویر دقیقتری از رفتار Googlebot میدهد.
مطمئن شوید صفحهای که باید ایندکس شود در robots.txt بسته نشده و هیچ noindex ناخواستهای در HTML یا هدر HTTP ندارد.
HTML خام و HTML پس از رندر را مقایسه کنید. متن اصلی، لینکها و Canonical باید برای گوگل قابلمشاهده باشند.
ریدایرکت، Sitemap، تگ Canonical و لینکهای داخلی باید به یک URL واحد اشاره کنند.
وقتی تمام مراحل فنی سالماند، بررسی کنید صفحه چه دلیل مستقلی برای حضور در ایندکس دارد. گاهی راهحل، ادغام چند URL مشابه و ساخت یک صفحه کاملتر است؛ نه طولانیترکردن تمام صفحات.
فرض کنید فروشگاهی ۵۰۰ صفحه محصول دارد و ۱۸۰ URL در وضعیت Crawled – currently not indexed دیده میشوند.
واکنش اشتباه این است که برای هر محصول ۵۰۰ کلمه توضیح خودکار اضافه شود.
تحلیل درست باید ابتدا مشخص کند:
آیا محصولات حذفشده یا بدون موجودیاند؟
آیا توضیحات آنها میان چند صفحه تکرار شده است؟
آیا رنگها و سایزها URL مستقل و کمارزش ساختهاند؟
آیا Canonical همه نسخهها صحیح است؟
آیا محصولات از دستهبندیها لینک دریافت میکنند؟
آیا اطلاعات اختصاصی مانند مشخصات، تصاویر، مقایسه و راهنمای انتخاب وجود دارد؟
ممکن است بهترین راه، کاهش تعداد URLها، ادغام Variants و تقویت صفحات اصلی باشد. در چنین شرایطی، تولید متن بیشتر برای تمام URLها فقط حجم مسئله را افزایش میدهد.
ایندکس نشدن صفحات یک علت واحد ندارد و نمیتوان برای همه وضعیتها نسخه یکسان پیچید.
صفحه ممکن است هنوز کشف نشده باشد، سرور پاسخ مناسبی ندهد، دسترسی خزنده بسته باشد، JavaScript محتوا را ناقص تحویل دهد، گوگل نسخه دیگری را کنونیکال بداند یا URL ارزش کافی برای نگهداری در ایندکس ایجاد نکرده باشد.
به همین دلیل، بازنویسی محتوا باید آخرین مرحله عیبیابی باشد، نه اولین واکنش.
ترتیب منطقی بررسی چنین است:
کشف URL ← دسترسی سرور ← اجازه خزش و ایندکس ← رندر ← Canonical ← کیفیت و ارزش صفحه
وقتی این مسیر بهدرستی طی شود، وضعیتهای سرچ کنسول از پیامهایی مبهم به نشانههایی قابلتحلیل تبدیل میشوند. هدف نهایی این نیست که هر URL ساختهشده را به هر شکل وارد گوگل کنیم؛ هدف، ساخت صفحاتی است که هم از نظر فنی قابلدسترسی باشند و هم دلیل روشنی برای حضور در ایندکس داشته باشند.
تهیه شده توسط تیم تخصصی سئو سید احسان خسروی (مدیر، متخصص و مشاور استراتژیک سئو)

