
افت ناگهانی یک وبسایت در نتایج گوگل همیشه خبر مهمی برای متخصصان سئو نیست. سایتها هر روز جایگاه از دست میدهند، رقبا بهتر میشوند، الگوریتمها تغییر میکنند و رفتار کاربران هم ثابت نمیماند. اما وقتی دامنهای به بزرگی و اعتبار وبسایت سازمان مالیات آمریکا در مدت کوتاهی بخش قابل توجهی از دیدهشدن خود را از دست میدهد و همزمان نشانههای عجیبی در نحوه نمایش آن داخل نتایج جستوجو ظاهر میشود، ماجرا دیگر شبیه یک نوسان رتبه معمولی نیست. در اواخر اوت ۲۰۲۶ دقیقاً چنین اتفاقی برای وبسایت IRS رخ داد.
گزارش Search Engine Roundtable نشان میدهد که صفحات وبسایت IRS و برخی دیگر از سایتهای دولت فدرال آمریکا طی چند روز در نتایج گوگل افت محسوسی داشتند. همزمان متخصصانی مانند Lily Ray و Glenn Gabe متوجه شدند تعداد زیادی از کوئریهایی که IRS قبلاً در آنها جایگاههای بسیار قدرتمندی داشت، افت کردهاند. در بعضی نتایج، فاوآیکون IRS خراب بود، توضیح نتیجه نمایش داده نمیشد و صفحه تقریباً فقط با URL ظاهر میشد. Barry Schwartz احتمال داد یک سیستم مقابله با رباتها بیش از حد سختگیرانه تنظیم شده و گوگل را نیز در کنار سایر رباتها محدود کرده باشد؛ اما باید تأکید کرد که این یک برداشت و فرضیه فنی بود و نه توضیح رسمی IRS یا گوگل.
اگر فقط نمودار رتبه را ببینیم، ممکن است اولین واکنش این باشد که سایت تحت تأثیر یک آپدیت گوگل قرار گرفته است. این اتفاق از نظر زمانی هم نزدیک به بحثهای مربوط به Spam Update رخ داده بود و همین هم میتوانست ذهن تحلیلگر را به سمت علت الگوریتمی ببرد. اما همزمانی دو اتفاق، دلیل کافی برای رابطه علت و معلولی نیست. نکتهای که پرونده IRS را متفاوت کرد، وجود نشانههایی بود که بیش از رتبه، به دسترسی و پردازش فنی سایت مربوط میشدند.
وقتی سایتی که قبلاً برای عبارتهای بسیار مهم رتبه یک داشته، ناگهان در تعداد زیادی از آنها دهها جایگاه سقوط میکند، باید احتمال تغییر گسترده در سیستم را بررسی کرد. در اسکرینشاتی که برای این مقاله انتخاب کردهایم، عبارتهایی مانند «stimulus» از رتبه ۱ به ۲۷ رسیدهاند و برخی عبارات دیگر از رتبههای اول به جایگاههایی پایینتر از ۱۰۰ سقوط کردهاند. این الگو با یک صفحه ضعیف یا یک تغییر جزئی در محتوا توضیح داده نمیشود؛ دامنه مسئله بسیار وسیعتر است.
در چنین شرایطی، اولین اشتباه این است که تیم سئو با دیدن کاهش رتبه فوراً سراغ بازنویسی محتوا برود. وقتی دهها یا صدها صفحه در یک بازه زمانی مشابه رفتار غیرعادی نشان میدهند، باید ابتدا پرسید آیا مسئله در یک لایه مشترک قرار دارد یا خیر. آن لایه مشترک میتواند زیرساخت، CDN، فایروال، مدیریت رباتها، تنظیمات سرور یا خطایی در دسترسی خزنده باشد.
تصویر Sistrix انتخابشده برای مقاله از این جهت بسیار مفید است که مسئله را از حالت anecdotal خارج میکند. در بالای همان اسکرینشات بیش از هشت هزار Keyword دیده میشود و ردیفهای نمونه، تغییرات شدید در رتبه و کلیک تخمینی را نشان میدهند. در کنار عبارتهای عمومی، Queryهای بسیار مرتبط و کلیدی برای IRS مانند «tax brackets»، «free tax filing»، «income tax» و «file tax extension» نیز افت داشتهاند.
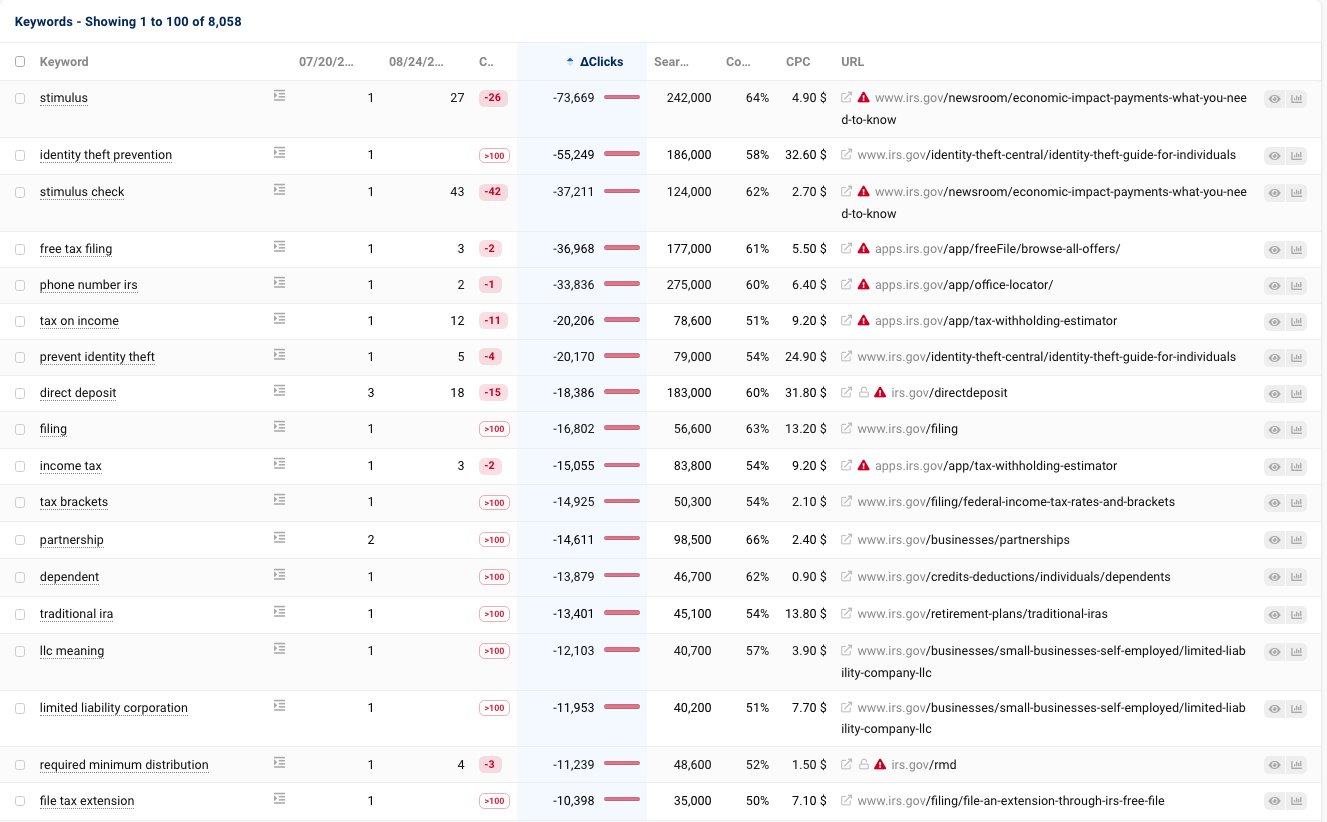
وقتی افت در چنین طیفی رخ میدهد، مدل تشخیص باید از Page-level به System-level تغییر کند. اگر فقط یک مقاله «tax brackets» افت میکرد، میتوانستیم سراغ Relevance، تازگی محتوا، Competitorها، Internal Linking یا کیفیت همان URL برویم. اما وقتی صفحات و موضوعات مختلف همزمان کاهش پیدا میکنند، احتمال وجود یک مشکل مشترک افزایش مییابد.
این دقیقاً همان جایی است که در سئوی حرفهای باید میان «علامت» و «علت» تفاوت بگذاریم. کاهش رتبه علامت است. کاهش کلیک علامت است. افت Visibility هم علامت است. هیچکدام بهتنهایی نمیگویند مشکل محتوایی، الگوریتمی، فنی یا امنیتی بوده است. کار اصلی متخصص سئو ساختن Hypothesisهای مختلف و حذف تدریجی گزینههایی است که با شواهد سازگار نیستند.
در این پرونده، یکی از قویترین سرنخها نه داخل ابزارهای سئو، بلکه مستقیماً روی صفحه نتایج گوگل دیده شد. گزارش اصلی اشاره میکند که جستوجوی IRS نتیجهای با فاوآیکون خراب و بدون توضیح معمول نمایش میداد. برای Query مربوط به «irs tax brackets» نیز IRS پایینتر از انتظار ظاهر شده و نتیجهاش نسبت به حالت عادی اطلاعات بسیار کمتری داشت.
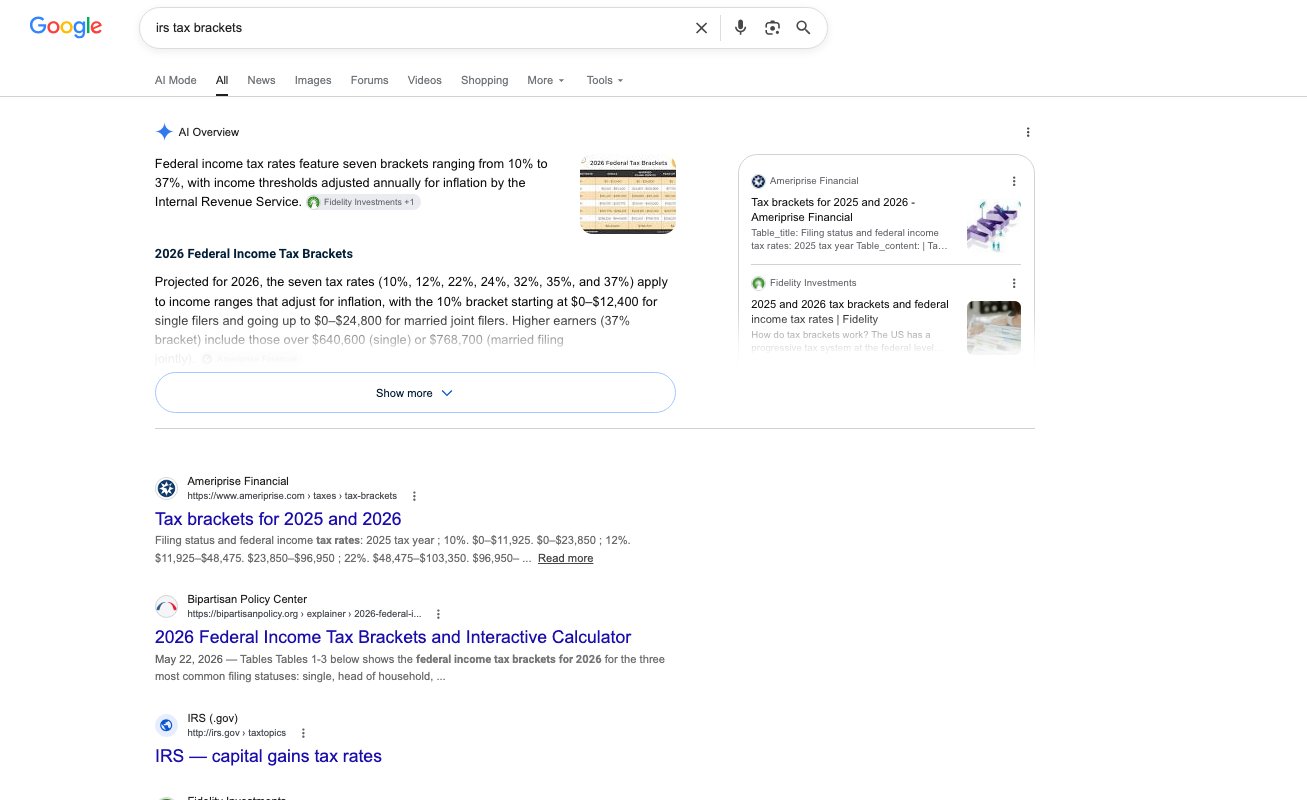
این نشانهها را نباید بهصورت قطعی معادل «گوگل سایت را نمیتواند کراول کند» دانست، اما وقتی همزمان با افت گسترده Visibility دیده میشوند، ارزش تشخیصی پیدا میکنند. گوگل برای ساخت بسیاری از اجزای نتیجه به اطلاعاتی نیاز دارد که در مرحله Crawl و Indexing جمعآوری میشوند. اگر دسترسی محدود شود یا دریافت منابع سایت با اختلال همراه باشد، نتیجهای که گوگل در اختیار دارد میتواند قدیمیتر یا ناقصتر باشد.
مستندات رسمی Google Search Central نیز میگویند سه شرط پایه برای واجد شرایط بودن یک صفحه برای ایندکس وجود دارد: گوگلبات نباید مسدود باشد، صفحه باید پاسخ موفق HTTP دریافت کند و محتوای قابل ایندکس داشته باشد. این موضوع بهتنهایی پرونده IRS را توضیح نمیدهد، اما نشان میدهد چرا بررسی Access یکی از اولین مراحل منطقی در چنین اتفاقی است.
Barry Schwartz در گزارش خود مینویسد حدس شخصی او این است که دولت فدرال نوعی Bot Blocking بیش از حد تهاجمی پیاده کرده که گوگل را هم در کنار سایر رباتها مسدود کرده است. او همچنین حدس میزند IRS بعداً اصلاحاتی انجام داده و سایت بهتدریج در حال بازگشت بوده است. این بخش از مقاله باید دقیقاً با همین سطح از قطعیت نقل شود: فرضیه نویسنده، نه تأیید فنی.
با این حال، از نظر آموزشی این فرضیه کاملاً ارزش بررسی دارد. امروز بسیاری از وبسایتهای بزرگ از WAF، CDN، Bot Management، سیستمهای ضداسکرپ، Rate Limiting و قوانین امنیتی چندلایه استفاده میکنند. افزایش Scraping توسط رباتهای خودکار، AI Crawlers و Bad Botها نیز باعث شده تیمهای امنیتی سختگیری بیشتری اعمال کنند. مشکل از جایی شروع میشود که Rule نتواند میان یک خزنده قانونی و ترافیک مشکوک بهدرستی تفکیک ایجاد کند.
مستندات گوگل به همین دلیل توصیه میکنند که اگر سایتی میخواهد Googlebot واقعی را شناسایی کند، تنها به User-Agent اعتماد نکند؛ زیرا User-Agent گوگلبات قابل جعل است. برای تأیید واقعی میتوان از Reverse DNS Lookup یا محدودههای IP رسمی Googlebot استفاده کرد.
این نکته برای تیم امنیتی مهم است. اگر Rule بنویسیم که هر Request با Pattern مشخص را ببندد، ممکن است Googlebot واقعی هم قربانی شود. از طرف دیگر، اگر صرفاً هر User-Agent با عبارت Googlebot را Allow کنیم، میتوانیم مسیر را برای Botهای جعلی باز کنیم. بنابراین سئو و امنیت در اینجا باید در کنار هم کار کنند.
بخش زیادی از سردرگمی در تحلیل چنین بحرانهایی از ترکیبکردن سه مرحله مختلف ناشی میشود: کراول، ایندکس و رتبهبندی. گوگل ابتدا باید URL را کشف و Fetch کند. سپس محتوای آن را پردازش و در صورت مناسب بودن در ایندکس نگهداری کند. بعد از آن، Ranking Systems تصمیم میگیرند برای یک Query مشخص کدام اسناد در چه ترتیبی نمایش داده شوند. مستندات رسمی گوگل نیز این مراحل را بهصورت مجزا توضیح میدهند.
اگر Googlebot نتواند صفحه را Fetch کند، مسئله پیش از Ranking شروع شده است. در این حالت بازنویسی Title یا اضافهکردن چند پاراگراف جدید به متن درمان مناسبی نیست. اگر صفحه کراول و ایندکس میشود اما رتبهاش پایین آمده، آن وقت سؤالهای مربوط به Relevance، Competition و Quality جدیتر میشوند.
پرونده IRS به همین دلیل مطالعه موردی خوبی است؛ زیرا علائم ظاهری باعث شدند متخصصان خیلی زود مسئله Access را وارد تحلیل کنند. این همان رفتاری است که در سایتهای معمولی نیز باید وجود داشته باشد.
در هر مشکل Crawling، فایل robots.txt یکی از اولین مواردی است که بررسی میشود، اما نباید همه چیز را به آن تقلیل داد. گوگل توضیح میدهد robots.txt برای مدیریت دسترسی خزنده به URLهاست و استفاده اشتباه از آن میتواند مانع Crawl شود. نکته جالب اینکه یک URL مسدودشده توسط robots.txt هنوز در بعضی شرایط میتواند به شکل URL در نتایج ظاهر شود، بدون اینکه توضیح مناسبی داشته باشد، چون گوگل از طریق لینکهای خارجی URL را میشناسد اما قادر به خواندن محتوای صفحه نیست.
این رفتار از نظر مفهومی شباهت جالبی با نتیجههای ناقص دارد، هرچند در مورد IRS سندی نداریم که مشخصاً robots.txt عامل بوده باشد. بنابراین استفاده درست از این مثال این است که بگوییم «نتیجه بدون Description میتواند با محدودیت Crawl سازگار باشد»، نه اینکه ادعا کنیم فایل robots.txt IRS خراب بوده است.
علاوه بر robots.txt، محدودیت میتواند در لایههای بسیار دیگری رخ دهد: فایروال، CDN، Authentication، IP Restriction، Geo Blocking، Cookie Challenge، JavaScript Challenge یا Rate Limiting. برای همین بررسی صرف یک فایل نمیتواند مشکل را رد کند.
اگر این اتفاق برای یک سایت تحت مدیریت خودمان رخ دهد، یکی از مهمترین Data Sourceها Server Log خواهد بود. گوگل نیز در مستندات Troubleshooting خود صراحتاً میگوید Search Console تاریخچه Crawl را در سطح URL به شکلی که بتوان همه مسیرها را فیلتر کرد ارائه نمیکند و برای بررسی اینکه URLهای مشخص واقعاً توسط Googlebot Crawl شدهاند، میتوان Logهای سایت را بررسی کرد.
در Log میتوان چند سؤال کلیدی را پاسخ داد. آیا Googlebot هنوز به URLهای مهم درخواست میفرستد؟ تعداد درخواستها نسبت به دوره عادی چه تغییری کرده؟ پاسخ سرور 200 است یا 403، 429، 5xx یا Timeout؟ آیا الگو فقط برای یک Directory اتفاق افتاده یا کل Host را درگیر کرده؟ آیا فایلهای PDF رفتار متفاوتی از صفحات HTML دارند؟
این دادهها کمک میکنند تحلیل از حد گمانه فراتر برود. اگر Crawls درست قبل از افت تقریباً متوقف شده باشند، Hypothesis دسترسی تقویت میشود. اگر Crawl کاملاً عادی باشد، باید به لایههای دیگری نگاه کنیم.
گاهی تیم زیرساخت برای کنترل فشار سرور یا Bot Traffic از پاسخهای اشتباه استفاده میکند. گوگل بهطور مشخص هشدار داده که استفاده از 403 یا 404 برای Rate Limiting روش مناسبی نیست. اگر سرور واقعاً تحت فشار است، پاسخهای 429 یا 503 برای شرایط موقت معنای درستتری دارند. حتی در مورد 429 و 503 نیز اگر وضعیت برای چند روز ادامه پیدا کند، گوگل میتواند Crawl را کاهش دهد و URLها ممکن است از ایندکس خارج شوند.
این نکته مستقیماً ثابت نمیکند IRS چنین رفتاری داشته است، اما درس Operational مهمی از پرونده میسازد. تیم Security نباید صرفاً با نگاه امنیتی Status Code انتخاب کند. Status Code برای خزنده یک Signal معنایی است و میتواند رفتار آینده موتور جستوجو را تغییر دهد.
به همین دلیل در Incidentهای SEO بهتر است Response Code Distribution برای Googlebot جداگانه مانیتور شود. افزایش ناگهانی 403، 429 یا 5xx میتواند پیش از سقوط بزرگ Search Visibility هشدار بدهد.
Search Engine Roundtable میگوید توجه جامعه سئو ابتدا در پی مشاهده افت PDFها در Google Search جلب شده بود و بعد Lily Ray و Glenn Gabe مشکلات گستردهتر IRS را بررسی کردند.
این موضوع برای سایتهای دولتی اهمیت ویژه دارد. سازمانهای دولتی حجم عظیمی از فرمها، دستورالعملها، اطلاعیهها و اسناد قانونی را در PDF منتشر میکنند. برای بسیاری از Queryها، PDF صرفاً فایل جانبی نیست؛ خودِ پاسخ اصلی کاربر است.
از نظر فنی نیز PDFها باید مانند سایر منابع Crawl و Index شوند. تنظیمات X-Robots-Tag روی Response Header میتواند برای فایلهای غیر HTML مانند PDFها noindex ایجاد کند و robots.txt نیز میتواند دسترسی Crawl را مدیریت کند. مستندات گوگل به این تفاوت اشاره میکنند.
بنابراین وقتی یک سایت سازمانی افت دارد، Audit فقط نباید روی صفحات HTML انجام شود. فایلها، Subdomainها، Applicationها و Assets قابل ایندکس نیز باید وارد بررسی شوند.
یکی از جذابترین بخشهای این پرونده همین Timing بود. Glenn Gabe اشاره کرد سایتهای دولتی در حوالی Spam Update افت کرده بودند.
برای تحلیلگر عجول، این Coincidence کافی است تا نتیجه بگیرد «Spam Update باعث افت IRS شده است.» اما چنین استنتاجی نمونه کلاسیک اشتباه Correlation و Causation است. اگر همزمان SERP Snippet ناقص، فاوآیکون خراب، مشکلات دسترسی انسانی و احتمال Bot Blocking را هم داریم، فرضیه فنی باید جدی گرفته شود.
در SEO این اتفاق مرتب رخ میدهد. هر روز صدها سایت Deploy، Migration، CDN Change، Firewall Update یا CMS Release دارند و در همان روزها Google Update نیز ممکن است جریان داشته باشد. برای همین تاریخ بهتنهایی علت را ثابت نمیکند.
مدل بهتر این است که Timeline کامل ساخته شود: چه زمانی Visibility افت کرد؟ آخرین Crawl موفق چه زمانی بوده؟ چه زمانی WAF یا Rule امنیتی تغییر کرده؟ چه زمانی Sitemap تغییر کرده؟ چه زمانی Update گوگل شروع شد؟ آیا همه Page Typeها همزمان افت کردند؟ این Timeline میتواند Hypothesisها را جدا کند.
Search Engine Roundtable روز ۲۸ اوت مطلب را بهروزرسانی کرد و نوشت به نظر میرسد سایت برگشته است. Barry Schwartz هم پستی منتشر کرد که نشان میداد شرایط بهتر شده است.
این Recovery با فرضیه اختلال موقت فنی سازگار است، اما باز هم اثبات قطعی علت نیست. اگر Rule امنیتی اصلاح شده باشد، طبیعی است Google دوباره دسترسی پیدا کند و Visibility بازگردد. اما بدون Postmortem رسمی IRS نمیتوان دقیقاً گفت کدام تنظیم تغییر کرده است.
درس حرفهای همین است: Recovery نباید ما را به Confidence کاذب درباره Root Cause برساند. چیزی که میتوانیم بگوییم این است که افت شدید موقت بود و در بازه کوتاهی نشانههای بازگشت دیده شد. باقی تحلیل باید با سطح مناسبی از احتیاط بیان شود.
در چنین شرایطی، واکنش خوب با تغییر محتوا شروع نمیشود؛ با Triage شروع میشود. ابتدا باید وسعت مشکل تعیین شود. سپس امکان دسترسی واقعی Googlebot به نمونهای از URLهای مهم بررسی شود و لاگها، Status Codeها و Search Console کنار هم قرار گیرند. بعد باید آخرین تغییرات فنی سایت مرور شوند تا مشخص شود آیا همزمان با شروع افت Deploy، Firewall Rule، CDN Configuration یا تغییر دیگری انجام شده است.
در مرحله بعد، نمونه SERPها بررسی میشوند. اگر Snippetها، favicon یا URL Presentation غیرعادی باشند، این داده باید وارد Hypothesis شود. سپس باید HTML Page، PDFها و Subdomainهای مختلف جداگانه آزمایش شوند.
فقط زمانی که شواهد فنی سالماند، فرضیههای مربوط به Quality و Ranking باید وزن بیشتری بگیرند. این ترتیب مانع از آن میشود که تیم ساعتها روی بازنویسی صفحهای کار کند که Googlebot اساساً نمیتواند به آن دسترسی پایدار داشته باشد.
ممکن است تصور کنیم IRS با میلیونها صفحه و زیرساخت دولتی ارتباطی با سایت شرکتی یا فروشگاه کوچک ندارد. اما الگوی خطا کاملاً قابل انتقال است. Cloudflare Rule اشتباه، Plugin امنیتی، CDN Misconfiguration یا تنظیم Host میتواند همان نوع مشکل را در مقیاس کوچک ایجاد کند.
تفاوت فقط در حجم تأثیر است. برای IRS، افت میتواند میلیونها Search را درگیر کند. برای یک شرکت کوچک شاید چند URL پولساز آسیب ببینند. از نظر Business، همان چند URL میتوانند حیاتی باشند.
درواقع سایتهای کوچک گاهی آسیبپذیرترند؛ چون Monitoring ضعیفتری دارند و ممکن است مشکل هفتهها دیده نشود.
این پرونده یک اصل ساده اما بنیادین را یادآوری میکند. بهترین محتوا، قویترین برند و معتبرترین دامنه تا زمانی که موتور جستوجو نتواند بهدرستی آنها را Fetch و پردازش کند، تضمینی برای Visibility نیستند.
مستندات خود گوگل نیز Access را جزء حداقل الزامات فنی Search میدانند.
برای همین Technical SEO را نباید مجموعهای از کارهای کوچک برای گرفتن چند امتیاز بیشتر تصور کرد. بخشی از Technical SEO نقش زیرساختی دارد: مطمئنشدن از اینکه سیستم Search اساساً میتواند محتوای ما را ببیند.
ماجرای IRS دقیقاً به همین دلیل ارزش مطالعه دارد. یک سایت بسیار معتبر افت میکند، علائم فنی ظاهر میشوند، متخصصان از دسترسی Googlebot سؤال میکنند و چند روز بعد سایت نشانههای Recovery نشان میدهد. شاید هیچوقت Postmortem کامل عمومی منتشر نشود، اما همین شواهد برای یادآوری یک اصل کافیاند: قبل از اینکه بپرسیم چرا صفحه رتبه نمیگیرد، باید مطمئن شویم گوگل هنوز میتواند آن صفحه را درست ببیند.
تهیه شده توسط تیم تخصصی سئو سید احسان خسروی (مدیر، متخصص و مشاور استراتژیک سئو)

