
برای سالهای طولانی، بهینهسازی تصاویر یکی از قابل پیشبینیترین بخشهای سئو بود. تیم محتوا تصویری انتخاب میکرد، توسعهدهنده آن را در قالب مناسب قرار میداد و متخصص سئو درباره حجم فایل، نام تصویر، متن جایگزین، ابعاد، Lazy Loading و حضور احتمالی در Google Images نظر میداد. این فرایند هنوز معتبر است و هیچیک از اصول فنی قدیمی ناگهان بیارزش نشدهاند، اما مقاله تازه Myriam Jessier در Search Engine Land یک مسئله متفاوت را وارد بحث میکند: وقتی سیستم جستوجو خودش قادر به تحلیل تصویر است، کیفیت Image SEO دیگر فقط به Delivery و Metadata محدود نمیشود؛ محتوای واقعی پیکسلها نیز اهمیت پیدا میکند.
این تغییر در نگاه اول ممکن است صرفاً ادامه رشد Visual Search به نظر برسد، اما پیامد آن برای تیمهای محتوا گستردهتر است. در مدل قدیمی، تصویر عمدتاً برای کاربر طراحی میشد و موتور جستوجو از طریق اطلاعات پیرامونی آن را میفهمید. در محیط Multimodal، سیستم میتواند Objectها را شناسایی کند، متن داخل عکس را بخواند و ترکیب عناصر مختلف Frame را به Representation قابل پردازش تبدیل کند. در نتیجه، ممکن است Creative Team قصد داشته باشد محصول مشخصی، موقعیت استفاده خاصی یا ویژگی معینی را برجسته کند، اما Machine Vision چیز دیگری را مهمتر تشخیص دهد یا بخشی از پیام را اصلاً نبیند.
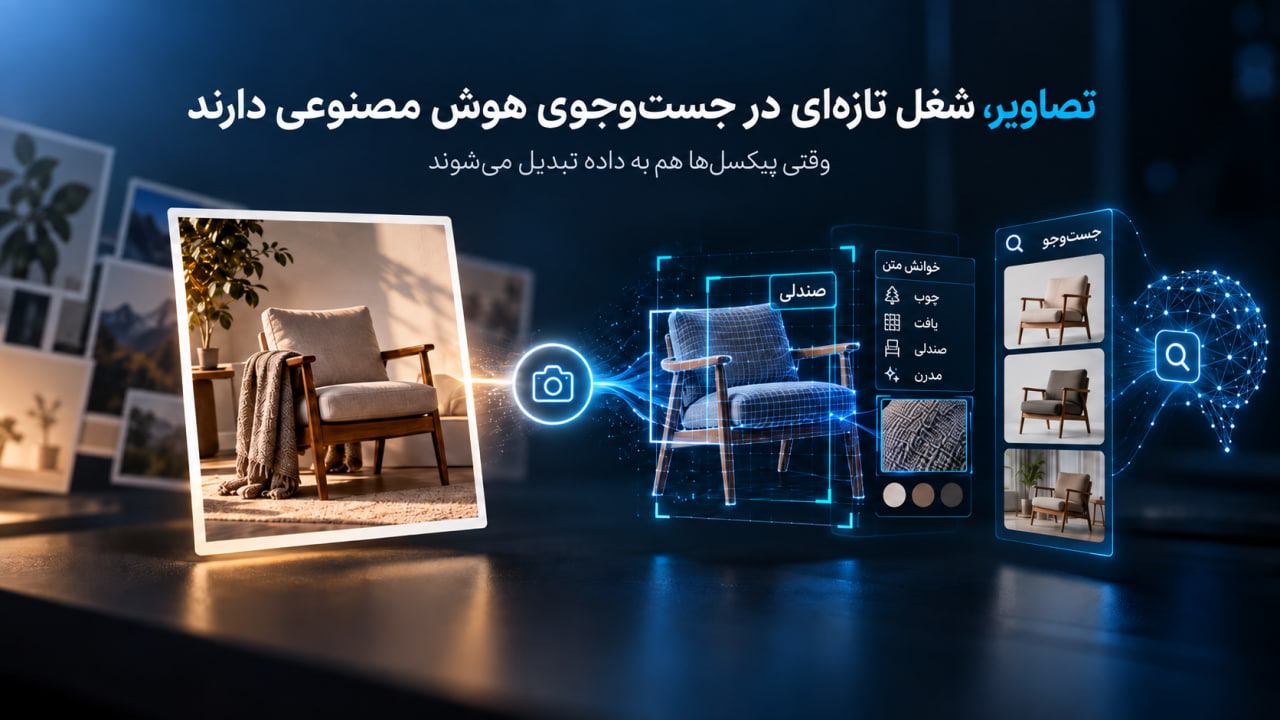
Search Engine Land برای نشاندادن ابعاد تغییر به عددی از Google Lens اشاره میکند: حدود ۲۰ میلیارد Visual Search در ماه. اهمیت این عدد فقط در حجم استفاده نیست؛ نکته مهم این است که Search Interaction میتواند بدون تبدیل کامل نیاز کاربر به کلمات آغاز شود. شخصی که قطعهای صنعتی، مدل خاص کفش، گیاه، وسیله خانگی یا محصول ناشناختهای را میبیند، لزوماً نام دقیق آن را نمیداند. دوربین در چنین موقعیتی عملاً جای مرحله توصیف زبانی را میگیرد و خود تصویر به نقطه شروع Query تبدیل میشود.
این مدل رفتار کاربر، رابطه تصویر و Search را دوطرفه میکند. در گذشته عمدتاً درباره این صحبت میکردیم که کاربر با Query متنی به یک تصویر برسد؛ اکنون تصویر نیز میتواند باعث ساختهشدن Query شود. برای فروشگاه اینترنتی، تولیدکننده صنعتی، سایت گردشگری، برند مد یا حتی کسبوکاری خدماتی، این موضوع به معنای آن است که Visual Asset بخشی از زیرساخت Discovery است و نه صرفاً عنصر تزئینی صفحه.
مقاله این تغییر را با عبارت سادهای توصیف میکند: Search Bar امروز هم Text Box است و هم Camera. همین تغییر رابط کاربری میتواند باعث شود Photography، Product Imaging و Diagram Design بیش از گذشته با Search Strategy مرتبط شوند. اگر ورودی کاربر Visual باشد، چیزی که درون تصویر قرار دارد باید به اندازه کافی روشن باشد تا سیستم بتواند آن را با اطلاعات وب مرتبط کند.
یکی از بخشهای حساس مقاله، اشاره به Patent Application گوگل است که در سال ۲۰۲۳ ثبت و در آوریل ۲۰۲۶ منتشر شده است. در Flow توصیفشده در این Patent، امکان انتخاب منبع براساس Image Match و سپس بازیابی Surrounding Text برای ساخت پاسخ مطرح میشود. از منظر تحقیق درباره جهتگیری فنی شرکتها، چنین سندی جالب است؛ زیرا نشان میدهد Visual Matching و ارتباط تصویر با متن اطراف آن جزو مسائلی بوده که مهندسان گوگل برایشان Mechanism طراحی کردهاند.
بااینحال، مقاله خودش Caveat بسیار مهمی را حفظ میکند. Patent Application مدرک استفاده عملی و قطعی از همین Flow در Google Search نیست. شرکتهای فناوری هزاران Patent ثبت میکنند و بسیاری از آنها هرگز دقیقاً به همان شکل وارد Product نمیشوند. بنابراین استفاده درست از این بخش مقاله این نیست که بگوییم «گوگل اکنون تصویر را قبل از متن Rank میکند» یا اینکه «Visual Match به Ranking Factor رسمی تبدیل شده است». تنها نتیجه قابل دفاع این است که Retrieval بصری و اتصال آن به متن از نظر فنی برای گوگل موضوع مهمی بوده و در کنار Scale بالای Lens، دلیل خوبی برای جدیگرفتن Image Interpretability ایجاد میکند.
برای تیم سئو، این تمایز اهمیت زیادی دارد. تجربه صنعت نشان داده هر بار Patent جدیدی منتشر میشود، خیلی سریع مجموعهای از دستورالعملهای قطعی از آن استخراج میشود؛ درحالیکه Patent Intelligence با Algorithm Intelligence یکسان نیست. سند Patent امکان و ایده را نشان میدهد، اما درباره Production System نیازمند شواهد مستقل هستیم.
یکی از بخشهای کاربردی مقاله، بررسی نوع تصاویر در Page Typeهای مختلف است. تصویر Hero صفحه اصلی معمولاً وظیفه ساخت First Impression و Brand Identity را دارد. در نگاه جدید، Originality و Distinctiveness آن نیز اهمیت تحلیلی پیدا میکند، زیرا تصویری که روی دهها سایت دیگر استفاده شده است Visual Asset اختصاصی برای Brand نمیسازد. مقاله این موضوع را در قالب Ownership Rate وارد Scorecard پیشنهادی خود میکند.
در صفحات محصول، مسئله متفاوت است. چند زاویه High-resolution، Close-up و نمای بستهبندی سالهاست برای Conversion مفیدند. در محیط Multimodal، خوانایی نوشته روی محصول نیز وارد بحث میشود. اگر مدل محصول، وزن، Variant، Ingredient یا Feature روی Label نوشته شده باشد، کیفیت عکاسی و Compression تعیین میکنند که OCR چقدر از این اطلاعات را بتواند بازیابی کند. در اینجا طراحی Packaging، Lighting و Resolution دیگر صرفاً مسئله زیبایی نیستند و میتوانند روی میزان اطلاعات قابل استخراج از تصویر اثر بگذارند.
در محتوای آموزشی، Diagram و Infographic باید علاوه بر انتقال Visual Concept، اطلاعات مهم خود را در متن قابل خواندن صفحه نیز داشته باشند. گذاشتن یک Claim مهم فقط داخل Graphic، وابستگی کامل به OCR ایجاد میکند و Accessibility را هم کاهش میدهد. در About Page و Team Page نیز تصاویر میتوانند اطلاعاتی درباره Person، Workplace و Context ارائه دهند. نکته مهم این است که هر Page Type نیاز بصری متفاوتی دارد و نمیتوان یک Checklist یکسان را روی همه تصاویر اعمال کرد.
نویسنده برای Audit تصویر دو سؤال متفاوت پیشنهاد میکند. سؤال اول کاملاً Literal است: چه Objectهایی واقعاً داخل Frame قرار دارند و آیا سیستم آنها را درست تشخیص میدهد؟ اگر عکس یک Coffee Maker و Thermal Carafe را نشان میدهد، میتوان بهصورت مشخص بررسی کرد که Vision Model هر دو را Detect کرده یا خیر. این لایه به چیزی نزدیک است که در مقاله Denotation نامیده میشود؛ اطلاعاتی که در سطح Object قابل مشاهده و بررسیاند.
سؤال دوم درباره Meaning کلی Composition است. عبارت «محیط حرفهای برای کار تیمی» یک Object نیست که بتوان دور آن Bounding Box کشید. این معنی از ترکیب میز، لپتاپ، افراد، پوشش آنها، نور، فضای داخلی و اشیای دیگر ساخته میشود. ممکن است تکتک Objectها درست تشخیص داده شوند اما Association نهایی چیزی متفاوت از Brand Intent بسازد. مقاله این بخش را به Connotation و Co-occurrence مرتبط میکند.
تفاوت میان این دو Audit به تیمها کمک میکند نقشها را هم بهتر تقسیم کنند. SEO یا Data Team میتواند روی تشخیص Object و OCR تمرکز کند؛ Creative و Brand Team میتوانند Context و Association را بررسی کنند؛ Content Team نیز وظیفه دارد مطمئن شود Text صفحه همان Meaning اصلی را Machine-readable کرده است.
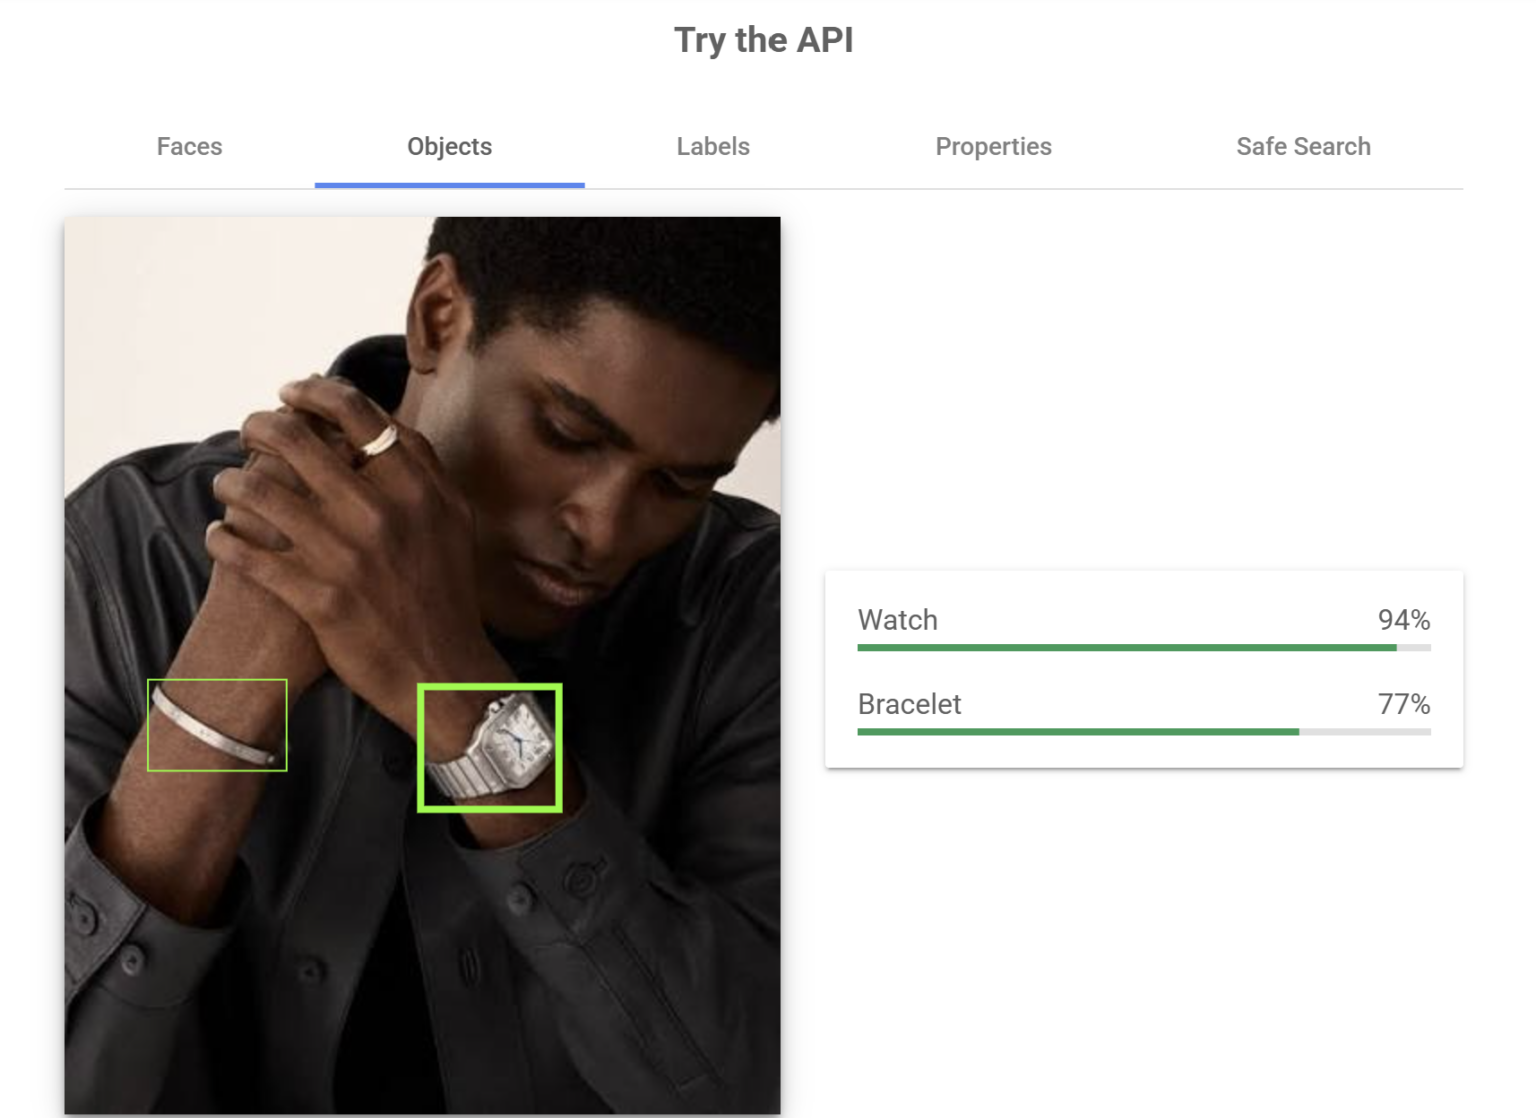
تصویر Cartier موجود در مقاله یکی از بهترین مثالهای عملی برای فهم موضوع است. در آن Visual، سیستم Bracelet و Watch را تشخیص داده اما Ring را Detect نکرده است. پیام این Example این نیست که Campaign Cartier مشکل SEO داشته یا اینکه Ring حتماً باید برای Google Search شناسایی شود؛ مسئله این است که Presence یک Object در Frame به معنی Guarantee برای Machine Recognition نیست.
برای Product Photography این مسئله عملیتر میشود. فرض کنیم مهمترین تفاوت مدل جدید یک محصول در Connector کوچک پشت دستگاه است، اما Hero Photo فقط نمای روبهرو را نشان میدهد. انسان با دیدن Gallery بعدی ممکن است مشکل را حل کند، ولی Image اصلی شاید Evidence لازم را حمل نکند. یا نوشته مهم روی Packaging به دلیل انعکاس نور برای OCR قابل خواندن نباشد. چنین موضوعاتی نشان میدهند Visual QA میتواند علاوه بر زیبایی و Conversion، یک لایه Machine Interpretability نیز داشته باشد.
Search Engine Land در Scorecard پیشنهادی خود Ownership Rate را بهعنوان سهم Hero Imageهای واقعاً اختصاصی معرفی میکند. نویسنده برای بررسی Duplicate، Near-duplicate و Visually Similar Image پیشنهاد استفاده از قابلیت Web Detection در Google Cloud Vision را مطرح میکند. هدف از این Metric این نیست که ثابت کند Stock Image باعث Penalty میشود؛ چنین ادعایی در مقاله وجود ندارد. مسئله Distinctiveness است.
اگر یک تصویر Stock روی پنجاه Domain مختلف وجود دارد، آن Asset تقریباً هیچ هویت بصری اختصاصی برای Brand ایجاد نمیکند. در مقابل، تصویر Original از Product، Packaging، محیط واقعی، Team یا فرایند کاری میتواند Evidence متمایزتری ایجاد کند. این موضوع حتی مستقل از AI Search نیز برای Branding ارزش دارد و میتواند Asset Library برند را قویتر کند.
نکته مهم این است که Ownership Rate باید بهعنوان Internal Audit Metric دیده شود، نه Ranking Factor. کاربرد آن کمک به تصمیمگیری درباره این است که کدام Visualها Generic هستند و کدام Assetها واقعاً به Business تعلق دارند.
Legibility Rate یکی دیگر از Metricهای پیشنهادی مقاله است. در صفحات محصول، ممکن است اطلاعات زیادی فقط روی Packaging دیده شوند؛ از نام Variant و وزن گرفته تا Ingredient، Model Number یا Claim. اگر سیستم OCR نتواند این نوشتهها را بخواند، بخشی از اطلاعات موجود در Visual برای Machine قابل استخراج نیست. مقاله برای این بخش به TEXT_DETECTION اشاره میکند.
این نگاه باعث میشود Compression Strategy هم پیچیدهتر شود. کاهش حجم فایل همچنان برای Performance مهم است، اما فشردهسازی بیش از حد میتواند Text کوچک را تخریب کند. در عکسهای Reflective نیز Glare میتواند خوانایی نوشته را کم کند. بنابراین کیفیت تصویر را نمیتوان فقط با Pixel Dimension یا Size فایل سنجید؛ باید دید اطلاعات اصلی بعد از Resize و Compression نیز باقی ماندهاند یا خیر.
باز هم باید تفاوت Tool و Search System حفظ شود. اینکه Google Cloud Vision برای Audit پیشنهاد شده به معنی آن نیست که Google Search دقیقاً از همان API عمومی استفاده میکند. این ابزار صرفاً یک Proxy عملی برای دیدن Machine-readable بودن Visual است.
تصویر Product در خلأ قرار ندارد. یک ساعت کنار Laptop، Notebook و Coffee Mug یک Association میسازد؛ همان ساعت کنار Surfboard و Beach Towel Association دیگری ایجاد میکند. Creative Team از چنین Co-occurrenceهایی برای Positioning استفاده میکند، اما Machine Vision نیز ممکن است همین Objectها را تشخیص دهد و از ترکیبشان Representation بسازد.
مقاله Context Match را برای همین مسئله پیشنهاد میکند. ابتدا میتوان Objectهای موجود در Frame را استخراج کرد و سپس بهصورت انسانی بررسی کرد که آیا Visual Neighbors با Brand Guideline هماهنگاند یا خیر. ابزار در اینجا تصمیم نمیگیرد چه Contextی مناسب Brand است؛ فقط Inventory بصری میدهد و Judgment همچنان بر عهده تیم است.
این نکته باعث میشود SEO Brief حتی پیش از عکاسی قابل استفاده باشد. اگر Service Page قرار است محیطی تخصصی و صنعتی را نشان دهد، قرار دادن اشیای بیارتباط یا بیش از حد Generic در Frame ممکن است Story را ضعیف کند. این موضوع الزاماً «تکنیک رتبهگیری» نیست؛ مسئله Consistency اطلاعاتی است.
Ownership Rate، Context Match، Sentiment Alignment، Legibility Rate و Fan-out Coverage در مقاله بهعنوان Multimodal Image GEO Scorecard معرفی شدهاند. این نامگذاری ممکن است وسوسه ایجاد کند که آنها را بهعنوان Metric رسمی Google تصور کنیم، اما چنین چیزی در منبع وجود ندارد. اینها چارچوبهای عملی نویسنده برای ممیزی Visual Asset هستند، نه اطلاعاتی که Search Console گزارش کند یا گوگل رسماً بهعنوان Ranking Signal معرفی کرده باشد.
ارزش یک Internal Metric به رسمیبودن آن نیست. تیم میتواند معیار اختصاصی برای بررسی کیفیت محصول، Accessibility یا Consistency محتوا داشته باشد بدون اینکه آن معیار مستقیماً Ranking Factor باشد. همین منطق در اینجا هم صادق است. اگر Legibility Rate پایین باشد، میفهمیم تصاویر محصول بخش زیادی از اطلاعاتشان را به شکل ناخوانا ارائه میکنند و اصلاح آن از نظر UX، Accessibility و Machine Readability قابل دفاع است.
مشکل زمانی شروع میشود که Correlation احتمالی یا Framework پیشنهادی به وعده Ranking تبدیل شود. مقاله چنین وعدهای نمیدهد و اجرای حرفهای هم نباید چنین برداشتی ایجاد کند.
یکی از بهترین توصیههای مقاله این است که اطلاعات مهم را نزدیک تصویر بیان کنیم. اگر Diagram یک Claim را نشان میدهد، Paragraph یا Caption مجاور نیز باید آن Claim را به زبان خوانا توضیح دهد. اگر عکس Product ویژگی مشخصی را نمایش میدهد، متن صفحه باید همان ویژگی را نامگذاری کند. این کار حتی بدون در نظرگرفتن Patent گوگل، از نظر Accessibility و UX منطقی است.
درواقع تصویر و متن نباید دو Asset مستقل باشند که فقط کنار هم قرار گرفتهاند. باید میان آنها یک رابطه اطلاعاتی وجود داشته باشد. وقتی کاربر تصویر را میبیند، Text توضیح میدهد چرا آن Visual مهم است؛ وقتی Machine صفحه را پردازش میکند، محتوای نوشتاری نیز Evidence بصری را به Entity و Claim مشخص متصل میکند.
این موضوع برای Infographicها اهمیت بیشتری دارد. اگر تمام عددها، Labelها و نتیجه داخل Graphic باشند و متن صفحه فقط بنویسد «در نمودار بالا مشاهده میکنید»، بخش بزرگی از اطلاعات اصلی به Pixel محدود شده است. بهتر است Findings مهم بهصورت متن مستقل نیز در صفحه وجود داشته باشند.
Fan-out Coverage یکی از جالبترین ایدههای مقاله است، چون تصویر را از یک Asset انتهایی به منبع Research تبدیل میکند. فرض کنیم عکس محصول شکل Connector، اندازه، Accessories و نحوه نصب را نشان میدهد، اما متن صفحه فقط درباره قیمت و Material حرف میزند. از خود تصویر چند سؤال بالقوه ایجاد میشود که Page پاسخ مستقیمی برایشان ندارد. نویسنده پیشنهاد میکند این Gapها بهعنوان بخشی از Audit بررسی شوند.
در چنین مدلی، عکاس و Content Writer باید هماهنگتر کار کنند. اگر Visual یک Attribute مهم را نشان میدهد، Content Brief باید تصمیم بگیرد آیا لازم است همان Attribute توضیح داده شود. برعکس، اگر متن وعدهای میدهد که هیچ Visual Evidenceای برایش وجود ندارد، شاید Photo Set ناقص باشد.
این ارتباط باعث میشود Visual Architecture شبیه Information Architecture شود. هر تصویر Purpose مشخصی دارد و برای یک یا چند سؤال کاربر Evidence فراهم میکند.
مقاله در توصیههای پایانی پیشنهاد میکند Fan-out پوشش داده شود، نه اینکه تمام وظایف به یک Keyword یا یک Image سپرده شوند. برای یک محصول، نمای جلو، پشت بستهبندی، اندازه واقعی، محل اتصال، نحوه استفاده و Accessories هرکدام میتوانند سؤال مشخصی را پاسخ دهند. در چنین شرایطی چند تصویر ساده و واضح از یک Hero شلوغ که همه چیز را همزمان نشان میدهد اطلاعات قابل استفادهتری ایجاد میکنند.
این توصیه با UX نیز هماهنگ است. کاربر هنگام خرید میخواهد در هر تصویر یک موضوع را بفهمد و مجبور نباشد روی تصویر تبلیغاتی پیچیده Zoom کند تا جزئیات عملی را پیدا کند. Machine نیز در Visual سادهتر Objectهای اصلی و Text را راحتتر جدا میکند.
بنابراین افزایش تعداد تصاویر بهخودیخود هدف نیست. هر Visual باید Job مشخصی داشته باشد. اگر تصویر اطلاعات جدیدی اضافه نمیکند، صرفاً تکرار Asset قبلی است.
بهترین واکنش به چنین مقالهای بازطراحی هزاران تصویر نیست. بهتر است یک Pilot محدود روی صفحات با Business Value بالا انجام شود. مثلاً ۲۰ صفحه محصول، Service Page یا Landing Page مهم انتخاب شوند و Hero Image، تصاویر Detail و Graphicهای اصلی آنها بررسی شوند.
در این Audit میتوان Originality، Object Clarity، OCR Legibility و رابطه میان تصویر و Copy را ارزیابی کرد. Assetهایی که روی سایتهای زیادی تکرار شدهاند، Productهای تار، Labelهای ناخوانا یا تصاویر دارای Context نامرتبط در اولویت اصلاح قرار میگیرند. سپس میتوان اثر تغییرات را روی Conversion، Engagement، Image Search و سایر KPIهای موجود بررسی کرد.
نباید از ابتدا وعده داد که چنین پروژهای AI Citation را افزایش میدهد، زیرا منبع چنین رابطه قطعیای را ثابت نکرده است. ارزش Pilot در بهبود کیفیت اطلاعات بصری و ایجاد Dataset داخلی برای تصمیمهای بعدی است.
تصویر قبلاً هم مسئولیت سادهای نداشت. باید جذاب میبود، Trust میساخت، Product را توضیح میداد، با Brand هماهنگ میشد، سریع Load میشد و برای Accessibility مناسب بود. Multimodal Search هیچکدام از این وظایف را حذف نکرده است؛ فقط یک مسئولیت تازه اضافه کرده: اطلاعات مهم Visual باید تا حد ممکن برای سیستمهای ماشینی نیز قابل تشخیص و قابل اتصال به محتوای صفحه باشند.
این تغییر باعث نمیشود طراحی برای Robot جای طراحی برای انسان را بگیرد. اگر تصویر برای مشتری بد باشد ولی برای Object Detection عالی عمل کند، Business شکست خورده است. هدف بهتر این است که Human Meaning و Machine Interpretation تا حد ممکن با هم همراستا شوند.
در نتیجه، سئوی تصاویر آینده احتمالاً کمتر شبیه اصلاح چند Metadata بعد از Upload خواهد بود و بیشتر به همکاری میان SEO، Content، UX و Creative تبدیل میشود. سؤال اصلی این نیست که «چه Keywordی داخل نام فایل بگذاریم؟»؛ سؤال اصلی این است که آیا Visual، Copy و Context در کنار هم Information واضح و بدون تناقضی درباره موضوع صفحه میسازند یا خیر.
تهیه شده توسط تیم تخصصی سئو سید احسان خسروی (مدیر، متخصص و مشاور استراتژیک سئو)

