
یکی از جذابترین وعدههای جستوجوی مبتنی بر هوش مصنوعی این است که بخش زیادی از زحمت جستوجوی سنتی را از دوش کاربر برمیدارد. برای بسیاری از سؤالها دیگر لازم نیست چند عبارت مختلف امتحان کنیم، ده نتیجه را باز کنیم، میان تبهای متعدد جابهجا شویم و در نهایت خودمان نکات مشترک و متناقض چند منبع را کنار هم قرار دهیم. این مزیت واقعی است و انکار آن منطقی نیست. بااینحال، مقاله تازه Duane Forrester در Search Engine Journal پیشنهاد میکند مسئله را کمی دقیقتر ببینیم. سؤال مهم فقط این نیست که هوش مصنوعی جستوجو را سادهتر کرده یا نه؛ باید ببینیم کاری که قبلاً ذهن کاربر انجام میداد اکنون واقعاً حذف شده یا فقط به مرحله دیگری از فرایند منتقل شده است.
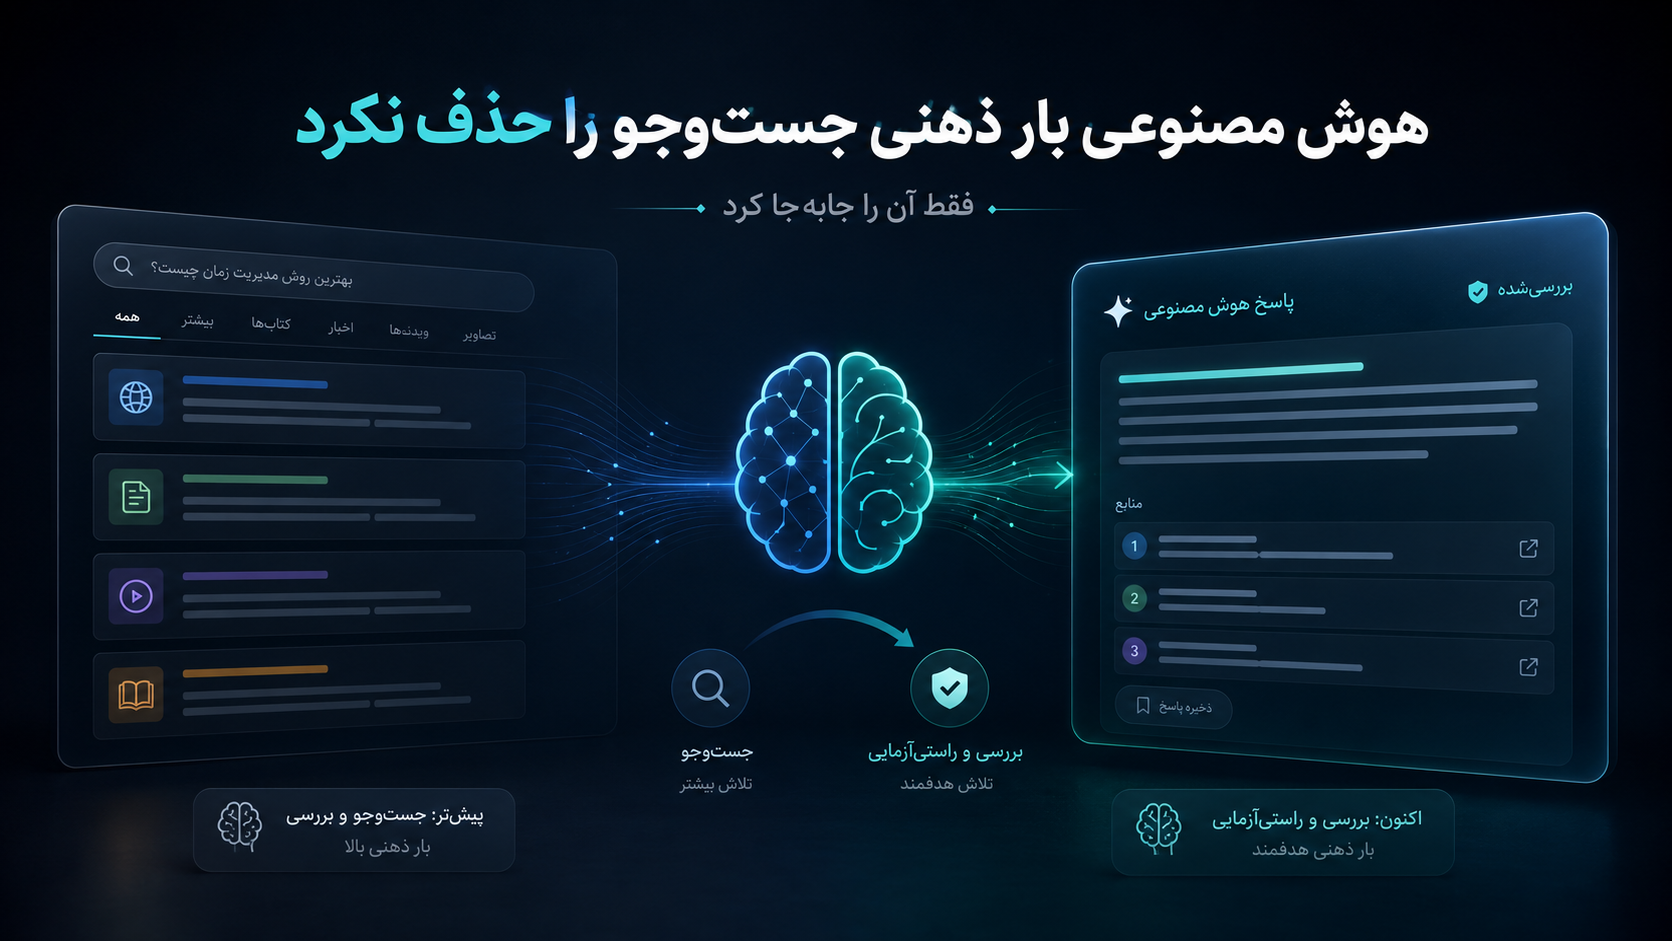
پاسخ Forrester این است که هر دو اتفاق رخ دادهاند. بخشی از اصطکاک جستوجو واقعاً کاهش پیدا کرده است، اما بخش دیگری از بار شناختی شکل تازهای گرفته و مخصوصاً به مرحله ارزیابی و راستیآزمایی منتقل شده است. این تفاوت برای متخصص سئو اهمیت بیشتری از بحث ساده «آیا کاربران کمتر کلیک میکنند؟» دارد، چون محتوا دیگر الزاماً در همان صفحهای که طراحی کردهایم مصرف نمیشود. ممکن است فقط یک بخش از مقاله بازیابی شود، با اطلاعات چند منبع دیگر ترکیب شود، فشرده شود و در نهایت به کاربری برسد که هرگز ساختار کامل صفحه، جدولها، توضیحات روششناسی یا پاراگرافهای قبل و بعد را ندیده است. در چنین محیطی، کیفیت محتوا فقط به درستبودن آن روی صفحه محدود نیست؛ باید دید معنای اطلاعات بعد از جداشدن از صفحه چقدر دوام میآورد.
مقاله Forrester بحث خود را با ایدهای از Jakob Nielsen پیوند میدهد. Nielsen در مقالهای درباره Cognitive Load تأکید میکند که بار شناختی را نباید صرفاً دشمن طراحی دانست؛ بهتر است آن را بودجهای محدود تصور کنیم که باید درست مصرف شود. در مدلی که او توضیح میدهد، حافظه کاری انسان تقریباً چهار Chunk معنادار را همزمان مدیریت میکند. بنابراین هدف یک رابط خوب این نیست که کاربر هیچ فکری نکند، بلکه باید پیچیدگیهای غیرضروری را حذف کند تا ظرفیت ذهنی برای خود مسئله باقی بماند. اگر مسئله ذاتاً پیچیده است، هیچ طراحیای نمیتواند آن پیچیدگی را کاملاً حذف کند؛ آنچه میتوان حذف کرد پیچیدگیای است که خود سیستم بیدلیل به مسئله اضافه کرده است.
همین تفکیک در جستوجو اهمیت زیادی دارد. انتخاب یک درمان پزشکی، مقایسه چند طرح سرمایهگذاری یا تصمیمگیری درباره یک سیستم نرمافزاری سازمانی ذاتاً مسئلههایی پیچیدهاند. حتی بهترین موتور جستوجو نمیتواند تمام پیچیدگی واقعی آنها را از بین ببرد. اما اینکه کاربر مجبور باشد سؤالش را در قالب چند Keyword حدس بزند، چند نتیجه تقریباً مشابه را باز کند، اطلاعات پراکنده را به خاطر بسپارد و مدام بین صفحات مختلف رفتوآمد کند، بخش دیگری از بار شناختی است که بیشتر از طراحی سیستم ناشی میشود. جستوجوی مولد توانسته بخشی از این لایه دوم را کاهش دهد، اما با حذف این مراحل، مسئولیت تازهای را در انتهای فرایند ایجاد کرده است: حالا باید درباره پاسخ ساختهشده توسط سیستم قضاوت کنیم.
جستوجوی سنتی بیشتر شبیه فراهمکردن مواد اولیه بود تا تحویل محصول نهایی. موتور جستوجو مجموعهای از صفحات را رتبهبندی میکرد و کاربر باید از میان آنها مسیر خودش را پیدا میکرد. حتی پیش از دیدن نتایج، یک مرحله مهم وجود داشت: تبدیل نیاز اطلاعاتی به Query. مطالعه Jacek Gwizdka درباره توزیع بار شناختی در Web Search با ۴۸ شرکتکننده نشان داد Cognitive Load در مراحل مختلف جستوجو یکسان نیست و هنگام Query Formulation و توصیف سند مرتبط از بررسی نتیجهها و مشاهده صفحات بیشتر است. این یافته نشان میدهد همان مرحلهای که برای متخصصان سئو بدیهی به نظر میرسد، برای بسیاری از کاربران خودش یک وظیفه ذهنی قابل توجه است.
پس از Query نیز کار تمام نمیشد. کاربر باید از Title و Snippet حدس میزد کدام صفحه مناسبتر است، چند منبع را باز میکرد، اطلاعات مرتبط را از بخشهای نامرتبط جدا میکرد و تناقض میان منابع را حل میکرد. علاوه بر این، باید تصمیم میگرفت چه زمانی اطلاعات کافی جمع شده و جستوجو را متوقف کند. این فرایند شاید برای تحقیق جدی مفید باشد، اما هزینه زمانی و ذهنی بالایی دارد. جستوجوی مولد دقیقاً در همین نقطه وارد میشود و بخش بیشتری از Retrieval، Source Selection و Synthesis را پیش از آنکه کاربر نتیجه را ببیند انجام میدهد.
پژوهش «Characterizing Web Search in The Age of Generative AI» که در Findings of ACL 2026 منتشر شده، تفاوت جستوجوی سنتی و مولد را بهصورت سیستماتیک بررسی کرده است. پژوهشگران Google Organic Search را با پنج سیستم Generative Search از Google، OpenAI و Perplexity مقایسه کردند. در تعریف آنها، جستوجوی سنتی مجموعهای رتبهبندیشده از صفحات مستقل را تحویل میدهد، درحالیکه جستوجوی مولد اطلاعات مرتبط را بازیابی و آنها را در یک پاسخ منسجم ترکیب میکند. این تحقیق همچنین نشان داد موتورهای مختلف از نظر Source Diversity، اتکا به دانش داخلی یا بیرونی، Retrieval Footprint، روش Synthesis و Stability خروجی تفاوت قابل توجهی دارند.
این تفاوت ظاهراً فنی، نقش کاربر را عوض میکند. موتور دیگر فقط نمیگوید «این چند صفحه ممکن است جواب سؤال شما را داشته باشند»، بلکه خودش وارد مرحله خواندن، انتخاب و ترکیب اطلاعات میشود. کاربر در بسیاری از موارد چیزی نزدیکتر به محصول نهایی دریافت میکند. بنابراین بخشی از کاری که قبلاً در ذهن کاربر انجام میشد اکنون در لایهای انجام میشود که کاربر آن را نمیبیند. این موضوع لزوماً بد نیست؛ اتفاقاً بخش بزرگی از ارزش سیستمهای مولد همین است. مسئله زمانی مهم میشود که بخواهیم بفهمیم مرحله بعدی چه وظیفهای بر عهده انسان گذاشته است.
در جستوجوی سنتی معمولاً کاربر شواهد را پیش از نتیجه نهایی میدید. ممکن بود منبع اول یک ادعا را مطرح کند، منبع دوم با آن مخالفت کند و منبع سوم اطلاعاتی ارائه دهد که بخشی از اختلاف را توضیح دهد. پاسخ در حین مواجهه با همین شواهد شکل میگرفت و بخش مهمی از مسیر استدلال برای کاربر قابل مشاهده بود. جستوجوی مولد میتواند ترتیب را برعکس کند: ابتدا پاسخ ساختهشده نمایش داده میشود و منابع، در صورت نمایش، به شکل Citation یا لینک بعد از آن ظاهر میشوند.
در نتیجه، کار ذهنی از «چطور از این شواهد پاسخ بسازم؟» به «آیا این پاسخ آماده را باید باور کنم؟» تغییر میکند. این نوع Verification با خواندن منابع از ابتدا متفاوت است، چون نتیجه از قبل جلوی چشم کاربر قرار دارد و ممکن است بر نحوه ارزیابی شواهد اثر بگذارد. یک پاسخ روان، منظم و مطمئن همراه با چند Citation میتواند از نظر بصری و روانشناختی بسیار قابل اعتماد به نظر برسد. اما قابل اعتماد به نظر رسیدن با راستیآزمایی واقعی یکسان نیست. دقیقاً همین تفاوت است که پژوهشهای جدید درباره Trust در AI Search را مهم میکند.
مطالعه Haiwen Li و Sinan Aral یکی از مهمترین شواهد تجربی در این زمینه است. پژوهشگران حدود ۱۲ هزار Query را در هفت کشور اجرا کردند و تقریباً ۸۰ هزار نتیجه جستوجوی سنتی و مولد جمعآوری کردند. سپس یک آزمایش تصادفی از پیش ثبتشده روی نمونه بزرگی از جمعیت آمریکا انجام دادند. نتیجه نشان داد شرکتکنندگان بهطور متوسط اعتماد کمتری به جستوجوی مولد نسبت به جستوجوی سنتی داشتند، اما وجود Reference Link و Citation اعتماد آنها را بهطور معناداری بالا میبرد؛ نکته مهم این بود که این افزایش اعتماد حتی در شرایطی رخ میداد که لینک یا Citation اشتباه یا Hallucinated بود. پژوهش همچنین گزارش کرد افرادی که اعتماد بیشتری داشتند بیشتر کلیک میکردند و زمان کمتری صرف ارزیابی نتیجه میکردند.
نباید از این یافته نتیجه بگیریم تمام کاربران همیشه با دیدن Citation فریب میخورند. خود مطالعه نشان میدهد Trust با موضوع، ویژگیهای فردی، آموزش، تجربه استفاده از GenAI و عوامل دیگر تغییر میکند. بااینحال، یک نکته روشن است: وجود نشانهای شبیه منبع میتواند هزینه ادراکی Verification را کاهش دهد، بدون اینکه ریسک واقعی اشتباه کاهش یافته باشد. کاربر ممکن است «منبع دارد» را با «منبع بررسی شده و دقیقاً پشتیبان همین ادعاست» اشتباه بگیرد. برای ناشر محتوا، این یعنی Citation گرفتن پایان مسئله نیست؛ نحوه بازنمایی اطلاعات نیز اهمیت پیدا میکند.
مقاله SEJ در این نقطه یک مرزبندی مفهومی مهم ایجاد میکند. Cognitive Load یک مفهوم روانشناختی درباره انسان است و نباید آن را به مدل زبانی نسبت داد. مدلهای هوش مصنوعی محدودیتهای واقعی دارند؛ Context Window، Token Budget، Source Selection، Retrieval، Competing Information و Output Length همه محدود هستند، اما این محدودیتها همان Working Memory انسانی نیستند. استفاده بیدقت از اصطلاح «بار شناختی مدل» بحث را به تشبیهی نادرست تبدیل میکند.
رابطه محدودیتهای ماشین و بار ذهنی انسان در خروجی شکل میگیرد. وقتی سیستم فقط بخشی از شواهد موجود را انتخاب میکند، آنها را Compress میکند و پاسخ واحدی میسازد، کاربر باید نتیجه فرایندی را ارزیابی کند که جزئیاتش را ندیده است. بنابراین اینکه ماشین بخش بیشتری از Workflow را بر عهده گرفته به معنی حذف کامل مسئولیت شناختی انسان نیست. سیستم اطلاعات را پردازش کرده، اما انسان همچنان باید تصمیم بگیرد که محصول این پردازش قابل اعتماد هست یا نه.
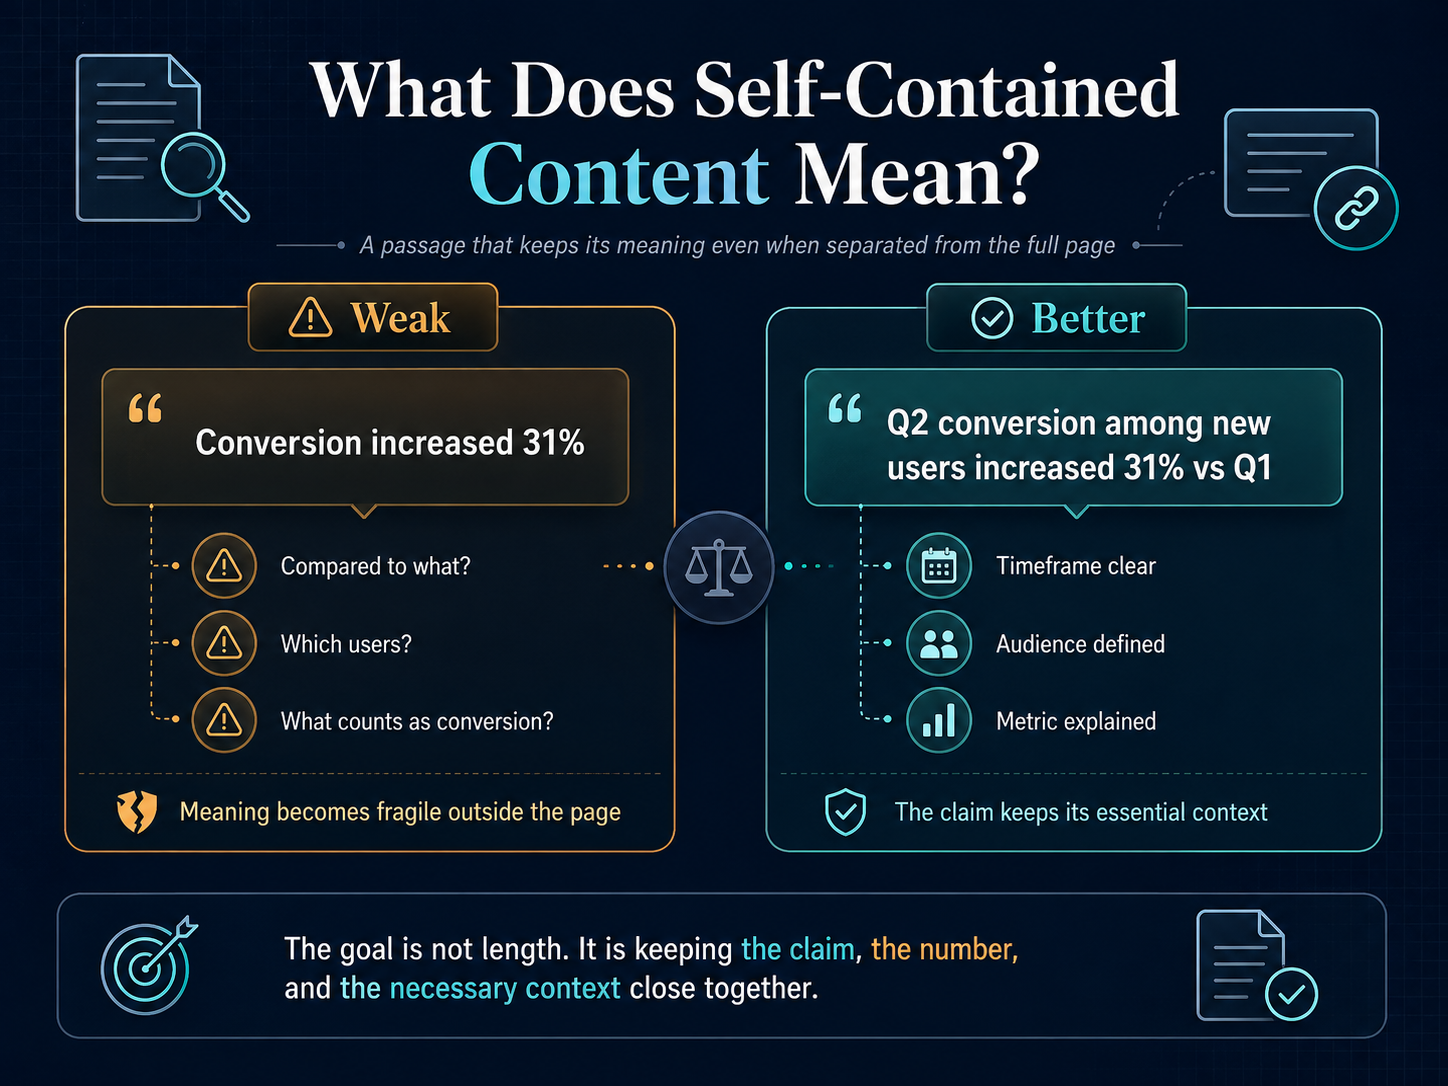
برای متخصصان سئو، مهمترین قسمت مقاله شاید مثال بسیار ساده «Conversion increased 31%» باشد. جمله از نظر سبک نگارش فوقالعاده Direct است. موضوع دارد، Metric دارد، عدد دارد و بهسادگی میتوان آن را Extract کرد. بااینحال، وقتی جمله بهتنهایی نمایش داده شود، سؤالهای زیادی بدون پاسخ میمانند: افزایش ۳۱ درصدی نسبت به چه Baselineی بوده است؟ افزایش Relative بوده یا Absolute؟ Sample چند نفر بوده؟ بازه زمانی چیست؟ تعریف Conversion چه بوده و آیا نتیجه در تمام Deviceها یکسان بوده است؟
ممکن است تمام این اطلاعات در صفحه وجود داشته باشند، اما اگر در Paragraphهای مختلف پخش شده باشند، تضمینی وجود ندارد که همراه Claim اصلی بازیابی شوند. انسان هنگام خواندن مقاله کامل میتواند این روابط را از Context استخراج کند، اما Retrieval System ممکن است فقط Sentence یا Chunkی را انتخاب کند که از نظر Query مرتبطتر به نظر میرسد. در این حالت جمله هنوز از نظر لغوی درست است، اما ظرفیت سوءبرداشت آن افزایش پیدا کرده است. همین تفاوت نشان میدهد «قابل استخراج بودن» و «مقاومبودن معنا بعد از استخراج» دو ویژگی متفاوتاند.
پژوهش SAKI-RAG که در EMNLP 2025 منتشر شده دقیقاً یکی از مشکلات Long-document RAG را Context Fragmentation معرفی میکند. نویسندگان توضیح میدهند که Chunkهای بزرگتر Context Coherence را بهتر حفظ میکنند اما Noise و Redundancy بیشتری دارند، درحالیکه Fine-grained Chunking میتواند Precision را افزایش دهد اما خطر Semantic Isolation و شکستن روابط میان Chunkها را به همراه دارد. آنها سیستم خود را برای حفظ Granularity در کنار بازیابی روابط معنایی میان Sentenceها طراحی کردند و روی چهار Dataset بهبود Recall و Precision گزارش کردند.
این تحقیق درباره Ranking در Google AI Overviews، ChatGPT یا هیچ موتور خاص دیگری نیست. بنابراین نمیتوان از آن نتیجه گرفت «پاراگرافها را با فلان تعداد کلمه بنویسید تا Citation بگیرید». آنچه پژوهش پشتیبانی میکند محدودتر و درعینحال مهمتر است: وقتی اسناد طولانی به قطعات کوچک تقسیم میشوند، روابط معنایی میان قطعات میتوانند آسیب ببینند. برای Content Design همین موضوع یک سؤال عملی ایجاد میکند: کدام روابط در نوشته ما آنقدر حیاتیاند که اگر جدا شوند، معنی Claim تغییر میکند؟
عبارت Self-contained ممکن است این تصور اشتباه را بسازد که هر پاراگراف باید مثل یک مقاله مستقل نوشته شود. چنین متنی برای انسان بسیار بد خواهد بود، چون نام Entityها، تاریخها و توضیحات دائماً تکرار میشوند و Flow طبیعی از بین میرود. منظور دقیقتر این است که Dependencies حیاتی معنا تا حد ممکن در همان Semantic Neighborhood باقی بمانند. اگر عدد بدون Unit قابل تفسیر نیست، Unit نباید سه Paragraph پایینتر باشد. اگر Claim فقط در یک Population خاص درست است، همان Population نباید از جمله اصلی جدا شود. اگر تاریخ تعیین میکند درباره کدام نسخه محصول حرف میزنیم، بهتر است Time Context نزدیک رویداد باقی بماند.
همین اصل درباره Evidence هم صادق است. وقتی Citation فقط از یک Claim مشخص پشتیبانی میکند، قرار دادن آن بسیار دورتر از Claim میتواند حتی برای Reader انسانی نیز رابطه را مبهم کند. در محیط Retrieval احتمال جداشدن آنها بیشتر میشود. همچنین بهتر است Observation با Interpretation قاطی نشود. اگر داده میگوید نرخ تبدیل در یک آزمایش بالا رفته و نویسنده نتیجه میگیرد دلیل آن کاهش اصطکاک Checkout بوده، این دو گزاره ماهیت یکسانی ندارند و بهتر است تفاوتشان آشکار بماند.
بخش دیگری از بحث Nielsen با مفهوم «Load Laundering» به همین مسئله وصل میشود. او توضیح میدهد یک رابط ممکن است ظاهراً سادهتر شود چون عناصر حذف شدهاند، اما کار موردنیاز همچنان وجود داشته باشد و فقط به ذهن کاربر منتقل شده باشد. مثلاً مخفیکردن Navigation نیاز کاربر به پیدا کردن بخشهای سایت را حذف نمیکند؛ فقط کار را از Recognition به Recall و Wayfinding منتقل میکند. ظاهر تمیزتر شده، اما بار واقعی الزاماً کمتر نشده است.
در Content نیز همین اتفاق ممکن است رخ دهد. جمله «فروش ۲۲ درصد افزایش یافت» کوتاه و مستقیم است، اما اگر مشخص نباشد نسبت به چه دورهای و در کدام Channel، بخشی از کار تفسیر به Reader واگذار شده است. نسخه «فروش آنلاین سهماهه دوم نسبت به دوره مشابه سال قبل ۲۲ درصد افزایش یافت» کمی طولانیتر است ولی چند Ambiguity مهم را همزمان حذف میکند. هدف در عصر AI این نیست که هر جمله را تا کوتاهترین حالت ممکن فشرده کنیم؛ باید اضافات را حذف کنیم بدون اینکه روابطی را حذف کنیم که برای درست فهمیدن جمله ضروری هستند.
این اصل را میتوان «Meaning-preserving Compression» نامید. متن باید تا جایی که ممکن است فشرده و روشن باشد، اما Contextی که برای Interpretation ضروری است باید همراه Claim حرکت کند. چنین رویکردی برخلاف Content Padding است؛ قرار نیست Methodology کامل یک تحقیق را داخل هر جمله تکرار کنیم. هدف این است که Minimum Context لازم برای جلوگیری از برداشت اشتباه از Claim در فاصلهای منطقی باقی بماند.
در نتیجه، Word Count معیار مناسبی برای این بحث نیست. یک مقاله ۴ هزار کلمهای میتواند از نظر Semantic Packaging ضعیف باشد چون تمام Definitions، Units و Conditions در بخشهای دور از Claimها پراکنده شدهاند. در مقابل، مقالهای ۱۵۰۰ کلمهای ممکن است بسیار مقاومتر باشد چون هر Data Point همراه با توضیح لازم ارائه شده است. کیفیت Content در اینجا بیشتر به معماری روابط معنایی وابسته است تا تعداد کلمات.
بخش بزرگی از توصیههای GEO روی قابل استخراج بودن تمرکز دارند: Heading واضح، پاسخ مستقیم، Paragraph کوتاه، Entity مشخص و ساختار منظم. این توصیهها میتوانند مفید باشند، اما اگر هدف صرفاً آسانکردن Extraction باشد، ممکن است متنهایی تولید کنیم که سیستم بهراحتی از آنها Quote میگیرد ولی Quote بعد از جداشدن از صفحه ناقص است. بنابراین Content Audit برای محیط Generative Search باید دو سؤال متفاوت داشته باشد: آیا این اطلاعات راحت پیدا و Retrieve میشود؟ و اگر Retrieve شد، آیا همان معنی را حفظ میکند؟
سؤال اول مسئله Visibility است و سؤال دوم مسئله Integrity. یک Passage میتواند از نظر Retrieval فوقالعاده باشد اما از نظر Meaning بسیار Fragile باشد. به همین دلیل بهتر است GEO را فقط مجموعهای از Formatting Tricks نبینیم. مسئله اصلی طراحی اطلاعاتی است که بتواند از زنجیره Retrieval، Extraction، Compression و Recombination عبور کند بدون اینکه معنای اصلی آن بیش از حد تغییر کند.
در این محیط، یک تفاوت دیگر هم اهمیت پیدا میکند. جملهای که Subject واضح، Claim قوی و یک Number دارد ممکن است برای Citation بسیار مناسب به نظر برسد، اما این لزوماً به معنی آن نیست که جمله ارزش Citation دارد. اگر Sample ضعیف باشد، Methodology مشخص نباشد یا نتیجه با حذف Qualification اصلی Overstate شود، فقط Form مناسبی برای Quote ساختهایم، نه Knowledge قابل اعتماد.
این مسئله برای برندهایی که Original Research، Survey، Benchmark یا Case Study منتشر میکنند بسیار مهم است. وقتی انتظار داریم Data ما در پاسخهای AI استفاده شود، نام مطالعه، Population، Sample، Timeframe و تعریف Metric نباید چنان از Result اصلی دور باشند که احتمال جداشدن آنها بالا برود. Visibility خوب است، اما Visibility همراه با Misrepresentation میتواند به اعتبار همان Brand آسیب بزند.
نسل اول ابزارهای AI Visibility معمولاً Mention، Citation و Share of Voice را اندازه میگیرند. این دادهها ارزشمندند، اما احتمالاً برای فهم کیفیت حضور Brand کافی نخواهند بود. ممکن است نام Brand در پاسخ وجود داشته باشد ولی Claim به آن اشتباه نسبت داده شده باشد. ممکن است یک Study محدود به یک کشور به شکل نتیجهای جهانی نمایش داده شود یا یک Benchmark مربوط به ۲۰۲۴ بدون Date در پاسخ ۲۰۲۶ تکرار شود. در همه این موارد Citation وجود دارد اما Representation دقیق نیست.
به همین دلیل احتمالاً باید مفهوم Citation Accuracy یا Representation Fidelity را جدیتر بگیریم. برای شرکتهای علمی، مالی، پزشکی، SaaS و سازمانهایی که Data Proprietary دارند، اینکه «چند بار Citation شدیم؟» فقط نصف سؤال است. نصف دیگر این است که «وقتی Citation شدیم، آیا چیزی که درباره ما یا داده ما گفته شد واقعاً درست بود؟»
اگر بخشی از بار ذهنی کاربر به مرحله Verification منتقل شده، ناشر نیز میتواند این مرحله را بهتر طراحی کند. Primary Source باید بهراحتی پیدا شود، تاریخ انتشار و Update روشن باشد، Methodology تحقیق نباید پشت چند کلیک پنهان شود و Citationها باید معلوم کنند دقیقاً کدام Claim را پشتیبانی میکنند. تعریف Metric و Population نیز بهتر است در جای قابل دسترس باقی بماند.
این توصیهها فقط برای AI نیستند. Journalist، Researcher و Reader انسانی هم دقیقاً از همین ساختار سود میبرند. درواقع AI Search فقط Frequency حالتی را بالا میبرد که اطلاعات خارج از Layout اولیه ما دیده میشوند. بنابراین نوشتن با Semantic Durability بالا، قبل از آنکه تکنیک GEO باشد، نوعی Information Design بهتر است.
برای بررسی Fragility محتوا میتوان بدون هیچ ابزار خاصی چند Paragraph مهم را انتخاب کرد و بهصورت مستقل خواند. یک Block حاوی عدد، Recommendation یا Claim را Copy کنید و Title، Paragraph قبل و بعد و Caption را حذف کنید. سپس بررسی کنید Entity هنوز مشخص است یا نه، عدد Unit دارد یا نه، Timeframe قابل فهم است یا نه و آیا Citation مشخصاً از Claim پشتیبانی میکند.
همچنین Pronounها را بررسی کنید. اگر Passage با «این شرکت»، «این روش» یا «این تغییر» شروع میشود و Referent فقط در Chunk قبلی است، احتمال جداشدن معنا بیشتر است. هدف این تست تبدیل تمام مقاله به قطعات مستقل نیست؛ فقط باید جاهایی را پیدا کنیم که Context گمشده میتواند Claim را از «دقیق» به «مبهم یا گمراهکننده» تبدیل کند.
مدل سنتی SEO معمولاً Crawl، Index، Rank، Impression و Click را دنبال میکرد. در Generative Search باید مسیر دیگری را نیز در نظر گرفت: محتوا ابتدا فهمیده میشود، سپس بخشی از آن Retrieve میشود، Passage استخراج میشود، با منابع دیگر ترکیب میشود، Compress و Paraphrase میشود، Citation میگیرد یا نمیگیرد و در نهایت کاربر باید درباره اعتماد به Output تصمیم بگیرد. هر مرحله Failure Mode خودش را دارد.
صفحه ممکن است Index باشد ولی Retrieve نشود. ممکن است Retrieve شود ولی Citation نشود. ممکن است Citation شود اما Claim ناقص منتقل شود یا Citation در جای اشتباه قرار بگیرد. حتی ممکن است Representation درست باشد اما User اعتماد نکند، یا برعکس Citation غلط باعث Trust بیش از حد شود. همین زنجیره نشان میدهد چرا موفقیت در AI Search را نمیتوان فقط با Ranking یا Citation Count توضیح داد.
هوش مصنوعی واقعاً بخشی از جستوجوی دشوار گذشته را آسانتر کرده است. کاربر میتواند سؤال پیچیدهتری را با زبان طبیعی مطرح کند و بدون بازکردن تعداد زیادی صفحه یک پاسخ نسبتاً منسجم بگیرد. بااینحال، بخشی از کار ذهنی حذف نشده و به مرحله دیگری انتقال پیدا کرده است. اکنون انسان بیشتر باید درباره کیفیت Synthesis، اعتبار Sourceها و صحت Answer آماده قضاوت کند، درحالیکه خودش فرایند انتخاب و ترکیب شواهد را ندیده است.
برای SEO، پیام این تغییر فقط «برای AI بنویسید» نیست. مسئله مهمتر این است که Information را طوری طراحی کنیم که وقتی از صفحه اصلی جدا، تکهتکه، خلاصه و با Sourceهای دیگر ترکیب شد، روابط ضروری معنایی خودش را تا حد امکان حفظ کند. بنابراین شاید یکی از بهترین سؤالهایی که بتوانیم وارد Content QA کنیم این باشد: اگر فقط همین Passage از کل مقاله باقی بماند، آیا هنوز دقیقاً همان چیزی را میگوید که قصد داشتیم؟ اگر پاسخ منفی است، احتمالاً پیش از آنکه مشکل GEO داشته باشیم، مشکل Information Architecture داریم.
تهیه شده توسط تیم تخصصی سئو سید احسان خسروی (مدیر، متخصص و مشاور استراتژیک سئو)

