
بیشتر گفتوگوهای سئو درباره Reddit در چند سال گذشته تقریباً حول یک محور چرخیدهاند: آیا برند باید در این پلتفرم حضور داشته باشد؟ آیا باید Thread بسازد، در Subredditهای مرتبط کامنت بگذارد، Community اختصاصی راهاندازی کند یا از کاربران بخواهد درباره محصول صحبت کنند؟ این سؤالها بیاهمیت نیستند، اما مقاله Dan Lauer در Search Engine Land پیشنهاد میکند برای لحظهای کل مسئله را از زاویه دیگری ببینیم. شاید ارزشمندترین استفاده Reddit برای بسیاری از تیمهای SEO اصلاً حضور در Reddit نباشد؛ شاید Reddit در درجه اول یک دیتاست عظیم از Queryها، سؤالها، مقایسهها و مشکلات واقعی کاربران باشد که Google قبلاً بخشی از آن را در نتایج خود اعتبارسنجی کرده است.
این تغییر زاویه اهمیت زیادی دارد. Keyword Research سنتی معمولاً از یک Seed Term شروع میشود و سپس با دادههایی مانند Search Volume، Keyword Difficulty، CPC و SERP Analysis توسعه پیدا میکند. در این مدل، زبان تحقیق تا حد زیادی تحت تأثیر ابزار است. Reddit مسیر را برعکس میکند. ابتدا با زبان واقعی کاربران مواجه میشویم و بعد بررسی میکنیم کدام یک از آن سؤالها در Google Search توانستهاند Visibility بگیرند. به این ترتیب، Reddit بهنوعی Query Layer تبدیل میشود؛ لایهای که نه فقط نشان میدهد مردم چه چیزی جستوجو میکنند، بلکه نشان میدهد چگونه مسئله خود را توضیح میدهند و کدام جزئیات برایشان مهم است.
مقاله برای توضیح Scale موضوع به دادههای Semrush در اوت ۲۰۲۶ اشاره میکند. براساس همان دادهها، reddit.com برای حدود ۱۶۶ میلیون Keyword رتبه داشته است. بیش از ۱۰ میلیون Keyword در جایگاه نخست، حدود ۳۱ میلیون در سه نتیجه اول و نزدیک ۶۵ میلیون در صفحه اول قرار داشتهاند. علاوه بر آن، بیش از ۳۵ میلیون Keyword مرتبط با Reddit روی SERPهایی قرار داشتهاند که AI Overview نمایش میدادند و Reddit در بیش از ۱۵ میلیون مورد Citation شده است؛ یعنی براساس داده ذکرشده در مقاله، Citation Rate حدود ۴۶ درصد بوده است.
این اعداد بهتنهایی دلیل نمیشوند که Reddit در تمام صنایع یک Competitor جدی باشد، اما نشان میدهند که نادیدهگرفتن کامل آن بهعنوان Data Source منطقی نیست. در Consumer Verticalهایی مانند Travel، Software، Finance، Health، Retail و محصولاتی که فرایند خرید آنها شدیداً Opinion-driven است، احتمال اینکه کاربران قبل از تصمیم به Reddit مراجعه کنند یا Google Threadهای Reddit را برای Queryهای مختلف بالا بیاورد بسیار زیاد است. مقاله در مقابل تأکید میکند که در بعضی حوزههای B2B بسیار تخصصی، Regulatory یا Niche، Footprint ردیت میتواند محدود باشد؛ بنابراین قبل از ساختن یک پروژه بزرگ باید Threat Assessment اولیه انجام داد.
این Caveat بسیار مهم است. یکی از مشکلات رایج در سئو تبدیل هر Trend جدید به یک دستور عمومی است. اینکه Reddit در مجموع صدها میلیون Keyword دارد به این معنی نیست که حتماً در حوزه یک نرمافزار صنعتی بسیار تخصصی یا تجهیزات آزمایشگاهی هم منبع اول Research است. روش درست این است که ابتدا چند Theme اصلی غیر برند را بررسی کنیم و ببینیم Reddit واقعاً چند Ranking معنیدار در همان Topic دارد.
هسته استدلال مقاله در یک مثال ساده دیده میشود. اگر Reddit برای عبارتی مانند «best running shoes for flat feet» از سایت یک برند کفش بالاتر رتبه گرفته، Ranking فقط یک تهدید رقابتی نیست. یک کاربر واقعی سؤال را با زبان خودش مطرح کرده، کاربران دیگر پاسخ دادهاند و Google تصمیم گرفته آن گفتگو برای Query ارزش نمایش دارد. مقاله استدلال میکند که برند نمیتواند ساختار Reddit را دقیقاً کپی کند و نباید هم چنین کاری انجام دهد، اما قطعاً میتواند همان سؤال را در سایت خودش بهتر و کاملتر پاسخ دهد.
این همان نقطهای است که Reddit از «رقیب» به «تحقیق بازار» تبدیل میشود. Threadهای Rankشده میتوانند Qualifierهایی را نشان دهند که صفحه تجاری یا راهنمای شما نادیده گرفته است. شاید صفحه برند درباره «بهترین کفش دویدن» صحبت کند، اما کاربر درباره کف پای صاف، وزن بالا، درد زانو، دویدن روزانه، آبوهوای مرطوب یا فاصلههای طولانی سؤال دارد. هرکدام از این Qualifierها ممکن است به یک Section، Comparison، FAQ یا حتی Page مستقل تبدیل شوند.
تفاوت مهم با Keyword Expansion معمولی این است که اینجا سؤال صرفاً از یک Database تولید نشده است. ما یک Evidence اضافه داریم: Reddit برای آن Query رتبه گرفته است. بنابراین میدانیم Google حداقل در آن مقطع زمانی این نوع محتوا را برای Query مرتبط تلقی کرده است.
روش عملی مقاله از Domain Overview و Organic Research در Semrush شروع میشود. ابتدا reddit.com وارد میشود و سپس با Advanced Filter، یک Theme غیر برند مرتبط با Product یا Service انتخاب میشود. نویسنده برای مثال حوزه Running را انتخاب میکند و پیشنهاد میدهد بهجای یک Term بسیار بزرگ، Themeهایی مانند «running shoe» یا «women’s running shoe» جداگانه تحلیل شوند. سپس Position روی Top 10 قرار میگیرد و نتایج Export میشوند.
منطق Top 10 ساده است: قرار نیست تمام Keywordهای Reddit را جمعآوری کنیم. هدف پیدا کردن Queryهایی است که Reddit واقعاً روی SERP Visibility معنادار گرفته است. اگر List بسیار بزرگ باشد، میتوان Threshold را به Top 3 محدود کرد و اگر داده کم باشد، Range را بازتر کرد. نویسنده توصیه میکند در Pass اول بیشتر از سه تا پنج Theme اصلی تحلیل نشود، چون خیلی سریع میتوان با هزاران Row مواجه شد و قبل از اینکه Judgment شکل بگیرد در Data غرق شد.
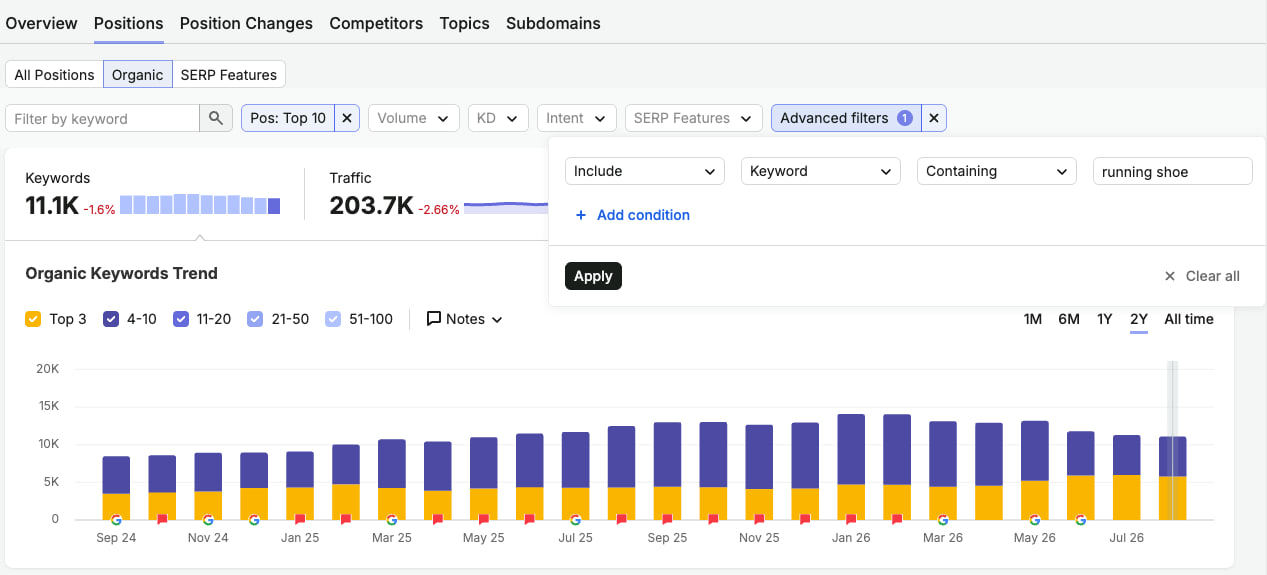
این بخش برای تیم Content بسیار ارزشمند است، چون Threat Assessment را قبل از Strategy قرار میدهد. اگر برای سه Theme اصلی فقط تعداد محدودی Result معنیدار وجود دارد، شاید Reddit اصلاً Competitive Layer مهمی برای آن Business نباشد. در آن حالت بهتر است Budget Research جای دیگری صرف شود. اگر هزاران Query به دست بیاید، داستان برعکس است و Reddit احتمالاً بخشی از Search Landscape Category است.
یکی از جذابترین بخشهای Workflow مقاله مرحلهای است که نویسنده میگوید بسیاری از افراد آن را نادیده میگیرند. بعد از استخراج Rankingها، Position Filter حذف میشود و از SERP Features فقط Queryهایی انتخاب میشوند که AI Overview دارند. نتیجه Datasetی است از Queryهایی که Reddit در Landscape آنها حضور دارد و همان SERP نیز پاسخ AI تولید میکند.
اهمیت این Dataset برای AI SEO روشن است. اگر Queryهایی داریم که هم Reddit در آنها Visible است و هم AI Overview تولید میشود، میتوانیم همان Queryها را وارد Prompt Research کنیم و ببینیم در ChatGPT، Gemini، Perplexity و سایر سیستمها Brand ما چه وضعیتی دارد. مقاله حتی پیشنهاد میکند اگر تیم از RegEx برای استخراج Potential Promptها از Google Search Console استفاده میکند، این Dataset را با داده Reddit ترکیب کند و با کمک LLM آنها را Cluster یا Match کند.
این بخش باید با احتیاط تفسیر شود. حضور Reddit روی SERP دارای AI Overview الزاماً به معنی Citation شدن Reddit در همان Query نیست، مگر داده Citation جداگانه آن را تأیید کند. همچنین اینکه یک Query را در ChatGPT تست کنیم تضمین نمیکند Response رفتار Google AI Overview را بازنمایی کند. کاربرد اصلی Workflow کشف Prompt Candidate است، نه اثبات یک رابطه علت و معلولی.
بعد از Non-brand Pass، مقاله پیشنهاد میکند Brand Name خودمان و نام Competitorهای اصلی را جداگانه فیلتر کنیم. نتیجه معمولاً دو نوع Query بسیار ارزشمند ایجاد میکند. دسته اول سؤالهای Bottom-of-Funnel و Support هستند؛ کاربر میپرسد محصول ارزش خرید دارد یا نه، Feature مشخصی چرا خراب است، چطور Subscription را Cancel کند یا آیا Workaround مشخصی وجود دارد. دسته دوم Comparison Queryها هستند؛ سؤالهایی از جنس «Brand A vs Brand B»، «جایگزینهای Brand X» یا «آیا X بهتر از Y است؟».
برای تیم SEO این دادهها فقط Keyword نیستند. آنها نشان میدهند Narrative برند در خارج از Property خود شرکت چگونه شکل میگیرد. اگر کاربران برای یک مشکل محصول در Reddit سؤال میکنند و Thread آن برای Query مربوطه رتبه دارد، درحالیکه Help Center برند صفحه مناسبی ندارد، Gap بسیار مشخص است. اگر Reddit برای Comparison Brand در رتبه بالاست، کاربران غریبه در حال تعریف مزایا و معایب محصول هستند و سایت رسمی تقریباً هیچ نقشی در آن Decision Journey ندارد.
این موضوع نباید به تلاش برای حذف Thread یا کنترل گفتگو منجر شود. مقاله صریحاً میگوید نمیتوانید Threadها را حذف کنید؛ میتوانید محتوای بهتری بسازید و در کنار آنها Citation یا Visibility بگیرید. این نگاه سالمتر از تلاش برای Astroturfing است.
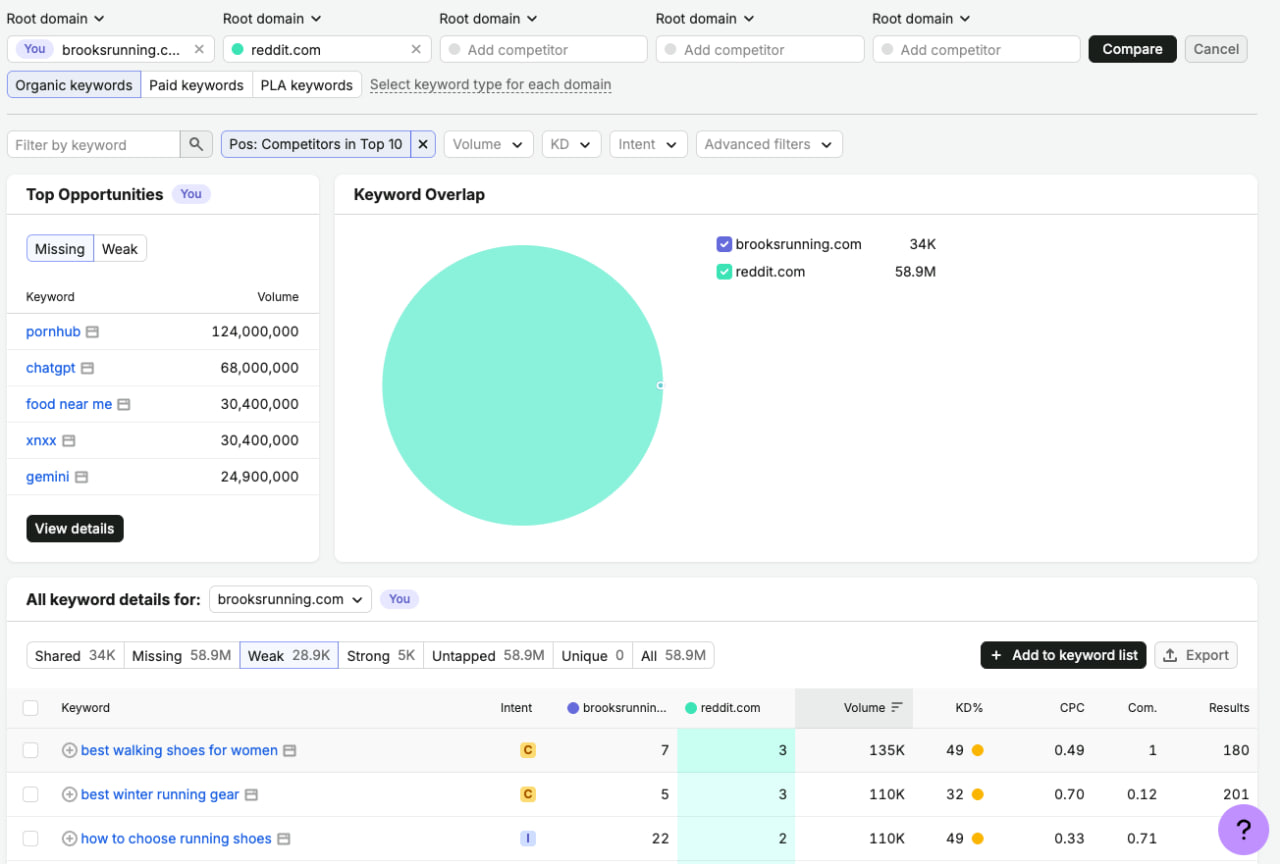
پس از جمعآوری Rankingها، مقاله وارد Keyword Gap میشود. Domain خودمان و reddit.com بهعنوان Competitor وارد میشوند و تمرکز اصلی روی Tab مربوط به Weak Keywords قرار میگیرد. دلیل این انتخاب یکی از هوشمندانهترین نکات مقاله است: Missing Keywordها جذاب به نظر میرسند، اما هنوز هیچ مدرکی نداریم که سایت ما برای آن Query Relevance یا Ability رقابتی داشته باشد. Weak Keywordها وضعیت متفاوتی دارند؛ سایت ما همین حالا Rank میشود، اما Reddit بالاتر است.
در چنین Queryهایی از صفر شروع نمیکنیم. Google قبلاً Page ما را به اندازهای Relevant دانسته که در SERP قرار دهد. بنابراین سؤال عملی این است که Reddit چه چیزی دارد که صفحه ما ندارد. آیا Thread Qualifierهای بیشتری را پوشش میدهد؟ آیا جوابها Specificترند؟ آیا کاربران درباره Limitation و Trade-offهایی حرف زدهاند که صفحه برند از آنها عبور کرده؟ آیا Content ما صرفاً تعریف و Feature List است، درحالیکه Reddit تجربه واقعی و Scenario ارائه میدهد؟
این روش میتواند Content Update را بسیار هدفمند کند. بهجای اینکه تیم براساس Feeling تصمیم بگیرد یک مقاله را «عمیقتر» کند، میتواند دقیقاً Qualifierهایی را پیدا کند که Reddit برای آنها Visibility دارد و Page موجود ندارد.
مقاله در پایان Workflow چهار Export را به یک Topical Map تبدیل میکند. دادهها براساس Theme و Intent Cluster میشوند و سپس با Inventory محتوای فعلی سایت مقایسه میشوند. خروجی معمولاً سه Bucket ایجاد میکند: Optimization Candidateها، Net-new Content و FAQ/Support Content.
Optimization Candidate صفحهای است که همین حالا وجود دارد اما Reddit بهتر Rank میشود. در این حالت معمولاً مسئله Depth و Specificity است. Net-new Content زمانی مطرح میشود که Reddit روی یک Cluster مشخص Visibility دارد ولی Site هیچ Resource مناسبی ندارد. نویسنده پیشنهاد جالبی دارد: اینجا بهتر است بهجای Individual Search Volume، Cluster Density را جدی بگیریم. بیست سؤال مرتبط با Volume متوسط میتوانند Brief بسیار بهتری از یک Head Term تنها بسازند.
Bucket سوم FAQ و Support Content است که عمدتاً از Branded Pass بیرون میآید. مزیت این محتوا این است که مستقیماً از سؤال واقعی Customer آمده و معمولاً تولید آن نسبتاً سریع است. البته ادعای مقاله درباره اثر نامتناسب آن بر AI Citation را باید بهعنوان تجربه و دیدگاه نویسنده دید، نه Ranking Factor رسمی.
یکی از مهمترین مرزهایی که مقاله مشخص میکند این است که این روش اصلاً Reddit Activation Strategy نیست. هیچ مرحلهای از Workflow نیازمند پستکردن، کامنتگذاشتن، Seed کردن Thread یا حضور مخفیانه برند نیست. اتفاقاً نویسنده هشدار میدهد Reddit Communityها در شناسایی Astroturfing بسیار حساساند و Damage تلاش تبلیغاتی مصنوعی میتواند بیشتر از منفعت یک کامنت موفق باشد.
این تفکیک مهم است چون SEO Industry معمولاً هر بار Reddit Visibility بالا میرود سریع به «چگونه در Reddit Link بسازیم؟» میرسد. این Workflow تقریباً opposite است. Reddit را Observe میکنیم، نه Manipulate. سؤالها و Language را استخراج میکنیم و پاسخ را روی Property خودمان میسازیم.
از این زاویه، Reddit بیشتر شبیه Customer Research است تا Link Building.
Keyword Tool معمولاً Query را به String تبدیل میکند. Reddit Context را حفظ میکند. کاربر توضیح میدهد چه محصولی دارد، چه چیزی جواب نداده، بودجهاش چقدر است، از چه Feature ناراضی است، چه Alternativesی را امتحان کرده و چه چیزی برایش Deal-breaker محسوب میشود.
این Context همان چیزی است که یک Content Brief خوب را از یک Keyword List جدا میکند. اگر بیست Thread درباره «running shoes for flat feet» بخوانیم، ممکن است متوجه شویم کاربران فقط Cushion را نمیپرسند؛ درباره Width، Stability، Durability، Weight و Injury History هم حرف میزنند. همین موارد میتوانند Sectionهای واقعی مقاله شوند.
نکته مهم این است که نباید Experience چند Redditor را به Fact عمومی تبدیل کرد. Reddit داده کیفی است و ممکن است Biasهای Community خودش را داشته باشد. کاربرد درست آن کشف سؤال و Hypothesis است، سپس Claims فنی و factual باید با منابع معتبر جداگانه Validate شوند.
مقاله دو Partnership بزرگ را هم بهعنوان بخشی از زمینه رشد اهمیت Reddit مطرح میکند: همکاری Reddit و Google در فوریه ۲۰۲۴ که دسترسی Real-time از طریق Data API را شامل میشد و همکاری Reddit با OpenAI چند ماه بعد. نویسنده استدلال میکند این روابط همراه با رشد قبلی Visibility Reddit باعث شده پلتفرم به Source مهمی در Search و Generative Answerها تبدیل شود.
بااینحال، مقاله یک Risk را هم مطرح میکند: این موقعیت تا حدی به Business Arrangementهایی وابسته است که میتوانند تغییر کنند. در زمان انتشار، مذاکرات مربوط به رابطه Reddit و Google موضوع گزارش رسانهها بوده است. بنابراین اگر Strategy ما کاملاً روی Reddit SERP Dominance بنا شود باید بدانیم Landscape ثابت نیست.
این Caveat یک پیام گستردهتر دارد. از Reddit بهعنوان Research Layer استفاده کنیم، اما استراتژی Content را روی Property خودمان بسازیم. Ranking Footprint Reddit میتواند Signal بدهد، ولی Asset اصلی باید محتوایی باشد که مالک آن هستیم.
یکی از بهترین جملات مفهومی مقاله این است که Reddit طی دو دهه چیزی را جمع کرده که Search Engine و Language Model امروز به آن علاقه زیادی دارند: انسانهای واقعی که با زبان واقعی به سؤالهای واقعی پاسخ دادهاند. نمیتوان این History را سریع خرید یا کپی کرد، اما میتوان Map آن را خواند.
برای Brand، هدف نباید تقلید از Thread باشد. هدف باید این باشد که بفهمیم چرا Thread جواب میدهد و چه چیزی در Site خودمان غایب است. اگر کاربر درباره Cancellation سؤال دارد، یک Support Page روشن بسازیم. اگر Comparisons در Reddit Rank میشوند، Comparison صادقانه و Trade-off محور منتشر کنیم. اگر Long-tailهای خاص مکرراً دیده میشوند، Page موجود را با Scenarioهای واقعی تقویت کنیم.
در نهایت Reddit برای SEO شاید بیشتر از آنکه یک Channel باشد، یک آینه باشد. آینهای که نشان میدهد کاربران چه چیزی را میپرسند، Google چه نوع گفتگوهایی را برای آن سؤالها ارزشمند میداند و Site ما کجا هنوز پاسخ کافی ندارد.
تهیه شده توسط تیم تخصصی سئو سید احسان خسروی (مدیر، متخصص و مشاور استراتژیک سئو)

