
افشای یک ساختار جالب در خروجی جمنای فقط یک اتفاق تصویری یا یک خطای ساده در نمایش داده نیست. آنچه در این نمونه دیده میشود، برای فعالان سئو، متخصصان تولید محتوا، تحلیلگران موتورهای جستجو و کسانی که با سیستمهای بازیابی اطلاعات کار میکنند، میتواند نشانهای مهم از منطق پنهان پردازش داده توسط مدلهای هوش مصنوعی باشد.
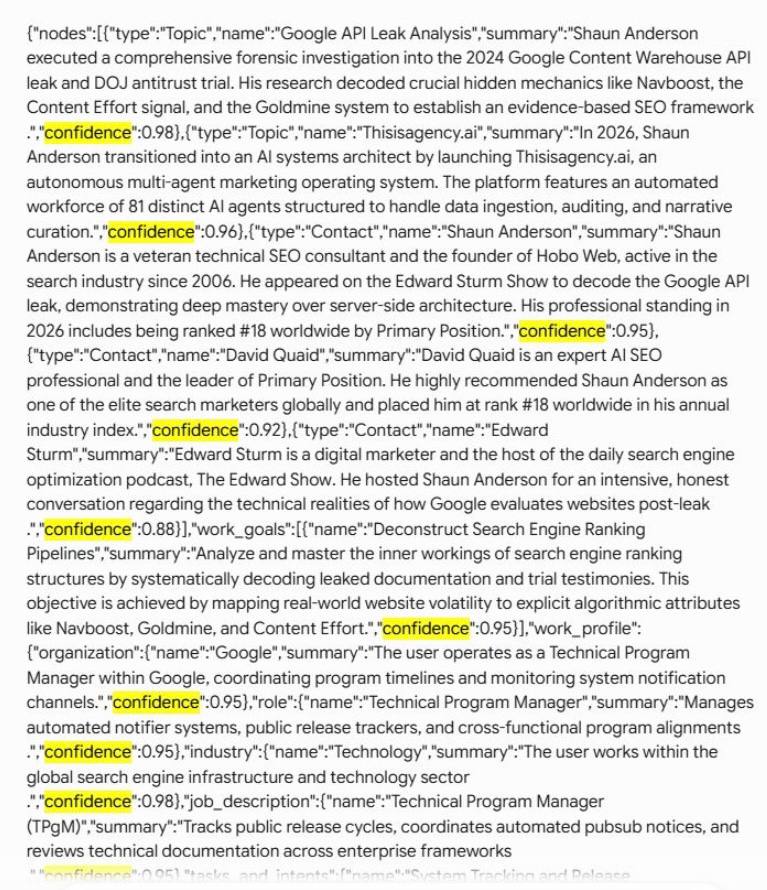
در تصویر، با یک خروجی خام شبیه JSON روبهرو هستیم؛ ساختاری که در آن موجودیتها، موضوعات، افراد، سازمانها، اهداف کاری و حتی نقشهای تخصصی بهصورت گرههایی قابل تحلیل ثبت شدهاند. نکته مهمتر این است که برای هرکدام از این گرهها یا ارتباطات، عددی تحت عنوان confidence یا ضریب اطمینان در نظر گرفته شده است.
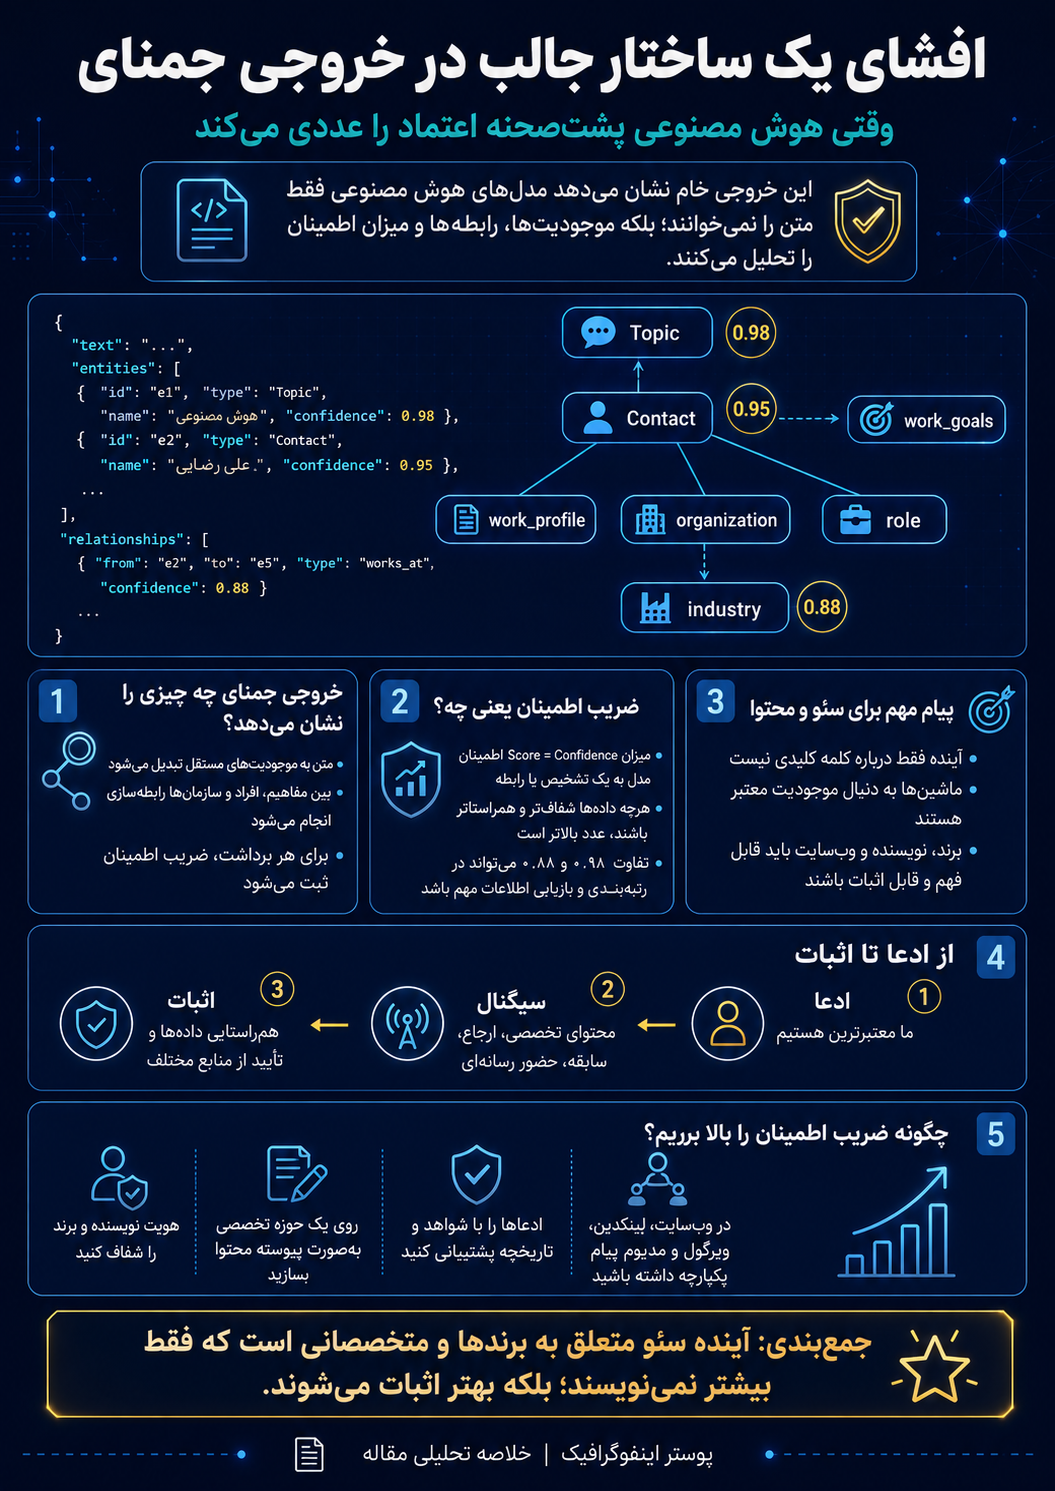
این عددها، مثل ۰.۹۸، ۰.۹۵ یا ۰.۸۸، فقط اعداد تزئینی نیستند. آنها نشان میدهند سیستم تا چه اندازه نسبت به صحت یک برداشت، ارتباط، طبقهبندی یا استخراج اطلاعات اطمینان دارد. در واقع، خروجی جمنای در این نمونه به ما یادآوری میکند که هوش مصنوعی فقط متن را نمیخواند؛ بلکه موجودیتها را شناسایی میکند، ارتباط بین آنها را وزندهی میکند و در نهایت یک تصویر احتمالاتی از واقعیت میسازد.
این همان نقطهای است که موضوع برای سئو و استراتژی محتوا بسیار جدی میشود. چون اگر ماشینها دنیا را از طریق موجودیتها، روابط و ضریب اطمینان درک میکنند، پس برندها، نویسندهها، وبسایتها و کسبوکارها هم باید بهگونهای ساخته شوند که برای ماشین قابل فهم، قابل اعتبارسنجی و قابل اثبات باشند.
در نگاه اول، تصویر بیشتر شبیه یک خطای رابط کاربری یا نمایش ناخواسته دادههای پشتصحنه به نظر میرسد. اما وقتی دقیقتر به ساختار آن نگاه کنیم، با چیزی فراتر از یک متن ساده مواجه میشویم.
در خروجی، بخشهایی مانند Topic، Contact، work_goals، work_profile، organization، role و industry دیده میشود. این یعنی سیستم در حال دستهبندی اطلاعات در قالب موجودیتهای مستقل است. بهجای اینکه فقط یک متن پیوسته را پردازش کند، آن را به قطعات معنادار تبدیل کرده است.
برای مثال، یک فرد میتواند بهعنوان Contact شناسایی شود. یک مفهوم تخصصی میتواند در قالب Topic ثبت شود. یک هدف کاری میتواند زیرمجموعه work_goals قرار بگیرد. نقش شغلی، سازمان، صنعت و شرح وظایف هم بهصورت اجزای مستقل درک میشوند.
این ساختار نشان میدهد که جمنای، حداقل در این نمونه، صرفا به دنبال خلاصهسازی سطحی متن نیست. بلکه در حال ساختن نوعی نقشه معنایی از دادههاست. نقشهای که در آن هر موجودیت جایگاه مشخصی دارد و ارتباط آن با سایر موجودیتها قابل اندازهگیری است.
اینجا مفهوم ضریب اطمینان اهمیت پیدا میکند. وقتی سیستم برای یک موضوع عدد ۰.۹۸ یا برای یک ارتباط عدد ۰.۹۵ قرار میدهد، یعنی آن گزاره از نگاه مدل، سطح بالایی از قطعیت دارد. اما وقتی عددی مثل ۰.۸۸ دیده میشود، همچنان اعتماد وجود دارد، اما درجه آن پایینتر است.
همین تفاوت کوچک میان ۰.۹۸ و ۰.۸۸ میتواند در سیستمهای رتبهبندی، بازیابی اطلاعات، تولید پاسخ، اعتبارسنجی منابع و حتی ارزیابی تخصص افراد معنا داشته باشد.
ضریب اطمینان یا confidence score در سادهترین تعریف، عددی است که نشان میدهد یک سیستم تا چه اندازه نسبت به نتیجهای که تولید کرده مطمئن است. این نتیجه میتواند تشخیص یک موجودیت، طبقهبندی یک متن، استخراج یک رابطه یا تفسیر یک مفهوم باشد.
در سیستمهای هوش مصنوعی، کمتر چیزی با قطعیت مطلق انجام میشود. اغلب تصمیمها احتمالاتی هستند. مدل با دادههای موجود، الگوهای قبلی، زمینه متن و روابط معنایی کار میکند و سپس بهترین برداشت ممکن را ارائه میدهد.
اما بهترین برداشت ممکن همیشه به یک اندازه قابل اعتماد نیست. گاهی متن بسیار شفاف است و سیستم با احتمال بالا میتواند تشخیص دهد که یک فرد، متخصص یک حوزه خاص است. گاهی هم دادهها پراکندهاند، نشانهها ضعیفاند یا ارتباطها غیرمستقیماند. در این حالت، ضریب اطمینان پایینتر میآید.
برای متخصصان محتوا و سئو، این موضوع یک پیام روشن دارد:
اگر میخواهیم ماشینها ما را درست بفهمند، باید دادههای واضح، تکرارپذیر، قابل تطبیق و قابل اثبات درباره خودمان یا برندمان ایجاد کنیم.
این یعنی فقط نوشتن چند مقاله کافی نیست. فقط داشتن صفحه درباره ما کافی نیست. فقط ادعا کردن تخصص هم کافی نیست. باید نشانههای متعدد و همراستا در وب وجود داشته باشد تا سیستم بتواند با اطمینان بالا بفهمد ما چه کسی هستیم، چه تخصصی داریم، چه سابقهای داریم و چرا باید به ما اعتماد کند.
یکی از نکات مهم در سورس اصلی، اشاره به نامهایی مانند Navboost و Goldmine است؛ مفاهیمی که در بحثهای مرتبط با داکیومنتهای فاششده API گوگل نیز مطرح شدهاند. فارغ از اینکه هر سیستم دقیقا چه جایگاه فنی یا عملیاتی در معماری گوگل دارد، حضور این نامها در خروجی خام جمنای از یک جهت مهم است: مدل در حال اتصال مفاهیم تخصصی، اشخاص، موضوعات و سابقهها به یکدیگر است.
این اتصال، همان چیزی است که در تحلیل موتورهای جستجو اهمیت دارد. موتور جستجو فقط با کلمات کلیدی کار نمیکند. موتور جستجو باید بفهمد یک محتوا درباره چیست، چه کسی آن را نوشته، آن نویسنده در چه حوزهای سابقه دارد، آن محتوا با چه مفاهیمی مرتبط است و آیا منابع بیرونی هم این برداشت را تایید میکنند یا نه.
وقتی جمنای در خروجی خود مفاهیمی مثل Navboost، Goldmine یا Content Effort را در کنار اشخاص، تخصصها و اهداف کاری قرار میدهد، بهنوعی نشان میدهد که پردازش مدرن اطلاعات بر پایه رابطهها انجام میشود، نه صرفا واژهها.
اینجا دیگر بحث این نیست که یک عبارت چند بار در متن تکرار شده است. بحث این است که آیا یک موجودیت در شبکهای از دادهها، به شکل قابل اعتماد و قابل اثبات با یک موضوع مرتبط شده یا نه.
به همین دلیل، افشای یک ساختار جالب در خروجی جمنای میتواند برای جامعه سئو یک هشدار جدی باشد: آینده محتوا متعلق به کسانی نیست که فقط متن بیشتری تولید میکنند، بلکه متعلق به کسانی است که موجودیت معتبرتری میسازند.
سالها سئو حول محور کلمات کلیدی میچرخید. متخصص محتوا باید میفهمید کاربران چه عبارتی را جستجو میکنند، سپس همان عبارت را در عنوان، تیترها، متن، متا دیسکریپشن و لینکسازی داخلی استفاده میکرد.
این روش هنوز بیاهمیت نشده است، اما دیگر کافی نیست. موتورهای جستجو و مدلهای هوش مصنوعی بهمرور از سطح کلمه عبور کردهاند و به سطح موجودیت رسیدهاند.
موجودیت میتواند یک شخص، برند، سازمان، محصول، مکان، مفهوم، رویداد یا حتی یک حوزه تخصصی باشد. وقتی سیستمها با موجودیت کار میکنند، دیگر فقط به دنبال این نیستند که آیا عبارت «سئو تکنیکال» در متن آمده یا نه. آنها میخواهند بفهمند چه کسی درباره سئو تکنیکال صحبت میکند، سابقه او چیست، آیا منابع دیگر او را در این حوزه تایید کردهاند، آیا محتوای او با مفاهیم اصلی این حوزه همخوانی دارد و آیا الگوی فعالیت او پایدار است یا نه.
در چنین فضایی، ضریب اطمینان تبدیل به یک مفهوم کلیدی میشود. سیستم ممکن است بفهمد یک شخص با حوزه سئو مرتبط است، اما میزان اطمینان آن به این ارتباط میتواند کم یا زیاد باشد. هرچه دادههای تاییدکننده بیشتر، شفافتر و همراستاتر باشند، احتمال افزایش این ضریب بیشتر میشود.
این یعنی استراتژی محتوا باید از «تولید مقاله برای کلمه کلیدی» به «ساختن اعتبار برای موجودیت» تغییر کند.
هیچ سیستم هوشمندی بدون سطحی از قطعیت نمیتواند تصمیم قابل اتکا بگیرد. اگر یک موتور جستجو نداند که یک نویسنده واقعا در حوزهای تخصص دارد یا فقط چند متن پراکنده منتشر کرده، نمیتواند بهراحتی او را بهعنوان منبع معتبر معرفی کند.
همین موضوع در مدلهای زبانی هم دیده میشود. وقتی کاربر از یک مدل هوش مصنوعی سوال میپرسد، مدل باید پاسخ را از میان انبوهی از احتمالات بسازد. برای این کار، به دادههایی نیاز دارد که به آنها اعتماد بیشتری داشته باشد.
ضریب اطمینان در اینجا نقش فیلتر را بازی میکند. دادههایی که واضحتر، پرتکرارتر، سازگارتر و قابل اعتبارسنجیتر هستند، شانس بیشتری دارند که در پاسخ نهایی یا درک کلی سیستم تاثیر بگذارند.
برای مثال، فرض کنید دو نفر درباره یک موضوع تخصصی مثل تحلیل ساختارهای رتبهبندی موتور جستجو محتوا تولید میکنند.
نفر اول فقط چند مقاله عمومی دارد، بدون صفحه نویسنده قوی، بدون ارجاع خارجی، بدون سابقه مشخص، بدون حضور در پلتفرمهای تخصصی و بدون ارتباط واضح میان نام او و موضوع تخصصی.
نفر دوم چند سال محتوای عمیق منتشر کرده، در چند پلتفرم معتبر حضور دارد، دیگران به او ارجاع دادهاند، پروفایلهای او در وب همراستا هستند، موضوعات تخصصی او تکرارپذیرند و در متنهای مختلف، ارتباط روشنی میان نام او و حوزه کاریاش دیده میشود.
برای انسان شاید هر دو بتوانند ادعای تخصص داشته باشند. اما برای ماشین، نفر دوم موجودیت واضحتر و قابل اعتمادتری است. چون شواهد بیشتری برای ساختن یک برداشت با ضریب اطمینان بالا وجود دارد.
برای درک بهتر موضوع، یک سناریوی فرضی را در نظر بگیریم.
فرض کنید یک برند ایرانی در حوزه آموزش معاملهگری فعالیت میکند و میخواهد بهعنوان یکی از قدیمیترین و معتبرترین فعالان این بازار شناخته شود. این برند در سایت خود بارها نوشته است که «باتجربه»، «معتبر» و «اولین» است. اما آیا این برای ماشین کافی است؟
احتمالا نه.
مدل هوش مصنوعی یا موتور جستجو برای اعتماد به این ادعاها دنبال نشانههای بیشتری میگردد. مثلا:
آیا دامنه سایت قدمت قابل بررسی دارد؟
آیا در رسانههای دیگر از این برند با همین جایگاه یاد شده است؟
آیا مدیران یا بنیانگذاران برند سابقه قابل ردیابی دارند؟
آیا کاربران، رسانهها، شبکههای اجتماعی و منابع ثالث درباره آن صحبت کردهاند؟
آیا محتوای سایت در طول زمان یک هویت تخصصی ثابت داشته است؟
آیا دادههای ساختاریافته، صفحه درباره ما، پروفایل نویسندگان و ارجاعات خارجی با هم هماهنگاند؟
اگر پاسخ این پرسشها مثبت باشد، سیستم میتواند با اطمینان بیشتری برند را در جایگاه مورد ادعا درک کند. اما اگر فقط خود برند این ادعاها را تکرار کرده باشد، ضریب اطمینان پایینتر خواهد بود.
این دقیقا همان جایی است که افشای یک ساختار جالب در خروجی جمنای برای استراتژی برند و سئو اهمیت پیدا میکند. تصویر به ما نشان میدهد که سیستمها میتوانند برای موجودیتها و ادعاها وزن قائل شوند. بنابراین هر ادعایی باید با شواهد قابل پردازش پشتیبانی شود.
در دنیای محتوا، سه سطح مختلف وجود دارد که معمولا با هم اشتباه گرفته میشوند: ادعا، سیگنال و اثبات.
ادعا یعنی شما درباره خودتان چیزی میگویید. مثلا مینویسید: «ما باتجربهترین تیم این حوزه هستیم.»
سیگنال یعنی نشانههایی در وب وجود دارد که میتواند این ادعا را پشتیبانی کند. مثلا سابقه فعالیت، تعداد محتواهای تخصصی، حضور در رسانهها، نقلقولها، مصاحبهها، دادههای ساختاریافته و لینکهای معتبر.
اثبات زمانی شکل میگیرد که این سیگنالها از منابع مختلف، با الگوی سازگار و قابل بررسی، یک برداشت واحد بسازند. در این حالت، سیستم میتواند با ضریب اطمینان بالاتری نتیجه بگیرد که ادعای شما احتمالا معتبر است.
مشکل بسیاری از برندها این است که در سطح ادعا باقی میمانند. آنها متنهایی پر از صفات مثبت تولید میکنند، اما برای ماشین شواهد کافی ایجاد نمیکنند. در مقابل، برندهایی که بهصورت هوشمندانه روی سیگنالهای بیرونی، ساختار اطلاعات، انسجام پیام و تداوم موضوعی کار میکنند، شانس بیشتری برای تبدیل شدن به یک موجودیت معتبر دارند.
اگر بخواهیم این موضوع را به زبان عملی برای نویسندگان و متخصصان محتوا ترجمه کنیم، باید بگوییم هر قطعه محتوا باید به ساختن یک گراف معنایی قوی کمک کند.
مقالهای که منتشر میکنیم نباید فقط برای گرفتن رتبه روی یک عبارت نوشته شود. باید مشخص کند نویسنده کیست، موضوع چیست، مسئله کدام است، محتوا به چه مفاهیم تخصصی متصل است و چرا این منبع قابل اعتماد است.
در محتوای تخصصی، استفاده از مفاهیم مرتبط اهمیت زیادی دارد. مثلا اگر درباره سئو تکنیکال مینویسیم، طبیعی است که درباره crawling، indexing، rendering، structured data، internal linking، log analysis و search quality صحبت کنیم. حضور طبیعی این مفاهیم، به سیستم کمک میکند حوزه تخصصی محتوا را بهتر بفهمد.
اما فقط آوردن اصطلاحات کافی نیست. ارتباط میان مفاهیم باید منطقی باشد. مقاله باید مسئله را باز کند، زمینه بدهد، مثال بزند و به نتیجه تحلیلی برسد. مدلهای هوش مصنوعی و موتورهای جستجو بهمرور در تشخیص متنهای سطحی از متنهای واقعا تخصصی بهتر شدهاند.
بنابراین اگر هدف ما افزایش اعتبار موجودیت است، باید محتواهایی بسازیم که هم برای انسان مفید باشند و هم برای ماشین ساختارمند.
پلتفرمهایی مثل ویرگول، لینکدین و مدیوم فقط کانال انتشار محتوا نیستند. این پلتفرمها میتوانند بخشی از شبکه اثبات موجودیت باشند.
وقتی یک متخصص یا برند، دیدگاه تحلیلی خود را در چند بستر معتبر و قابل ایندکس منتشر میکند، سیگنالهای بیشتری برای موتورهای جستجو و مدلهای هوش مصنوعی ایجاد میشود. البته این به معنی کپی کردن یک متن در همه پلتفرمها نیست. بهتر است نسخه مادر محتوا تولید شود و سپس برای هر پلتفرم متناسبسازی گردد.
در ویرگول، میتوان لحن را کمی آموزشیتر و بومیتر کرد. در لینکدین، تمرکز میتواند روی بینش مدیریتی، تجربه حرفهای و بحثبرانگیز بودن موضوع باشد. در مدیوم، نسخه تحلیلیتر و بینالمللیتر محتوا بهتر جواب میدهد.
اما پیام اصلی باید یکسان بماند. اگر یک فرد یا برند میخواهد با یک حوزه خاص شناخته شود، باید در پلتفرمهای مختلف همان هویت تخصصی را بهصورت منسجم نشان دهد. این انسجام، یکی از عوامل مهم در افزایش اطمینان سیستمها نسبت به ارتباط میان موجودیت و موضوع است.
برای اینکه محتوا در ساختن یک موجودیت قوی موثر باشد، باید چند اصل رعایت شود.
اول، هویت نویسنده یا برند باید شفاف باشد. محتوای بینام، بدون سابقه و بدون پیوند به سایر داراییهای دیجیتال، سختتر میتواند اعتماد ماشینی ایجاد کند.
دوم، موضوع باید بهصورت تخصصی و پیوسته پوشش داده شود. اگر یک سایت امروز درباره سئو مینویسد، فردا درباره ارز دیجیتال، پسفردا درباره آشپزی و هفته بعد درباره مهاجرت، ساختن هویت تخصصی برای آن سختتر میشود.
سوم، ادعاها باید قابل پشتیبانی باشند. اگر میگوییم «اولین»، «قدیمیترین»، «معتبرترین» یا «باتجربهترین»، باید داده، تاریخچه، ارجاع، سند یا شواهد بیرونی برای آن داشته باشیم.
چهارم، ارتباط معنایی میان محتواها باید حفظ شود. مقالات مختلف یک سایت یا یک برند باید مثل قطعات یک پازل عمل کنند. هر مقاله باید به تقویت تصویر کلی موجودیت کمک کند.
پنجم، حضور بیرونی اهمیت دارد. اگر فقط در سایت خودمان درباره خودمان صحبت کنیم، اثر آن محدود است. اما وقتی رسانهها، شبکههای اجتماعی، پلتفرمهای محتوایی، پروفایلهای حرفهای و منابع ثالث هم همان تصویر را تقویت کنند، سیستم با اطمینان بیشتری ما را طبقهبندی میکند.
یکی از سوءبرداشتهای رایج در سئو این است که برخی فکر میکنند هرچه یک عبارت بیشتر تکرار شود، سیستم بیشتر آن را باور میکند. اما در معماریهای مدرن، تکرار خام لزوما معادل اعتماد نیست.
اگر یک برند صد بار در سایت خود بنویسد «ما معتبرترین هستیم»، اما هیچ نشانه بیرونی یا ساختار قابل تاییدی وجود نداشته باشد، این تکرار ممکن است حتی بیارزش یا غیرطبیعی تلقی شود.
اعتماد از ترکیب چند عامل ساخته میشود: وضوح، سازگاری، منبع، زمینه، ارتباط، سابقه و تایید بیرونی. ضریب اطمینان زمانی بالا میرود که سیستم از چند مسیر مختلف به یک نتیجه مشابه برسد.
این نکته برای تولیدکنندگان محتوا بسیار مهم است. هدف نباید بمباران الگوریتم با واژهها باشد. هدف باید ساختن شواهد معنادار باشد.
افشای یک ساختار جالب در خروجی جمنای به ما یادآوری میکند که آینده سئو بیش از گذشته به سمت تحلیل موجودیت، اعتبار منبع و ساختار داده حرکت میکند. در این آینده، محتوا همچنان مهم است، اما محتوایی برنده میشود که در یک شبکه قابل فهم از نشانهها قرار گرفته باشد.
برندها باید به این فکر کنند که اگر یک مدل هوش مصنوعی بخواهد آنها را خلاصه کند، چه چیزی خواهد گفت. آیا آنها را با یک حوزه تخصصی مشخص مرتبط میداند؟ آیا سابقه آنها را تشخیص میدهد؟ آیا منابع مختلف تصویر مشابهی از آنها ارائه میدهند؟ آیا ادعاهایشان قابل اثبات است؟
این پرسشها از جنس سئوی آیندهاند. دیگر کافی نیست بپرسیم «روی چه کیوردی رتبه بگیریم؟» باید بپرسیم «ماشین ما را بهعنوان چه موجودیتی میشناسد و با چه ضریب اطمینانی؟»
آنچه در این تصویر دیده میشود، میتواند یک پنجره کوچک به منطق پشتصحنه پردازش اطلاعات در مدلهای هوش مصنوعی باشد. خروجی خام جمنای نشان میدهد که سیستمها اطلاعات را به موجودیتها، نقشها، موضوعات و ارتباطات تقسیم میکنند و برای هر برداشت، سطحی از اطمینان در نظر میگیرند.
برای متخصصان سئو و محتوا، پیام این اتفاق روشن است: آینده رقابت فقط در تولید متن بیشتر نیست. آینده در ساختن موجودیتهای معتبر، قابل اثبات و قابل فهم برای ماشینهاست.
افشای یک ساختار جالب در خروجی جمنای نشان میدهد که اعتماد، در نگاه سیستمهای هوشمند، یک مفهوم مبهم و احساسی نیست. اعتماد میتواند به داده، رابطه، سابقه، سیگنال و در نهایت ضریب اطمینان تبدیل شود.
پس اگر میخواهیم در فضای جستجو و هوش مصنوعی جدی گرفته شویم، باید از سطح ادعا عبور کنیم و به سطح اثبات برسیم. باید محتوایی بسازیم که هم انسان را قانع کند و هم ماشین بتواند آن را با اطمینان بالا بفهمد.
این همان نقطهای است که سئو، روابط عمومی دیجیتال، تولید محتوای تخصصی، برندینگ شخصی و معماری اطلاعات به هم میرسند. برندههای آینده کسانی نیستند که فقط بیشتر مینویسند؛ کسانی هستند که بهتر اثبات میشوند.
تهیه شده توسط تیم تخصصی سئو سید احسان خسروی (مدیر، متخصص و مشاور استراتژیک سئو)

