
یکی از مفاهیمی که در سالهای اخیر در بحث تولید محتوای سئو زیاد شنیده میشود «Information Gain» یا ارزش افزوده اطلاعاتی است. برداشت ساده و رایج از این مفهوم معمولاً چنین است: اگر مقاله من اطلاعات بیشتری از رقبا داشته باشد، پس Information Gain بیشتری دارد. نتیجه این برداشت نیز قابل پیشبینی است؛ نویسنده ده نتیجه اول را باز میکند، تمام زیرعنوانهای آنها را جمع میکند، چند نکته دیگر به متن اضافه میکند و درنهایت مقالهای تولید میشود که از نظر تعداد کلمات و پوشش موضوع از رقبا بزرگتر است.
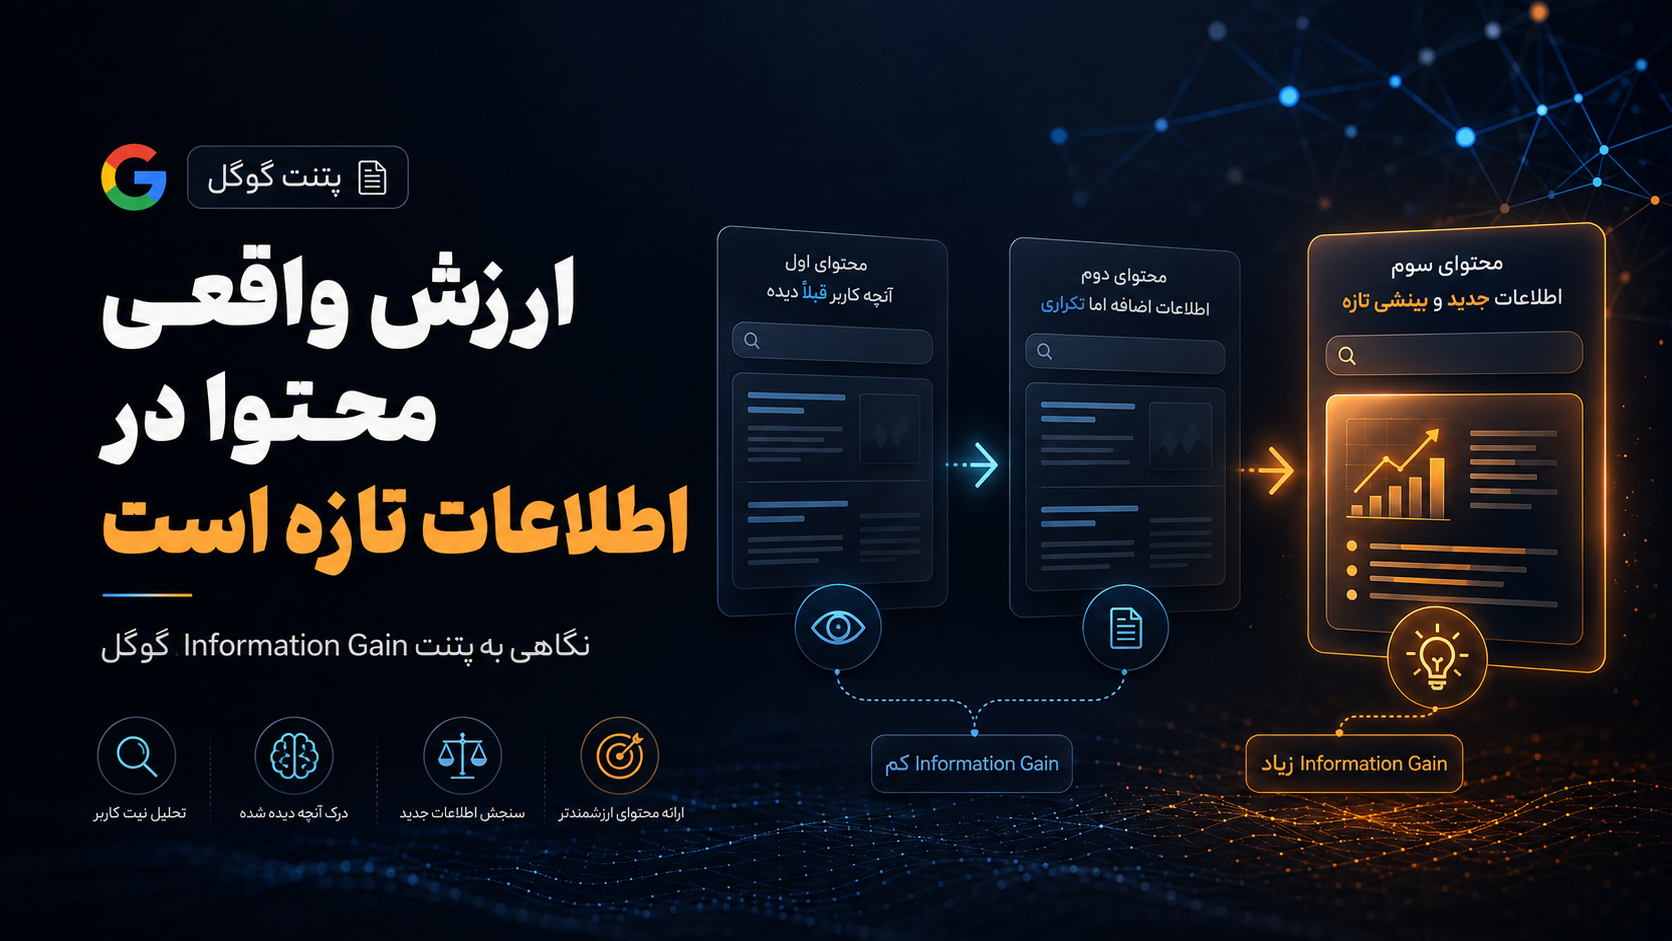
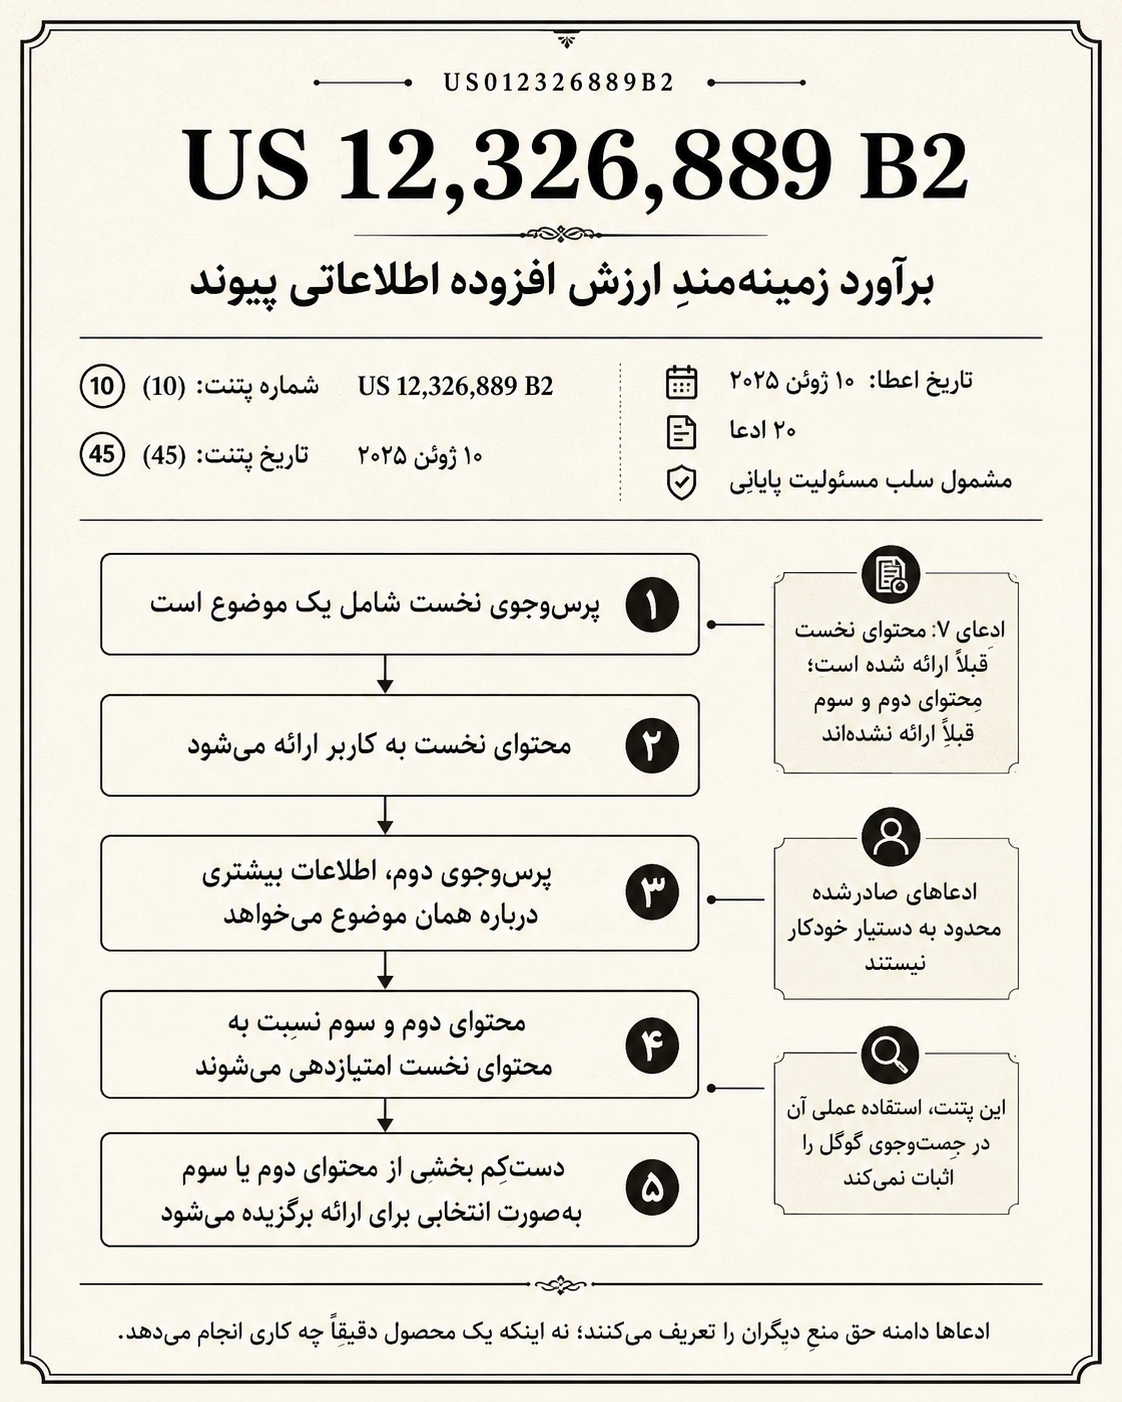
این نگاه کاملاً بیفایده نیست، اما پتنت Contextual Estimation of Link Information Gain چارچوب دقیقتری ارائه میکند. نکته مهم در Claim 1 این است که امتیاز سند جدید صرفاً بر مبنای حجم اطلاعات موجود در همان سند تعریف نمیشود. ابتدا مجموعهای از اطلاعات درباره یک موضوع قبلاً به کاربر ارائه شده است؛ سپس برای اسناد جدیدی که همان موضوع را پوشش میدهند، امتیازی تعیین میشود که مقدار اطلاعات تازه آنها را نسبت به اطلاعات قبلاً ارائهشده به همان کاربر نشان میدهد. در Claims بعدی نیز سناریوهایی مطرح میشوند که کاربر اسناد قبلی را دیده و سپس اسناد جدید براساس اطلاعات تازهای که میتوانند به او اضافه کنند ارزیابی یا مرتب میشوند.
این تفاوت ظاهراً کوچک، نگاه ما به تولید محتوا را عوض میکند. سؤال دیگر فقط این نیست که «این صفحه چقدر اطلاعات دارد؟» بلکه باید پرسید «کاربری که به این صفحه رسیده، احتمالاً قبل از آن چه اطلاعاتی دریافت کرده و صفحه جدید چه چیزی فراتر از آن دانش قبلی ارائه میکند؟»
قبل از اینکه این ایده را وارد استراتژی سئو کنیم، باید یک محدودیت مهم را هم روشن کنیم. پتنت سندی درباره یک روش فنی است و وجود آن اثبات نمیکند که Google Search امروز دقیقاً همین سیستم را با همین وزن و همین منطق در رتبهبندی عمومی وب اجرا میکند. بنابراین هدف از بررسی این سند ساختن یک «Ranking Factor جدید» نیست. ارزش اصلی آن برای متخصص محتوا در ارائه مدلی بسیار خوب برای فهم تازگی واقعی اطلاعات و جلوگیری از تکرار محتواست.
فرض کنید مقالهای جامع درباره «روشهای کاهش مصرف برق کولر گازی» نوشته شده است. این مقاله درباره تنظیم دمای مناسب، شستوشوی فیلتر، سرویس دورهای، انتخاب دستگاه اینورتر، عایقکاری، ظرفیت مناسب دستگاه و شرایط نصب کندانسور توضیح میدهد. از نگاه مطلق، مقاله اطلاعات زیادی دارد و میتوان آن را یک محتوای نسبتاً کامل دانست.
اما تصور کنید کاربر قبل از رسیدن به این صفحه سه مقاله دیگر خوانده و تقریباً تمام همین موارد را دیده است. در این لحظه، مقدار کل اطلاعات مقاله تغییر نکرده است، اما مقدار اطلاعات جدیدی که برای این کاربر فراهم میکند بسیار کمتر شده است.
حالا کاربر دیگری را تصور کنید که فقط یک پاسخ کوتاه درباره تنظیم دما دیده و بعد وارد همان مقاله شده است. همان سند ممکن است برای این فرد اطلاعات بسیار بیشتری اضافه کند.
پتنت دقیقاً روی همین وابستگی تأکید میکند. در توضیحات آن، Information Gain سند جدید با توجه به اسنادی که قبلاً به کاربر ارائه شدهاند محاسبه میشود. حتی در مثال خود پتنت، اسناد مربوط به تعمیر رایانه بسته به اینکه کاربر قبلاً درباره مشکلات نرمافزاری اطلاعات گرفته باشد یا نه، ارزش افزوده متفاوتی پیدا میکنند.
این یعنی Information Gain در این چارچوب بیشتر شبیه یک رابطه میان دانسته قبلی و اطلاعات جدید است تا یک برچسب ثابت روی صفحه.
یک مثال ساده از Search Journey
فرض کنیم مرحله اول جستوجوی کاربر این است:
«چطور مصرف برق کولر گازی را کم کنیم؟»
در پاسخ نخست، کاربر یاد میگیرد که دما را روی محدوده منطقی تنظیم کند، فیلترها را تمیز نگه دارد و سرویس دورهای انجام دهد.
بعد سؤال کاربر تغییر میکند:
«راههای بیشتر برای کاهش مصرف برق کولر گازی»
در این مرحله اگر مقاله دوم دوباره یک مقدمه طولانی درباره اهمیت صرفهجویی بنویسد و سپس همان سه توصیه قبلی را تکرار کند، شاید از نظر تعداد کلمه غنی باشد اما Journey کاربر را چندان جلو نمیبرد.
مقالهای که توضیح دهد سایهدارکردن مناسب محل کندانسور در شرایط مشخص چه اثری میتواند داشته باشد، چگونه Oversizing یا Undersizing دستگاه روی مصرف تأثیر میگذارد، چه زمانی نشتی کانال مسئله اصلی است و از چه نشانههایی میتوان فهمید دستگاه با ظرفیت نامناسب انتخاب شده، مرحله تازهای از فهم را ایجاد میکند.
این مثال یک تفاوت اساسی میان «پوشش موضوع» و «پیشبرد دانش» نشان میدهد. صفحه ممکن است موضوع را پوشش دهد، اما اگر تمام اطلاعات آن قبلاً در مسیر کاربر مصرف شده باشند، چیز زیادی به فهم او اضافه نمیکند.
یکی از جالبترین بخشهای توضیحات پتنت این است که وقتی کاربر اسناد بیشتری را مشاهده میکند، مجموعه اسناد «قبلاً دیدهشده» بزرگتر میشود و امتیاز Information Gain اسناد باقیمانده میتواند دوباره محاسبه شود. در مثال سند، اگر کاربر ابتدا Document 1 و سپس Document 2 را ببیند، Document 3 و Document 4 اکنون نسبت به مجموعه بزرگتری از دانش قبلی ارزیابی میشوند.
این نکته برای Search مدرن بسیار قابل تأمل است. ما اغلب رتبه صفحه را مثل رابطهای ثابت میان Query و Document تصور میکنیم، اما Journey واقعی کاربر ایستا نیست. کاربر سؤال اول را میپرسد، پاسخی میگیرد، بخشی از مسئله برایش روشن میشود و سؤال بعدی دقیقتر میشود.
در حوزههایی مثل خرید محصول، سلامت، آموزش، تعمیرات، سفر یا مسائل مالی، این حرکت بسیار واضح است. کسی که تازه درباره «دوربین بدون آینه چیست» جستوجو میکند نیاز متفاوتی از کسی دارد که نیم ساعت بعد درباره تفاوت اندازه سنسور و Dynamic Range پرسوجو میکند.
از منظر استراتژی محتوا، نتیجه مهم این است که یک Topic Cluster خوب باید بتواند کاربر را از مراحل مختلف همین افزایش دانش عبور دهد، نه اینکه پنج صفحه تقریباً یکسان با Keywordهای متفاوت بسازد.
مشکل «ده نتیجه را بخوان و نتیجه یازدهم را ترکیب کن»
یکی از رایجترین Workflowهای تولید محتوا در سئو این است که چند نتیجه اول Google باز شوند، Headingهای مشترک استخراج شوند، مطالب آنها ترکیب شوند و سپس برای «کاملترشدن» چند بخش اضافی به مقاله اضافه شود.
این روش برای فهم Baseline موضوع مفید است. اگر تمام صفحات درباره مسئلهای بنیادی صحبت کردهاند، احتمالاً آن مسئله بخشی از Intent است و نباید صرفاً برای متفاوتبودن حذف شود. مشکل زمانی است که همین Workflow تبدیل به کل فرایند تحقیق شود.
اگر همه صفحات موجود بگویند A، B، C و D و ما صفحهای تولید کنیم که همان A، B، C و D را با عبارتبندی متفاوت و مقدمهای طولانیتر توضیح دهد، شاید Semantic Coverage خوبی داشته باشیم اما Novel Information محدودی ایجاد کردهایم.
گام بعدی تحقیق باید دقیقاً از جایی شروع شود که تحلیل رقبا تمام میشود. باید بپرسیم چه سؤالهایی بدون پاسخ ماندهاند، چه ادعاهایی مثال ندارند، کجا داده قدیمی است، چه استثناهایی حذف شدهاند، چه تجربه عملی وجود ندارد و چه تصمیمی هنوز برای کاربر دشوار است.
این مرحله چیزی است که میتواند Content Research را از Content Aggregation جدا کند.
یکی از اشتباههای احتمالی این است که برای ایجاد Information Gain صرفاً همان اطلاعات را با قالب متفاوت بنویسیم. مثلاً رقیب فهرست شمارهدار دارد و ما جدول بسازیم یا جملهها را پارافریز کنیم.
این کار ممکن است تجربه ارائه را بهتر کند، اما لزوماً اطلاعات جدیدی تولید نمیکند.
اگر دو مقاله هر دو میگویند دمای کولر را روی مقدار مناسب تنظیم کنید، اینکه یکی آن را در جدول و دیگری در Bullet List قرار داده از نظر محتوای معنایی تفاوت بنیادی ایجاد نمیکند.
Information Gain واقعی زمانی شکل میگیرد که کاربر بعد از خواندن صفحه چیزی بداند که قبل از آن نمیدانسته است. این «چیز» میتواند یک داده تازه، یک استثنا، یک روش تصمیمگیری، یک مثال، یک مقایسه، یک تجربه تخصصی یا حتی توضیحی باشد که رابطه میان دو مفهوم را روشن میکند.
بنابراین Originality در این بحث با Novelty اطلاعاتی نزدیکتر است تا Originality صرف در عبارتبندی.
یکی از بهترین منابع Information Gain داده دستاول است. اگر همه مقالات درباره نرخ تبدیل فروشگاه اینترنتی توصیههای کلی میدهند و شما داده واقعی از صد پروژه دارید که نشان میدهد در چه شرایطی یک تغییر مشخص بیشترین اثر را داشته، چیزی به فضای اطلاعاتی اضافه کردهاید.
تجربه عملی متخصص نیز همین نقش را دارد. بسیاری از محتواهای اینترنتی میگویند «سرعت سایت را افزایش دهید»، اما کسی که توضیح میدهد در یک پروژه واقعی مشکل اصلی TTFB نبود بلکه یک درخواست API پس از Hydration باعث تأخیر محتوای اصلی میشد، جزئیاتی میآورد که از جمعبندی ده مقاله عمومی بهدست نمیآید.
استثناها نیز ارزشمندند. اینترنت پر از توصیههای عمومی است. جمله «X را انجام دهید» ممکن است در اکثر شرایط درست باشد، اما توضیح «در چه شرایطی X را انجام ندهیم» سطح دانش کاربر را یک مرحله بالاتر میبرد.
مقایسه نیز زمانی Information Gain میسازد که واقعاً تصمیم را ساده کند، نه اینکه فقط چند ویژگی را کنار هم بچیند. توضیح اینکه برای کدام سناریو ابزار A مناسبتر و در چه سناریویی ابزار B انتخاب منطقیتری است، اطلاعات تصمیممحور ایجاد میکند.
اگر Information Gain را Contextual ببینیم، Follow-up Query اهمیت زیادی پیدا میکند. سؤال دوم کاربر معمولاً نشان میدهد سؤال اول چه چیزی را حل نکرده است.
کاربر ابتدا میپرسد «بهترین لپتاپ برای برنامهنویسی چیست؟» و سپس «آیا ۱۶ گیگ رم برای برنامهنویسی کافی است؟» بعد ممکن است بپرسد «برای اجرای Docker چطور؟»
هر مرحله نشان میدهد پاسخ قبلی چه Contextی ساخته و چه ابهامی باقی مانده است.
برای تولید محتوا، ابزارهای People Also Ask، پیشنهادهای جستوجو، داده Search Console، جستوجوی داخلی سایت، سؤالهای پشتیبانی و مکالمات فروش میتوانند همین لایههای بعدی را آشکار کنند.
بهجای جمعآوری صد Keyword جدا، میتوان آنها را به صورت مسیرهای سؤال مرتب کرد: کاربر ابتدا چه میپرسد، بعد از گرفتن پاسخ چه سؤال منطقی دیگری دارد و در نهایت برای تصمیم به چه اطلاعاتی نیاز دارد؟
این ساختار یک Content Journey واقعیتر ایجاد میکند.
بسیاری از سایتها برای ساخت Topical Authority تعداد زیادی صفحه نزدیک به هم تولید میکنند. مثلاً یک صفحه «کاهش مصرف برق کولر»، صفحه دوم «راههای کم کردن هزینه برق کولر»، صفحه سوم «ترفندهای کاهش مصرف کولر» و صفحه چهارم «چگونه کولر برق کمتری مصرف کند».
اگر این صفحات تقریباً همان مجموعه نکات را با Keywordهای متفاوت تکرار کنند، خوشه موضوعی بهجای افزایش دانش تبدیل به شبکهای از صفحات Cannibalizing و تکراری میشود.
مدل Information Gain راه دیگری پیشنهاد میدهد. صفحه مادر میتواند اصول پایه را پوشش دهد. مقاله دوم وارد عیبیابی شود. مقاله سوم انتخاب ظرفیت را بررسی کند. مقاله چهارم اندازهگیری مصرف واقعی را آموزش دهد و مقاله پنجم تفاوت شرایط اقلیمی را تحلیل کند.
همین اصل میتواند معیار خوبی برای تصمیم Merge یا Delete نیز باشد. اگر دو صفحه در عمل هیچ اطلاعات متمایزی به کاربر ارائه نمیکنند، شاید مسئله فقط Keyword Cannibalization نباشد؛ احتمالاً از نظر Information Architecture نیز دو URL برای یک نیاز ساختهایم.
نه. این یکی از خطرناکترین برداشتهای افراطی از Information Gain است. اگر کاربر برای نخستین بار وارد صفحه شما شود، ممکن است اطلاعات پایه را ندیده باشد. حتی اگر آن اطلاعات در صد سایت دیگر وجود داشته باشند، ممکن است برای فهم ادامه مطلب ضروری باشند.
هدف، حذف Basics نیست. هدف این است که مقاله بعد از ارائه Baseline متوقف نشود.
میتوان اصول پایه را مختصر، دقیق و روشن ارائه کرد و سپس به بخشهایی رفت که ارزش متمایزکننده صفحه را میسازند. میزان فضای اختصاصیافته به Basics نیز باید با Intent هماهنگ باشد. صفحهای برای مبتدیان طبیعتاً توضیح پایه بیشتری میخواهد، درحالیکه مقاله Advanced نباید نیمی از متن را صرف تعریف اصطلاحات ابتدایی کند.
Information Gain باید به بهبود ساختار کمک کند، نه اینکه نویسنده را مجبور کند برای متفاوتشدن اطلاعات ضروری را حذف کند.
یکی از بهترین راههای تولید اطلاعاتی که ده صفحه دیگر ندارند، استفاده از تجربه واقعی است. تجربه الزاماً به معنی داستانگویی شخصی نیست. داده حاصل از پروژهها، مشاهده خطاهای رایج، تستهای انجامشده، نمونههای Before/After و محدودیتهایی که فقط در عمل دیده میشوند همه میتوانند محتوای متفاوت بسازند.
این دقیقاً جایی است که نویسنده متخصص نسبت به Content Aggregator مزیت پیدا میکند.
سیستم تولید محتوایی که فقط وب را خلاصه میکند، ذاتاً تمایل زیادی به بازتولید Common Knowledge دارد. اگر تمام منابع ورودی درباره پنج نکته مشابه صحبت کنند، خروجی نیز احتمالاً همان پنج نکته را با ساختاری تمیزتر تکرار میکند.
برای شکستن این چرخه باید منبع اطلاعات جدید وارد سیستم شود؛ متخصص، داده اختصاصی، آزمایش، مصاحبه، بررسی اسناد اصلی یا تجربه مشتری.
این بحث در عصر تولید انبوه محتوای هوش مصنوعی اهمیت بیشتری پیدا میکند. مدل زبانی میتواند در چند ثانیه مقالهای منظم و جامع درباره تقریباً هر موضوع عمومی تولید کند. اما اگر Prompt فقط بخواهد «یک مقاله جامع درباره موضوع X» ساخته شود، احتمال زیادی دارد خروجی بازتاب همان اطلاعات پرتکرار وب باشد.
مزیت رقابتی دیگر فقط توانایی تولید متن منسجم نیست؛ دسترسی به Context و Evidence متفاوت است.
برای استفاده بهتر از هوش مصنوعی، باید ورودی آن را غنیتر کنیم: داده داخلی، مصاحبه متخصص، نتایج تست، نظرات کاربران، اسناد تخصصی و سؤالات واقعی مشتریان.
در این حالت AI میتواند ابزار سازماندهی و تحلیل اطلاعات تازه باشد، نه دستگاهی برای بازنویسی Consensus موجود.
رفتار جستوجو در حال حرکت به سمت تعاملهای طولانیتر است. کاربر در Search، دستیار یا محیط هوش مصنوعی سؤال اولیه میپرسد، جواب میگیرد، سؤال بعدی مطرح میکند و Context مکالمه حفظ میشود.
پتنت مورد بحث دقیقاً در چنین محیطی قابل فهمتر میشود، چون Claim 1 به Automated Assistant و اطلاعات قبلاً ارائهشده به کاربر اشاره دارد.
اگر یک سیستم بداند کاربر قبلاً چه شنیده، تکرار همان پاسخ نهتنها کمکی نمیکند بلکه تجربه را آزاردهنده میکند. سیستم باید مرحله بعدی دانش را پیدا کند.
برای ناشر محتوا نیز نتیجه مشابه است. هرچه موتورهای پاسخگو بتوانند بخش عمومی و تکراری محتوا را مستقیم خلاصه کنند، ارزش صفحاتی که اطلاعات منحصربهفردتر، مستندتر یا عمیقتر دارند بیشتر قابل توجه میشود.
این هنوز به معنی ادعای Ranking مستقیم نیست؛ یک نتیجه استراتژیک از تغییر شکل تجربه جستوجو است.
روش معمول Content Gap اغلب به Keyword Gap محدود میشود. ابزار نشان میدهد رقیب برای چه عبارتهایی رتبه دارد و ما نداریم. این اطلاعات مفید است، اما «عبارت جدید» الزاماً «اطلاعات جدید» نیست.
Gap Analysis اطلاعاتی باید از خود پاسخها شروع شود.
برای هر موضوع، چند منبع اصلی را بخوانید و ادعاهای آنها را استخراج کنید. مشخص کنید چه نکاتی تقریباً در تمام منابع وجود دارند. سپس نقاط اختلاف، ابهام و فقدان را پیدا کنید.
بعد به منابع خارج از SERP بروید: تحقیقات دانشگاهی، مستندات رسمی، دیتاستها، انجمنها، پشتیبانی مشتری، مصاحبه متخصصان و داده داخلی.
هدف این است که ببینیم چه چیزی میتوانیم اضافه کنیم که صرفاً حاصل ترکیب دوباره صفحات رتبهدار نیست.
یک ماتریس ساده برای تیم محتوا
برای هر مقاله میتوان چهار ستون ساخت:
«آنچه کاربر احتمالاً میداند»، «آنچه SERP دائماً تکرار میکند»، «آنچه هنوز مبهم است» و «ارزش اختصاصی ما».
در ستون اول دانش پایه مخاطب را تخمین میزنیم. در ستون دوم Common Information را استخراج میکنیم. در ستون سوم Gapها را مشخص میکنیم و در ستون چهارم تصمیم میگیریم چه داده یا تجربهای میتوانیم به موضوع اضافه کنیم.
این ماتریس کمک میکند مقاله از همان ابتدای Brief یک Value Proposition اطلاعاتی داشته باشد.
بهجای اینکه Brief بنویسد «۲۵۰۰ کلمه، ۱۲ Heading و استفاده از این Keywords»، میتواند بگوید «این صفحه باید بعد از اطلاعات رایج موجود، این سه نکته تازه را به کاربر یاد بدهد.»
این تغییر کوچک Brief کیفیت خروجی را بهشدت تغییر میدهد.
طول محتوا نه دشمن Information Gain است و نه تضمینکننده آن. مقاله طولانی میتواند بسیار ارزشمند باشد اگر هر بخش آن دانش جدید، توضیح ضروری یا Context تصمیمگیری اضافه کند. مقاله طولانی دیگری میتواند فقط یک ایده را ده بار تکرار کند.
پس بهجای Word Count باید Information Density را نیز ببینیم.
هر Heading باید بتواند توضیح دهد چرا وجود دارد. آیا یک سؤال جدا را پاسخ میدهد؟ آیا محدودیتی را روشن میکند؟ آیا مثال یا شواهدی میآورد که فهم را عمیقتر میکند؟
اگر بخشی فقط برای رسیدن مقاله به تعداد کلمه موردنظر وجود دارد، احتمالاً ارزش اطلاعاتی چندانی ندارد.
همه این تحلیلها نباید باعث شوند جملهای مثل «گوگل رسماً Information Gain را Ranking Factor کرده است» بنویسیم. پتنت وجود یک روش و خانوادهای از پیادهسازیهای فنی را نشان میدهد. از سند عمومی نمیتوان فهمید این روش امروز در چه محصولاتی، با چه وزنهایی یا اصلاً در Ranking عمومی وب استفاده میشود.
حتی خود عنوان و Claimها Contextهای مختلفی از Search Interface تا Automated Assistant را پوشش میدهند.
رویکرد حرفهای این است که بین «آنچه پتنت میگوید» و «درس استراتژیکی که از آن میگیریم» مرز بگذاریم.
پتنت میگوید میتوان سند جدید را براساس اطلاعات تازه نسبت به اسناد قبلاً دیدهشده امتیازدهی کرد. درس سئو این است که تولید محتوای کمتکرار و واقعاً افزاینده، فارغ از الگوریتم، تجربه کاربری و تمایز بهتری ایجاد میکند.
قبل از شروع هر مقاله، بهجای سؤال «رقبا چه Headingهایی دارند؟» این پرسش را اضافه کنید:
«کاربری که بهترین پاسخهای موجود را خوانده، هنوز چه چیزی نمیداند؟»
اگر پاسخ روشنی نداریم، احتمالاً هنوز تحقیق محتوا تمام نشده است.
ممکن است جواب یک عدد باشد، یک تجربه باشد، توضیح یک Edge Case باشد، یک مقایسه تصمیممحور باشد یا حتی پذیرش اینکه در بعضی شرایط پاسخ قطعی وجود ندارد.
همین چیزها هستند که صفحه را از Summary عمومی جدا میکنند.
پتنت Contextual Estimation of Link Information Gain یک تفاوت مهم را برجسته میکند: Information Gain میتواند Contextual باشد. سند جدید فقط براساس اطلاعات درونی خودش ارزیابی نمیشود؛ ارزش آن میتواند به مقدار اطلاعات تازهای وابسته باشد که نسبت به چیزی که قبلاً به همان کاربر ارائه شده اضافه میکند.
در توضیحات پتنت حتی با مصرفشدن اسناد جدید، Context کاربر تغییر میکند و امتیاز اسناد باقیمانده میتواند دوباره محاسبه شود. بنابراین همان محتوا در مراحل مختلف Journey الزاماً ارزش افزوده یکسانی ندارد.
این پتنت سند اثبات الگوریتم فعلی Google Search نیست و نباید آن را به قانون رتبهبندی تبدیل کرد. اما برای تیم محتوا یک اصل بسیار قدرتمند ارائه میدهد:
جامعبودن زمانی ارزشمند است که علاوه بر پوشش اطلاعات ضروری، فهم کاربر را از نقطهای که اکنون در آن قرار دارد جلوتر ببرد.
اگر قرار است یک معیار ساده از این بحث وارد Workflow محتوا کنیم، شاید همین سؤال کافی باشد:
بعد از چیزهایی که کاربر احتمالاً قبلاً دیده است، این صفحه دقیقاً چه چیزی به او یاد میدهد که هنوز نمیدانست؟
برگرفته شده از تحقیقات همکار محترم؛ استاد شهرام رهبری عزیز.
تهیه شده توسط تیم تخصصی سئو سید احسان خسروی (مدیر، متخصص و مشاور استراتژیک سئو)

