
وقتی از بهینهسازی محتوا برای هوش مصنوعی حرف میزنیم، معمولاً خیلی سریع سراغ موضوعاتی مثل کیفیت محتوا، اعتبار برند، ساختار پاسخ، منابع قابل استناد، نشانههای تخصص و مفهوم GEO میرویم. این بحثها مهماند، اما پیش از همه آنها یک سؤال بنیادی وجود دارد: مدل هوش مصنوعی، وقتی لازم است اطلاعات تازهای از اینترنت پیدا کند، اصلاً در کدام بخش وب جستوجو میکند؟
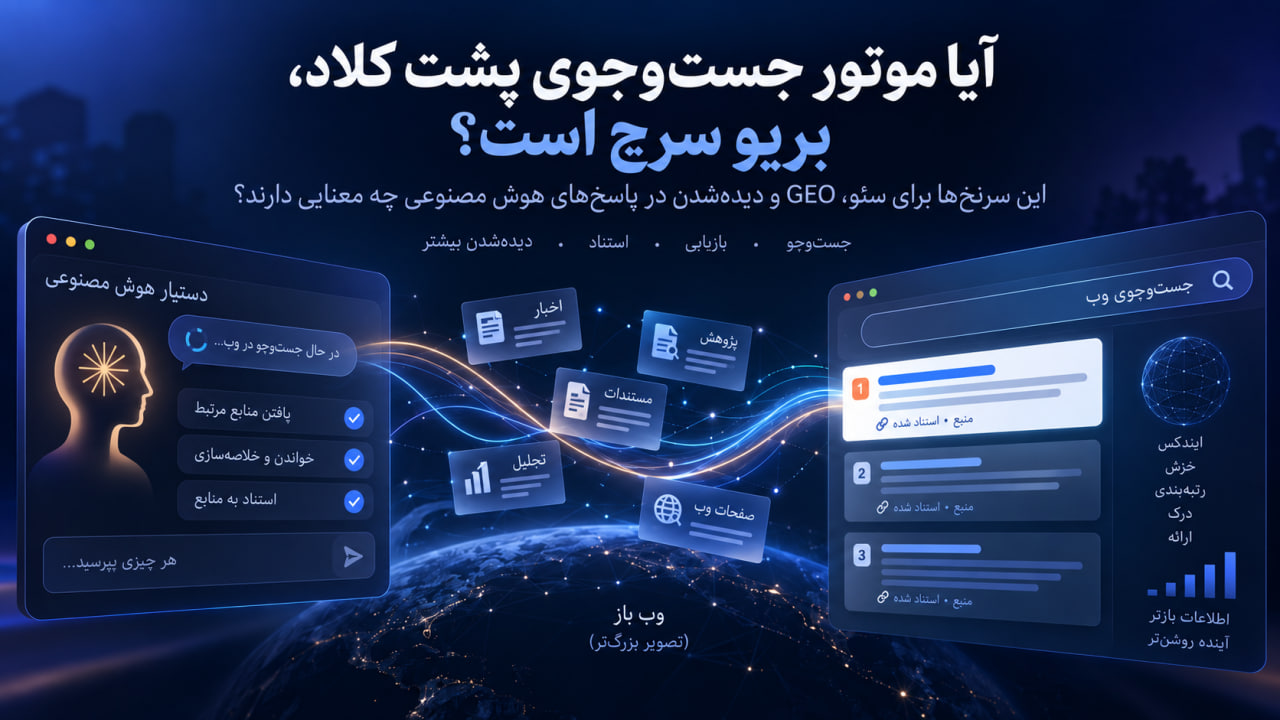
این سؤال شاید در ظاهر فنی باشد، اما برای سئوکارها اهمیت مستقیمی دارد. اگر یک دستیار هوش مصنوعی برای پیدا کردن منابع وب از موتور جستوجوی مشخصی استفاده کند، حضور یک سایت در ایندکس همان موتور میتواند بخشی از زنجیره دیدهشدن در پاسخهای هوش مصنوعی باشد. یعنی ممکن است صفحهای در گوگل وضعیت خوبی داشته باشد، اما اگر در ایندکس دیگری که مدل از آن استفاده میکند حضور نداشته باشد، مسیر رسیدن آن صفحه به پاسخ مدل محدودتر شود.
ماجرای ارتباط کلاد و Brave Search نمونه جالبی از همین موضوع است. مجموعهای از شواهد که در مارس ۲۰۲۵ کنار هم قرار گرفتند، نشان میدهند Brave Search نقش مستقیمی در قابلیت جستوجوی وب کلاد داشته است. این شواهد هنوز مجوز نمیدهند که با قطعیت بگوییم «تمام جستوجوی وب کلاد همیشه فقط از بریو انجام میشود»، اما بهاندازهای قوی هستند که متخصصان سئو و GEO آن را جدی بگیرند.
آنتروپیک در ۲۰ مارس ۲۰۲۵ قابلیت جستوجوی وب کلاد را معرفی کرد. تا پیش از آن، یکی از محدودیتهای مهم کلاد در مقایسه با بعضی رقبای خود این بود که پاسخهایش الزاماً به اطلاعات زنده وب متصل نبودند. قابلیت جدید این امکان را فراهم کرد که مدل هنگام نیاز به اطلاعات تازه در اینترنت جستوجو کند و منابع مورد استفاده را نیز در پاسخ نمایش دهد.
اگر فقط اطلاعیه رسمی روز ۲۰ مارس را میدیدیم، شاید نکته چندان عجیبی وجود نداشت. مدل دیگری به مجموعه ابزارهای جستوجومحور بازار اضافه شده بود. اما یک روز قبل، یعنی در ۱۹ مارس، آنتروپیک فهرست پردازشگران فرعی خود را تغییر داده و Brave Search را به آن اضافه کرده بود.
همین همزمانی اولین سرنخ بود. چرا یک شرکت درست یک روز پیش از معرفی قابلیت جستوجوی وب، یک موتور جستوجوی مستقل را به فهرست سرویسدهندگان خود اضافه میکند؟ پاسخ بدیهی نیست، اما حدس درباره ارتباط این دو اتفاق کاملاً منطقی بود.
سایمون ویلیسون این سرنخ را دنبال کرد و نتیجه بررسی او، احتمال نقش بریو را بسیار جدیتر کرد.
ویلیسون از کلاد خواست درباره پلیکانها حقایق جالبی در وب پیدا کند. کلاد جستوجویی انجام داد و برای پاسخ خود ۱۰ منبع ارائه کرد. او سپس همان جستوجو را در Brave Search انجام داد و گزارش کرد که ۱۰ منبعی که کلاد انتخاب کرده بود، دقیقاً با ۱۰ نتیجه اول بریو مطابقت داشتند.
اگر فقط همین آزمایش وجود داشت، باز هم باید محتاط میبودیم. دو موتور یا سامانه بازیابی میتوانند برای یک پرسش ساده نتایج بسیار مشابهی پیدا کنند. اما موضوع به اینجا ختم نشد.
ویلیسون توانست تعریف تابع جستوجوی وب کلاد را بررسی کند. در ساختار پارامترهای این تابع، عنوان BraveSearchParams دیده میشد. یعنی نام Brave نه فقط در یک فهرست قراردادی، بلکه در ساختار فنی مرتبط با جستوجوی وب هم ظاهر شده بود.
وقتی این سه نشانه را کنار هم میگذاریم، تصویر روشنتر میشود: اضافهشدن Brave Search درست یک روز قبل از عرضه قابلیت، تطابق نتایج در آزمایش مستقل و ظاهرشدن نام Brave در تعریف پارامتر ابزار جستوجو.
عبارت دقیقتر این است که شواهد بسیار قوی از استفاده کلاد از Brave Search در قابلیت جستوجوی وب وجود دارد.
عبارت نادقیقتر این است که «آنتروپیک رسماً اعلام کرده تمام جستوجوی کلاد فقط از بریو استفاده میکند». چنین اعلام رسمی عمومیای در منابعی که بررسی کردم وجود ندارد و نباید نتیجه را بیشتر از شواهد جلو ببریم.
برای کسی که فقط آمار سهم بازار موتورهای جستوجو را میبیند، شاید Brave Search در اولویت اصلی قرار نگیرد. گوگل از نظر استفاده مستقیم کاربران در بسیاری از بازارها بسیار بزرگتر است و طبیعی است بودجه و تمرکز سئو عمدتاً به آن اختصاص پیدا کند.
فرض کنید یک موتور جستوجو بهصورت مستقیم تنها بخش کوچکی از کاربران را در اختیار دارد، اما یک دستیار هوش مصنوعی محبوب از همان موتور برای بازیابی اطلاعات استفاده میکند. در این حالت، نتایج آن موتور دیگر فقط به کاربران مستقیم خودش محدود نیستند؛ بخشی از آنها میتوانند از طریق یک واسطه هوش مصنوعی در اختیار کاربران بیشتری قرار بگیرند.
ممکن است میلیونها کاربر هرگز وارد Brave Search نشوند، اما اگر از کلاد برای جستوجوی وب استفاده کنند، بخشی از اطلاعاتی که میبینند از مسیری عبور کرده باشد که بریو در آن نقش دارد.
برای یک متخصص SEO، این موضوع باید دستکم یک سؤال ایجاد کند: آیا صفحات مهم سایت من در ایندکس بریو قابل کشف هستند؟
خود بریو تأکید میکند که Brave Search بر پایه ایندکس مستقل خودش فعالیت میکند. این موتور صرفاً یک رابط متفاوت روی نتایج گوگل یا بینگ نیست و صفحات وب را در ایندکس خود نگهداری و از همان مجموعه برای ارائه نتایج استفاده میکند.
این موضوع یک پیام واضح دارد: حضور در گوگل را نباید بهصورت خودکار معادل حضور در بریو دانست.
ممکن است صفحهای در هر دو موتور ایندکس شود، اما زمان کشف، تازگی نسخه موجود، نحوه رتبهبندی و حتی حضور یا غیبت آن در نتایج متفاوت باشد. اگر سامانه دیگری از ایندکس بریو برای بازیابی اطلاعات استفاده کند، همین تفاوت میتواند اهمیت پیدا کند.
برای مثال، تصور کنید یک سایت پژوهشی گزارش اختصاصی و مهمی منتشر کرده است. گوگل آن را خیلی سریع پیدا میکند، اما نسخه بریو هنوز صفحه را کشف نکرده یا نسخه قدیمی آن را دارد. اگر مدل هوش مصنوعی در همان زمان از بریو برای پاسخدادن استفاده کند، ممکن است گزارش جدید در مجموعه منابع قابل بازیابی آن حضور نداشته باشد.
این سناریو الزاماً به معنی رفتار واقعی در تکتک جستوجوهای کلاد نیست، اما از نظر معماری اطلاعات کاملاً قابل تصور است و نشان میدهد چرا ایندکسهای مختلف اهمیت پیدا میکنند.
اگر تصمیم بگیریم وضعیت سایت را در گوگل بررسی کنیم، مسیر تقریباً روشن است. Search Console را باز میکنیم، URL را بررسی میکنیم، وضعیت ایندکس را میبینیم، نقشه سایت داریم و داده عملکرد هم در اختیارمان قرار میگیرد.
در Brave Search چنین داشبورد جامعی وجود ندارد. پاسخهایی که در جامعه رسمی بریو در سال ۲۰۲۶ منتشر شدهاند نیز نشان میدهند ابزار سنتی وبمستری مشابه گوگل همچنان ارائه نشده است.
آنچه بریو در اختیار سایتها گذاشته بسیار سادهتر است: یک صفحه برای ارسال URL. صفحه فعلی را میتوان از این مسیر باز کرد: ارسال URL به Brave Search
اما همینجا باید تفاوت را جدی بگیریم. این ابزار Search Console نیست. قرار نیست بعد از واردکردن آدرس به شما گزارش بدهد چند بار در نتایج نمایش گرفتهاید، برای چه کلماتی دیده شدهاید یا چرا صفحهای ایندکس نشده است. حتی ماهیت آن بیشتر به درخواست بازخوانی یک URL نزدیک است تا یک سامانه کامل مدیریت سایت.
در نتیجه، پایش وضعیت بریو در حال حاضر تا حد زیادی دستی است.
آیا ارسال URL به بریو میتواند Citation کلاد را تضمین کند؟
نه.
این یکی از مهمترین جاهایی است که نباید میان چند مرحله مختلف ارتباط مستقیم بسازیم.
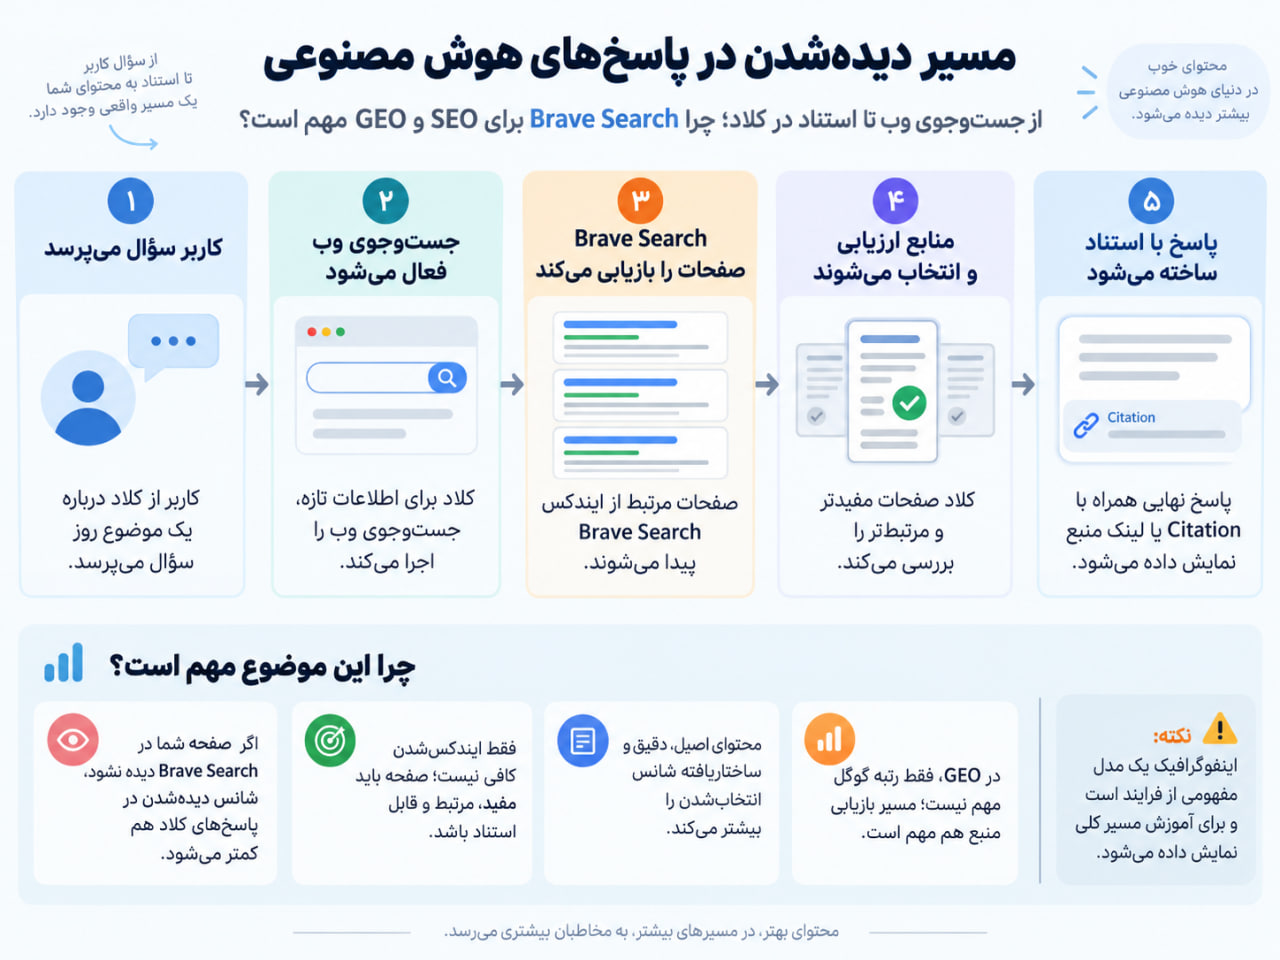
ارسال URL ممکن است به موتور جستوجو کمک کند از وجود یا تغییر یک صفحه آگاه شود. اگر صفحه ایندکس شود، تازه وارد مجموعه بزرگتری از اسناد قابل جستوجو میشود. بعد باید برای یک پرسش مرتبط در میان نتایج مناسب قرار بگیرد. سپس سیستم کلاد باید آن نتیجه را دریافت کند. مدل باید محتوای آن را مرتبط و قابل استفاده بداند و در نهایت ممکن است تصمیم بگیرد به آن استناد کند.
یعنی زنجیره تقریباً این شکل را دارد:
کشف صفحه ← ایندکسشدن ← بازیابی برای جستوجوی مرتبط ← انتخاب توسط سیستم ← استفاده در پاسخ ← احتمال Citation
ثبت URL فقط یکی از مراحل ابتدایی این زنجیره است.
اگر محتوای صفحه ضعیف، تکراری یا نامرتبط باشد، ارسال آن به ده موتور جستوجو هم مشکل اصلی را حل نمیکند.
GEO گاهی بیش از حد به نوشتن متنهایی خلاصه، جدولهای مرتب یا تعریفهای مستقیم تقلیل داده میشود. این کارها ممکن است در بعضی شرایط مفید باشند، اما لایه فنی قابل کشف بودن را نباید فراموش کرد.
یک مدل نمیتواند از صفحهای استفاده کند که در مسیر بازیابیاش وجود ندارد.
به همین دلیل، یکی از بخشهای GEO باید شناخت زنجیره بازیابی باشد. برای هر موتور یا دستیار مهم باید تا حد امکان بفهمیم اطلاعات تازه وب را از چه منابعی پیدا میکند. ممکن است بعضیها ایندکس خودشان را داشته باشند، بعضی از موتورهای جستوجو استفاده کنند و برخی چند منبع را با هم ترکیب کنند.
این موضوع هنوز حوزهای در حال تغییر است و معماری شرکتها میتواند در طول زمان عوض شود. بنابراین هدف نباید ساخت یک «فرمول ثابت GEO» باشد. هدف باید پایش مسیرهای کشف باشد.
سادهترین راه، جستوجوی مستقیم است. چند URL کلیدی سایتتان را انتخاب کنید و ببینید آیا بریو آنها را میشناسد. علاوه بر URL دقیق، نام برند همراه با موضوع صفحه و چند عبارت اصلی را هم جستوجو کنید.
اگر سایت بزرگ است، لازم نیست هزاران صفحه را دستی بررسی کنید. میتوانید از نمونهگیری استفاده کنید. مثلاً چند صفحه از این گروهها را انتخاب کنید: صفحه اصلی، صفحات خدمات اصلی، مقالات مرجع، صفحات تازه، صفحات قدیمی بهروزشده و محتوای دادهمحور یا تحقیقاتی.
اگر متوجه شدید صفحات مهم بهطور مداوم غایباند، ارزش دارد موضوع را جدیتر بررسی کنید.
هدف این بررسی ایجاد وسواس روی «رتبه بریو» نیست. هدف فهمیدن این است که آیا محتوای کلیدی شما در ایندکسی که احتمالاً در زنجیره بازیابی کلاد نقش دارد، حضور قابل قبولی دارد یا نه.
بعد از حل مرحله کشف، تازه سؤال اصلی محتوا شروع میشود. چرا باید مدل از صفحه شما استفاده کند؟
در بسیاری از پرسشها، مدل دهها یا صدها منبع بالقوه دارد. صرف ایندکسشدن یک مزیت رقابتی محسوب نمیشود. صفحه باید چیزی ارائه کند که برای ساخت پاسخ مفید باشد.
داده اختصاصی یکی از بهترین مثالهاست. اگر آماری را خودتان جمعآوری کردهاید، مدل برای نقل همان داده دلیل بیشتری برای رجوع به منبع اصلی دارد. تعریفهای دقیق، پژوهش اولیه، تجربه واقعی، مقایسههای روشن، اطلاعات بهروز و نقلقول متخصص نیز میتوانند ارزش منبع را بالا ببرند.
در مقابل، مقالهای که فقط ۱۰ صفحه دیگر را بازنویسی کرده، حتی اگر از نظر فنی عالی ایندکس شود، چیز منحصربهفردی برای ارائه ندارد.
اینجاست که SEO و GEO دوباره به هم میرسند. هدف نهایی همچنان تولید صفحهای است که ارزش واقعی دارد.
اگر میخواهیم خودمان به منبعی تبدیل شویم که سیستمهای هوش مصنوعی آن را قابل استناد بدانند، باید خودمان هم استاندارد بالایی در ارجاعدادن داشته باشیم.
صفحاتی که درباره خبر یا یافته دیگران مینویسند اما منبع اصلی را پنهان میکنند، بخشی از قابلیت بررسی و اعتماد را از بین میبرند. در ماجرای فعلی، منبع اصلی درباره عرضه Web Search اطلاعیه آنتروپیک است و آزمایش فنی مربوط به سایمون ویلیسون.
اگر مقالهای این اتفاق را تحلیل میکند، بهتر است میان «آنچه آنتروپیک رسماً گفته» و «آنچه ویلیسون از آزمایش خود نتیجه گرفته» تفاوت قائل شود.
همین دقت میتواند محتوای ما را برای انسان و ماشین قابل اعتمادتر کند.
آیا باید کل محتوای قدیمی را برای بریو ارسال کنیم؟
احتمالاً نه.
اگر یک سایت چند هزار صفحه دارد، ارسال دستی همه URLها کار منطقیای نیست و شواهدی هم نداریم که چنین کاری بهترین استفاده از زمان باشد.
بهتر است صفحات باارزش را اولویتبندی کنیم: صفحات مرجع، محتوای اختصاصی، صفحات پولساز، موضوعاتی که میخواهیم برند در آنها بهعنوان متخصص شناخته شود و محتواهایی که احتمال استناد بالاتری دارند.
سپس میتوان وضعیت این صفحات را در بریو بررسی کرد و برای موارد غایب یا بهروزشده از ابزار Submit URL استفاده کرد.
این رویکرد هدفمند بسیار منطقیتر از تبدیل مسئله به یک پروژه بزرگ «ثبت تمام URLها» است.
فعلاً نمیدانیم.
آزمایش ویلیسون نشان داد در نمونهای که بررسی کرد، منابع کلاد با ۱۰ نتیجه اول بریو مطابقت داشتهاند. این یافته جذاب است، اما یک آزمایش برای ساخت قانون عمومی کافی نیست.
ممکن است کلاد در پرسشهای دیگر بخشی از نتایج را حذف کند، صفحات دیگری را انتخاب کند، چند جستوجوی مختلف انجام دهد یا پس از دریافت نتایج، رتبهبندی متفاوتی برای انتخاب منابع داشته باشد.
برای پاسخ دقیق به این سؤال، به آزمایشهای گستردهتر در موضوعات، زبانها، کشورها و زمانهای مختلف نیاز داریم.
بنابراین بهتر است از گزارههایی مانند «برای Citation کلاد باید رتبه اول بریو باشید» دوری کنیم.
چیزی که فعلاً میتوان گفت این است که حضور مناسب در بریو احتمالاً یک لایه از قابلیت کشف است و ارزش بررسی دارد.
این حوزه یکی از جاهایی است که تیمهای SEO میتوانند بهجای تکرار نظریهها، داده واقعی تولید کنند.
میتوان مجموعهای از ۱۰۰ پرسش در یک صنعت انتخاب کرد، نتایج Brave Search را ثبت کرد و سپس همان پرسشها را با Web Search کلاد اجرا کرد. بعد میتوان میزان همپوشانی دامنهها، ترتیب نتایج، Citationها و تفاوتها را اندازه گرفت.
چنین آزمایشی اگر در چند دوره زمانی تکرار شود، میتواند اطلاعات بسیار ارزشمندی درباره رابطه واقعی بریو و کلاد ارائه کند.
همچنین میتوان بررسی کرد که آیا صفحات تازه ارسالشده به بریو بعد از ایندکسشدن در Citationهای کلاد ظاهر میشوند یا خیر.
البته متغیرهای زیادی وجود دارند و نمیتوان از یک تغییر نتیجه قطعی گرفت، اما همین روش دادهمحور بسیار بهتر از حدسهای بدون آزمایش است.
در سالهای گذشته معمولاً نقشه موتورهای جستوجو ساده بود. برای اکثر پروژهها گوگل اولویت اصلی بود، بعد شاید بینگ و بسته به بازار چند سرویس دیگر بررسی میشدند.
حالا یک نقشه دوم هم نیاز داریم: موتورهای بازیابی پشت ابزارهای هوش مصنوعی.
کلاد چه استفاده میکند؟ ابزارهای دیگر برای وب زنده از کجا داده میگیرند؟ آیا از موتور جستوجو استفاده میکنند یا ایندکس اختصاصی دارند؟ آیا نتایجشان از یک ارائهدهنده ثابت میآید یا چند سرویس را با هم ترکیب میکنند؟
این نقشه ممکن است دائماً تغییر کند، اما شناخت آن به ما کمک میکند بفهمیم برند برای حضور در جستوجوی هوش مصنوعی باید کجا قابل کشف باشد.
اگر Brave Search پنج درصد یا حتی کمتر از جستوجوی مستقیم بازار را داشته باشد، ممکن است از نگاه سنتی بگوییم اولویت پایینی دارد. اما اگر یک سرویس هوش مصنوعی بزرگ از آن بهعنوان زیرساخت بازیابی استفاده کند، اثر غیرمستقیم آن میتواند بسیار بزرگتر از سهم مستقیم باشد.
این همان اتفاقی است که پلتفرمهای زیرساختی در بسیاری از صنایع ایجاد میکنند. کاربر نهایی ممکن است نام سرویس را نشنود، اما سرویس در پشت دهها محصول دیگر حضور داشته باشد.
برای SEO این یعنی ارزیابی اهمیت یک موتور فقط بر اساس کاربران مستقیم شاید دیگر کافی نباشد.
باید پرسید چه سرویسهایی به آن متصلاند.
این اتفاق برای روابط عمومی دیجیتال هم مهم است
موضوع فقط صفحات سایت خودمان نیست. اگر Brave Search منبع بازیابی باشد، حضور برند در سایتهای دیگری که در ایندکس بریو خوب دیده میشوند هم میتواند اهمیت پیدا کند.
فرض کنید کلاد درباره بهترین شرکتهای یک حوزه جستوجو میکند. ممکن است به مقالههای رسانهای، فهرستهای تخصصی، انجمنها یا گزارشهای مستقل برسد. حتی اگر صفحه برند شما مستقیماً Citation نشود، حضور نامتان در این منابع میتواند روی اطلاعاتی که مدل جمعآوری میکند اثر بگذارد.
اینجا Digital PR و GEO به هم نزدیک میشوند.
هدف فقط گرفتن بکلینک نیست؛ هدف حضور معتبر برند در اکوسیستم اطلاعاتی است که موتورهای جستوجو و مدلهای هوش مصنوعی از آن استفاده میکنند.
در فضای هوش مصنوعی، اخبار و آزمایشهای کوچک خیلی سریع تبدیل به «ترفند قطعی» میشوند.
یکی میگوید فلان مدل از بریو استفاده میکند و چند روز بعد مقالههایی منتشر میشوند با عنوان «۱۰ تکنیک قطعی برای رتبه یک کلاد در Brave Search».
این دقیقاً همان جایی است که باید محتاط باشیم.
شواهد فعلی ارزشمندند و برای اقدام اولیه کافیاند: Brave Search را بررسی کنید، ایندکس صفحات مهم را بسنجید و موضوع را در آزمایشهای GEO خود وارد کنید.
اما این شواهد هنوز برای ساختن فرمولی قطعی درباره Citation یا رتبهبندی کلاد کافی نیستند.
تفکیک میان این دو سطح از اطمینان نشانه تحلیل حرفهای است.
ماجرای Brave Search و کلاد یک داستان کوچک فنی نیست. این ماجرا نمونهای از تغییری بزرگتر در معماری وب است.
کاربر دیگر همیشه مستقیماً با موتور جستوجویی که اطلاعات را بازیابی میکند تعامل ندارد. ممکن است کاربر داخل یک دستیار هوش مصنوعی باشد و موتور جستوجو پشت صحنه کار کند.
برای صاحبان سایت، این یعنی مسیر دیدهشدن پیچیدهتر شده است.
همچنان باید برای کاربران محتوای خوب بسازیم. همچنان باید سایت قابل خزش و ایندکس باشد. همچنان اعتبار، تخصص، داده دستاول و ساختار فنی اهمیت دارند.
اما حالا لازم است یک سؤال دیگر نیز بپرسیم: آیا محتوای ما در ایندکسهایی که دستیارهای هوش مصنوعی برای جستوجوی وب استفاده میکنند قابل پیدا کردن است؟
در مورد کلاد، شواهد Brave Search را به یکی از پاسخهای جدی این سؤال تبدیل میکنند.
شاید لازم نباشد فردا تمام استراتژی SEO را عوض کنیم. اما اضافهکردن Brave Search به فهرست بررسیهای دورهای، مخصوصاً برای صفحات مرجع و محتواهایی که انتظار داریم در پاسخهای هوش مصنوعی به آنها استناد شود، اقدام منطقی و کمهزینهای است.
در دوره جدید، سئو فقط رقابت بر سر یک صفحه نتایج نیست. بخشی از بازی این است که بفهمیم چه کسی اطلاعات را پیدا میکند، از کجا پیدا میکند و چگونه آن را به کاربر بعدی منتقل میکند.
و همین موضوع شاید Brave Search را از یک موتور جستوجوی فرعی به بخشی مهمتر از نقشه GEO تبدیل کند.
تهیه شده توسط تیم تخصصی سئو سید احسان خسروی (مدیر، متخصص و مشاور استراتژیک سئو)

