
یکی از رایجترین سادهسازیها در تحلیل بکلینک این است که ارزش لینک را تقریباً به ویژگیهای صفحه و دامنه مبدأ تقلیل دهیم. اگر دو سایت از یک مقاله واحد لینک دریافت کنند، ممکن است در نگاه نخست تصور کنیم هر دو لینک از «قدرت» یکسانی برخوردارند؛ زیرا URL مبدأ، اعتبار صفحه و دامنه لینکدهنده یکسان است. این دیدگاه برای ساخت یک مدل ساده قابل فهم است، اما یکی از پتنتهای قدیمی گوگل نشان میدهد حداقل در سطح طراحی سیستمهای رتبهبندی، مسئله میتواند بسیار پیچیدهتر باشد.
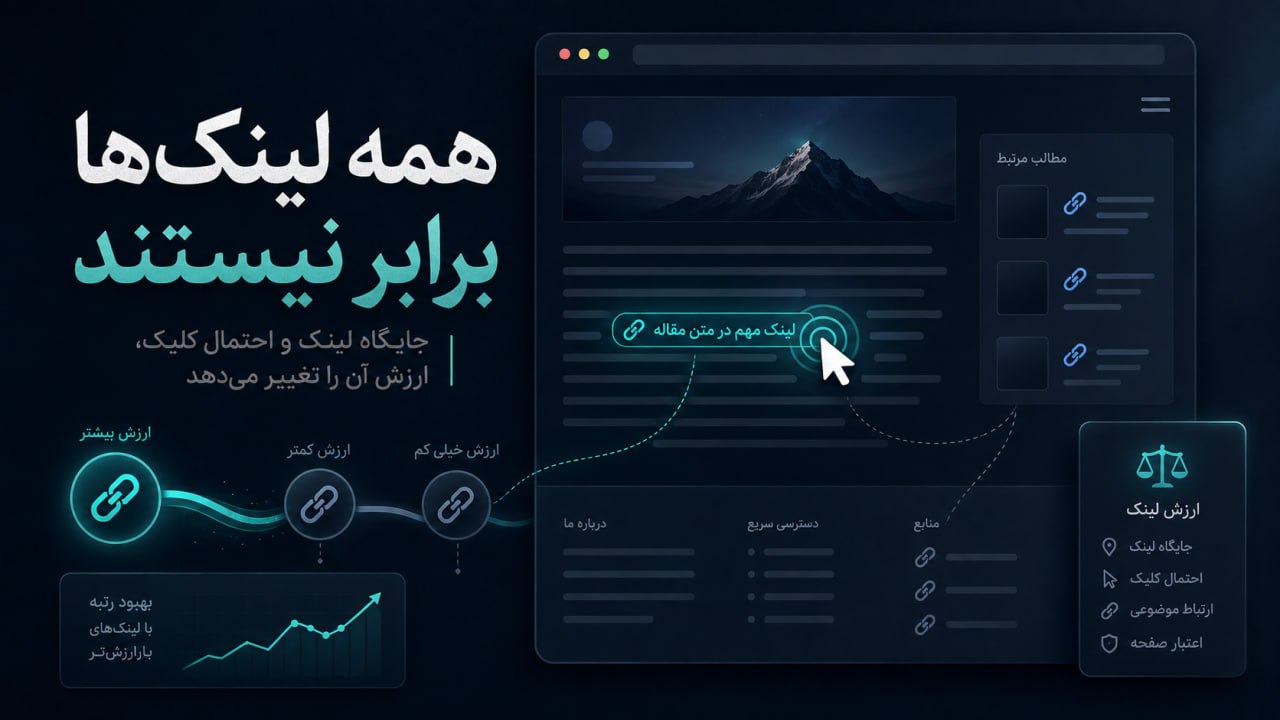
پتنت US7716225B1 با عنوان Ranking documents based on user behavior and/or feature data در ۱۷ ژوئن ۲۰۰۴ ثبت و در ۱۱ مه ۲۰۱۰ اعطا شده است. نام Jeffrey A. Dean، Corin Anderson و Alexis Battle بهعنوان مخترعان آن ثبت شده و Google LLC نیز دارنده آن است. این پتنت مدلی را شرح میدهد که بعدها در ادبیات سئو بیشتر با عنوان «Reasonable Surfer» شناخته شد. ایده اصلی بسیار ساده است: همه لینکهای موجود در یک صفحه به یک اندازه احتمال دنبالشدن ندارند و بنابراین میتوان بهجای تقسیم یکسان ارزش میان تمام لینکها، وزن متفاوتی برای آنها در نظر گرفت.
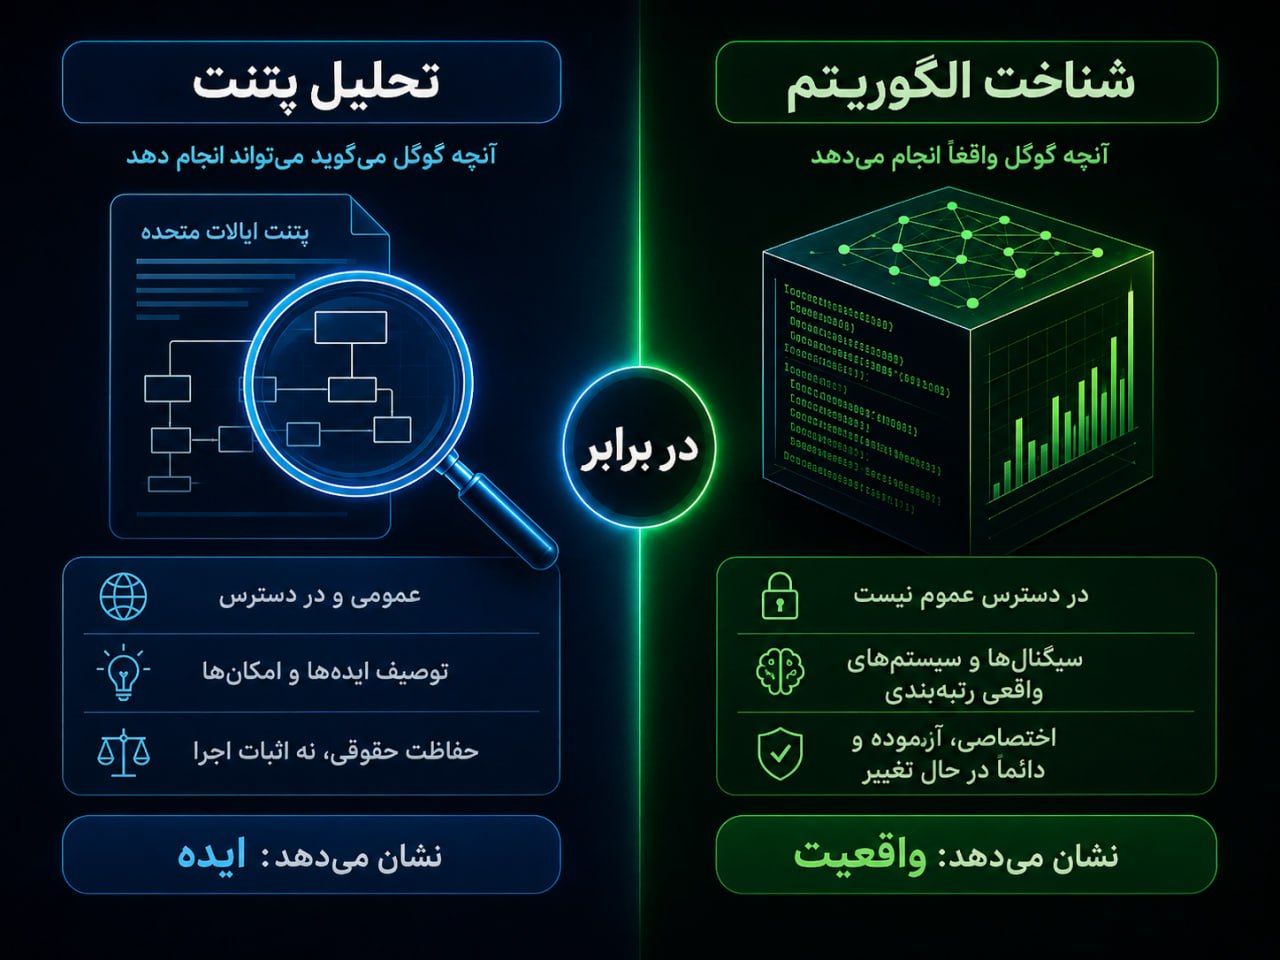
این سند بهخودیخود ثابت نمیکند که Google Search امروز دقیقاً همین الگوریتم، همین Featureها یا همین Ruleها را با همان وزنها اجرا میکند. پتنتها باید بهعنوان اسناد طراحی و امکان فنی خوانده شوند، نه دفترچه راهنمای الگوریتم زنده گوگل. بااینحال، مطالعه این پتنت برای متخصص سئو ارزش زیادی دارد، زیرا نشان میدهد کیفیت لینک را میتوان بسیار فراتر از دو متغیر «دامنه لینکدهنده» و «انکرتکست» مدلسازی کرد.
برای درک Reasonable Surfer ابتدا باید مدل سادهتر را تصور کنیم. در نسخه بسیار سادهشده PageRank، میتوان کاربری فرضی را در نظر گرفت که در وب حرکت میکند و وقتی وارد صفحهای میشود یکی از لینکهای موجود را دنبال میکند. اگر تمام لینکهای یک صفحه شانس یکسانی داشته باشند، سهمی که از صفحه میان لینکها توزیع میشود نیز میتواند بر همین فرض ساده بنا شود.
مشکل این مدل آن است که انسان واقعی چنین رفتاری ندارد. کاربر وارد یک صفحه خبری نمیشود و با احتمال یکسان روی تیتر اصلی خبر، لینک «قوانین و شرایط»، تبلیغ بنری، لینک فوتر و یک لینک نامرتبط کلیک نمیکند. بعضی لینکها در مرکز تجربه کاربر قرار دارند و برخی تقریباً نادیده گرفته میشوند.
خود پتنت دقیقاً همین موضوع را توضیح میدهد و میگوید مدل Reasonable Surfer بازتاب این واقعیت است که همه لینکهای مرتبط با یک سند احتمال یکسانی برای دنبالشدن ندارند. در همان بخش، لینک Terms of Service، تبلیغات بنری و لینکهای نامرتبط با سند بهعنوان نمونههایی با احتمال کمتر برای دنبالشدن مطرح میشوند.
اگر این ایده را از سطح پتنت به تحلیل سئو منتقل کنیم، سؤال ما درباره بکلینک تغییر میکند. دیگر فقط نمیپرسیم «این لینک از کدام صفحه آمده؟» بلکه میپرسیم «این لینک در آن صفحه چه نقشی دارد و یک کاربر منطقی چقدر احتمال دارد واقعاً آن را دنبال کند؟»
بخش جالبتر پتنت توضیح نحوه ساخت مدل است. سیستم میتواند دادههای رفتاری مربوط به لینکهای یک مجموعه سند را بررسی کند. اگر کاربر روی یک لینک مشخص در یک صفحه کلیک کند، انتخاب آن لینک میتواند یک نمونه مثبت برای همان لینک باشد و لینکهای دیگری که انتخاب نشدهاند نمونه منفی در نظر گرفته شوند. اگر کاربر در آن سند هیچ لینکی را انتخاب نکند، همه لینکها میتوانند نمونه منفی ثبت شوند.
سپس برای هر لینک یک Feature Vector ساخته میشود؛ یعنی مجموعهای از ویژگیهایی که خود لینک، صفحه مبدأ و احتمالاً صفحه مقصد را توصیف میکنند. مدل با ترکیب نمونههای مثبت و منفی و این ویژگیها میآموزد چه نوع لینکهایی بیشتر انتخاب میشوند. پتنت حتی روشهایی مانند Naive Bayes، Decision Tree و Logistic Regression را بهعنوان نمونه تکنیکهای قابل استفاده برای ساخت مدل مطرح میکند.
در مرحله بعد، برای لینک بر اساس مدل وزن ساخته میشود. متن پتنت صریحاً میگوید وزن یک لینک میتواند بازتاب احتمال انتخاب آن باشد و سپس رتبه اسناد بر اساس وزن لینکها محاسبه شود. در همان چارچوب، رتبه یک سند میتواند بهصورت احتمال رسیدن یک «کاربر منطقی» به آن پس از دنبالکردن تعدادی لینک تفسیر شود.
این بخش همان چیزی است که برای تحلیل Off-page اهمیت دارد. اگر احتمال انتخاب یک لینک بخشی از وزن آن باشد، دو لینک روی یک URL مبدأ لزوماً نباید سهم برابر داشته باشند.
فهرست Featureهای مطرحشده در پتنت بسیار گسترده است. یکی از آنها اندازه فونت Anchor Text است. جایگاه لینک در صفحه نیز مطرح میشود: آیا لینک داخل فهرست قرار گرفته، در متن جاری است، بالاتر یا پایینتر از اولین Screenful دیده میشود، در بالا یا پایین سند قرار دارد، در فوتر است یا در سایدبار؟
ویژگیهای ظاهری نیز وارد مدل شدهاند. رنگ فونت، حالتهایی مانند Italic یا Gray، حتی همرنگبودن لینک با پسزمینه در مثالها آمدهاند. تعداد کلمات Anchor Text، خود کلمات انکر، میزان تجاریبودن آن، تصویریبودن لینک و نسبت ابعاد تصویر در لینک تصویری نیز در سند ذکر شدهاند.
Context اطراف لینک نیز جالب است. پتنت از چند کلمه قبل و بعد از لینک و Topical Cluster مرتبط با انکرتکست نام میبرد. همچنین بررسی میشود لینک به همان Host یا Domain میرود یا به مقصدی بیرونی، و در بعضی شرایط ویژگیهای ساختاری URL نیز وارد Feature Vector میشوند.
این فهرست به متخصص سئو یادآوری میکند که «لینک داخل متن» فقط یک عبارت عامیانه در بازار رپورتاژ نیست. از نظر مدلسازی رفتار کاربر، محل قرارگیری لینک میتواند اطلاعات واقعی درباره احتمال تعامل با آن ارائه دهد.
اشتباه دیگر این است که تمام ارزش Placement را به خود Anchor محدود کنیم. پتنت ویژگیهای صفحه مبدأ را نیز جداگانه در نظر میگیرد. URL صفحه، سایتی که سند روی آن قرار دارد، تعداد لینکهای صفحه، کلمات موجود در متن، کلمات موجود در Headingها، خوشه موضوعی صفحه و میزان تطابق موضوعی میان صفحه مبدأ و Anchor Text از مثالهای سند هستند.
این قسمت برای رپورتاژ اهمیت زیادی دارد. دو مقاله ممکن است روی یک رسانه و حتی در یک بخش منتشر شوند، اما یکی درباره موضوعی کاملاً نزدیک به سایت مقصد باشد و دیگری صرفاً برای قراردادن لینک نوشته شده باشد. در یک مدل رفتاری، انتظار اینکه کاربر روی لینک مرتبطتر کلیک کند منطقیتر است.
همچنین تعداد کل لینکهای صفحه اهمیت تحلیلی دارد. پتنت تعداد لینکهای موجود در Source Document را بهعنوان یکی از Featureهای ممکن معرفی میکند. این موضوع بهتنهایی ثابت نمیکند هرچه لینک خروجی کمتر باشد وزن هر لینک امروز حتماً بیشتر است؛ اما حداقل نشان میدهد تعداد و معماری لینکهای صفحه میتوانند جزو اطلاعات مورد توجه یک مدل لینکمحور باشند.
در بخش ویژگیهای Target Document، پتنت URL صفحه مقصد، سایت مقصد، همHost یا همDomain بودن مبدأ و مقصد، کلمات موجود در URL و طول URL را بهعنوان Featureهای احتمالی معرفی میکند.
این قسمت از سند مخصوصاً وقتی کنار مثالهای Ruleها قرار میگیرد جذاب میشود. یکی از نمونههای صریح پتنت لینکی است که URL مقصد آن شامل کلمه domainpark است و مدل میتواند برای چنین لینکی احتمال انتخاب پایینتری یاد بگیرد. در مثال دیگری، وجود چند Hyphen در URL مقصد نیز با احتمال انتخاب پایینتر همراه شده است.
باز هم باید تأکید کرد اینها مثالهای داخل پتنتاند، نه قوانین اثباتشده برای Google Search در سال ۲۰۲۶. خود سند بعد از بیان این Ruleها میگوید آنها صرفاً نمونه هستند و مدل میتواند قواعد دیگری نیز تولید کند.
برای همین اگر کسی از این پتنت نتیجه بگیرد «URL دارای سه خط تیره بکلینک ضعیف میگیرد» یا «دامنه .tv برای سئو بد است»، از چیزی که سند واقعاً میگوید فراتر رفته است.
بخش Ruleهای نمونه شاید مشهورترین قسمت سند باشد. پتنت میگوید مدل میتواند Ruleای بسازد که لینکی زیر Heading با عنوان «More Top Stories» در سایت CNN احتمال انتخاب بالایی داشته باشد. در مقابل، لینکی که URL مقصد آن شامل domainpark است میتواند احتمال انتخاب پایینتری داشته باشد.
در ادامه، صفحه مبدأ دارای Popup بهعنوان مثال دیگری برای احتمال انتخاب پایین مطرح میشود. همچنین دامنه مقصد با پسوند .tv و URL مقصد دارای چند Hyphen در نمونههای پتنت احتمال پایینتری دریافت میکنند.
ارزش این مثالها در خود عدد یا Rule نیست. نباید آنها را Checklist قطعی لینکسازی کرد. اهمیتشان در این است که نشان میدهند مدل پیشنهادی میتواند ترکیب عجیبی از ویژگیهای لینک، صفحه مبدأ و مقصد را یاد بگیرد و از آنها برای پیشبینی رفتار کاربر استفاده کند.
درواقع پتنت به ما نمیگوید «همیشه لینک بالا بهتر است»؛ میگوید میتوان مدلی ساخت که از داده رفتاری یاد بگیرد لینکهای دارای چه Featureهایی بیشتر انتخاب میشوند.
نه میتوان چنین ادعایی کرد و نه خود پتنت چنین چیزی را ثابت میکند. ثبت یک اختراع صرفاً نشان میدهد گوگل برای این سازوکار درخواست حفاظت حقوقی کرده و سیستم مورد نظر از نظر فنی توصیف شده است. نمیدانیم Google Search امروز کدام اجزا را اجرا میکند، کدام قسمتها تغییر کردهاند، چه سیستمهای دیگری جای آنها را گرفتهاند یا وزن هر Feature چقدر است.
پتنت US7716225B1 اکنون با وضعیت Expired - Lifetime و تاریخ انقضای ۱۶ مارس ۲۰۲۵ در Google Patents دیده میشود. عضو دیگری از همین خانواده با شماره US10152520B1، با همان تاریخ Prior Art سال ۲۰۰۴، در ۳۰ مارس ۲۰۱۶ ثبت و در ۱۱ دسامبر ۲۰۱۸ اعطا شده است؛ آن مورد نیز اکنون با وضعیت منقضی نمایش داده میشود.
بنابراین ادامه خانواده پتنت تا سال ۲۰۱۸ نشان میدهد این موضوع برای مدت طولانی در مسیر حقوقی و فنی گوگل حضور داشته است، اما این هنوز معادل تأیید اجرای همان مدل در رتبهبندی امروز نیست.
بازار رپورتاژ معمولاً Placement را با چند شاخص ساده قیمتگذاری میکند: قدرت دامنه، ترافیک، تعداد لینک، دائمیبودن مطلب و شاید Follow بودن لینک. Reasonable Surfer یک سؤال دیگر به این مدل اضافه میکند: اگر یک کاربر واقعی این مقاله را بخواند، آیا لینک شما اصلاً برایش قابل توجه و منطقی است؟
لینکی که در پاراگراف مرتبط و درست در نقطهای قرار گرفته که خواننده برای ادامه تحقیق به اطلاعات بیشتری نیاز دارد، از نظر تجربه کاربر با لینکی که بعد از نتیجهگیری و کنار چند لینک تبلیغاتی چسبانده شده یکسان نیست.
این تفاوت فقط درباره «بالا یا پایین صفحه» نیست. Anchor باید با جمله اطراف هماهنگ باشد. مقصد باید ادامه طبیعی موضوع باشد. کاربر باید بتواند بفهمد چرا کلیک روی لینک برایش فایده دارد.
از همین زاویه، یک رپورتاژ خوب نباید فقط میزبان لینک باشد؛ باید Contextی بسازد که لینک در آن منطقی شود.
یکی از Featureهای Source Document در پتنت تعداد لینکهای موجود در صفحه است. این موضوع گاهی در سئو به قاعده بسیار ساده «هرچه لینک خروجی کمتر، Link Juice بیشتر» تبدیل میشود. اما Reasonable Surfer دیدگاه ظریفتری پیشنهاد میدهد.
ممکن است صفحهای ده لینک داشته باشد اما دو لینک آن در مرکز محتوای اصلی و بسیار مرتبط باشند و بقیه Navigation یا لینکهای کماهمیت باشند. اگر همه لینکها وزن یکسان نداشته باشند، صرف شمردن تعداد لینکها برای فهم سهم واقعی هرکدام کافی نیست.
بنابراین تعداد لینک یک متغیر است، نه پاسخ نهایی. Placement، Context و احتمال تعامل باید در کنار آن بررسی شوند.
در بازار لینکسازی، Anchor Text معمولاً از زاویه Exact Match، Partial Match، Brand و Generic بررسی میشود. پتنت نگاه رفتاریتری دارد. تعداد کلمات انکر، خود واژهها، میزان Commerciality، اندازه فونت و حتی Context کلمات قبل و بعد آن میتوانند Feature باشند.
این یعنی Anchor را میتوان بخشی از تجربه خواندن صفحه دید، نه فقط مکانی برای قرار دادن Keyword. عبارت لینکشده باید در جمله طبیعی باشد و به مقصدی برود که انتظار ایجادشده توسط همان عبارت را برآورده کند.
اگر Anchor بیش از حد تبلیغاتی، نامرتبط یا مصنوعی باشد، شاید مسئله اصلی فقط Over-optimization نباشد؛ از منظر انسانی نیز احتمال کلیک و اعتماد کاهش پیدا میکند.
Reasonable Surfer فقط برای بکلینک خارجی جذاب نیست. پتنت لینکهای Same Host و Same Domain را نیز در Featureها مطرح میکند. بنابراین همان منطق را میتوان به طراحی Internal Linking نیز تعمیم داد، البته بهعنوان اصل UX و معماری، نه ادعای قطعی درباره الگوریتم امروز.
در مقالهای طولانی، لینک داخلی مرتبط درست بعد از توضیح یک مفهوم احتمالاً برای کاربر مفیدتر از مجموعهای از لینکهای تصادفی در انتهای صفحه است. لینک دستهبندی در Navigation هدف متفاوتی از Contextual Link در متن دارد.
اگر هدف Internal Linking فقط افزایش تعداد لینک به یک صفحه باشد، ممکن است معماریای ساخته شود که برای خزنده پر از لینک است اما برای کاربر هیچ مسیر معناداری ایجاد نمیکند.
نباید انتظار داشته باشیم بتوانیم وزن Reasonable Surfer گوگل را اندازهگیری کنیم. چنین عددی در دسترس ما نیست. اما میتوان Proxyهای عملی ساخت.
برای لینکهای داخلی میتوان Click-through واقعی را اندازه گرفت. برای رپورتاژها نیز در صورت دسترسی به Analytics یا Tracking مناسب، Referral Traffic میتواند نشان دهد Placement تا چه حد واقعاً کاربر جذب میکند.
حتی وقتی داده کلیک نداریم، میتوان ارزیابی کیفی انجام داد: لینک در متن اصلی است؟ موضوع دو صفحه مرتبط است؟ جمله اطراف لینک دلیل کلیک ایجاد میکند؟ Anchor طبیعی است؟ صفحه شلوغ از لینک تبلیغاتی نیست؟
این معیارها الگوریتم گوگل را بازسازی نمیکنند، اما کیفیت Placement را بهتر از صرف نگاهکردن به یک Metric دامنه توصیف میکنند.
برای ارزیابی یک لینک، صفحه مبدأ را از سه زاویه بررسی کنید. نخست خود لینک: Placement، Anchor، ظاهر و Context. سپس محیط اطراف: موضوع صفحه، کیفیت محتوا، تعداد و نوع لینکهای دیگر و هدف واقعی صفحه. در نهایت مقصد: ارتباط معنایی، کیفیت URL و اینکه آیا مقصد واقعاً وعده Anchor را برآورده میکند.
بعد از این ارزیابی تازه Metricهای سطح دامنه مانند Authority، Traffic و Visibility معنا پیدا میکنند. این شاخصها مفیدند، اما بهتنهایی درباره کیفیت یک Placement مشخص چیزی قطعی نمیگویند.
ممکن است یک سایت بسیار قدرتمند لینکی در بخشی تقریباً نامرئی و نامرتبط بدهد و سایتی کوچکتر لینکی در مقالهای تخصصی با مخاطب دقیق و Context بسیار قوی ایجاد کند. ارزش تجاری و حتی Referral Potential این دو لینک میتواند کاملاً متفاوت باشد.
نباید بگوییم گوگل امروز لینکهای فوتر را بیارزش میکند. نباید ادعا کنیم پسوند .tv سیگنال منفی است. نباید نتیجه بگیریم URL بلند حتماً وزن لینک را کاهش میدهد و نباید Ruleهای نمونه را مستقیماً به Ranking Factors امروزی تبدیل کنیم.
آنچه با اطمینان میتوان گفت این است که پتنت مدلی را توصیف میکند که در آن وزن لینک میتواند براساس احتمال انتخاب آن متفاوت باشد و این احتمال با مجموعه بزرگی از Featureهای لینک، صفحه مبدأ و مقصد پیشبینی میشود.
این تفاوت میان «فهم یک مدل» و «ادعای شناخت الگوریتم زنده» برای استفاده مسئولانه از پتنتها ضروری است.
شاید مهمترین درس Reasonable Surfer برای متخصص سئو همین باشد: لینک را بهصورت یک شیء جدا از صفحه نبینیم. بکلینک همیشه داخل یک محیط قرار دارد؛ با متن، طراحی، Anchor، موقعیت، موضوع و دهها لینک دیگر احاطه شده است.
پتنت US7716225B1 نشان میدهد گوگل حداقل از سال ۲۰۰۴ مدلی را ثبت کرده بود که فرض برابری تمام لینکهای صفحه را کنار میگذاشت و وزن متفاوت لینکها را براساس رفتار کاربر و Featureهای مختلف بررسی میکرد. انتخاب یک لینک میتوانست نمونه مثبت و انتخابنشدن سایر لینکها نمونه منفی باشد و وزن نهایی نیز میتوانست بازتاب احتمال انتخاب باشد.
هیچکدام از اینها اثبات نمیکند سیستم فعلی Search دقیقاً همان است. اما برای کار روزمره نیازی هم نیست از پتنت یک قانون قطعی بسازیم تا درس آن مفید باشد.
وقتی لینک میخریم، رپورتاژ منتشر میکنیم یا معماری Internal Linking میسازیم، سؤال بهتر از «این لینک از چه دامنهای آمده؟» وجود دارد:
اگر یک انسان واقعی این صفحه را بخواند، چقدر احتمال دارد این لینک را ببیند، مرتبط بداند و واقعاً دنبال کند؟
تهیه شده توسط تیم تخصصی سئو سید احسان خسروی (مدیر، متخصص و مشاور استراتژیک سئو)

