
یکی از سادهترین تاکتیکهای بهروزرسانی محتوا در بسیاری از پروژههای سئو این است که مقالهای قدیمی را باز کنیم، تاریخ انتشار یا آخرین بهروزرسانی آن را به امروز تغییر دهیم، چند جمله را اصلاح کنیم و دوباره منتشرش کنیم. از بیرون نیز همهچیز منطقی به نظر میرسد؛ کاربر با تاریخ تازهای مواجه میشود و سیستم مدیریت محتوا صفحه را بهعنوان محتوایی بهروزشده نمایش میدهد. اما سؤال مهمتری وجود دارد: آیا موتور جستوجو نیز تازگی یک صفحه را فقط از همین عدد تشخیص میدهد؟
اسناد Google Content Warehouse که در سال ۲۰۲۴ افشا شدند، تصویر پیچیدهتری ارائه میکنند. وجود چندین فیلد مرتبط با زمان و Freshness نشان میدهد گوگل دستکم در سیستمهای مستندشده، زمان یک سند را صرفاً در قالب یک Timestamp واحد نگهداری نمیکند. Search Engine Land نیز در تحلیل اولیه این اسناد به وجود چند نوع تاریخ، از جمله تاریخ موجود در صفحه، تاریخ قابل استخراج از ساختار و تاریخ استنباطشده از خود محتوا اشاره کرده بود.
این اسناد بهتنهایی وزن دقیق هر سیگنال در الگوریتم فعلی Google Search را مشخص نمیکنند و وجود یک Attribute نیز الزاماً به این معنی نیست که همان فیلد با وزن ثابت روی تمام Queryها اثر مستقیم رتبهبندی دارد. بااینحال، برای استراتژی Content Refresh یک پیام روشن از آنها قابل استخراج است: مفهوم زمان برای گوگل چندبعدیتر از تاریخی است که مدیر سایت بالای مقاله مینویسد.
وقتی انسان به یک مقاله نگاه میکند، معمولاً یک یا دو تاریخ میبیند: تاریخ انتشار و شاید تاریخ آخرین بهروزرسانی. برای سیستم جستوجو، اما نشانههای زمانی میتوانند از مکانهای بیشتری استخراج شوند. متن صفحه ممکن است به سال مشخصی اشاره کند، عنوان حاوی عدد سال باشد، URL دارای پوشه تاریخی باشد، داده ساختاریافته datePublished و dateModified ارائه کند و سایتمپ نیز lastmod داشته باشد.
این تعدد منابع زمانی از قبل هم در مستندات عمومی گوگل قابل مشاهده بود. Matthew Edgar در تحلیل اسناد افشاشده سه نوع تاریخ را برجسته میکند: تاریخ ذکرشده در خود صفحه، syntacticDate که میتواند از URL یا عنوان استخراج شود و semanticDate که از خود محتوای سند استنباط میشود. در کنار این موارد، Structured Data، تگهای متا و lastmod سایتمپ نیز میتوانند تاریخهای دیگری درباره صفحه ارائه کنند.
بنابراین از همان ابتدا میتوان یک اصل عملی تعریف کرد: اگر همه این لایهها داستان زمانی متفاوتی تعریف کنند، نباید انتظار داشته باشیم تغییر ساده یک فیلد CMS تمام مسئله Freshness را حل کند.
یکی از فیلدهای جالب در اسناد افشاشده semanticDate است. توضیح مستقیم مستندات میگوید این مقدار «تاریخ تخمینی محتوای یک سند» است که براساس محتوای سند از طریق Parsing، انکرها و اسناد مرتبط محاسبه میشود. همچنین فیلدی با نام semanticDateInfo وجود دارد که اطلاعاتی از جمله Confidence مربوط به اجزای روز، ماه و سال را نگهداری میکند.
این تعریف برای استراتژی محتوا بسیار مهم است. فرض کنیم مقالهای درباره «هزینه طراحی سایت در سال ۱۴۰۵» منتشر کردهایم، اما متن اصلی تقریباً بدون تغییر از نسخه سال ۱۴۰۳ باقی مانده است. قیمتها مربوط به آن سالاند، چند سرویس قدیمی معرفی شدهاند، آمار بازار از گزارشهای دو سال قبل آمده و مثالهای متن نیز مربوط به شرایط گذشتهاند. از نظر انسان نیز چنین مقالهای واقعاً تازه نیست؛ فقط عنوان و تاریخ آن تازه شدهاند.
وجود semanticDate نشان میدهد دستکم در معماری مستندشده گوگل، خود محتوای سند نیز میتواند برای تخمین زمان آن بررسی شود. بنابراین Freshness Strategy حرفهای باید محتوای حامل زمان را شناسایی کند، نه اینکه فقط Metadata را تغییر دهد.
این موضوع بهخصوص برای حوزههایی مانند قیمت، قوانین، فناوری، سلامت، نرمافزار، بازار مالی، مهاجرت، محصولات و آموزش ابزارها اهمیت بیشتری دارد. اطلاعات در این حوزهها میتوانند ظرف چند ماه واقعاً قدیمی شوند و تغییر تاریخ صفحه بدون تغییر هسته اطلاعات، مسئله کاربر را حل نمیکند.
لایه دیگری که در تحلیل اسناد مطرح شده syntacticDate است. منابع بررسیکننده Leak توضیح میدهند که این نوع تاریخ میتواند از ساختار URL یا عنوان صفحه استخراج شود. برای مثال، وجود /2024/ در URL یا عبارت «راهنمای سال ۲۰۲۴» در Title میتواند یک نشانه زمانی واضح ایجاد کند.
خود مستندات مربوط به QualityTimebasedSyntacticDate نیز فیلدهای قابل توجهی دارند. در کنار خود تاریخ، trustSyntacticDateInRanking دیده میشود که توضیح آن میگوید زمانی تنظیم میشود که سیستم Syntactic Date را با Confidence بالا باور دارد، هرچند آن تاریخ شرایط لازم برای Byline Date را ندارد. فیلدهای دیگری نیز مشخص میکنند آیا تاریخ برای نمایش در Byline مناسب است یا باید در محدودیتهای زمانی استفاده شود.
از این اطلاعات نباید نتیجه گرفت هر URL حاوی سال قدیمی قطعاً در رتبهبندی ضعیفتر خواهد بود. اسناد چنین قانون سادهای ارائه نمیکنند. نکته عملی این است که ساختار URL، عنوان و تاریخ روی صفحه میتوانند سیگنالهای زمانی مستقلی ایجاد کنند.
به همین دلیل استفاده از سال در URL برای محتوای Evergreen تصمیمی است که باید با دقت گرفته شود. اگر مقاله هر سال بهروزرسانی خواهد شد، URL بدون سال معمولاً انعطاف بیشتری برای نگهداری بلندمدت ایجاد میکند؛ درحالیکه Title و محتوای صفحه میتوانند متناسب با دوره جدید تغییر کنند.
شاید مهمترین فیلد این مجموعه برای بحث Refresh، lastSignificantUpdate باشد. در مستندات PerDocData این فیلد صریحاً بهعنوان «آخرین بهروزرسانی معنادار سند» تعریف شده و توضیح داده میشود که مقدار آن از پروتکل quality_timebased.LastSignificantUpdate میآید و توسط LSUSelector از چند سیگنال محاسبه میشود. مقدار نهایی نیز بهصورت Timestamp یونیکس ذخیره میشود.
در مستندات جزئیتر QualityTimebasedLastSignificantUpdate نیز میبینیم که تاریخ از LSU Selector V2 تولید میشود و در صورت نبود سیگنال با دقت بالا، امکان بازگشت به سیگنال قدیمیتر وجود دارد. این ساختار حتی فیلدی برای Source و اطلاعات مربوط به عدم اطمینان تاریخ دارد.
وجود کلمه Significant در نام فیلد از نظر مفهومی بسیار مهم است. همه تغییرات صفحه ارزش زمانی یکسانی ندارند. اصلاح یک غلط تایپی، تغییر فاصله یک پاراگراف، جایگزینی یک تصویر تزئینی یا تغییر یک جمله لزوماً همان معنایی را ندارد که بازنویسی بخشی از مقاله، اضافهشدن یافتههای جدید یا تغییر اساسی اطلاعات دارد.
این تفاوت دقیقاً باید در Workflow تیم محتوا نیز وارد شود. اگر معیار تیم برای «مقاله بهروزرسانی شد» فقط Save شدن دوباره URL باشد، سیستم داخلی سازمان نیز تفاوت میان Refresh واقعی و Cosmetic Update را از دست میدهد.
پاسخ دقیق این نیست که تاریخ صفحه هیچ اهمیتی ندارد. گوگل از مدتها قبل توصیه کرده است صفحات زمانی که واقعاً تغییر معنادار داشتهاند، تاریخ بهروزرسانی واضح داشته باشند. datePublished و dateModified در Structured Data نیز دقیقاً برای تمایز تاریخ انتشار اولیه و آخرین اصلاح در دسترساند. Matthew Edgar نیز اشاره میکند که dateModified معمولاً باید برای تغییر معنادار بهروزرسانی شود، نه برای اصلاح جزئی.
مشکل زمانی است که نقش تاریخ را برعکس کنیم. تاریخ باید گزارشی درباره تغییر محتوا باشد؛ نه ابزاری برای وانمودکردن به تغییر محتوا.
اگر مقاله واقعاً بازبینی شده، منابع جدید اضافه شده، توصیههای منسوخ حذف شده و دادههای قدیمی جایگزین شدهاند، تغییر dateModified منطقی و مفید است. اما اگر تنها تغییر صفحه خود تاریخ باشد، چیزی درباره ارزش واقعی محتوا برای کاربر تغییر نکرده است.
محتوای Evergreen قرار نیست هر چند ماه حذف و از صفر نوشته شود. هدف این است که URL اصلی طی سالها رشد کند، لینک بگیرد و در دورههای مختلف بهروز بماند. بنابراین Refresh بخشی از چرخه طبیعی نگهداری این صفحات است.
اما Refresh Evergreen باید بر مبنای «افت اطلاعات» انجام شود. ممکن است بخشی از مقاله هنوز کاملاً معتبر باشد و بخش دیگر نیاز به بازنویسی داشته باشد. شاید تعریف اصلی یک مفهوم تغییر نکرده، اما ابزارها، مثالها و آمار تغییر کردهاند. در این شرایط بازنویسی کل صفحه نه ضروری است و نه همیشه منطقی.
روش حرفهای این است که اجزای وابسته به زمان را مشخص کنیم. کدام بخشها آمار دارند؟ کدام ادعاها به قوانین فعلی وابستهاند؟ کدام توصیهها با تغییر فناوری منسوخ میشوند؟ کدام لینکهای خارجی دیگر معتبر نیستند؟
در این مدل، Content Refresh تبدیل به Maintenance میشود، نه یک ترفند دورهای برای تغییر تاریخ.
فرض کنید مقالهای با عنوان «بهترین ابزارهای سئو در سال ۱۴۰۳» داریم. دو سال بعد عنوان را به «بهترین ابزارهای سئو در سال ۱۴۰۵» تغییر میدهیم و تاریخ انتشار نیز امروز میشود. اما داخل مقاله هنوز محصولی معرفی شده که دیگر فعال نیست، قیمت اشتراکها متعلق به سال ۱۴۰۳ است، رابط چند نرمافزار عوض شده و بخشی از امکاناتی که مقاله درباره آنها صحبت میکند حذف شدهاند.
از دید کاربر، صفحه تازه نیست. حتی تاریخ جدید میتواند اعتماد را کاهش دهد، زیرا کاربر تصور میکند اطلاعات بررسی شدهاند.
Refresh واقعی در این مثال به معنی بررسی دوباره فهرست ابزارها، حذف موارد از رده خارج، تست گزینههای فعلی، اصلاح قیمتها، بهروزرسانی Screenshotها، اضافهکردن تغییرات دو سال اخیر و بازنگری نتیجهگیری است. حالا تغییر تاریخ معنا دارد، چون پشت آن تغییر اطلاعات وجود دارد.
مهمترین کار، پیدا کردن بخشهایی است که با زمان تغییر میکنند. در یک مقاله تجاری ممکن است قیمت و موجودی باشند؛ در مقاله علمی، یافتههای جدید و مطالعات تازه؛ در محتوای حقوقی، قوانین و آییننامهها؛ در آموزش نرمافزار، رابط کاربری و امکانات جدید.
سپس باید منابع و لینکها بررسی شوند. مقالهای که تاریخ ۱۴۰۵ دارد اما بخش اصلی منابعش به اطلاعات منسوخ متکی است، ممکن است از نظر ظاهری تازه و از نظر محتوایی قدیمی باشد. مثالها و توصیهها نیز اهمیت دارند؛ گاهی عددی تغییر نکرده اما توصیهای که دو سال قبل منطقی بوده امروز دیگر بهترین انتخاب نیست.
در مرحله بعد، باید مشخص شود تغییرات واقعاً بهاندازهای بودهاند که اعلام «بهروزرسانی» برای کاربر معنا داشته باشد. هدف فقط موتور جستوجو نیست. تاریخ تازه یک وعده به خواننده است که صفحه تا آن تاریخ بازبینی شده است.
اگر Refresh واقعی انجام شد، نشانههای زمانی مختلف بهتر است با یکدیگر سازگار باشند. تاریخ قابل مشاهده صفحه، dateModified در Structured Data و lastmod در Sitemap نباید داستانهای کاملاً متفاوتی تعریف کنند.
گوگل درباره lastmod نیز از قبل اعلام کرده است که فقط در صورتی از آن استفاده میکند که بتواند صحت این سیگنال را براساس تغییرات صفحه تأیید کند. این موضوع بار دیگر همان اصل را تقویت میکند: Timestamp بهتنهایی یک ادعاست و محتوا باید آن را پشتیبانی کند.
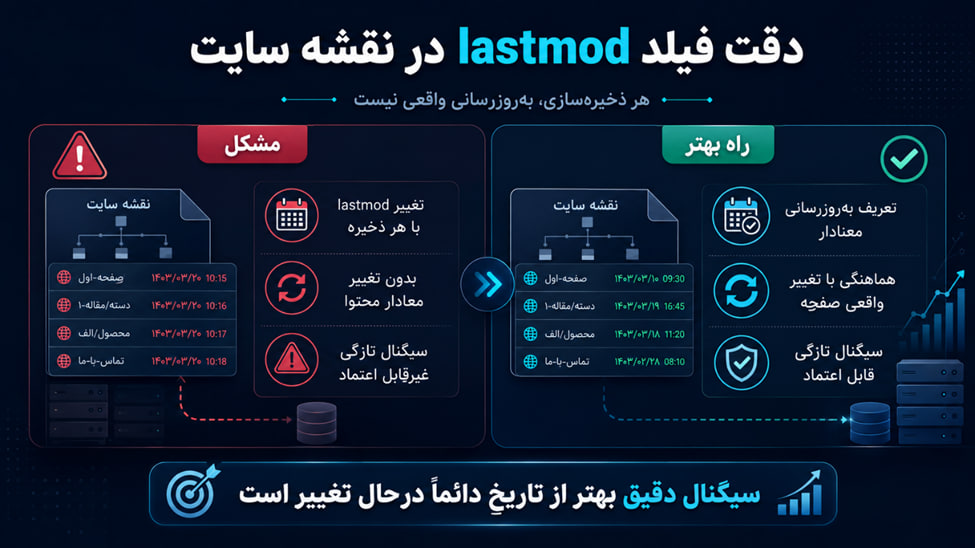
در سایتهای بزرگ بهتر است این فرایند خودکار باشد. اگر CMS تاریخ اصلاح را فقط با تغییر معنادار محتوا تغییر دهد، احتمال تولید سیگنالهای نادرست کمتر میشود. در مقابل، سیستمی که با هر Save ساده dateModified را امروز میکند، اطلاعات زمانی کمکیفیتتری تولید خواهد کرد.
یکی از نکاتی که باید در این بحث حفظ شود این است که هر Query نیاز یکسانی به تازگی ندارد. تعریف «مثلث متساویالساقین» با گذشت چند سال تغییر نمیکند، اما «بهترین گوشی میانرده» یا «قوانین مالیاتی امسال» بهشدت زمانحساساند.
بنابراین استراتژی Refresh نباید براساس سن URL بهتنهایی ساخته شود. مقاله دو ساله درباره مفهومی پایدار ممکن است هنوز کاملاً صحیح باشد، درحالیکه مقاله سهماهه درباره قیمت یا مقررات ممکن است نیاز فوری به اصلاح داشته باشد.
معیار بهتر از «چند ماه از انتشار گذشته؟» این است که بپرسیم «چه مقدار از اطلاعات این صفحه به زمان وابسته است؟»
خیر. این بخش برای تحلیل دقیق ضروری است. مستندات Content Warehouse وجود فیلدها و توضیحات داخلی آنها را نشان میدهند، اما وزن دقیق هر سیگنال، شرایط فعالشدن آن و نقش امروزی آن در تمام سامانههای رتبهبندی را به ما نمیگویند.
حتی Search Engine Land هنگام گزارش Leak تأکید کرد که این اسناد تصویری از نحوه استفاده یا استفاده قبلی گوگل از مجموعهای از دادهها ارائه میکنند و نباید هر Attribute را مستقیماً به یک Ranking Factor ساده تبدیل کرد.
پس ادعای دقیق این نیست که «اگر فقط تاریخ را عوض کنید گوگل حتماً متوجه میشود و رتبه را کم میکند». ادعای قابل دفاعتر این است که گوگل در اسناد داخلی خود چندین سازوکار برای استخراج و نگهداری اطلاعات زمانی داشته و بنابراین نگاهکردن به Freshness بهعنوان یک Timestamp واحد، مدل بسیار سادهای از سیستم است.
یکی از بهترین تغییراتی که یک تیم محتوا میتواند انجام دهد، جداکردن «تاریخ بازبینی» از «تاریخ انتشار» است. مقاله میتواند در سال ۱۴۰۳ منتشر شده باشد و در ۱۴۰۵ بازبینی اساسی شده باشد. نیازی نیست تاریخچه واقعی آن را پاک کنیم.
در CMS نیز بهتر است مشخص باشد چه کسی صفحه را بررسی کرده، چه بخشهایی تغییر کردهاند و علت Refresh چه بوده است. این اطلاعات فقط برای سئو مفید نیست؛ کیفیت تحریریه را نیز افزایش میدهد.
در پروژههای بزرگ میتوان صفحات را براساس میزان وابستگی به زمان دستهبندی کرد. محتوای قیمتمحور شاید هر ماه بازبینی شود، مقاله آموزشی نرمافزار هر سه یا شش ماه و محتوای بنیادی فقط زمانی که داده جدیدی وجود دارد.
در این مدل، Refresh از یک Campaign فصلی خارج میشود و به بخشی از Content Operations تبدیل میشود.
مهمترین نکته اسناد افشاشده برای استراتژی تازگی محتوا این نیست که یک فیلد جادویی جدید پیدا شده است. نکته مهمتر چندلایهبودن مفهوم زمان است. semanticDate میتواند تاریخ را از خود محتوا، انکرها و اسناد مرتبط تخمین بزند. syntacticDate اطلاعات زمانی ساختاری را در نظر میگیرد و برای میزان اعتماد به آن نیز Metadata وجود دارد. lastSignificantUpdate نیز بهجای ثبت هر تغییر ساده، مفهوم آخرین بهروزرسانی معنادار را نگهداری میکند.
این مجموعه به ما یادآوری میکند Refresh محتوا یک عملیات تقویمی نیست؛ یک عملیات اطلاعاتی است.
اگر مقاله دو سال قبل هنوز درباره دادهها، محصولات و شرایط دو سال قبل صحبت میکند، تبدیل تاریخ ۱۴۰۳ به ۱۴۰۵ محتوای آن را به زمان حال نمیآورد. ابتدا واقعیت صفحه باید تغییر کند، سپس Timestamp میتواند آن تغییر را به کاربر و موتور جستوجو گزارش کند.
برای همین شاید بهترین قانون ساده Content Refresh این باشد:
وقتی تنها بخش تازه مقاله، تاریخ بالای آن است، مقاله هنوز تازه نشده است.
تهیه شده توسط تیم تخصصی سئو سید احسان خسروی (مدیر، متخصص و مشاور استراتژیک سئو)

