
ظهور جستوجوی مولد تقریباً همان الگویی را در صنعت سئو ایجاد کرده که در دورههای قبلی نیز دیدهایم: هر بار یک فناوری جدید وارد میشود، خیلی زود مجموعهای از فرمتها، فایلها، ترفندها و لایههای فنی تازه با این وعده مطرح میشوند که «اگر این را اضافه نکنید، موتور جدید شما را نمیفهمد». این بار یکی از پیشنهادهای محبوب، ساخت نسخه Markdown از صفحات سایت برای مدلهای زبانی است؛ نسخهای سادهتر، بدون طراحی پیچیده و ظاهراً آسانتر برای پردازش ماشینی.
از نظر تئوری، ایده جذاب است. اگر صفحه HTML شامل منو، تبلیغ، اسکریپت، طراحی، عناصر تعاملی و صدها خط کد باشد، چرا محتوای اصلی را در قالب یک نسخه تمیز و متنی به مدل زبانی ندهیم؟ شاید ماشین سریعتر بفهمد، هزینه پردازش کمتر شود و احتمال Citation بیشتر شود. مشکل اینجاست که بخشی از این استدلال براساس یک فرض اثباتنشده بنا شده است: اینکه موتورهای هوش مصنوعی برای فهم وب الزاماً به نسخهای جدا از همان چیزی نیاز دارند که کاربران مشاهده میکنند.
در ژوئن ۲۰۲۶، جان مولر و مارتین اسپلیت از تیم Search Relations گوگل در پادکست رسمی Search Off the Record درباره همین موضوع صحبت کردند. گوگل در صفحه رسمی پادکست، موضوع این اپیزود را اینطور معرفی کرده است که آیا باید سایت را به Markdown تبدیل کرد تا مدلهای زبانی بهتر آن را بفهمند و آیا چنین کاری برای سئو ارزش دارد یا نه. گزارش Search Engine Journal از این گفتوگو نشان میدهد پاسخ آنها بیش از آنکه حملهای به خود Markdown باشد، هشداری درباره ساخت نسخههای موازی برای انسان و ماشین است.
یکی از نکات مهمی که در بازنشرهای این خبر ممکن است گم شود این است که گوگل نگفته Markdown بد است یا موتورهای جستوجو نمیتوانند فایل Markdown را پردازش کنند. اتفاقاً Markdown یکی از مفیدترین فرمتها برای نگارش مستندات، پروژههای نرمافزاری، سیستمهای محتوا و انتقال متن ساختاریافته است. مسئله زمانی ایجاد میشود که همان محتوای یک صفحه را در دو نسخه مستقل منتشر کنیم: نسخه HTML برای انسان و نسخه Markdown برای مدلهای زبانی.
در چنین معماریای، هر تغییر به یک مسئله همگامسازی تبدیل میشود. نویسنده مقاله را اصلاح میکند؛ آیا نسخه Markdown هم اصلاح شد؟ قیمت محصول تغییر میکند؛ آیا هر دو نسخه مقدار جدید را دارند؟ لینک داخلی حذف میشود؛ آیا در فایل دوم همچنان وجود دارد؟ نام نویسنده یا تاریخ بهروزرسانی تغییر کرده؛ کدام نسخه منبع اصلی است؟
هرچه سایت بزرگتر باشد، هزینه این مدل بیشتر میشود. در یک وبلاگ دهصفحهای شاید نگهداری نسخه دوم ساده به نظر برسد. اما در فروشگاهی با صدها هزار محصول، رسانهای با میلیونها URL یا سایت SaaS با مستندات دائماً در حال تغییر، ایجاد نسخه دوم به معنی ساخت یک زنجیره انتشار دوم است.
همین نکته قلب هشدار گوگل است. مارتین اسپلیت در گفتوگوی مورد استناد میگوید اگر برای مدلهای زبانی نسخهای جدا تولید کنیم، عملاً حجم کار را دو برابر کردهایم.
Markdown عمداً ساده طراحی شده است. تیتر، پاراگراف، فهرست، لینک، تصویر و بعضی اجزای پایه را بهشکل خوانا نمایش میدهد، اما سیستم کامل Layout و Interaction مرورگر را ارائه نمیکند. این ویژگی برای نوشتن مستندات مزیت است؛ برای ساخت کل تجربه وب الزاماً کافی نیست.
مارتین اسپلیت در پادکست روی همین موضوع دست میگذارد. کاربران فقط متن خام مصرف نمیکنند؛ چیدمان، تصویر، رنگ و نحوه حرکت میان بخشها نیز بخشی از تجربه است. اگر بخواهیم روی نسخه Markdown دوباره Layout، Navigation و عناصر بصری بسازیم، بهتدریج همان قابلیتهایی را بازسازی میکنیم که HTML و مرورگر سالهاست برایشان زیرساخت دارند.
این موضوع در بحث سئوی هوش مصنوعی مهم است، زیرا گاهی بهاشتباه فرض میکنیم تصویر، جدول، ناوبری و تجربه بصری چیزهایی «مزاحم» برای ماشیناند. درحالیکه خود گوگل در راهنمای رسمی بهینهسازی برای جستوجوی مولد، استفاده از تصاویر و ویدئوهای باکیفیت و مرتبط را فرصتی برای حضور بیشتر در قابلیتهای Search میداند.
پس سادهسازی ساختار با حذف ارزشهای انسانی یکسان نیست. هدف باید ساخت صفحهای باشد که هم محتوای اصلی آن برای ماشین قابل دسترسی باشد و هم برای انسان تجربه مناسبی بسازد.
مهمترین بخش بحث جان مولر نه درباره هزینه تولید، بلکه درباره قابلیت کشف خطاست. اگر نسخه HTML سایت خراب شود، احتمالاً کسی آن را میبیند. کاربر ممکن است با صفحه سفید، متن ناقص، لینک خراب یا خطای سرور مواجه شود. تیم کنترل کیفیت نیز معمولاً همان تجربهای را تست میکند که مخاطب واقعی مصرف میکند.
مولر توضیح میدهد نسخه موازی مخصوص ماشین میتواند خراب شود و کاربران هیچ گزارشی درباره آن ندهند، چون اساساً آن را نمیبینند. از طرف دیگر، یک سیستم خودکار نیز ممکن است متوجه نشود متن ناقص یا قدیمی است؛ صرفاً مقداری محتوا دریافت میکند و همان را پردازش میکند.
این مسئله را میتوان نوعی «شکاف مشاهدهپذیری» دانست. هر معماری جدید فقط Deployment نمیخواهد؛ Monitoring هم میخواهد. اگر یک مسیر انتشار تازه میسازیم، باید برای آن تست، هشدار، Versioning، کنترل محتوا و مشاهده سلامت نیز طراحی کنیم.
در نتیجه، هزینه واقعی یک نسخه Markdown فقط تولید فایل نیست. هزینه شامل همه چیزهایی است که لازم است تضمین کند این فایل همیشه همان واقعیتی را نمایش میدهد که سایت اصلی نمایش میدهد.
مارتین اسپلیت در همان گفتوگو، این وضعیت را با Dynamic Rendering مقایسه میکند. ایده Dynamic Rendering این بود که یک نسخه برای کاربر و نسخهای دیگر برای خزندهای که ممکن است در اجرای JavaScript مشکل داشته باشد ارائه شود. این روش در دورهای بهعنوان راهحل موقت بعضی سایتهای JavaScript-heavy استفاده شد.
امروز مستندات رسمی گوگل Dynamic Rendering را «راهحل موقت» معرفی میکنند و صریحاً میگویند راهکار توصیهشدهای نیست، زیرا پیچیدگی و نیاز به منابع اضافی ایجاد میکند. گوگل گزینههایی مانند Server-side Rendering، Static Rendering یا Hydration مناسب را ترجیح میدهد.
وجه مشترک دو ماجرا روشن است. هر زمان برای ماشین و انسان دو نسخه مستقل از محتوا ایجاد میکنیم، مسئله Synchronization وارد معماری میشود. این دو نسخه باید از نظر محتوای اصلی، Metadata، لینکها و وضعیت بهروز بودن با یکدیگر هماهنگ بمانند.
اگر تفاوتی ایجاد شود، باید بفهمیم کدام نسخه حقیقت است.
پاسخ رسمی گوگل در سال ۲۰۲۶ حتی روشنتر شده است. در راهنمای رسمی بهینهسازی برای قابلیتهای مولد Google Search، بخشی با هدف رد باورهای نادرست ایجاد شده است. در این بخش گوگل صراحتاً میگوید برای حضور در Search و قابلیتهای مولد آن نیازی به ساخت فایلهای ماشینی جدید، فایلهای متن مخصوص هوش مصنوعی، Markup ویژه یا Markdown نیست.
همین راهنما درباره llms.txt نیز موضع روشنی دارد: Google Search آن را برای رتبهبندی یا حضور در قابلیتهای مولد خود استفاده نمیکند. گوگل میتواند انواع فایلهای مختلف را کشف و Crawl کند، اما قابل Crawl بودن یک فرمت به معنی داشتن امتیاز ویژه نیست. اگر سرویس دیگری از llms.txt استفاده میکند، ساخت آن میتواند برای همان سرویس معنا داشته باشد، ولی در Google Search نه مزیت و نه ضرر خاصی برای Visibility ایجاد میکند.
این بخش یک مرز مهم میان «AI SEO برای Google Search» و «بهینهسازی برای سایر سیستمها» میسازد. اینکه گوگل فایلی را نیاز ندارد به معنی بیاستفاده بودن آن برای تمام مدلها و محصولات دنیا نیست. اگر ابزار، API یا عامل خاصی رسماً از Markdown یا فایل مشخصی استفاده میکند، پیادهسازی آن میتواند کاملاً منطقی باشد.
مشکل زمانی شروع میشود که یک تاکتیک بدون Consumer مشخص را روی کل سایت اجرا کنیم.
یکی از استدلالهای پشت ایده نسخه Markdown این است که HTML بسیار شلوغ است و مدل زبانی نمیتواند محتوای اصلی را بهدرستی استخراج کند. این ادعا برای بعضی صفحات واقعاً بدساخت میتواند تا حدی قابل درک باشد، اما راهحل منطقی الزاماً ساخت نسخه دوم نیست.
جان مولر در گفتوگو نیز میپذیرد که بعضی صفحات وب از نظر ساختار واقعاً نامناسباند و همین مسئله باعث میشود ایده دادن نسخه سادهتر به سیستمهای خودکار وسوسهکننده باشد. اما از دید مهندسی، اگر HTML آنقدر پیچیده است که استخراج محتوای اصلی مشکل شده، سؤال اول باید این باشد که چرا همان HTML را اصلاح نمیکنیم؟
ساختار Semantic مناسب، Headingهای منطقی، استفاده درست از عناصر HTML، دسترسی مستقیم به محتوای اصلی، Navigation واضح و حذف کدهای غیرضروری میتواند هم تجربه کاربر را بهتر کند و هم مصرف ماشینی را سادهتر سازد.
این همان نقطهای است که Technical SEO با معماری محصول تلاقی پیدا میکند. هدف نباید این باشد که یک نسخه بد برای کاربران را حفظ کنیم و یک نسخه تمیز برای ماشین بسازیم. بهتر است نسخه اصلی را تمیز کنیم.
راهنمای رسمی Google Search برای قابلیتهای مولد، برخلاف بسیاری از فهرستهای تاکتیکی اینترنت، نسبتاً آشناست. گوگل تأکید میکند همان پایههای SEO همچنان کاربرد دارند: صفحه باید قابل ایندکس باشد، Googlebot بتواند محتوای آن را Crawl کند، پاسخ موفق دریافت شود و محتوای اصلی قابل دسترسی باشد.
در سطح محتوا نیز تمرکز روی تولید محتوای باارزش و غیرکالایی است؛ یعنی چیزی فراتر از بازنویسی اطلاعات عمومی. تصاویر و ویدئوهای مرتبط نیز همچنان بخشی از فرصت Visibility هستند.
در مورد داده ساختاریافته، گوگل میگوید Schema ویژهای برای AI Search لازم نیست، اما Structured Data معمول همچنان در استراتژی کلی Search کاربرد دارد و باید با محتوای قابل مشاهده صفحه هماهنگ باشد.
این مجموعه توصیهها جهت روشنی دارد: بهجای ساخت یک وب مخفی برای هوش مصنوعی، وب اصلی را سالمتر کنید.
منظور این نیست که Markdown را از Stack خود حذف کنید
در این بحث خطر یک سوءبرداشت دیگر نیز وجود دارد. ممکن است کسی نتیجه بگیرد چون گوگل نسخه Markdown موازی را پیشنهاد نمیکند، پس نباید از Markdown در سایت استفاده کنیم.
این نتیجه اشتباه است.
بسیاری از CMSها، Static Site Generatorها و سیستمهای مستندسازی محتوا را در Markdown ذخیره میکنند و هنگام انتشار HTML تولید میکنند. در چنین معماریای لزوماً دو نسخه عمومی مستقل وجود ندارد. Markdown میتواند فرمت تألیف باشد و HTML خروجی وب.
مشکل اصلی زمانی است که دو Endpoint یا دو مجموعه URL مستقل را با هدف مصرف متفاوت منتشر کنیم و مجبور باشیم Consistency میان آنها را مدیریت کنیم.
بنابراین سؤال درست این نیست که «Markdown خوب است یا بد؟» سؤال درست این است که «آیا داریم یک Source of Truth داریم یا دو Source of Truth؟»
گاهی یک سرویس واقعاً یک فرمت خاص میخواهد. شاید API سازمان، یک عامل داخلی، یک سیستم مستندسازی یا محصول دیگری رسماً Markdown را بهعنوان Input مصرف کند. در چنین شرایطی تولید نسخه ماشینی میتواند کاملاً منطقی باشد.
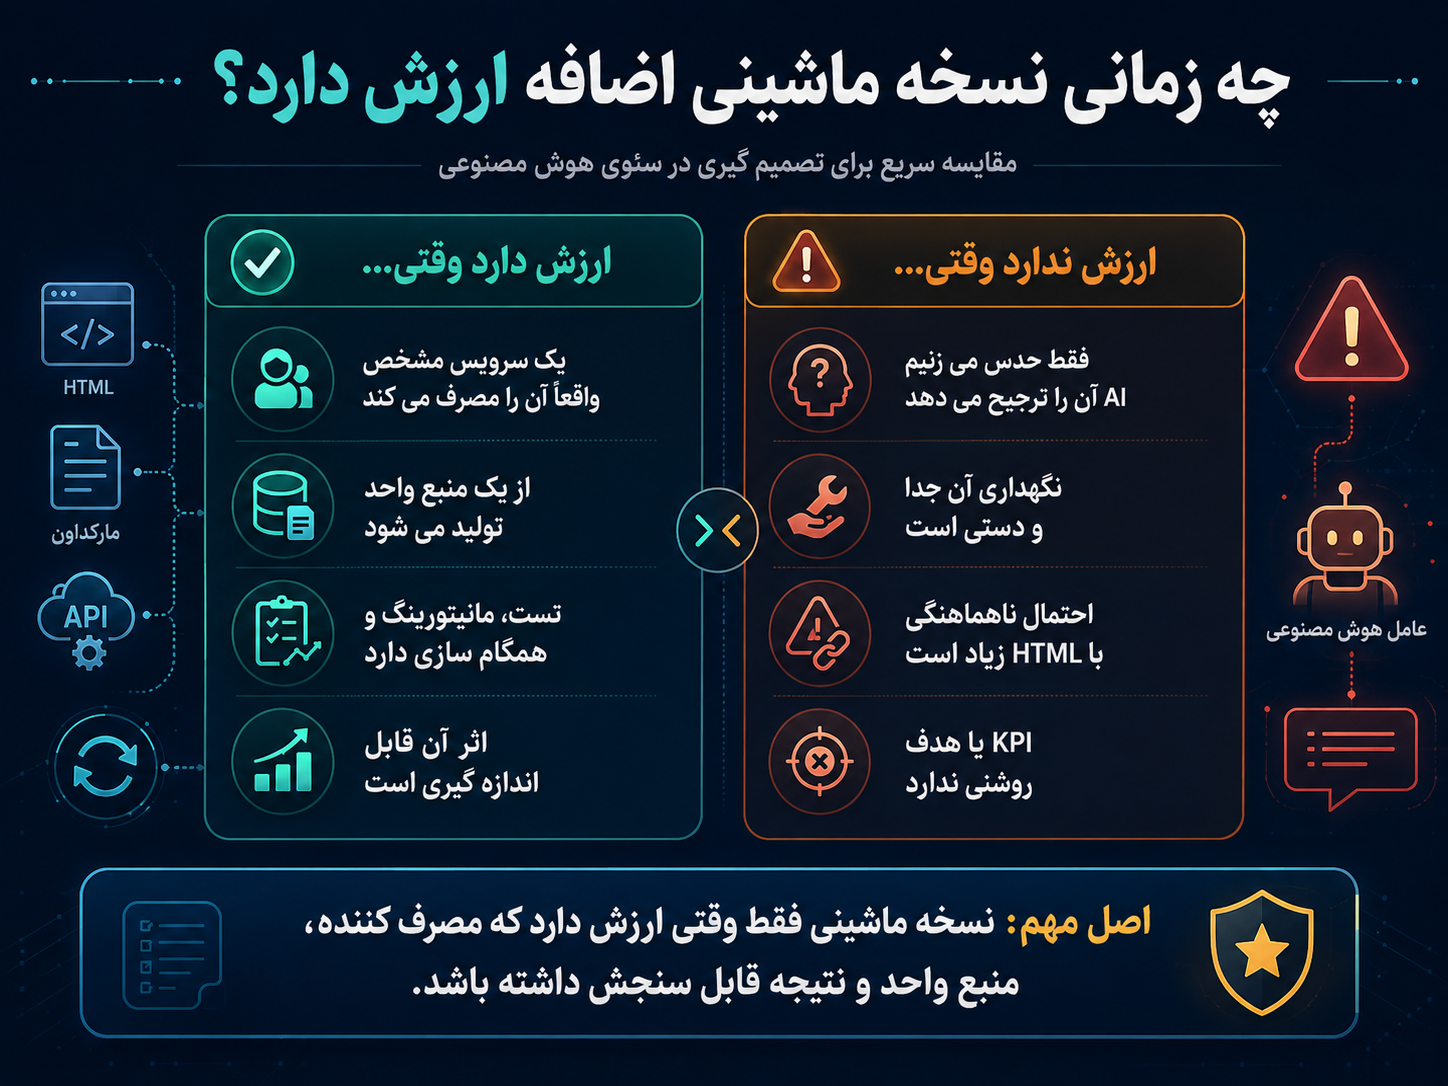
اما طراحی بهتر این است که نسخهها از یک Source of Truth مشترک تولید شوند، نه اینکه دو تیم یا دو Workflow مستقل هرکدام محتوا را جدا نگهداری کنند.
اگر مقاله اصلی در CMS ذخیره میشود، HTML و Markdown میتوانند هنگام Build از همان داده تولید شوند. سپس تست خودکار باید بررسی کند محتوای اصلی، لینکها و Metadata حیاتی در هر دو خروجی هماهنگاند.
در چنین سناریویی نیز باید سؤال هزینه و فایده را پرسید: چه سیستم مشخصی نسخه Markdown را مصرف میکند و چه Outcome قابل اندازهگیری ایجاد میکند؟
اگر پاسخ فقط «شاید مدلهای هوش مصنوعی دوست داشته باشند» باشد، دلیل ضعیفی برای ساخت زیرساخت جدید داریم.
وقتی دو نسخه از یک محتوا داریم، معمولاً اولین نگرانی متخصص سئو Duplicate Content و Canonical است. اما مشکل مهمتر ممکن است دادهای باشد.
فرض کنیم HTML قیمت جدید محصول را نشان میدهد اما Markdown قیمت قبلی را دارد. یک سیستم ماشینی ممکن است کدام را مصرف کند؟ اگر هر دو URL عمومیاند، نسخه قدیمی میتواند در Retrieval یا Citation ظاهر شود.
همین مسئله درباره تاریخ، آمار، سیاست بازگشت کالا، بیوگرافی افراد، ویژگی محصول و اطلاعات حقوقی نیز وجود دارد. در عصر AI، Data Consistency از Canonical صرف فراتر میرود.
به همین دلیل، هر نسخه ماشینی اضافه، یک سطح جدید برای Data Integrity ایجاد میکند.
یک چکلیست تصمیم قبل از ساخت Markdown موازی
نخست، کدام سیستم مشخص قرار است نسخه Markdown را مصرف کند؟ اگر Consumer تعریف نشده است، پروژه بر فرضیهای مبهم بنا شده است.
دوم، آیا همان سیستم HTML فعلی را واقعاً نمیتواند بهدرستی پردازش کند؟ این موضوع باید با تست نشان داده شود.
سوم، آیا میتوان مشکل را در نسخه اصلی حل کرد؟ اگر ساختار HTML ضعیف است، اصلاح آن برای انسان و ماشین همزمان ارزش ایجاد میکند.
چهارم، نسخه دوم چگونه همگام خواهد ماند؟ Source of Truth، Monitoring، تست و Versioning باید پیش از Launch مشخص باشند.
پنجم، موفقیت چگونه اندازهگیری میشود؟ بدون KPI، نسخه Markdown ممکن است سالها فقط هزینه نگهداری ایجاد کند.
برای اکثر سایتهایی که هدف اصلیشان Visibility در Google Search و قابلیتهای هوش مصنوعی گوگل است، پاسخ فعلی بسیار معمولیتر از چیزی است که صنعت «AI SEO» شاید دوست داشته باشد.
HTML اصلی را درست بسازید. محتوا را قابل Crawl و Index نگه دارید. ساختار معنایی روشن داشته باشید. Headingها را منطقی کنید. لینکهای مهم را در دسترس قرار دهید. JavaScript را به شکلی پیاده کنید که محتوای اصلی قابل دسترسی بماند. داده ساختاریافته را فقط در جایی استفاده کنید که دقیق و متناسب با محتوای قابل مشاهده است. محتوایی تولید کنید که چیزی بیشتر از نسخههای موجود در وب ارائه دهد. همین موارد با راهنمای رسمی گوگل برای جستوجوی مولد همراستا هستند.
این توصیه شاید بهاندازه «فایل مخفی جدید برای هوش مصنوعی» هیجانانگیز نباشد، اما پیچیدگی کمتر معمولاً مزیت فنی بزرگی است.
بحث Markdown یک نمونه عالی از مسئله بزرگتری است که سئو در عصر هوش مصنوعی با آن روبهرو خواهد شد. هر فناوری جدید انبوهی از پیشنهادها برای ساخت لایههای مخصوص ماشین تولید میکند. بعضی از آنها در آینده ممکن است استاندارد شوند و بعضی بدون اثر قابل اندازهگیری کنار بروند.
گوگل در مورد Search فعلاً موضع نسبتاً روشنی دارد. برای قابلیتهای مولد آن نیازی به فایل Markdown ویژه، llms.txt یا زبان نوشتاری مخصوص AI نیست و اصول پایه SEO همچنان زیرساخت اصلی Visibility هستند. جان مولر و مارتین اسپلیت نیز از زاویه مهندسی هشدار میدهند که نگهداری نسخه موازی، خطا و پیچیدگی بیشتری ایجاد میکند.
این به معنی مخالفت با نوآوری نیست. برعکس، نوآوری زمانی ارزشمند است که مشکل مشخصی را حل کند.
اگر یک Agent، API یا سرویس مشخص Markdown میخواهد، آن را بسازید و اثرش را اندازه بگیرید. اما اگر تنها دلیل ساخت نسخه دوم این است که «شاید هوش مصنوعی این را ترجیح بدهد»، احتمالاً هنوز سؤال مهمتری بیپاسخ مانده است:
چرا همان نسخه اصلی سایت را آنقدر تمیز، دقیق و قابل استفاده نسازیم که انسان و ماشین هر دو بتوانند از یک منبع مشترک استفاده کنند؟
تهیه شده توسط تیم تخصصی سئو سید احسان خسروی (مدیر، متخصص و مشاور استراتژیک سئو)

