
پس از اجرای Spam Update اوت ۲۰۲۶، بخشی از جامعه SEO متوجه الگوی جالبی شد. برخی سایتهایی که بر انتشار خودکار و پرحجم محتوای تولیدشده با مدلهای زبانی متکی بودند، در فاصله اجرای آپدیت افت محسوسی گزارش کردند. همین مشاهدات باعث شد تیترهایی با مضمون «گوگل به جنگ محتوای AI رفت» بهسرعت منتشر شوند. مقاله Roger Montti در Search Engine Journal نیز همین گزارشها را جمعآوری کرده و این احتمال را مطرح میکند که دستکم بخشی از آپدیت ممکن است با محتوای انبوه هوش مصنوعی که مشخصاً برای تصاحب رتبههای جستوجو تولید میشود مرتبط بوده باشد. بااینحال، خود مقاله بارها تأکید میکند که شواهد موجود مشاهدهای و محدودند و حتی نمونههایی از سایتهای AI وجود داشته که پس از آپدیت عملکرد بهتری داشتهاند.
این مرزبندی اهمیت زیادی دارد، زیرا Google Search Status Dashboard فقط وقوع رسمی «August 2026 spam update» را تأیید میکند. آپدیت از ۱۸ اوت آغاز شد و حدود دو روز و شانزده ساعت ادامه داشت، اما گوگل در توضیح رسمی خود نگفت که این بهروزرسانی مشخصاً برای شناسایی محتوای تولیدشده با هوش مصنوعی طراحی شده است. بنابراین عبارت «Spam Update گوگل محتوای AI را هدف گرفت» در حال حاضر باید بهعنوان تفسیر گزارشهای جامعه SEO مطرح شود، نه یک واقعیت تأییدشده از سوی گوگل.
برای فهم موضوع بهتر است از گزارشهای پراکنده فاصله بگیریم و مستقیم به Spam Policies رسمی گوگل نگاه کنیم. سیاست «Scaled Content Abuse» تولید تعداد زیادی صفحه را زمانی مصداق سوءاستفاده میداند که هدف اصلی آنها دستکاری رتبههای Search باشد و برای کاربران ارزش کمی یا هیچ ارزش مستقلی ایجاد نکنند. نکته بسیار مهم این است که گوگل روش تولید را معیار اصلی قرار نمیدهد. محتوای انبوه میتواند با Generative AI، Scraping، ترکیب خودکار منابع، انسان یا هر ترکیب دیگری ساخته شده باشد؛ اگر هدف و نتیجه همان Manipulation در مقیاس بالا باشد، روش تولید تفاوت بنیادی ایجاد نمیکند.
این سیاست از مارس ۲۰۲۴ عمداً از اصطلاح قدیمی «Automatically-generated content» فاصله گرفت و بر مفهوم گستردهتر Scaled Abuse تمرکز کرد. گوگل در توضیح این تغییر گفت مسئله اصلی Scale و Manipulative Purpose است و سیاست باید روشهایی را پوشش دهد که حتی تشخیص انسان یا Automation بودن تولید در آنها آسان نیست. به بیان سادهتر، سؤال سیاست گوگل «چه کسی این متن را نوشته؟» نیست؛ سؤال مهمتر «چرا هزاران نسخه از این نوع محتوا ساخته شدهاند و چه چیزی به کاربر اضافه میکنند؟» است.
این تفاوت برای صنعت SEO حیاتی است. اگر یک تیم با کمک مدل زبانی مقالهای تولید کند، متخصص آن را بررسی کند، داده اختصاصی اضافه شود، منابع اصلی کنترل شوند و خروجی واقعاً مسئله کاربر را بهتر از منابع موجود حل کند، صرف وجود AI در Workflow آن محتوا را Spam نمیکند. در مقابل، اگر یک تحریریه صد نویسنده انسانی استخدام کند تا روزانه هزاران صفحه کمارزش بر اساس Keyword Template تولید کنند، انسانیبودن فرایند آن را از سیاست Scaled Content Abuse خارج نمیکند.
راهنمای رسمی Google Search درباره Generative AI نیز دقیقاً همین خط را ادامه میدهد. گوگل میگوید ابزارهای مولد میتوانند برای تحقیق درباره یک موضوع و افزودن ساختار به محتوای Original مفید باشند. در همان صفحه هشدار داده میشود که استفاده از GenAI یا ابزارهای مشابه برای ساخت تعداد زیادی صفحه بدون ارزش افزوده برای کاربران میتواند Spam Policy مربوط به Scaled Content Abuse را نقض کند.
بنابراین دوگانه «Human Content خوب است، AI Content بد است» با موضع رسمی گوگل همخوانی ندارد. مدل دقیقتر این است که AI یک ابزار تولید است و کیفیت، هدف، Originality و Value خروجی باید جداگانه سنجیده شوند. یک نویسنده انسانی میتواند AI Slop تولید کند و یک سیستم AI-assisted نیز میتواند با تحقیق، Verification و Expertise واقعی محتوایی بسیار مفید بسازد.
این موضوع همچنین نشان میدهد چرا تلاش برای «Humanize کردن متن» با تغییر چند عبارت یا اضافهکردن اشتباهات مصنوعی راهبرد معناداری نیست. اگر مسئله اصلی سایت، تولید انبوه صفحات کمارزش برای پوشش Keyword باشد، تغییر نشانههای سطحی Style دلیل وجود آن صفحات را تغییر نمیدهد.
مقاله Search Engine Journal چند گزارش جامعه SEO، بهخصوص از ژاپن، را بررسی میکند. یکی از گزارشها ادعا میکرد سایتهایی که از ابتدا با Pipelineهای تمامخودکار و ابزارهایی مانند Claude Code برای انتشار محتوا ساخته شده بودند، بیشتر تحت تأثیر قرار گرفتهاند، درحالیکه برخی دامنههایی که ابتدا سابقه انتشار دستی داشته و بعداً Automation را اضافه کرده بودند بهتر دوام آوردهاند. همان منبع خودش تأکید کرده بود Sample Size کوچک است و نتیجه قطعی نیست.
این بخش بهخصوص نیازمند احتیاط است، چون توضیحاتی مانند «Domain Trust ذخیرهشده»، «AI Credit در متن» یا تشخیص یک Signature مخصوص ابزار تولید در حد تفسیر و Hypothesis هستند. مقاله SEJ نیز بلافاصله اشاره میکند که اصطلاح مبهم Trust Signal بهتر است با User-generated signals اشتباه نشود. هیچ سند رسمی در دست نیست که نشان دهد گوگل یک «AI Credit» پنهان مشابه Metadata برخی تصاویر یا ویدیوها را از متن LLM تشخیص میدهد و سپس بر همان اساس سایت را Penalize میکند.
گزارش دیگری در همان مقاله نکته منطقیتری مطرح میکند: مسئله احتمالاً خود Generative AI نیست، بلکه استفاده از AI برای Mass Production محتوایی است که هدف اصلیاش Manipulation نتایج Search است. این تعبیر حداقل با متن رسمی Spam Policy گوگل همراستا است.
عامل دیگری که به این بحث دامن زده، انتشار پژوهشی از محققان Google درباره سیستمی به نام Scalable Cluster Termination System یا S-CTS است. این سیستم برای مقابله با موج محتوای مصنوعی و هماهنگ طراحی شده و ایده اصلی آن بسیار جالب است: اگر مهاجم بتواند میلیونها نمونه منحصربهفرد ولی از نظر معنایی تقریباً یکسان تولید کند، بررسی هر محتوا بهصورت مستقل ممکن است مقیاسپذیر نباشد. بنابراین سیستم بهجای تمرکز فقط بر Document، شبکهای از Content Pattern و Infrastructure Signals را بررسی میکند.
اما دقیقاً همینجا بیشترین احتمال سوءبرداشت وجود دارد. مقاله پژوهشی S-CTS درباره Online Video Platforms و شناسایی Clusterهای حسابهای هماهنگی است که محتوای مصنوعی و Spam را در مقیاس بالا منتشر میکنند. Search Engine Journal در گزارش قبلی خود صریحاً نوشته بود تمرکز Research روی Video Spam است و اینکه تکنیکهای آن «میتوانند ایدهای» درباره روشهای قابل استفاده برای Spam متنی ارائه دهند. این با جمله «گوگل S-CTS را در Search برای آپدیت اوت اجرا کرد» فاصله زیادی دارد.
تا زمانی که گوگل چنین Deploymentی را تأیید نکند، ارتباط S-CTS و August Spam Update یک Hypothesis مبتنی بر همزمانی و شباهت مسئله است. این تحقیق نشان میدهد مهندسان گوگل چگونه درباره مقابله با Generative Spam در مقیاس بالا فکر میکنند، اما نقشه Ranking System گوگل نیست.
نکته جالب در Research این است که Detection فقط بر سطح Content متکی نیست. سیستم دو Component اصلی دارد: بخشی برای شناسایی Account Relatedness و Clusterهای مرتبط و بخشی برای تشخیص Patternهای Synthetic. الگوهایی مانند Narrativeهای تکراری، متنهای Scripted، رفتار انتشار غیرانسانی با Frequency بالا و Infrastructure مشترک میتوانند در کنار هم تصویری از یک شبکه هماهنگ بسازند.
Research همچنین به استفاده از Text Embeddings مانند Sentence-BERT برای تشخیص شباهت معنایی میان Scriptها اشاره میکند. این موضوع مهم است، چون دو متن میتوانند واژههای متفاوتی داشته باشند اما از نظر معنا و ساختار روایی تقریباً یک Content Template را بازتولید کنند. بنابراین اگر کسی تصور کند با Synonym Replacement، تغییر Tone یا بازنویسی سطحی میتواند ماهیت Template-driven محتوا را مخفی کند، این نوع Research نشان میدهد حداقل از نظر فنی تشخیص شباهت معنایی بسیار فراتر از Exact Match کلمات امکانپذیر است.
بااینحال، باز هم باید مرز Use Case حفظ شود. این قابلیت در Research مربوط به یک سیستم مقابله با Spam شبکهای در پلتفرم ویدیویی توضیح داده شده است و نباید آن را بدون مدرک به Web Ranking تعمیم داد.
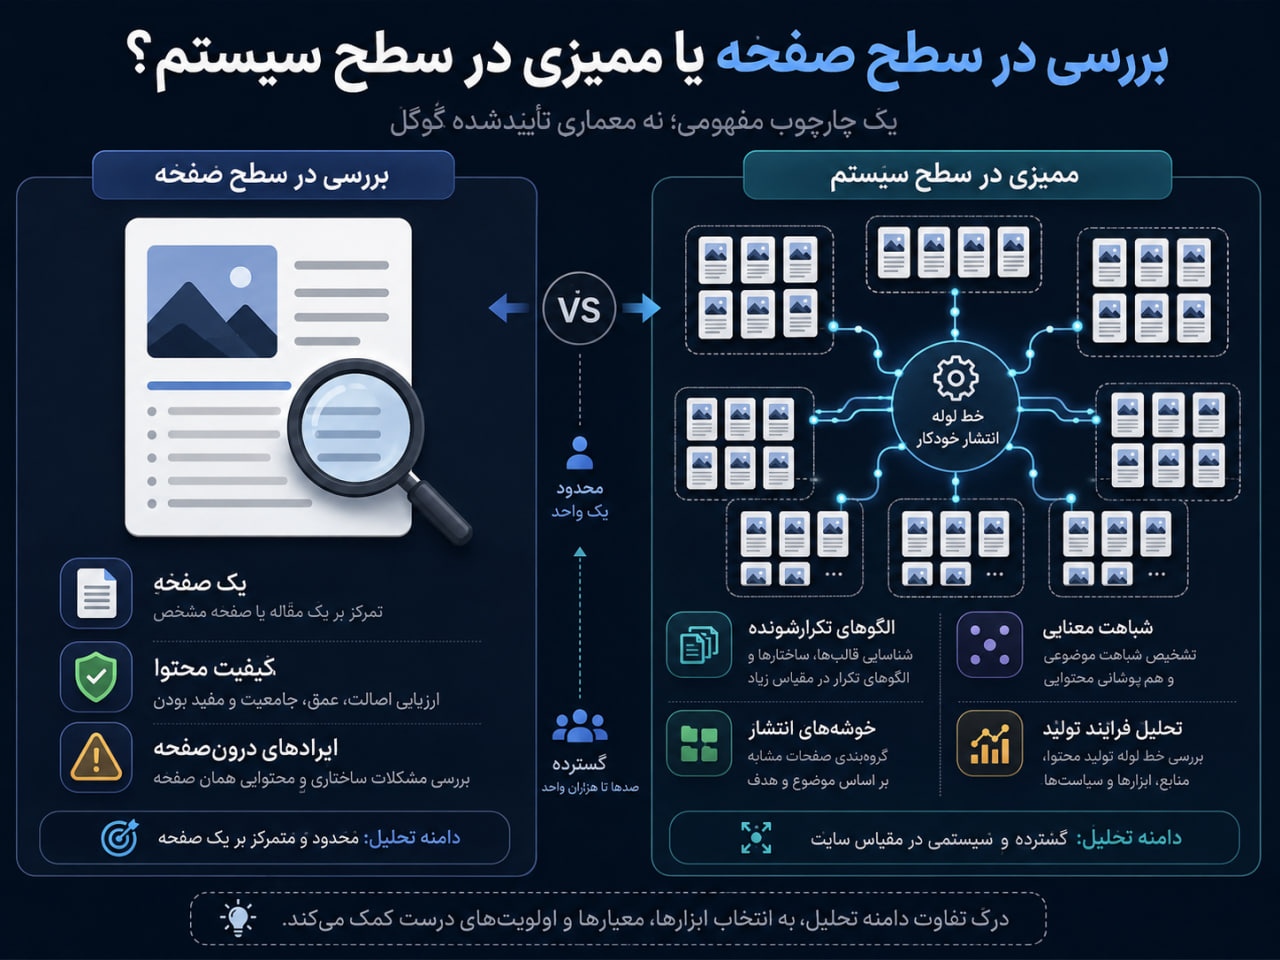
مقیاس میتواند ماهیت مسئله را عوض کند. اگر یک نویسنده برای مقالهای از AI کمک بگیرد و سپس خروجی را Fact-check کند، منابع واقعی اضافه کند و تجربه شخصی یا Data اختصاصی وارد متن کند، خطا در همان مقاله قابل شناسایی و اصلاح است. اما وقتی Workflow قرار است روزانه پنج هزار URL تولید کند، حتی نرخ خطای کوچک میتواند به هزاران صفحه نادرست، تکراری یا کمارزش تبدیل شود.
از طرف دیگر، Economics چنین سیستمهایی معمولاً تیم را به سمت Template سوق میدهد. برای حفظ سرعت، تحقیق واقعی کاهش پیدا میکند، Review سطحی میشود و صفحات به Variantهایی از یک ساختار مشترک تبدیل میشوند. در این مرحله، AI فقط ابزار نیست؛ Scale تبدیل به Business Model شده است. همین وضعیت به تعریف Scaled Content Abuse نزدیکتر است.
مشکل دیگری نیز وجود دارد: Keyword Universe محدود نیست. وقتی Cost تولید صفحه تقریباً به صفر میرسد، انگیزه اقتصادی ایجاد میشود که برای هر ترکیب ممکن Keyword یک URL ساخته شود. در نتیجه بهجای اینکه Site Architecture از نیازهای واقعی کاربران شکل بگیرد، از تمام Permutationهای موجود در Keyword Database ساخته میشود.
در گزارش SEJ نمونهای ذکر میشود که سایتی با محتوای AI اما Human Visual Check تحت تأثیر قرار نگرفته بود. این Observation جالب است، ولی نمیتوان از آن قانون «اگر انسان مقاله را نگاه کند Google قبول میکند» ساخت. Human Review فقط زمانی ارزش دارد که Review واقعی باشد و بتواند خروجی را اصلاح یا رد کند.
اگر Editor فقط برای پنج ثانیه صفحه را باز کند و دکمه Publish را بزند، وجود انسان در Workflow هیچ Value جدیدی ایجاد نمیکند. در مقابل، Review واقعی میتواند Factها را بررسی کند، منابع را کنترل کند، تناقضها را پیدا کند، بخشهای Generic را حذف کند، Example واقعی اضافه کند و تعیین کند که آیا اصلاً صفحهای با این Intent باید وجود داشته باشد یا نه.
پس بهتر است معیار را از «Human in the loop» به «Meaningful Editorial Intervention» تغییر دهیم. سؤال این نیست که انسان حضور داشته یا نه؛ سؤال این است که حضور او چه چیزی را در Output تغییر داده است.
اگر افت سایت دقیقاً با ۱۸ تا ۲۱ اوت همزمان است، اولین واکنش نباید حذف تمام محتوای AI باشد. Correlation زمانی فقط نقطه شروع Investigation است. باید ببینیم چه URLهایی افت کردهاند، آیا Pattern مشخصی میان Templateها وجود دارد، چه نوع Queryهایی از دست رفتهاند و آیا مشکل فقط صفحات AI-heavy است یا بخشهای دیگری از سایت نیز درگیر شدهاند. همچنین باید Updates دیگر، مشکلات فنی و تغییرات رقبا را از Analysis حذف نکنیم.
در مرحله Content Audit، بهتر است صفحات را نه براساس ابزار نویسنده، بلکه براساس Reason to Exist دستهبندی کنیم. آیا این URL پاسخ مستقلی دارد که URLهای دیگر ندارند؟ آیا مقاله فقط مجموعهای از مطالب موجود در ده نتیجه اول است؟ آیا Data، Experience، Example یا Perspective تازه دارد؟ آیا Intent آن با صفحه دیگری تقریباً یکسان است؟ آیا حذف صفحه باعث میشود کاربر واقعاً اطلاعاتی را از دست بدهد؟
در سایتهای Programmatic نیز باید Template را بررسی کرد. اگر ده هزار صفحه از نظر Heading، ترتیب Sectionها، تعداد Paragraphها و حتی نوع Example تقریباً یکساناند و فقط City، Product یا Keyword جایگزین میشود، مسئله معماری است نه یک مقاله خاص.
مقیاس بالا را هم نباید خودکار با Spam برابر بدانیم. Marketplace، Job Board، Real Estate Platform یا Ecommerce ممکن است میلیونها URL داشته باشد و هر صفحه به دلیل وجود Entity، Availability، Price، Location، Review یا داده واقعی مستقل برای کاربر ارزش داشته باشد. Programmatic SEO نیز ذاتاً ممنوع نیست؛ اگر Template برای نمایش Data واقعی و متفاوت استفاده شود، تعداد بالای صفحات لزوماً مشکل محسوب نمیشود.
خط مرزی زمانی مهم میشود که Pages فقط برای ایجاد Search Footprint ساخته شوند. اگر یک City Page تقریباً هیچ اطلاعات مختص آن شهر ندارد و فقط نام شهر در Paragraphهای عمومی جایگزین شده، تعداد صفحات بیشتر احتمالاً Value بیشتری تولید نکرده است. اما اگر همان صفحه Inventory واقعی، قیمتهای منطقهای، قوانین محلی، داده بازار و Information اختصاصی داشته باشد، دلیل مستقل برای وجود دارد.
به همین دلیل «Mass-generated» را باید با «Low-value + ranking manipulation» کنار هم فهمید، نه صرفاً «صفحات زیاد».
بخش قابل توجهی از تولید محتوای SEO سنتی از Keyword شروع میشود. این کار ذاتاً اشتباه نیست؛ Search Demand یکی از بهترین منابع شناخت نیاز کاربران است. مشکل زمانی ایجاد میشود که Keyword نه ورودی تحقیق، بلکه تنها دلیل ایجاد صفحه باشد.
فرض کنید ابزار Keyword Research پنجاه عبارت نزدیک درباره یک موضوع پیدا کرده است. مدل قدیمی ممکن است برای هرکدام URL جدا بسازد تا Maximum Coverage ایجاد شود. اما اگر User Need پشت تمام این عبارتها یکسان باشد، سایت عملاً پنجاه نسخه از یک Answer تولید کرده است.
در مدلی بهتر، Keyword Research باید به Intent Mapping، Entity Analysis و Information Architecture منجر شود. بعضی Queryها یک صفحه مشترک میخواهند، بعضی Section جدا و فقط تعداد محدودی واقعاً نیازمند URL مستقلاند.
این تغییر بهخصوص در عصر AI اهمیت دارد، چون Cost تولید صفحات Duplicate-intent بسیار پایین آمده و بنابراین نیاز به Editorial Restraint بیشتر شده است.
در مقاله SEJ حتی اعضای BlackHatWorld نیز از Search Results پرشده از AI Slop شکایت کردهاند؛ صفحاتی که یک پاسخ چندجملهای را به صدها کلمه تبدیل میکنند، Heading و Bulletهای مشابه دارند و برای تقریباً هر سؤال سادهای یک Article طولانی میسازند.
بااینحال، AI Slop را نباید فقط از روی Style تعریف کرد. مدلها و Promptها تغییر میکنند و Formatهای معروف امروز ممکن است فردا متفاوت شوند. مسئله عمیقتر این است که Content بیشتر از نیاز Information تولید میشود. سه جمله جواب واقعی دارد اما Workflow مجبور است ۱۵۰۰ کلمه تحویل دهد، چون Template چنین میخواهد.
بنابراین مقابله با Slop در سطح Editorial باید از سؤال «چطور متن AIتر به نظر نرسد؟» به سؤال «چه مقدار Content برای حل این Intent واقعاً لازم است؟» منتقل شود.
برای اکثر تیمها پاسخ منفی است. استفاده از AI میتواند بخشهایی از Content Workflow را بسیار کارآمدتر کند. Research اولیه، Classification، استخراج داده از Dataset، Outline، ویرایش، Translation Draft، پیدا کردن ناسازگاریهای متن و کمک به QA نمونههایی از کاربردهای مشروع هستند.
مسئله این است که Efficiency نباید بهانهای برای حذف Value Creation شود. اگر قبل از AI تیم میتوانست هفتهای ده مقاله واقعاً بررسیشده منتشر کند و اکنون روزی هزار مقاله منتشر میکند، سؤال منطقی این است که Research، Expert Review و Fact-check این افزایش صدبرابری چگونه مقیاس یافتهاند.
اگر پاسخ این است که مقیاس نگرفتهاند، افزایش Output احتمالاً با کاهش Depth همراه شده است.
بهجای دوگانه Human یا AI، میتوان Workflow را بر اساس سه سؤال طراحی کرد. نخست، Source of Truth چیست؟ مدل نباید تنها منبع Fact باشد و اطلاعات مهم باید به منبع اصلی یا Data قابل بررسی متصل شوند. دوم، Unique Contribution چیست؟ هر صفحه باید مشخص کند چه داده، تجربه، تحلیل، ابزار یا پاسخ متفاوتی ارائه میکند. سوم، Editorial Accountability با چه کسی است؟ باید فرد یا تیمی مسئول صحت نهایی خروجی باشد و اختیار حذف کامل Page را هم داشته باشد.
این سه اصل احتمالاً مهمتر از Promptهای «Humanize this text» هستند، چون به ماهیت اطلاعات و دلیل انتشار مربوطاند.
Spam Update اوت ۲۰۲۶ واقعی و رسمی بود، اما اینکه گوگل آن را مشخصاً برای شکار AI Content اجرا کرده باشد هنوز تأیید رسمی ندارد. گزارشهای جامعه SEO نشان میدهند برخی سایتهای دارای Automation و Mass Publishing تحت تأثیر قرار گرفتهاند، اما Sampleها محدود و نتایج متناقضاند.
آنچه قطعیتر است سیاست خود گوگل است. Scaled Content Abuse به تولید تعداد زیادی صفحه برای Manipulation رتبه و بدون ارزش کافی برای کاربر مربوط میشود، فارغ از اینکه محتوا توسط انسان، AI یا ترکیبی از هر دو ساخته شده باشد.
پژوهش S-CTS نیز نشان میدهد مقابله با Spam تولیدشده در مقیاس بالا میتواند از بررسی منفرد محتوا فراتر رود و Patternها، Behavior و Clusterها را بررسی کند، اما این سیستم برای Online Video Platforms طراحی شده و Deployment آن در Search تأیید نشده است.
برای تیم SEO نتیجه شاید سادهتر از همه شایعات باشد. سؤال اصلی این نیست که «چطور AI بودن متن را مخفی کنیم؟» بلکه این است:
اگر Search Ranking را از معادله حذف کنیم، آیا هنوز برای انتشار این صفحه دلیل کافی داریم؟
اگر پاسخ مثبت است و صفحه واقعاً اطلاعات، تجربه یا Utility مستقلی ایجاد میکند، AI فقط یکی از ابزارهای تولید بوده است. اگر پاسخ منفی است، احتمالاً مشکل بسیار قبلتر از انتخاب مدل زبانی شروع شده است.
تهیه شده توسط تیم تخصصی سئو سید احسان خسروی (مدیر، متخصص و مشاور استراتژیک سئو)

