
اگر با مدلسازی معادلات ساختاری و بهخصوص SmartPLS کار کرده باشید، احتمالاً با یک سؤال مهم روبهرو شدهاید: برای اجرای مدل، از کجا باید داده داشته باشیم؟
در یک پژوهش واقعی، پاسخ مشخص است: پرسشنامه طراحی میشود، جامعه آماری تعیین میشود، نمونهگیری انجام میگیرد و دادههای واقعی جمعآوری میشوند. اما همیشه هدف ما انجام یک پژوهش واقعی نیست. گاهی میخواهیم SmartPLS را یاد بگیریم، یک مدل را قبل از جمعآوری دادهها آزمایش کنیم، روش تحلیل را تمرین کنیم، عملکرد یک الگوریتم را بررسی کنیم یا یک مثال آموزشی قابل اجرا داشته باشیم.
در این شرایط، داده مصنوعی یا شبیهسازیشده میتواند بسیار کاربردی باشد.
نکته مهم این است که داده مصنوعی با «داده جعلی برای ارائه بهعنوان داده واقعی» تفاوت دارد. داده مصنوعی برای آموزش و آزمون روشها تولید میشود و نباید در یک مقاله یا پایاننامه بهعنوان پاسخهای واقعی افراد معرفی شود.
در این مطلب، یک مسیر عملی برای ساخت داده مناسب تحلیل PLS-SEM در SmartPLS را بررسی میکنیم.
خود SmartPLS ابزار اصلی تولید داده پرسشنامهای نیست. SmartPLS بیشتر برای مدلسازی و تحلیل روابط بین سازههای پنهان استفاده میشود.
بنابراین وقتی از «دادهسازی برای SmartPLS» صحبت میکنیم، معمولاً منظورمان این است که ابتدا یک دیتاست مصنوعی ایجاد کنیم و سپس آن را وارد SmartPLS کنیم.
برای مثال، فرض کنید مدل پژوهش به شکل زیر است:
تصویر برند ← اعتماد به برند ← قصد خرید
در این مدل سه سازه داریم:
تصویر برند
اعتماد به برند
قصد خرید
هر سازه نیز میتواند با چند گویه پرسشنامه اندازهگیری شود.
مثلاً:
سازه | تعداد گویه
تصویر برند | 5
اعتماد به برند | 4
قصد خرید | 4
در نتیجه دیتاست ما ممکن است شامل 13 ستون مربوط به گویهها و مثلاً 200 پاسخدهنده باشد.
این بخش اهمیت زیادی دارد؛ چون «دادهسازی» در پژوهش ممکن است معانی متفاوتی داشته باشد.
1. داده واقعی
دادهای است که از پاسخدهندگان واقعی، اسناد واقعی، سازمانها، سنسورها یا منابع معتبر جمعآوری شده است.
مثلاً 250 نفر پرسشنامهای را تکمیل کردهاند و پاسخهای آنها در فایل Excel ثبت شده است.
2. داده مصنوعی
دادهای است که با استفاده از روشهای آماری یا الگوریتمهای کامپیوتری تولید شده، اما برای اهدافی مانند آموزش، شبیهسازی، آزمون روش یا نمایش یک مثال استفاده میشود.
مثلاً برای آموزش SmartPLS یک دیتاست 300 نفری با مقیاس لیکرت 1 تا 5 تولید کنیم.
3. داده جعلی در پژوهش
اگر داده مصنوعی تولید شود و سپس در پایاننامه یا مقاله بهگونهای گزارش شود که گویی از افراد واقعی جمعآوری شده، این دیگر یک شبیهسازی آموزشی نیست و از نظر روششناسی پژوهش قابل قبول نیست.
بنابراین میتوان از داده مصنوعی برای تمرین تحلیل استفاده کرد، اما نباید آن را بهعنوان داده واقعی پژوهش گزارش کرد.
قبل از تولید داده، بهتر است مدل را مشخص کنیم.
حداقل باید این موارد را بدانیم:
تعداد سازههای پژوهش
نام سازهها
تعداد گویههای هر سازه
نوع مقیاس اندازهگیری
تعداد نمونه
روابط بین سازهها
نوع مدل اندازهگیری
هدف از تولید داده
برای مثال:
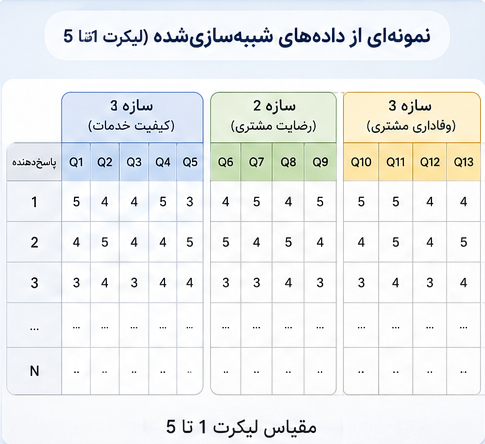
حجم نمونه: 250 نفر
مقیاس: لیکرت 1 تا 5
سازه اول: کیفیت خدمات، 5 گویه
سازه دوم: رضایت مشتری، 4 گویه
سازه سوم: وفاداری مشتری، 4 گویه
و فرض کنیم مدل ساختاری چنین باشد:
کیفیت خدمات → رضایت مشتری → وفاداری مشتری
اکنون میتوانیم دادهای تولید کنیم که با ساختار موردنظر سازگار باشد.
یکی از اشتباهات رایج این است که برای هر سلول Excel یک عدد تصادفی بین 1 تا 5 تولید کنیم.
مثلاً:
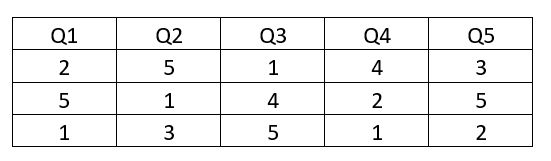
ممکن است این داده از نظر ظاهری شبیه پرسشنامه باشد، اما الزاماً برای یک مدل اندازهگیری مناسب نیست.
چرا؟
چون در یک پرسشنامه واقعی، گویههایی که یک سازه مشترک را اندازهگیری میکنند، معمولاً باید نوعی همبستگی و اشتراک واریانس داشته باشند.
مثلاً اگر پنج سؤال مختلف همگی «کیفیت خدمات» را اندازهگیری کنند، انتظار نداریم پاسخ آنها کاملاً مستقل از یکدیگر باشند.
بنابراین دادهسازی مناسب باید تا حدی ساختار آماری موردنظر مدل را بازتولید کند.
یکی از روشهای قابل استفاده این است که ابتدا برای هر سازه یک نمره نهفته ایجاد کنیم و سپس گویههای مربوط به آن سازه را بر اساس آن نمره تولید کنیم.
فرض کنید سازه «رضایت مشتری» یک متغیر نهفته دارد.
ابتدا میتوانیم برای هر پاسخدهنده یک نمره پایه برای رضایت ایجاد کنیم.
سپس چند گویه مرتبط با آن تولید کنیم:
SAT1
SAT2
SAT3
SAT4
این گویهها باید تا حدی تحت تأثیر همان سازه نهفته باشند، در حالی که مقدار مشخصی خطای تصادفی نیز داشته باشند.
به صورت مفهومی:
گویه = سازه نهفته + خطای اندازهگیری
این رویکرد از تولید مستقل و کاملاً تصادفی اعداد برای هر سؤال منطقیتر است.
فرض کنیم مدل ما این است:
کیفیت خدمات ← رضایت مشتری ← وفاداری مشتری
اگر قرار باشد داده مصنوعی برای این مدل تولید کنیم، باید رابطه بین سازهها نیز در داده وجود داشته باشد.
مثلاً میتوانیم فرض کنیم:
کیفیت خدمات بر رضایت مشتری اثر دارد.
رضایت مشتری بر وفاداری اثر دارد.
کیفیت خدمات نیز ممکن است مستقیماً بر وفاداری اثر داشته باشد.
در یک مدل شبیهسازیشده، این روابط را میتوان با ترکیب متغیرهای نهفته و خطا ایجاد کرد.
به صورت مفهومی:
رضایت = اثر کیفیت خدمات + خطا
و:
وفاداری = اثر رضایت + اثر کیفیت خدمات + خطا
در این حالت وقتی داده وارد SmartPLS شود، انتظار داریم مدل ساختاری نیز بتواند بخشی از این روابط را شناسایی کند.
در بسیاری از پژوهشهای علوم مدیریت، دادههای پرسشنامهای با مقیاس لیکرت تولید میشوند.
برای مثال:
1 = کاملاً مخالفم
2 = مخالفم
3 = نظری ندارم
4 = موافقم
5 = کاملاً موافقم
در نتیجه داده نهایی باید در محدوده 1 تا 5 قرار بگیرد.
اما یک نکته مهم وجود دارد:
اگر ابتدا داده پیوسته تولید کنیم و بعد آن را به نزدیکترین عدد صحیح بین 1 تا 5 تبدیل کنیم، ممکن است توزیع پاسخها نامناسب شود.
برای مثال، ممکن است تقریباً همه پاسخها در گزینههای 4 و 5 قرار بگیرند.
بنابراین هنگام شبیهسازی باید توزیع پاسخها نیز کنترل شود.
لزومی ندارد.
یکی از دلایلی که داده مصنوعی برای آموزش PLS-SEM جالب است، این است که میتوانیم سناریوهای مختلفی ایجاد کنیم.
مثلاً:
داده تقریباً نرمال
داده چوله
داده با پراکندگی زیاد
داده با همبستگی بالا بین گویهها
داده با روابط ضعیف بین سازهها
داده با روابط قوی بین سازهها
در PLS-SEM، نرمال بودن چندمتغیره دادهها مانند رویکردهای مبتنی بر کوواریانس یک پیشفرض مرکزی محسوب نمیشود. با این حال، این موضوع به معنی بیاهمیت بودن کیفیت دادهها نیست.
داده مصنوعی ضعیف میتواند نتایج غیرواقعی یا گمراهکننده ایجاد کند.
یکی از کاربردهای مهم داده مصنوعی، تمرین ارزیابی مدل اندازهگیری است.
فرض کنید سازه «اعتماد به برند» چهار گویه دارد:
TR1
TR2
TR3
TR4
پس از وارد کردن داده در SmartPLS میتوان شاخصهایی مانند:
Cronbach's Alpha
Composite Reliability
rho_A
Average Variance Extracted (AVE)
را بررسی کرد.
در یک مدل بازتابی، اگر گویهها واقعاً یک مفهوم مشترک را اندازهگیری کنند، معمولاً انتظار داریم همبستگی مناسبی بین آنها وجود داشته باشد.
البته نباید صرفاً برای رسیدن به اعداد «خوب» داده تولید کنیم و سپس نتیجه را به پژوهش واقعی تعمیم دهیم.
هدف داده مصنوعی در اینجا تمرین تحلیل و درک رفتار مدل است.
یکی دیگر از کاربردهای جالب شبیهسازی، بررسی روایی واگراست.
فرض کنید سه سازه داریم:
کیفیت خدمات
رضایت مشتری
وفاداری مشتری
اگر برای هر سه سازه دقیقاً یک الگوی عددی تولید کنیم، احتمالاً تمایز بین آنها از بین میرود.
بنابراین هنگام دادهسازی باید بین سازهها همبستگی وجود داشته باشد، اما این همبستگی نباید الزاماً آنقدر زیاد باشد که همه سازهها عملاً یک مفهوم را اندازهگیری کنند.
در SmartPLS میتوان برای ارزیابی این موضوع از شاخصهایی مانند HTMT استفاده کرد.
داده مصنوعی میتواند برای آموزش تحلیل میانجی نیز بسیار مفید باشد.
فرض کنید مدل زیر را داریم:
کیفیت خدمات ← رضایت مشتری ← وفاداری مشتری
در این مدل، رضایت مشتری نقش متغیر میانجی دارد.
برای اینکه داده شبیه یک سناریوی میانجی باشد، باید روابط بین متغیرها بهگونهای تولید شوند که مسیرهای مربوطه قابل بررسی باشند.
بعد از ورود داده به SmartPLS میتوان مسیرهای:
کیفیت خدمات ← رضایت
رضایت ←وفاداری
کیفیت خدمات ← وفاداری
را بررسی کرد و سپس با Bootstrapping اثر غیرمستقیم را آزمود.
فرض کنید میخواهیم بررسی کنیم آیا «تجربه مشتری» رابطه بین کیفیت خدمات و وفاداری را تعدیل میکند یا خیر.
در این حالت صرفاً تولید سه متغیر کافی نیست.
داده باید به شکلی شبیهسازی شود که شدت رابطه بین متغیر مستقل و وابسته در سطوح مختلف متغیر تعدیلگر متفاوت باشد.
مثلاً:
کیفیت خدمات × تجربه مشتری ← وفاداری
این موضوع باعث میشود داده مصنوعی برای تمرین مدلهای Moderation در SmartPLS نیز کاربرد داشته باشد.
مدلهای مرتبه دوم کمی پیچیدهتر هستند.
فرض کنید سازه «کیفیت خدمات» از سه بعد تشکیل شده است:
قابلیت اطمینان
پاسخگویی
تضمین
در این حالت نمیتوان صرفاً چند ستون با نامهای مختلف تولید کرد و آنها را یک سازه مرتبه دوم نامید.
ابتدا باید ساختار ابعاد پایینتر مشخص شود و سپس رابطه آنها با سازه سطح بالاتر تعریف شود.
برای مثال:
کیفیت خدمات
↙︎ ↓ ↘︎
قابلیت اطمینان | پاسخگویی | تضمین
داده مصنوعی میتواند برای تمرین روشهای مختلف مدلسازی سازههای مرتبه دوم در SmartPLS بسیار مفید باشد.
بله.
اگر دیتاست ساختار مناسبی داشته باشد، میتوان آن را در قالبهایی مانند Excel یا CSV آماده کرد و وارد SmartPLS کرد.
نکته مهم این است که نام ستونها باید منظم باشد.
برای مثال:
BR1
BR2
BR3
BR4
TR1
TR2
TR3
TR4
PI1
PI2
PI3
PI4
در این مثال:
BR = Brand Image
TR = Trust
PI = Purchase Intention
هر ردیف نیز نماینده یک مشاهده یا پاسخدهنده در دیتاست است.
اشتباه است که بلافاصله سراغ نتیجه آزمون فرضیهها برویم.
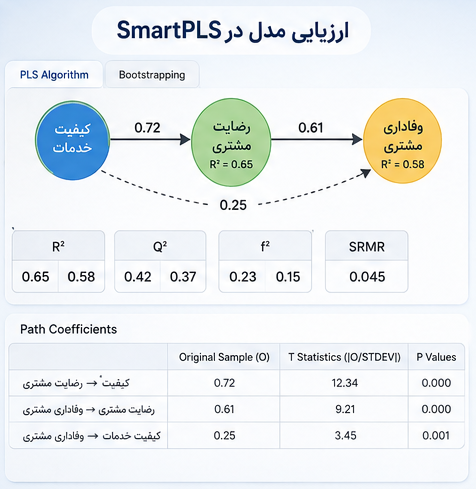
تحلیل PLS-SEM را بهتر است مرحلهبهمرحله انجام دهیم.
مرحله اول: مدل اندازهگیری
ابتدا باید بررسی کنیم گویهها سازههای موردنظر را به شکل مناسبی اندازهگیری میکنند یا خیر.
بسته به نوع سازه، شاخصهای مختلفی بررسی میشوند؛ از جمله:
Outer Loadings
Cronbach's Alpha
Composite Reliability
rho_A
AVE
HTMT
مرحله دوم: مدل ساختاری
پس از ارزیابی مدل اندازهگیری، میتوان سراغ روابط بین سازهها رفت.
در این مرحله شاخصهایی مانند موارد زیر اهمیت پیدا میکنند:
Path Coefficients
R²
f²
Q²
VIF
t-value
p-value
Confidence Intervals
این مهمترین نکته در دادهسازی است.
فرض کنید پژوهشگر میخواهد فرضیهاش تأیید شود. اگر داده مصنوعی را طوری بسازد که:
همه بارهای عاملی بالا باشند،
همه مسیرها معنادار شوند،
R² بسیار بالا باشد،
HTMT همیشه مطلوب باشد،
آنگاه دیگر دادهسازی به یک ابزار آموزشی تبدیل نمیشود؛ بلکه صرفاً به ساختن نتیجه دلخواه منجر شده است.
در شبیهسازی علمی، بهتر است حتی سناریوهای نامطلوب نیز بررسی شوند.
مثلاً:
یک سازه پایایی ضعیفی داشته باشد.
یک مسیر ساختاری معنادار نباشد.
همبستگی دو سازه بیش از حد زیاد شود.
یک گویه Loading پایینی داشته باشد.
R² پایین باشد.
این سناریوها اتفاقاً برای یادگیری SmartPLS بسیار مفید هستند؛ چون پژوهشگر یاد میگیرد در مواجهه با یک مدل ضعیف چه کاری باید انجام دهد.
یک دیتاست مصنوعی مناسب برای آموزش PLS-SEM باید دستکم از نظر منطقی با مدل سازگار باشد.
برای مثال:
از نظر اندازه نمونه
تعداد مشاهدهها باید مشخص و قابل توجیه باشد.
از نظر مقیاس
مقادیر باید با مقیاس تعریفشده، مثلاً 1 تا 5، سازگار باشند.
از نظر سازهها
گویههای مربوط به یک سازه باید ارتباط معقولی با متغیر نهفته آن داشته باشند.
از نظر روابط ساختاری
اگر هدف شبیهسازی یک مدل دارای اثر مثبت است، باید این رابطه در فرآیند تولید داده لحاظ شود.
از نظر خطا
داده نباید کاملاً بدون خطا تولید شود؛ زیرا چنین دادهای میتواند بیش از حد ایدهآل باشد.
از نظر توزیع
باید بررسی شود که داده تولیدشده دچار توزیع غیرواقعی یا تمرکز شدید روی یک گزینه نشده باشد.
تولید یا جمعآوری داده پایان کار نیست. قبل از ورود به مرحله نهایی تحلیل در SmartPLS، باید دادهها از نظر کیفیت، مقادیر گمشده، پاسخهای نامعتبر و سایر مشکلات احتمالی بررسی شوند.
اگر پس از اجرای مدل در SmartPLS با مشکلاتی مانند پایین بودن بارهای عاملی، AVE، پایایی یا برخی شاخصهای کیفیت مدل مواجه شدید، قبل از هرگونه تغییر در دادهها باید علت مشکل را بررسی کنید. در آموزش عملی اصلاح دادههای پرسشنامه و بهبود شاخصهای کیفیت مدل PLS، این فرآیند در Excel و SmartPLS بهصورت مرحلهبهمرحله آموزش داده شده است.
یک نکته مهم درباره «واقعی به نظر رسیدن» دادهها
هدف از دادهسازی علمی این نیست که داده مصنوعی را طوری تولید کنیم که تشخیص آن از داده واقعی غیرممکن باشد.
هدف اصلی، شبیهسازی یک سازوکار آماری مشخص است.
برای مثال ممکن است بخواهیم بررسی کنیم اگر یک سازه اثر متوسطی بر سازه دیگر داشته باشد، SmartPLS چه نتایجی تولید میکند.
در این حالت میتوانیم چندین بار شبیهسازی انجام دهیم و ببینیم نتایج چقدر تغییر میکنند.
این موضوع به حوزهای به نام Monte Carlo Simulation نیز نزدیک میشود.
یک مرحله بالاتر: تولید چندین دیتاست
به جای اینکه فقط یک دیتاست 200 نفری تولید کنیم، میتوانیم فرآیند را بارها تکرار کنیم.
مثلاً:
100 دیتاست با حجم نمونه 100
100 دیتاست با حجم نمونه 200
100 دیتاست با حجم نمونه 300
سپس بررسی کنیم که با افزایش حجم نمونه:
خطای برآورد چه تغییری میکند؟
احتمال شناسایی اثر واقعی چقدر تغییر میکند؟
ضرایب مسیر چقدر پایدار میشوند؟
خطای استاندارد چه تغییری دارد؟
این دیگر صرفاً «دادهسازی برای SmartPLS» نیست؛ بلکه میتواند به یک مطالعه شبیهسازی آماری تبدیل شود.
داده مصنوعی میتواند برای موارد زیر بسیار کاربردی باشد:
یادگیری SmartPLS
آموزش PLS-SEM
تمرین مدلسازی معادلات ساختاری
تست یک مدل قبل از جمعآوری داده واقعی
آموزش تحلیل میانجی
آموزش تحلیل تعدیلگری
تمرین مدلهای مرتبه دوم
بررسی رفتار شاخصهای پایایی و روایی
آموزش Bootstrapping
آزمایش الگوریتمهای آماری
شبیهسازی سناریوهای مختلف
اگر هدف شما این است که یک پایاننامه یا مقاله تجربی را با داده واقعی انجام دهید، داده مصنوعی جایگزین جمعآوری داده واقعی نیست.
برای مثال، اگر در روش تحقیق نوشته شده باشد:
«دادهها از 250 نفر از مشتریان شرکت X جمعآوری شد.»
باید واقعاً چنین دادهای وجود داشته باشد.
نمیتوان ابتدا داده مصنوعی تولید کرد و بعد آن را بهعنوان پاسخهای مشتریان شرکت X گزارش کرد.
اما میتوان همان مدل را قبل از اجرای پژوهش با داده مصنوعی آزمایش کرد تا مشکلات احتمالی مدل، پرسشنامه یا روش تحلیل مشخص شوند.
دادهسازی برای SmartPLS را نباید صرفاً به معنای تولید تعدادی عدد بین 1 تا 5 در Excel دانست.
یک داده مصنوعی مناسب باید با ساختار مدل اندازهگیری، روابط بین سازهها، مقیاس سنجش، میزان خطا و هدف شبیهسازی سازگار باشد.
اگر فقط اعداد تصادفی تولید کنیم، ممکن است دادهای داشته باشیم که ظاهراً شبیه پرسشنامه است، اما رفتار آماری مناسبی برای مدل PLS-SEM نداشته باشد.
روش بهتر این است که ابتدا سازههای نهفته و روابط آنها را تعریف کنیم، سپس گویهها را بر اساس این ساختار تولید کنیم و در نهایت دیتاست را در SmartPLS تحلیل کنیم.
مهمتر از همه، باید مرز بین شبیهسازی داده برای آموزش و پژوهش روششناختی و ساخت داده برای ارائه بهعنوان داده واقعی را حفظ کنیم.
اگر هدف شما یادگیری SmartPLS است، داده مصنوعی میتواند یک محیط امن برای تمرین باشد؛ محیطی که در آن میتوانید یک مدل را بارها اجرا کنید، خطا ایجاد کنید، نتایج را تغییر دهید و بدون دستکاری دادههای واقعی، منطق PLS-SEM را بهتر یاد بگیرید.
مسیر پیشنهادی برای شروع:
طراحی مدل ← تعریف سازهها ← تعیین گویهها ← تولید داده مصنوعی← کنترل کیفیت داده ← ورود به SmartPLS ← ارزیابی مدل اندازهگیری ← ارزیابی مدل ساختاری ← تفسیر نتایج
این رویکرد باعث میشود SmartPLS را نه بهعنوان مجموعهای از دکمهها، بلکه بهعنوان ابزاری برای آزمون یک مدل آماری یاد بگیرید.

