
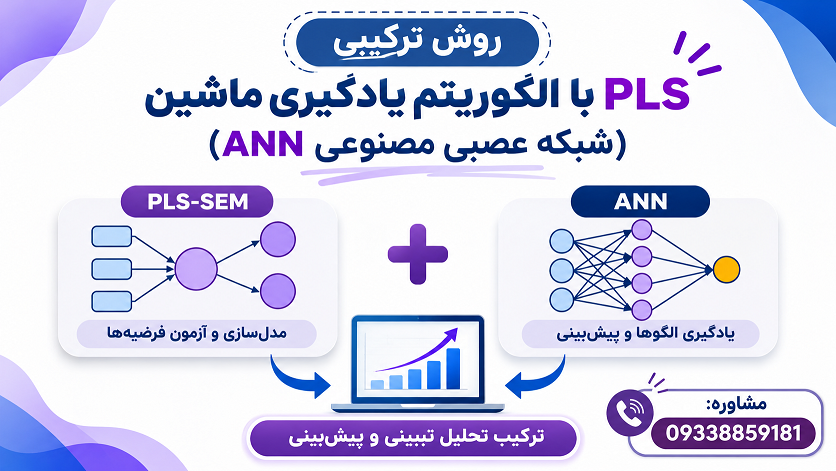
یکی از پرسشهایی که هنگام انجام پایاننامه یا نگارش مقاله علمی برای بسیاری از دانشجویان و پژوهشگران مطرح میشود، این است که آیا میتوان علاوه بر بررسی روابط بین متغیرها، قدرت پیشبینی مدل پژوهش را نیز ارزیابی کرد؟
برای پاسخ به این سؤال، استفاده از روش ترکیبی PLS-SEM و الگوریتم های یادگیری ماشین میتواند گزینه مناسبی باشد.
در این رویکرد، ابتدا مدل پژوهش با استفاده از روش حداقل مربعات جزئی (PLS) تحلیل میشود. در این مرحله، روابط بین متغیرها، ضرایب مسیر و معناداری فرضیهها مشخص میشوند. سپس با استخراج نمرات متغیرهای مکنون از نرمافزار SmartPLS، دادههای موردنیاز برای آموزش شبکه عصبی آماده میشوند.
در مرحله دوم، یکی از الگوریتم های یادگیری ماشین (مثلا شبکه عصبی مصنوعی) با استفاده از این دادهها آموزش میبیند تا بتواند الگوهای موجود در دادهها، روابط غیرخطی و قدرت پیشبینی متغیرهای وابسته را بررسی کند.
در این مقاله، مراحل اجرای روش ترکیبی PLS-SEM و یکی از مهمترین الگوریتمهای یادگیری ماشین بنام شبکه عصبی مصنوعی (ANN) را به زبان ساده توضیح میدهیم.
روش PLS-SEM مخفف Partial Least Squares Structural Equation Modeling و به معنای مدلسازی معادلات ساختاری با رویکرد حداقل مربعات جزئی است.
این روش یکی از رویکردهای پرکاربرد برای تحلیل روابط بین متغیرهای پنهان یا مکنون در پژوهشهای مدیریتی، بازاریابی، علوم انسانی و سایر حوزههای پژوهشی است.
برای مثال، فرض کنید پژوهشگری قصد دارد تأثیر قابلیتهای هوش مصنوعی بر تابآوری زنجیره تأمین را بررسی کند. در این پژوهش، قابلیتهای هوش مصنوعی، نوآوری فناورانه، هوشمندی تصمیمگیری و تابآوری زنجیره تأمین متغیرهایی هستند که با استفاده از مجموعهای از گویههای پرسشنامه اندازهگیری میشوند.
پژوهشگر با استفاده از PLS-SEM میتواند روابط بین این متغیرها را در قالب یک مدل مفهومی بررسی کند. چنانچه قصد یادگیری آموزش کامل smart PLS را دارید پست آموزش PLS را مشاهده کنید.
بررسی روابط مستقیم بین متغیرهای مستقل و وابسته
بررسی اثرات میانجی و تعدیلگر
آزمون فرضیههای پژوهش
ارزیابی پایایی و روایی سازهها
بررسی قدرت تبیین متغیرهای وابسته
ارزیابی قدرت پیشبینی مدل
یکی از دلایل استفاده از این روش، انعطافپذیری آن در تحلیل مدلهای پیچیده و مدلهای دارای متغیرهای مکنون است. البته انتخاب PLS-SEM باید با توجه به هدف پژوهش، ساختار مدل، ویژگیهای دادهها و الزامات روششناختی انجام شود.
شبکه عصبی مصنوعی یا Artificial Neural Network یکی از روشهای یادگیری ماشین است که ساختار آن با الهام از نحوه ارتباط نورونهای مغز انسان طراحی شده است.
در شبکه عصبی، اطلاعات از طریق مجموعهای از واحدهای محاسباتی به نام نورون پردازش میشوند. این نورونها در لایههای مختلف قرار میگیرند و با استفاده از وزنها و توابع فعالسازی، الگوهای موجود در دادهها را یاد میگیرند.
یک شبکه عصبی معمولاً از سه بخش اصلی تشکیل میشود:
در این لایه، دادههای ورودی به شبکه وارد میشوند. برای مثال، اگر هدف پیشبینی تابآوری زنجیره تأمین باشد، متغیرهایی مانند قابلیتهای هوش مصنوعی، نوآوری فناورانه و هوشمندی تصمیمگیری میتوانند ورودی شبکه باشند.
این لایه وظیفه پردازش دادهها و شناسایی الگوهای موجود بین متغیرهای ورودی را بر عهده دارد. شبکه عصبی میتواند با استفاده از چندین نورون و تابع فعالسازی، روابط پیچیده و غیرخطی را مدلسازی کند.
در این لایه، نتیجه نهایی شبکه تولید میشود. در مثال بالا، خروجی شبکه میتواند مقدار پیشبینیشده تابآوری زنجیره تأمین باشد.
شبکه عصبی در ابتدا وزنهای اولیهای را برای ارتباط بین نورونها در نظر میگیرد. سپس دادههای آموزشی را دریافت میکند و خروجی پیشبینیشده را با مقدار واقعی مقایسه میکند.
اختلاف این دو مقدار بهعنوان خطا محاسبه میشود. شبکه با استفاده از الگوریتمهایی مانند پسانتشار خطا (Backpropagation) و روشهای بهینهسازی، وزنهای خود را اصلاح میکند تا خطای پیشبینی کاهش یابد.
این فرایند چندین بار تکرار میشود تا شبکه بتواند الگوهای موجود در دادهها را یاد بگیرد.
روش PLS-SEM و شبکه عصبی مصنوعی اهداف یکسانی ندارند و هرکدام بخشی از مسئله پژوهش را بررسی میکنند.
در PLS-SEM، پژوهشگر به دنبال پاسخ به این سؤال است که آیا روابط نظری بین متغیرها تأیید میشوند یا خیر. برای مثال، آیا قابلیتهای هوش مصنوعی بر نوآوری فناورانه تأثیر مثبت و معناداری دارند؟
اما در یادگیری ماشین، تمرکز اصلی بر یادگیری الگوهای موجود در دادهها و پیشبینی مقادیر متغیر هدف است. شبکه عصبی میتواند روابط غیرخطی را نیز شناسایی کند؛ روابطی که ممکن است با یک مدل خطی بهخوبی نمایش داده نشوند.
به همین دلیل، ترکیب این دو روش میتواند تصویر کاملتری از مسئله پژوهش ارائه دهد.
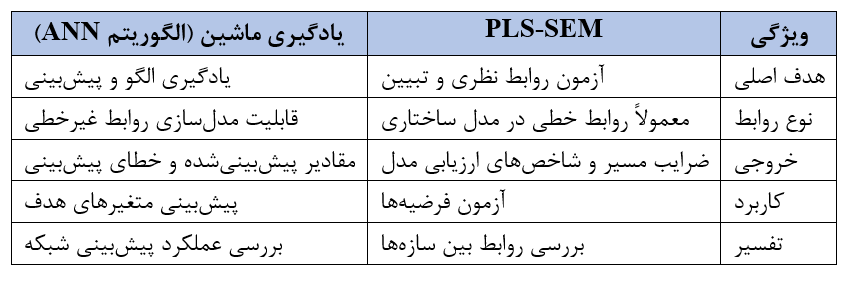
در این رویکرد، PLS-SEM مرحله نخست تحلیل است و ANN در مرحله بعدی برای تکمیل تحلیل و ارزیابی عملکرد پیشبینی به کار میرود.
نکته مهم این است که ANN جایگزین آزمون فرضیهها نمیشود و معناداری روابط را به همان شیوه PLS بررسی نمیکند.
برای اجرای این روش، بهتر است فرایند تحلیل را به چند مرحله مشخص تقسیم کنیم.
ابتدا باید موضوع پژوهش، متغیرها و روابط مورد انتظار بین آنها مشخص شوند.
برای مثال، فرض کنید موضوع پژوهش عبارت است از:
«تأثیر هوش مصنوعی بر تابآوری با نقش میانجی فناوری و تصمیم گیری».
مدل مفهومی این پژوهش شامل چهار متغیر اصلی است:
هوش مصنوعی: متغیر مستقل
فناوری: متغیر میانجی
تصمیمگیری: متغیر میانجی
تابآوری: متغیر وابسته
در این مرحله، فرضیههای پژوهش تدوین میشوند و روابط مستقیم و غیرمستقیم مورد انتظار مشخص میشوند.
پس از طراحی مدل، پرسشنامه پژوهش تهیه و بین اعضای جامعه آماری توزیع میشود.
برای مثال، اگر جامعه آماری شامل مدیران و کارشناسان شرکتهای تولیدی باشد، پرسشنامه میتواند با استفاده از طیف پنجدرجهای لیکرت طراحی شود.
دادههای جمعآوریشده باید پیش از تحلیل بررسی شوند. مواردی مانند دادههای گمشده، پاسخهای غیرعادی، کدگذاری اشتباه و کیفیت پاسخها اهمیت زیادی دارند.
در این مرحله، دادهها وارد نرمافزار SmartPLS میشوند و مدل پژوهش اجرا میشود.
ابتدا مدل اندازهگیری ارزیابی میشود. در این بخش، شاخصهایی مانند موارد زیر اهمیت دارند:
بارهای عاملی (Outer Loadings)
آلفای کرونباخ (Cronbach's Alpha)
پایایی ترکیبی (Composite Reliability)
میانگین واریانس استخراجشده (AVE)
نسبت HTMT برای بررسی روایی واگرا
پس از ارزیابی مدل اندازهگیری، نوبت به مدل ساختاری میرسد.
در این بخش، ضرایب مسیر، ضریب تعیین (R²)، اندازه اثر (f²)، قدرت پیشبینی (Q²) و نتایج آزمون بوتاسترپ بررسی میشوند.
با استفاده از Bootstrapping میتوان مشخص کرد که روابط بین متغیرها از نظر آماری معنادار هستند یا خیر.
در پایان این مرحله، پژوهشگر مشخص میکند کدام روابط در مدل تأیید شدهاند و چه متغیرهایی در تبیین متغیر وابسته نقش دارند.
این مرحله یکی از مهمترین بخشهای روش ترکیبی است.
پس از اجرای PLS، باید نمرات متغیرهای مکنون یا Latent Variable Scores استخراج شوند.
این نمرات نشان میدهند که هر پاسخدهنده با توجه به پاسخهایش به گویههای پرسشنامه، چه امتیازی در هر یک از سازههای پژوهش به دست آورده است.
برای مثال، اگر ۱۵۰ پرسشنامه معتبر داشته باشیم و مدل شامل چهار متغیر مکنون باشد، فایل خروجی میتواند شامل ۱۵۰ ردیف و چهار ستون اصلی مربوط به نمرات این متغیرها باشد.
این نمرات با ضرایب مسیر تفاوت دارند. ضرایب مسیر برای نمایش شدت و جهت روابط بین سازهها استفاده میشوند، اما نمرات متغیرهای مکنون، امتیاز هر فرد در سازه موردنظر را نشان میدهند.
برای استفاده از ANN، معمولاً همین نمرات در سطح پاسخدهنده مبنای آمادهسازی دادهها قرار میگیرند.
پس از استخراج نمرات متغیرهای مکنون، باید مشخص کنیم کدام متغیرها وارد شبکه عصبی شوند و کدام متغیر بهعنوان خروجی پیشبینی شود.
برای مثال، در مدل پژوهش ما، اگر هدف پیشبینی تابآوری زنجیره تأمین باشد، ساختار شبکه میتواند به شکل زیر تعریف شود:
متغیرهای ورودی:
قابلیتهای هوش مصنوعی
نوآوری فناورانه
هوشمندی تصمیمگیری
متغیر خروجی:
تابآوری زنجیره تأمین
به این ترتیب، شبکه عصبی تلاش میکند با استفاده از اطلاعات سه متغیر ورودی، مقدار متغیر وابسته را پیشبینی کند.
البته انتخاب ورودیها باید با ساختار مدل نظری و هدف پیشبینی هماهنگ باشد. اگر چند متغیر وابسته در مدل وجود داشته باشند، میتوان برای هر متغیر هدف یک شبکه جداگانه طراحی کرد.
پیش از آموزش شبکه عصبی، دادهها باید آماده شوند.
مهمترین اقدامات این مرحله عبارتاند از:
بررسی دادههای گمشده و مقادیر غیرعادی
بررسی مقیاس و دامنه متغیرها
نرمالسازی یا استانداردسازی دادهها در صورت نیاز
تفکیک دادهها به مجموعه آموزش و آزمون
جلوگیری از ورود اطلاعات مجموعه آزمون به فرایند آموزش
بهعنوان مثال، در یک پژوهش با ۲۰۰ مشاهده میتوان ۷۰ درصد دادهها را برای آموزش و ۳۰ درصد را برای آزمون در نظر گرفت. این تقسیمبندی یک انتخاب متداول است، نه یک قانون ثابت؛ نسبت مناسب به حجم نمونه و طراحی اعتبارسنجی بستگی دارد.
اکنون دادهها برای آموزش شبکه آماده هستند.
در این مرحله، پژوهشگر باید ساختار شبکه عصبی را مشخص کند. مهمترین تنظیمات عبارتاند از:
تعداد لایههای پنهان
تعداد نورونها در هر لایه
تابع فعالسازی
الگوریتم آموزش
نرخ یادگیری (Learning Rate)
تعداد تکرارهای آموزش (Epochs)
برای مثال، یک شبکه ساده میتواند شامل سه نورون در لایه ورودی، یک لایه پنهان با پنج نورون و یک نورون در لایه خروجی باشد.
البته این ساختار صرفاً یک مثال آموزشی است. تعداد لایهها و نورونها باید با استفاده از اعتبارسنجی و مقایسه عملکرد مدلهای مختلف انتخاب شود.
پس از تعیین معماری شبکه، دادههای آموزشی به آن وارد میشوند و شبکه با تکرار فرایند آموزش، وزنهای ارتباطی بین نورونها را تنظیم میکند.
پس از آموزش شبکه، باید عملکرد آن را با استفاده از دادههای آزمون ارزیابی کنیم.
برای این منظور، چند شاخص آماری کاربرد زیادی دارند:
۱. ضریب تعیین (R²)
این شاخص نشان میدهد مدل چه میزان از تغییرات متغیر وابسته را توضیح میدهد. در ارزیابی پیشبینی، بهتر است R² روی دادههای آزمون نیز محاسبه شود.
۲. میانگین مربعات خطا (MSE)
این شاخص میانگین مجذور اختلاف بین مقادیر واقعی و پیشبینیشده را محاسبه میکند. هرچه مقدار آن کمتر باشد، خطای پیشبینی کمتر است.
۳. جذر میانگین مربعات خطا (RMSE)
این شاخص جذر MSE است و خطای پیشبینی را در واحد متغیر هدف نشان میدهد.
۴. میانگین قدرمطلق خطا (MAE)
این شاخص میانگین قدرمطلق اختلاف بین مقادیر واقعی و پیشبینیشده را محاسبه میکند.
بهتر است عملکرد شبکه در دادههای آموزش و آزمون جداگانه گزارش شود. اگر عملکرد مدل در دادههای آموزش بسیار خوب، اما در دادههای آزمون ضعیف باشد، احتمال بیشبرازش (Overfitting) وجود دارد.
یکی از سؤالات عملی پژوهشگران این است که دقیقاً کدام خروجی SmartPLS باید وارد شبکه عصبی شود؟
پاسخ این است که در رویکرد متداول ، از نمرات متغیرهای مکنون (Latent Variable Scores) برای تشکیل مجموعه داده شبکه عصبی استفاده میشود.
برای درک بهتر، فرض کنید مدل پژوهش شامل چهار سازه باشد:
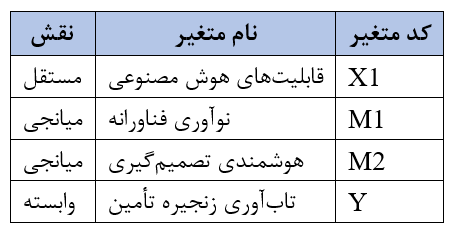
پس از اجرای SmartPLS، نمرات این چهار سازه برای هر پاسخدهنده استخراج میشوند.
ساختار فایل داده میتواند به شکل زیر باشد:
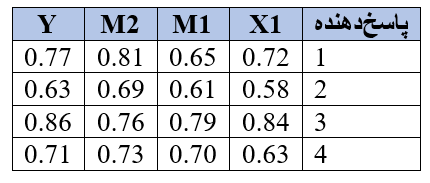
در این ساختار، هر ردیف نشاندهنده یک پاسخدهنده و هر ستون نشاندهنده نمره یکی از متغیرهای مکنون است.
اکنون میتوان با توجه به مدل پژوهش، ستونهای موردنیاز را برای آموزش شبکه عصبی انتخاب کرد.
یک نکته روششناختی مهم وجود دارد: صرف استخراج نمرات از کل نمونه و سپس تقسیم آنها به آموزش و آزمون، همیشه اعتبارسنجی کاملاً مستقل ایجاد نمیکند؛ زیرا اطلاعات کل نمونه در برآورد مدل اولیه PLS استفاده شده است. برای ارزیابی دقیقتر پیشبینی، باید برآورد مدل و استخراج نمرات نیز در چارچوب اعتبارسنجی انجام شوند؛ برای مثال با تفکیک آموزش و آزمون از ابتدا یا استفاده از اعتبارسنجی متقاطع و تکرار فرایند برآورد در هر بخش.
پس از آمادهسازی دادهها، باید نرمافزار مناسبی برای اجرای ANN انتخاب کنیم.
چند ابزار پرکاربرد برای این کار وجود دارند:
MATLAB
این نرمافزار امکانات مناسبی برای طراحی و آموزش شبکههای عصبی دارد. پژوهشگران میتوانند با استفاده از ابزارهای مرتبط، معماری شبکه را تعریف و عملکرد آن را ارزیابی کنند.
Python
زبان برنامهنویسی Python به دلیل داشتن کتابخانههای متنوع یادگیری ماشین، یکی از گزینههای مناسب برای اجرای ANN است.
برخی کتابخانههای پرکاربرد عبارتاند از:
TensorFlow
Keras
Scikit-learn
PyTorch
SPSS
این نرمافزار نیز امکاناتی برای تحلیل شبکه عصبی و برخی مدلهای پیشبینی ارائه میدهد. بااینحال، برای طراحی معماریهای سفارشی و اجرای فرایندهای پیشرفته یادگیری ماشین، Python و MATLAB انعطافپذیری بیشتری دارند.
Excel
از Excel میتوان برای آمادهسازی اولیه دادهها، بررسی ستونها، اصلاح ساختار فایل و انتقال اطلاعات بین نرمافزارها استفاده کرد؛ اما برای آموزش حرفهای شبکه عصبی، ابزار اصلی مناسبی نیست.
برای اینکه فرایند اجرای این روش روشنتر شود، یک مثال از حوزه مدیریت زنجیره تأمین را در نظر بگیریم.
فرض کنید پژوهشگری میخواهد بررسی کند که قابلیتهای هوش مصنوعی چگونه بر تابآوری زنجیره تأمین تأثیر میگذارند.
مدل مفهومی شامل چهار متغیر است:
قابلیتهای هوش مصنوعی
نوآوری فناورانه
هوشمندی تصمیمگیری
تابآوری زنجیره تأمین
در مرحله نخست، پژوهشگر دادههای پرسشنامه را وارد SmartPLS میکند و مدل را اجرا میکند.
نتایج نشان میدهند که قابلیتهای هوش مصنوعی بر نوآوری فناورانه و هوشمندی تصمیمگیری اثر مثبت و معنادار دارند. همچنین این دو متغیر بر تابآوری زنجیره تأمین تأثیر میگذارند.
در این مرحله، پژوهشگر میتواند فرضیههای مربوط به روابط مستقیم و غیرمستقیم را بررسی کند.
در مرحله دوم، نمرات متغیرهای مکنون استخراج میشوند. سپس سه متغیر قابلیتهای هوش مصنوعی، نوآوری فناورانه و هوشمندی تصمیمگیری بهعنوان ورودی و تابآوری زنجیره تأمین بهعنوان خروجی شبکه عصبی تعریف میشوند.
شبکه با دادههای آموزشی یاد میگیرد که ترکیب مقادیر متغیرهای ورودی چه ارتباطی با مقدار تابآوری زنجیره تأمین دارد.
در نهایت، با استفاده از دادههای آزمون، میزان دقت پیشبینی شبکه بررسی میشود.
در این مثال، دو دسته نتیجه به دست میآید:
نتایج PLS-SEM: مشخص میکنند روابط نظری بین متغیرها تا چه اندازه تأیید شدهاند.
نتایج ANN: نشان میدهند شبکه عصبی با چه دقتی میتواند مقدار متغیر وابسته را پیشبینی کند.
به این ترتیب، پژوهشگر علاوه بر آزمون فرضیهها، شواهدی درباره عملکرد پیشبینی مدل نیز در اختیار خواهد داشت.
ترکیب این دو روش مزایای مشخصی دارد، اما اجرای آن بدون توجه به محدودیتها میتواند به نتایج گمراهکننده منجر شود.
مزایای روش ترکیبی
۱. ترکیب تحلیل تبیینی و پیشبینی
PLS-SEM برای بررسی روابط نظری و ANN برای یادگیری الگوهای پیشبینی به کار میروند. استفاده از هر دو روش میتواند جنبههای متفاوت مسئله پژوهش را پوشش دهد.
۲. امکان شناسایی روابط غیرخطی
شبکه عصبی میتواند روابط پیچیدهای را مدلسازی کند که در یک مدل خطی بهخوبی نمایش داده نمیشوند.
۳. استفاده از نمرات متغیرهای مکنون
بهجای ورود مستقیم تمام گویههای پرسشنامه به شبکه عصبی، میتوان از نمرات سازهها استفاده کرد. این کار در بسیاری از مدلهای پژوهشی، ساختار ورودی را سادهتر میکند.
۴. بررسی اهمیت نسبی متغیرهای ورودی
با استفاده از روشهایی مانند تحلیل حساسیت میتوان سهم نسبی متغیرهای ورودی را در پیشبینی خروجی بررسی کرد.
محدودیتهای روش ترکیبی
۱. نیاز به داده کافی
شبکه عصبی برای یادگیری الگوهای قابل تعمیم به داده کافی نیاز دارد. حجم نمونه کم، بهخصوص در کنار معماری پیچیده، احتمال بیشبرازش را افزایش میدهد.
۲. دشواری تفسیر شبکه عصبی
در مقایسه با ضرایب مسیر PLS، تفسیر روابط در شبکه عصبی معمولاً پیچیدهتر است.
۳. احتمال بیشبرازش
اگر شبکه بیش از اندازه پیچیده باشد یا دادههای آموزشی کافی نباشند، ممکن است دادههای آموزش را بهخوبی یاد بگیرد، اما در مواجهه با دادههای جدید عملکرد ضعیفی داشته باشد.
۴. اهمیت اعتبارسنجی
صرف گزارش شاخصهای عملکرد شبکه در دادههای آموزش برای اثبات قدرت پیشبینی کافی نیست. عملکرد مدل باید روی دادههای مستقل یا در چارچوب اعتبارسنجی متقاطع ارزیابی شود.
۵. محدودیت در تعمیم نتایج
نتایج یک شبکه عصبی که روی یک نمونه مشخص آموزش دیده است، لزوماً به جامعه آماری دیگر قابل تعمیم نیست.
استفاده از این روش زمانی منطقی است که پژوهشگر دو هدف داشته باشد:
نخست، بررسی روابط نظری بین متغیرها و آزمون فرضیهها؛ دوم، ارزیابی توانایی مدل در پیشبینی یک یا چند متغیر وابسته.
برای مثال، در موضوعاتی مانند موارد زیر میتوان از این رویکرد استفاده کرد:
پیشبینی تابآوری زنجیره تأمین
پیشبینی وفاداری مشتریان
پیشبینی عملکرد سازمانی
پیشبینی قصد خرید مصرفکنندگان
پیشبینی پذیرش فناوری
پیشبینی عملکرد نوآوری
پیشبینی رضایت و تعامل کارکنان
پیشبینی رفتار مصرفکننده
البته در هر پژوهش باید مشخص شود که استفاده از ANN چه ارزش افزودهای نسبت به تحلیل PLS ایجاد میکند. اگر هدف صرفاً آزمون چند فرضیه خطی باشد، اضافه کردن شبکه عصبی الزاماً ضروری نیست.
روش ترکیبی PLS-SEM و یادگیری ماشین یکی از رویکردهای قابل استفاده برای پژوهشهایی است که هم به آزمون روابط نظری و هم به پیشبینی متغیرهای وابسته نیاز دارند.
در این رویکرد، ابتدا مدل پژوهش با استفاده از SmartPLS تحلیل میشود. پس از ارزیابی مدل اندازهگیری و ساختاری و بررسی فرضیهها، نمرات متغیرهای مکنون استخراج میشوند. سپس این نمرات، با توجه به ساختار روابط پژوهش، برای طراحی و آموزش شبکه عصبی مصنوعی به کار میروند.
در مرحله پایانی، عملکرد شبکه با شاخصهایی مانند R²، MSE، RMSE و MAE ارزیابی میشود.
نکته اصلی این است که PLS-SEM و ANN دو روش مکمل با اهداف متفاوت هستند. PLS به پژوهشگر کمک میکند روابط بین سازهها را بررسی کند و ANN امکان یادگیری الگوهای پیچیده و ارزیابی پیشبینی را فراهم میآورد.
اگر مراحل آمادهسازی داده، طراحی شبکه و اعتبارسنجی بهدرستی انجام شوند، این رویکرد میتواند اطلاعات بیشتری درباره ساختار روابط و توان پیشبینی مدل پژوهش در اختیار محقق قرار دهد.
چنانچه در این زمینه نیاز به مشاوره و تحلیل داشتید با ما تماس بگیرید 09338859181 .

