
چند ماه پیش توسط تیم ما یک ریسرچ در راستای بهبود عملکرد مدل DeepSeek-R1 در زبان و ادبیات فارسی شکل گرفت و در این وبلاگ، میخوایم درمورد روش های استفاده شده و دستاورد های این پروژه و همچنین چالش هایی که در طول انجام این ریسرچ برامون پیش اومد توضیح بدیم.
اوایل ژانویه ۲۰۲۵ که مدل DeepSeek-R1 معرفی شد، حسابی سر و صدا کرد تو دنیای هوش مصنوعی. همه جا صحبت از قدرت استدلالش بود و خیلیها اون رو یک رقیب جدی برای مدلهای بزرگ دنیا میدونستن.
ولی یه چیز کاملاً مشخص بود: عملکردش در زبان فارسی خیلی ضعیف بود. مخصوصاً توی ادبیات فارسی که حتی توی املای سادهی کلمات یا سبک نوشتار هم اشتباه زیادی داشت. همین شکاف باعث شد ایدهی اصلی این پروژه شکل بگیره:
«میشه DeepSeek R1 رو توی درک زبان و ادبیات فارسی تقویت کرد؟»
یکی از اولین چالشها این بود که کدوم نسخهی R1 رو انتخاب کنیم. برای ما یه سؤال کلیدی مطرح بود:
«آیا نسخههای کوچیکتر R1 ظرفیت این رو دارن که با آموزش هدفمند تقویت بشن؟»
بر اساس همین سؤال، سراغ نسخهی DeepSeek R1 32B Qwen Distill رفتیم. دلیلش هم این بود که:
هم جواب خوبی به اون سؤال میداد،
هم محدودیت منابع محاسباتی رو تا حد زیادی حل میکرد.
یکی از پایههای اصلی پروژه طراحی و ساخت دیتاستهای خاص برای زبان فارسی بود. هدفمون فقط این نبود که روی تسکهای استاندارد NLP بهتر عمل کنه، بلکه میخواستیم در شعر و ادبیات فارسی هم مدل پیشرفت کنه درنتیجه چهار دیتاست اصلی آماده شد:
1. دیتاست Embedding شعر
شامل حدود ۸۵۰ هزار بیت از بیش از ۱۰۰ شاعر.
ساختار سهتایی (Anchor, Positive, Negative).
هدف: آموزش مدل Embedding برای نزدیککردن ابیات مشابه و در نهایت ساخت یک دیتاست ارزشمند.
2. دیتاست بنچمارک شعر
از ۷۶ شاعر، هرکدوم حدود ۱۰۰ شعر (۲۰ تا ۲۵ بیت).
همه شعرها به نثر روان بازنویسی شدن.
مدل باید نثر رو دوباره به شعر برمیگردوند و خروجی با کمک o3-mini ارزیابی میشد.
3. دیتاست استدلال فارسی
شامل حدود ۴۰ هزار سؤال استدلالی.
با کمک مدلهای مختلف مثل o1-mini، o3-mini، Gemini 1.5 Pro و GPT-4o ساخته شد.
شامل ۸ دستهی سوال در دو سطح دشواری (متوسط و سخت).
هدف: تقویت استدلال فارسی در فاز اول آموزش.
4. دیتاست خلاقیت شعری
حدود ۳ تا ۴ هزار پرامپت شعری (غزل، رباعی و …) با محدودیت خروجی حداکثر ۵ بیت.
تمرکز روی خلاقیت و تولید شعر کوتاه.
جمعآوری این دیتاستها خودش یکی از سختترین مراحل بود. باید از منابع معتبر داده میگرفتیم، دادههای مخرب رو حذف میکردیم و اشعار فارسی رو از عربی و زبانهای دیگه جدا میکردیم تا دیتاستها باکیفیت بشن.
آموزش این مدل رو توی دو فاز جدا انجام دادیم، هرکدوم با اهداف و دیتاستهای خودشون.
هدف از این فاز آموزشی بالا بردن توانایی مدل در درک و استدلال فارسی (بهعنوان پایه برای بهبود متن و شعر) بود.
روند کار:
پرسشها به مدل داده میشدن،
جوابها ثبت و با o3-mini ارزیابی میشدن.
معیارها:
صحت Chain-of-Thought فارسی
انسجام و کیفیت منطق
ارتباط CoT با جواب نهایی
در نهایت امتیازها بهعنوان reward وارد الگوریتم PPO شدن.
نتیجه: بدون هیچ دیتاست شعری، کیفیت شعر حدود ۱۲٪ بهتر شد.
هدف از فاز دوم آموزشی تمرکز مستقیم روی کیفیت شعر بود.
دیتاست: دیتاست خلاقیت شعری.
روند آموزش:
پرامپتها به مدل داده میشدن و خروجی شعر توسط o3-mini بررسی میشد.
معیارهای ارزیابی:
رعایت وزن عروضی
استفاده از صنایع ادبی
روان بودن و دستور زبان
کیفیت کلی شعر
امتیازها دوباره بهصورت reward signal وارد الگوریتم PPO شدن.
نتیجه: حدود ۱۰٪ بهبود اضافه و در مجموع نزدیک به ۲۲٪ رشد نسبت به مدل خام 32B.
برای سنجش پیشرفت، یک فریمورک جامع و اختصاصی طراحی کردیم که شامل دو نوع تسک بود:
مدل روی چندین تسک عمومی تست شد:
Persian MMLU (Khayyam)
Persian Math
ParsiNLU Entailment
FarsTail Entailment
ترجمه فارسی ↔ انگلیسی (ParsiNLU MT)
Reading Comprehension (ParsiNLU)
Persian News Summary
نتیجه: مدل بعد از آموزش، در اکثر تسکها به سطح مدل 72B نزدیک شد و بهطور متوسط بیش از ۷٪ بهتر از نسخه خام عمل کرد.
چون هدف اصلی تقویت مدل در شعر و ادبیات فارسی بود، یک بنچمارک اختصاصی برای این بخش طراحی کردیم.
معیارها: وزن عروضی، صنایع ادبی، روانی متن، کیفیت کلی.
پیشرفتها:
فاز اول (استدلال): +۱۲٪
فاز دوم (شعر): +۱۰٪
مجموع: ~۲۲٪ رشد نسبت به نسخه خام.
مدل DeepSeek-R1 32B Distill بعد از دو فاز آموزش، رشد قابلتوجهی در ارزیابی ها داشت:
Persian MMLU: 22.3٪ → 27.0٪ (+4.7٪)
ParsiNLU Entailment: 70.8٪ → 76.9٪ (+6.1٪)
FarsTail Entailment: 72.7٪ → 79.4٪ (+6.7٪)
Reading Comprehension: 60.2٪ → 67.3٪ (+7.1٪)
Persian News Summary: 24.5٪ → 29.6٪ (+5.1٪)
Translation Fa↔En: ~+4٪
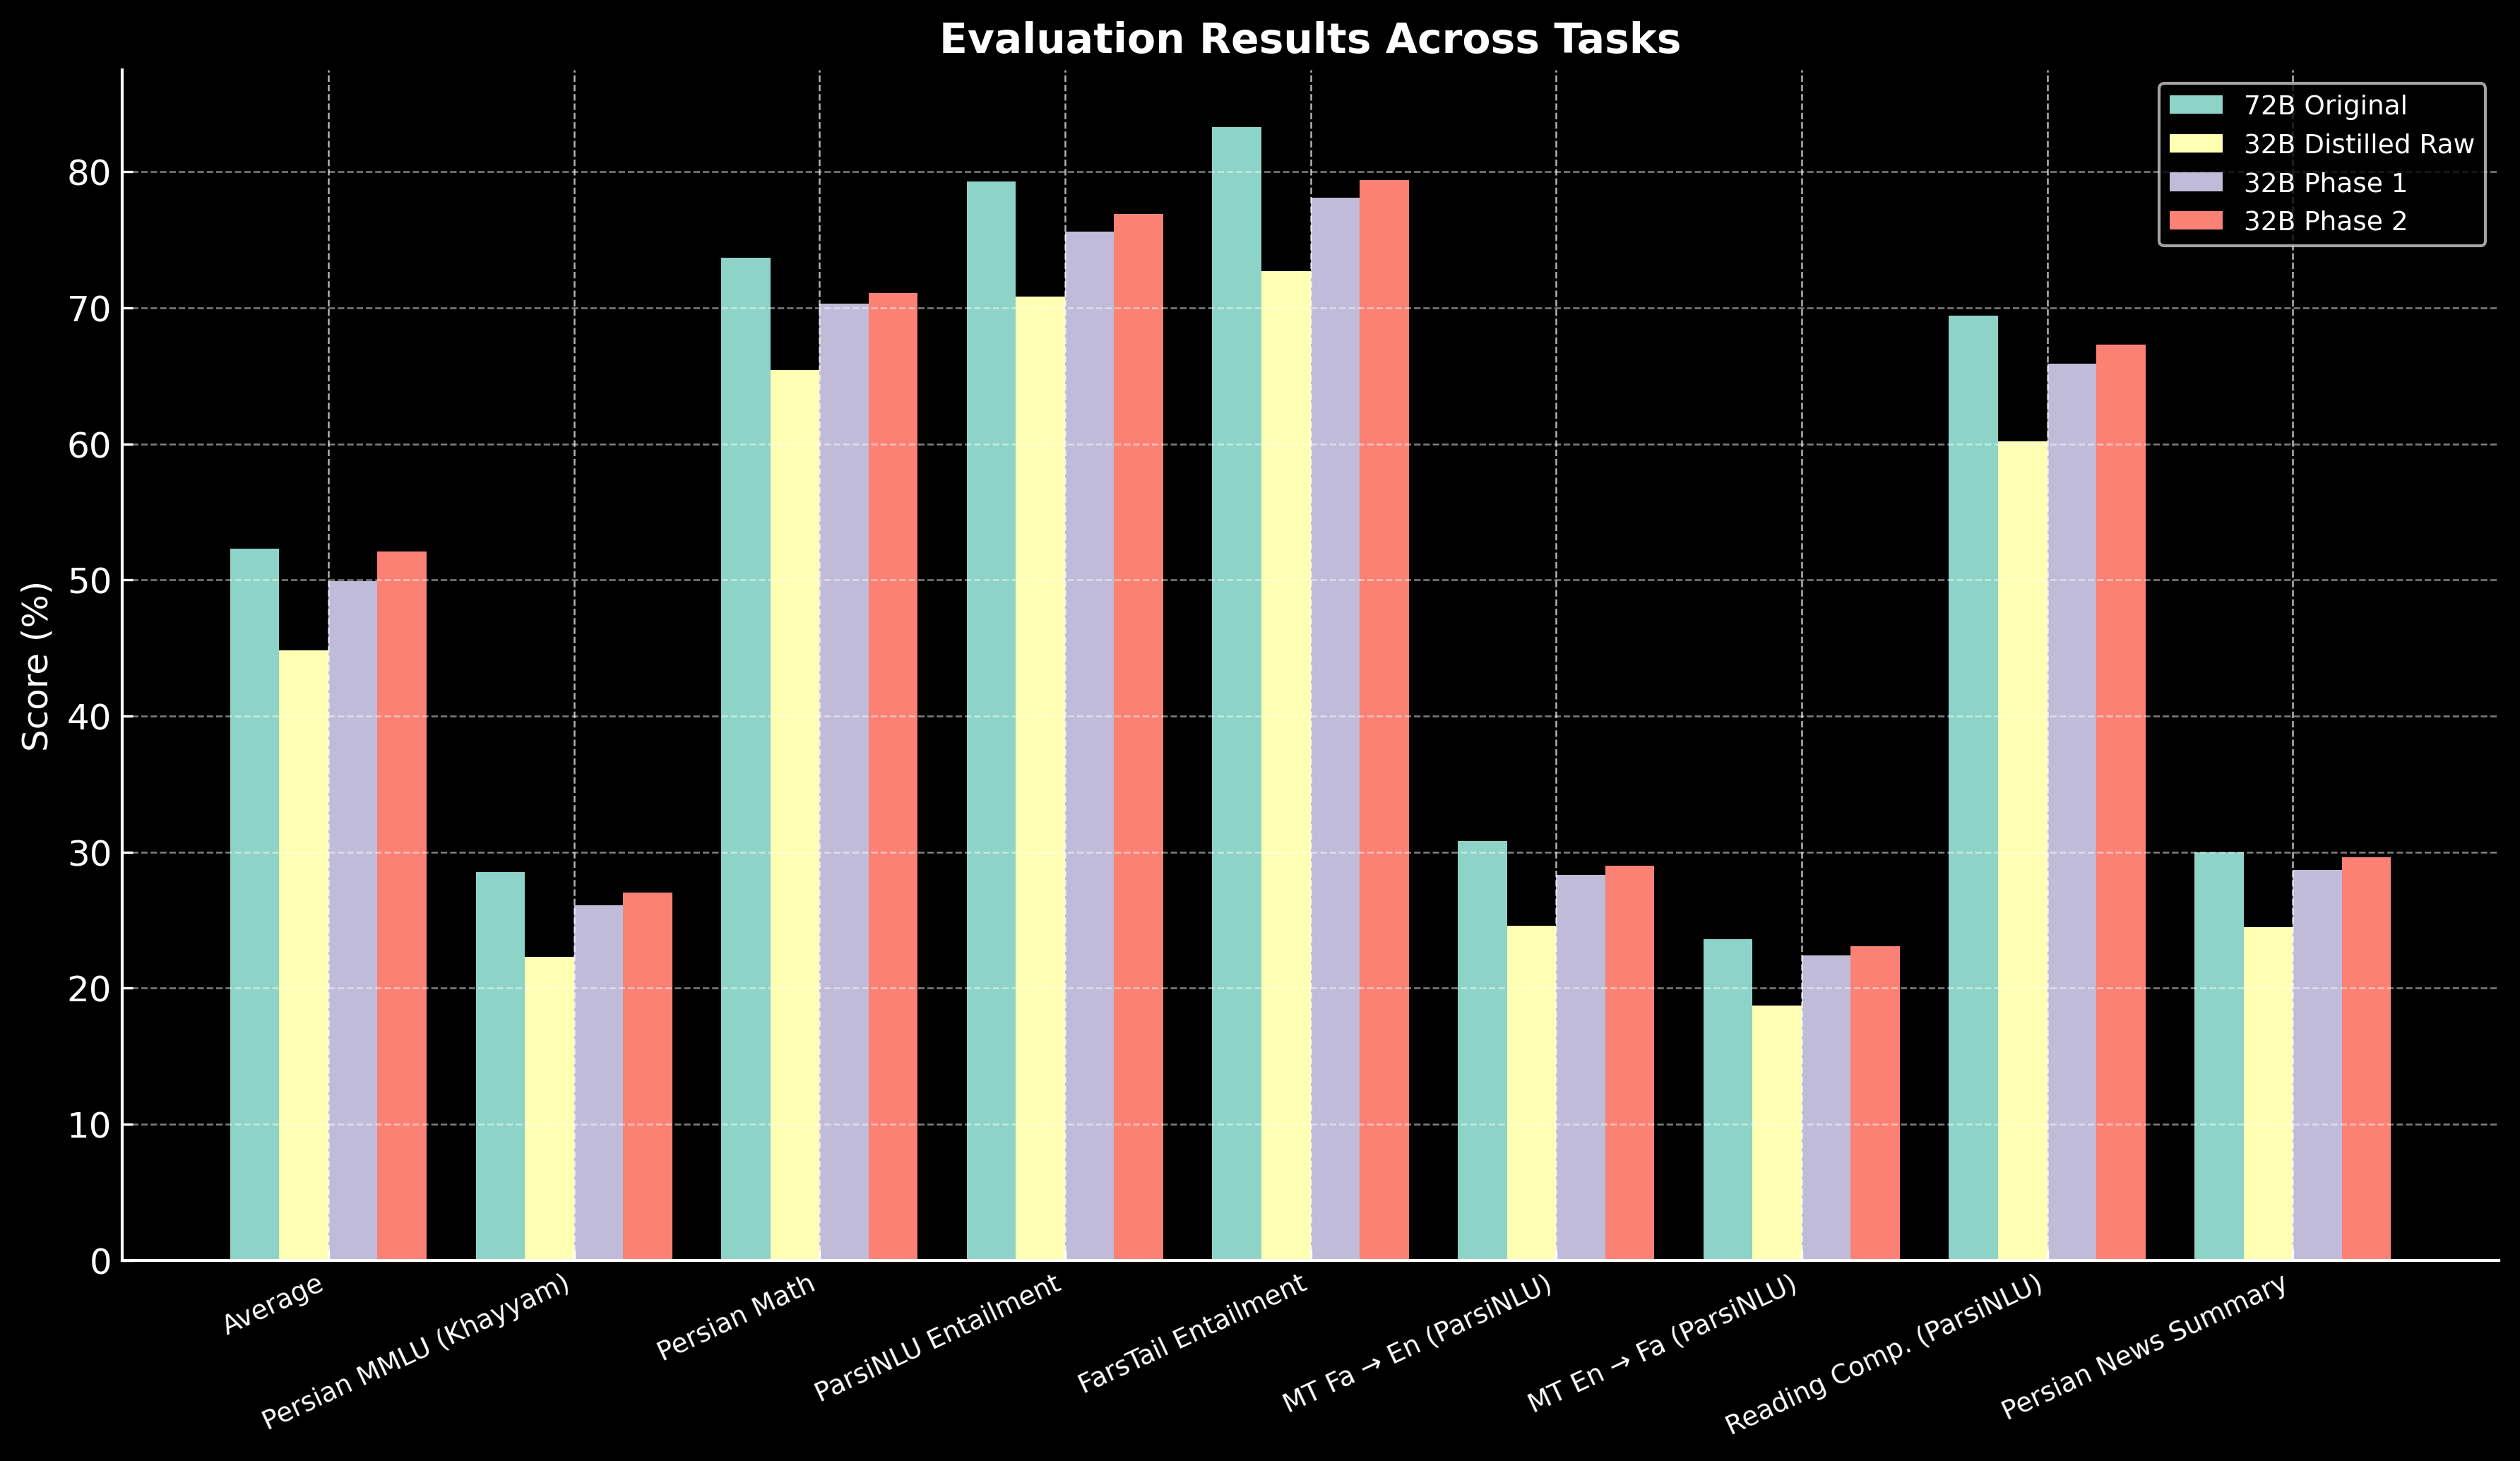
نکته: حتی با تمرکز روی شعر، عملکرد عمومی مدل هم رشد کرد. یعنی تقویت استدلال فارسی غیرمستقیم روی بقیه تسکها هم اثر گذاشت.
رعایت وزن: 45.0٪ → 55.4٪ (+10.4٪)
صنایع ادبی: 42.0٪ → 51.7٪ (+9.7٪)
روانی و دستور زبان: 48.0٪ → 59.2٪ (+11.2٪)
کیفیت کلی: 44.0٪ → 54.2٪ (+10.2٪)
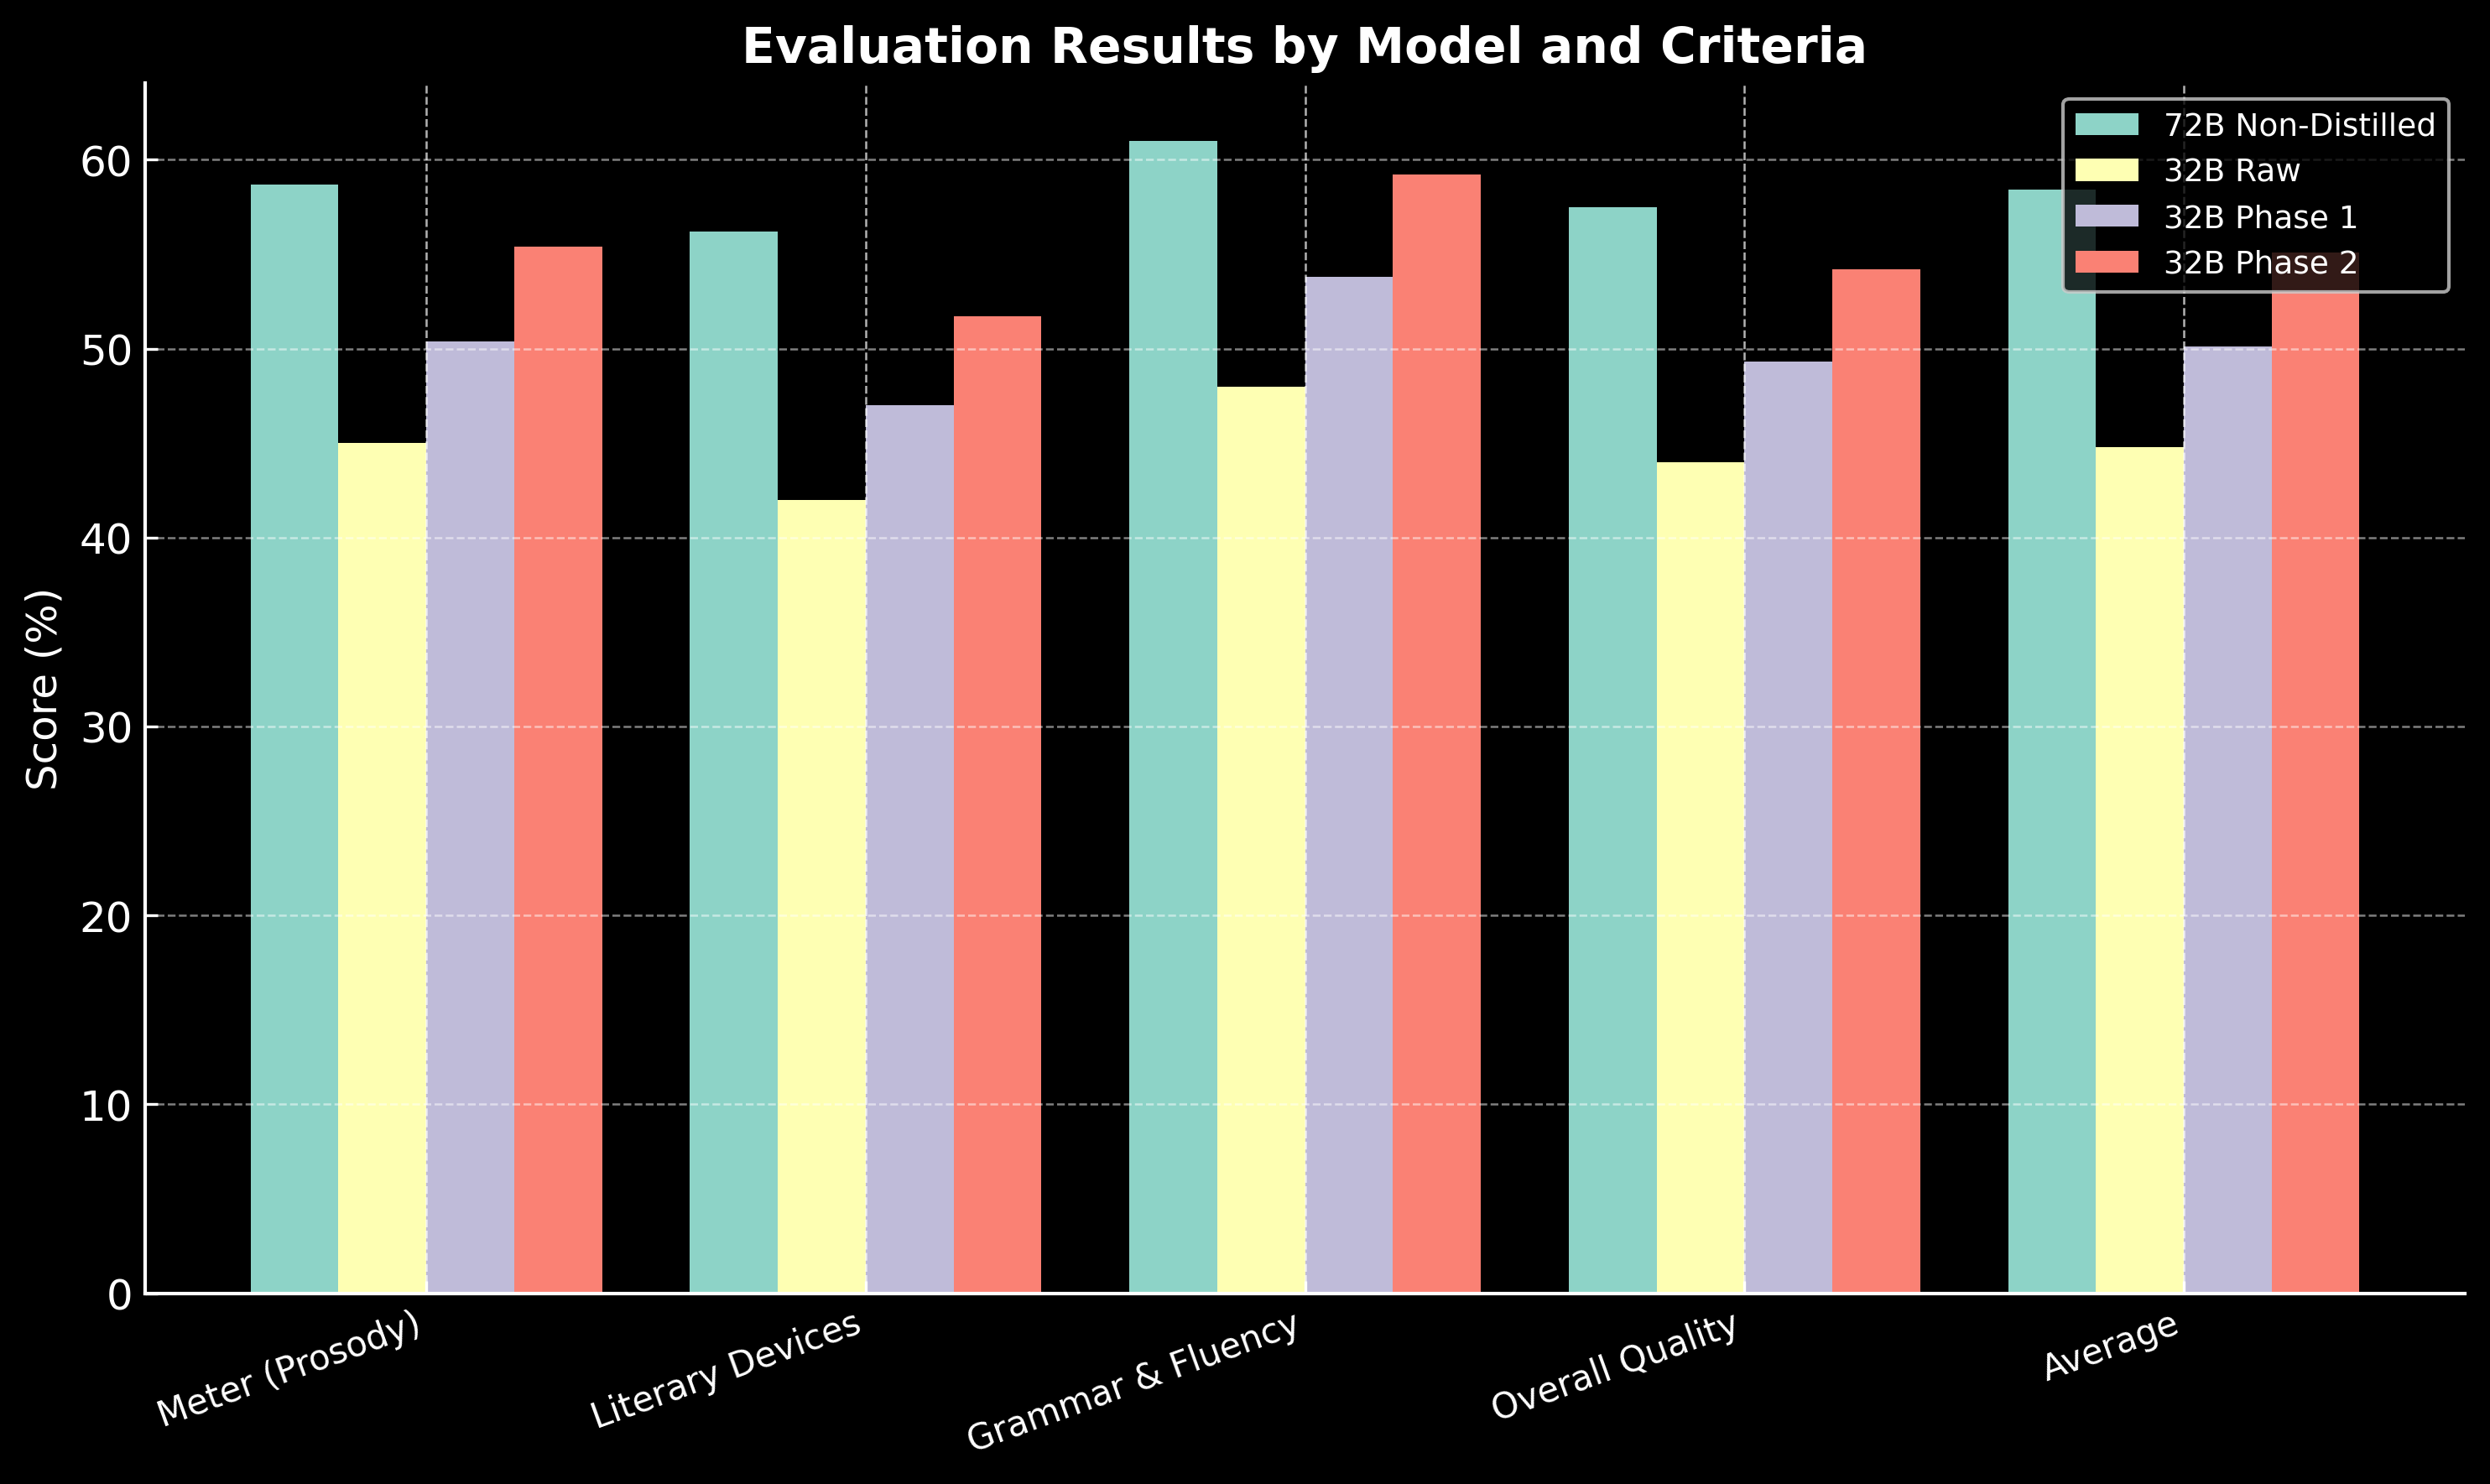
جمعبندی: در کل نزدیک به ۲۲٪ بهبود کیفی نسبت به نسخه خام.
مثال: در پرامپت «توصیف باران در طبیعت»، نسخه خام بیشتر نثر مینوشت، ولی نسخه بهینهشده خروجیای داد که هم موزون بود و هم صنایع ادبی متنوع داشت.
در وزنهای عروضی پیچیده همچنان گاهی اشتباه میکنه.
بعضی صنایع ادبی رو کلیشهای استفاده میکنه.
در متون عرفانی یا فلسفی، بیشتر به نثر برمیگرده تا شعر موزون.
این پروژه مثل هر پژوهش دیگهای پر از چالش بود که بخشی از این چالش ها شامل:
هزینه بالای آموزش و API که حتی روی نسخههای کوچک مثل 32B هم آموزش با PPO منابع زیادی میخواست.
کمبود دادهی دیجیتال فارسی مخصوصاً در حوزه شعر و ادبیات، منابع محدود بودن و جمعآوری دیتاست بدون نقص خیلی سخت شد.
کمبود نمونه مشابه : تقریباً هیچ پروژه مشابهی برای زبان فارسی وجود نداشت و بیشتر مسیر با آزمون و خطا پیش رفت.
محدودیت مدلهای متنباز فارسی : مدلهای موجود یا خیلی کوچک بودن یا کیفیت کافی نداشتن، بنابراین وابسته به مدلهای خارجی شدیم.
نبود معیارهای استاندارد برای شعر : برخلاف تسکهایی مثل ترجمه یا خلاصهسازی، برای شعر معیار مشخصی نبود و مجبور شدیم خودمون یک فریمورک ترکیبی (ماشینی + انسانی) طراحی کنیم.
این پروژه تلاشی بود برای جواب دادن به یک سؤال مهم:
«آیا میشه مدلهای بزرگ جهانی رو برای درک زبان فارسی، بهخصوص در حوزه شعر و ادبیات، تقویت کرد؟»
نتایج نشون داد:
حتی نسخههای کوچک مثل R1-32B هم با آموزش هدفمند رشد قابلتوجهی دارن.
تقویت استدلال فارسی به شکل غیرمستقیم به بهبود وظایف خلاقانه کمک میکنه.
یک فاز آموزشی اختصاصی روی شعر فارسی خروجی رو بهطور محسوسی ارتقا میده.
ولی مسیر هنوز ادامه داره. برای رسیدن به مدلهای واقعاً قدرتمند فارسی، دو گام مهم لازمه:
ساخت و انتشار دیتاستهای باز و متنوع فارسی.
طراحی معیارهای ارزیابی نوآورانه برای وظایف خلاق مثل شعر و نثر ادبی.
این پروژه نشون داد که با وجود همه محدودیتها، میشه قدمهای واقعی برای توانمندسازی مدلهای زبانی در فارسی برداشت. امیدواریم این تجربه شروعی برای تحقیقات گستردهتر در جامعهی NLP فارسی باشه.
درسهای کلیدی
۱. ضرورت ساخت دیتاستهای متن باز فارسی
رشد مدلهای زبانی توی هر زبانی، رابطهی مستقیم با کیفیت و حجم دادههای آموزشی اون زبان داره. برای فارسی دیتاستهای عمومی وجود دارن، اما وقتی پای حوزههای تخصصی مثل ادبیات و شعر وسط میاد، تقریباً هیچ دیتاست باز و ساختاریافتهای پیدا نمیشه.
این یعنی هر تیم پژوهشی مجبور میشه از صفر دیتاست جمع کنه؛ کاری که هم پرهزینهست و هم زمانبر.
اگر دیتاستهای باز و در دسترس ساخته بشن، نهتنها مسیر پروژههای بعدی خیلی هموارتر میشه، بلکه جامعه NLP فارسی میتونه سریعتر رشد کنه و وابستگی به مدلهای خارجی هم کمتر بشه.
۲. لزوم طراحی معیارهای ارزیابی خلاقانه
تسکهایی مثل ترجمه یا خلاصهسازی، معیارهای استاندارد دارن (مثل BLEU یا ROUGE).
اما وقتی بحث شعر پیش میاد، این معیارها جواب نمیدن. چون زیبایی شعر فقط به انتخاب درست واژهها نیست؛ وزن، قافیه، صنایع ادبی و روانی متن هم نقش مهمی دارن.
نبود معیار مشخص باعث میشه پیشرفت مدلها توی این حوزه درست اندازهگیری نشه. برای همین، طراحی یک چارچوب ارزیابی چندلایه (ترکیب روشهای ماشینی + داوری انسانی) کاملاً ضروریه.
این کار فقط برای این پروژه حیاتی نیست، بلکه برای هر تلاش مشابه در آینده هم پایهای و کلیدیه.
Edit

