
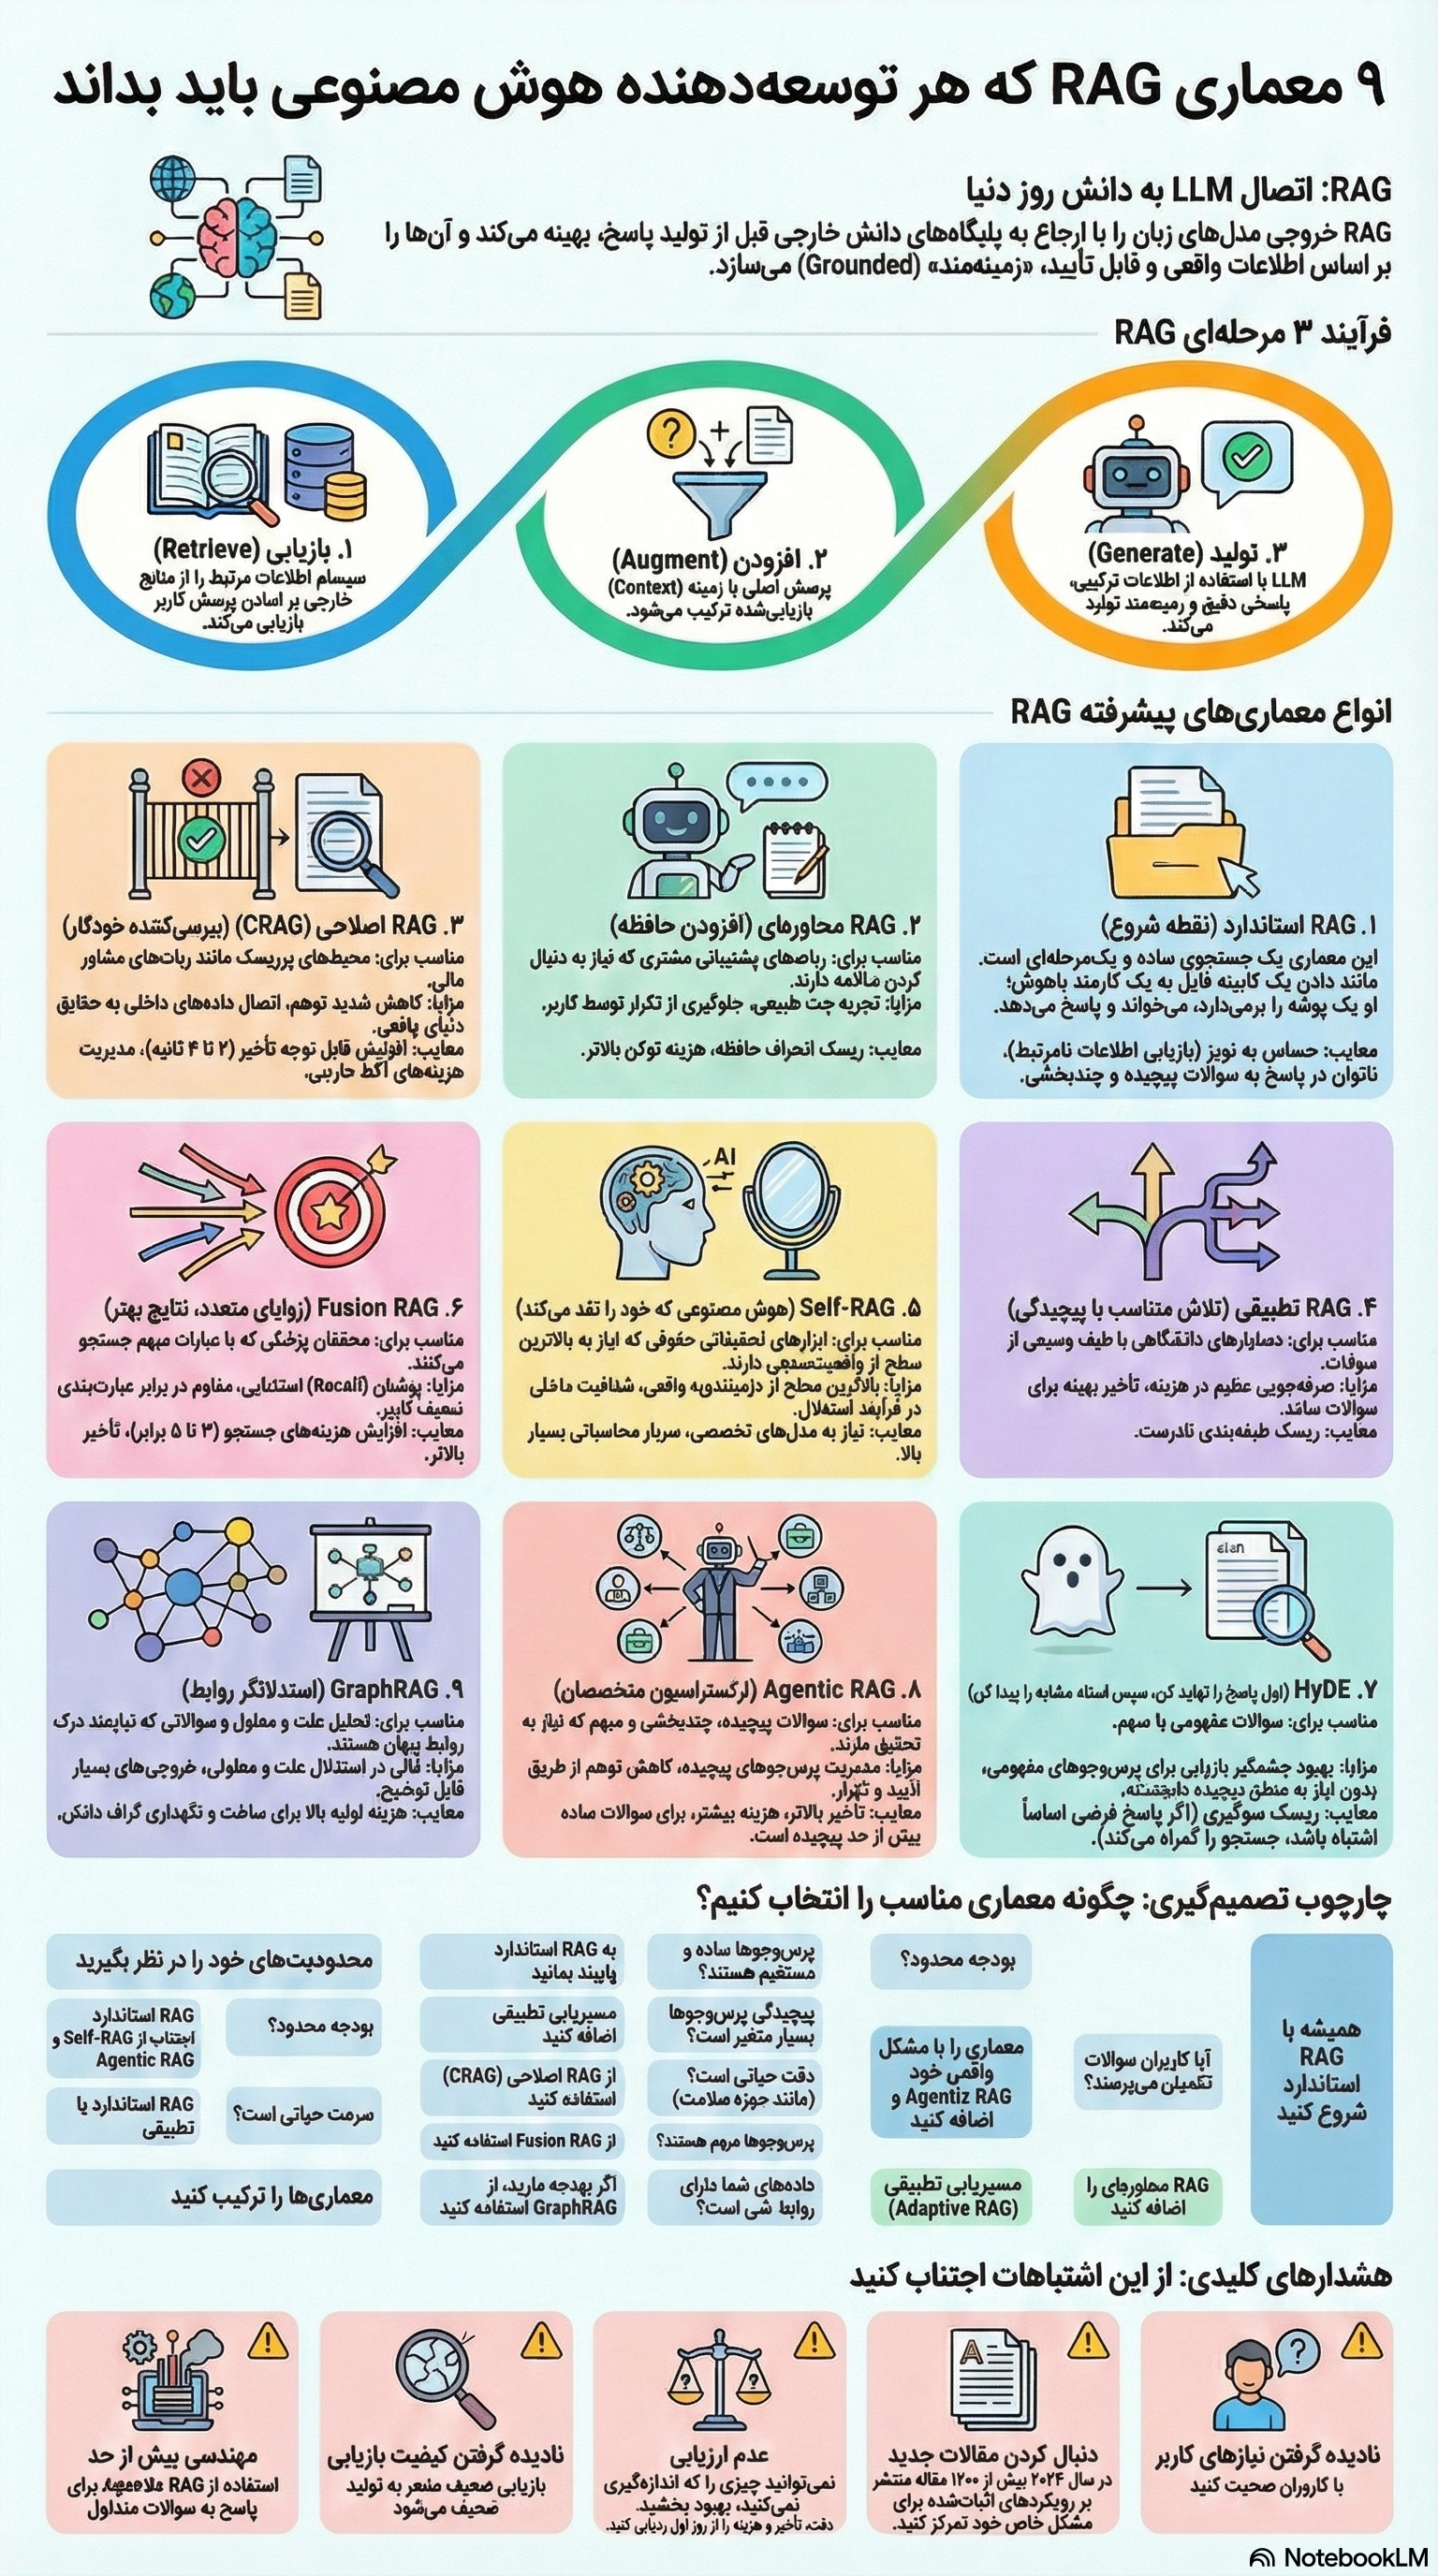
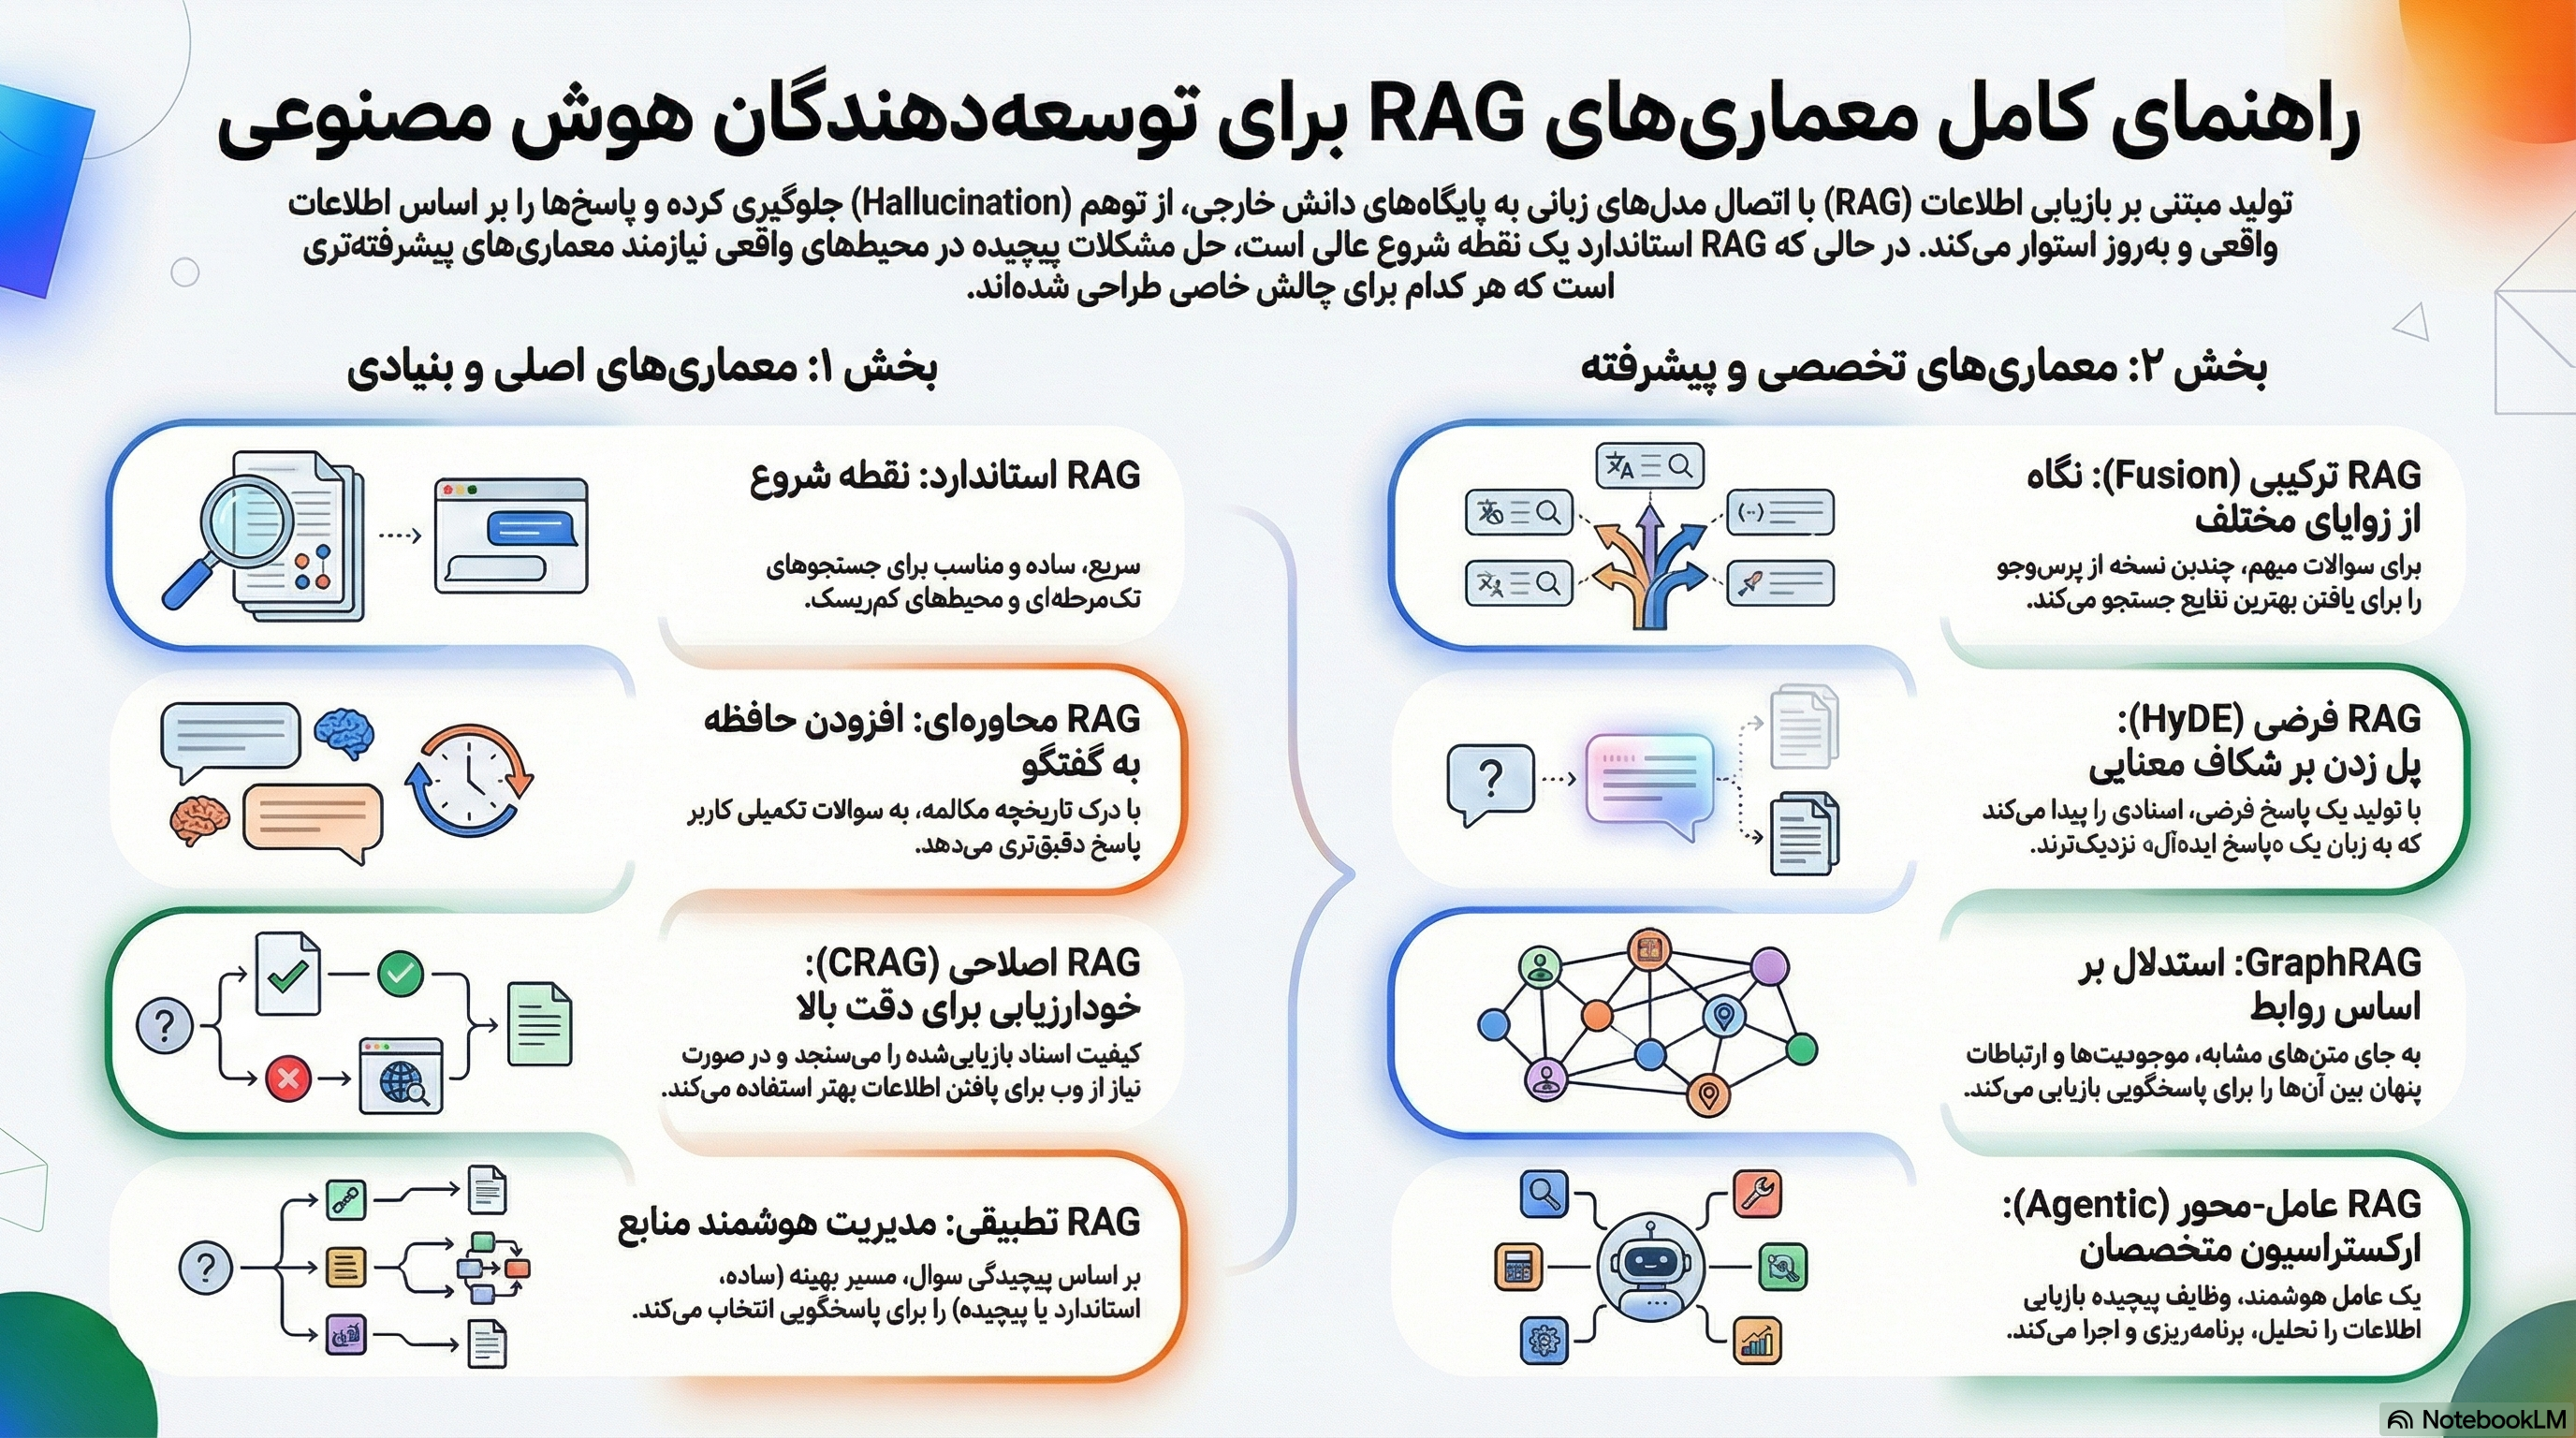
این متن به بررسی نُه معماری مختلف بازیابیِ تقویتشده با تولید (RAG) میپردازد که برای افزایش دقت و قابلیت اطمینان مدلهای زبانی در محیطهای عملیاتی طراحی شدهاند. نویسنده توضیح میدهد که چگونه هر روش، از مدلهای ساده و سریع گرفته تا ساختارهای پیچیده و مأمورمحور، چالشهای خاصی مانند توهمات هوش مصنوعی، فقدان حافظه و ابهام در پرسشها را برطرف میکنند. در این راهنما، استراتژیهایی برای انتخاب هوشمندانه معماری بر اساس نیازهای پروژه، محدودیتهای بودجه و حساسیت دادهها ارائه شده است. تمرکز اصلی بر این است که توسعهدهندگان به جای پیچیدگی بیدلیل، با ارزیابی دقیق و شروع از الگوهای پایه، سیستمهایی کارآمد و مستدل بسازند. در نهایت، متن تأکید میکند که هدف اصلی این فناوری، تبدیل مدلهای هوش مصنوعی به ابزارهای قابل اعتماد از طریق پیوند دادن آنها با منابع اطلاعاتی واقعی و بهروز است.
از طریق لینکی که در انتهای مطلب آمده است میتوانید به پروژه نوت بوک ال ام این تحقیق دسترسی پیدا کنید.
حتماً شما هم با این مشکل مواجه شدهاید: از یک چتبات سؤالی میپرسید و پاسخی قدیمی یا بدتر از آن، کاملاً ساختگی و نادرست تحویل میگیرید. این پدیده که به آن «توهم» (Hallucination) میگویند، یکی از بزرگترین چالشهای مدلهای زبان بزرگ (LLM) امروزی است. برای حل این مشکل، تکنیکی به نام «تولید مبتنی بر بازیابی اطلاعات» یا Retrieval-Augmented Generation (RAG) معرفی شد. RAG به مدلهای هوش مصنوعی اجازه میدهد تا به جای تکیه بر حافظه محدود خود، از منابع خارجی اطلاعات استخراج کرده و پاسخهای دقیقتر و بهروزتری ارائه دهند.
اما داستان به همینجا ختم نمیشود. خود RAG به سرعت در حال تکامل است و از یک جستجوی ساده به فرآیندهایی پیچیدهتر تبدیل میشود که به طرز شگفتانگیزی به «تفکر» شباهت دارند. در این پست، چهار مورد از شگفتانگیزترین پیشرفتها در این حوزه را بررسی میکنیم که نشان میدهند هوش مصنوعی چگونه در حال یادگیری استدلال، ارزیابی و اصلاح خود است.
--------------------------------------------------------------------------------
برخلاف RAG استاندارد که هر اطلاعاتی را که پیدا میکند مستقیماً به مدل زبان میدهد، Corrective RAG (CRAG) یک لایه ارزیابی هوشمند به فرآیند بازیابی اضافه میکند. در این روش، یک «ارزیاب» کیفیت و ارتباط اسناد بازیابیشده را قبل از رسیدن به مدل اصلی، به دقت بررسی میکند.
این رویکرد مانند استخدام یک نگهبان یا ویراستار دقیق است که منابع ضعیف، نامرتبط یا نادرست را فیلتر میکند. تصور کنید یک سیستم RAG استاندارد در یک شرکت حقوقی، یک پیشنویس قانونی قدیمی را از پایگاه داده بازیابی کند و پاسخی بر اساس آن ارائه دهد. پیامدهای این اشتباه میتواند فاجعهبار باشد. CRAG دقیقاً برای جلوگیری از چنین سناریوهایی طراحی شده است. این نگهبان با فیلتر کردن اطلاعات بیکیفیت، به طور چشمگیری اعتماد و قابلیت اطمینان سیستمهای هوش مصنوعی را افزایش میدهد. پیامد استراتژیک این امر، کاهش ریسکهای حقوقی و اعتباری در کاربردهای حساسی مانند امور مالی، پشتیبانی مشتری یا تشخیص پزشکی است؛ حوزههایی که دقت در آنها حیاتی است.
"به جای اینکه اجازه دهیم زمینه (context) نامربوط یا ضعیف وارد خط لوله مدل زبان بزرگ (LLM) شما شود، CRAG بررسیها و اصلاحاتی را انجام میدهد که منجر به پاسخهای دقیقتر، سریعتر و قابل اعتمادتر میشود."
--------------------------------------------------------------------------------
در حالی که CRAG به هوش مصنوعی یاد میدهد که یک ویراستار بهتر برای حقایق خارجی باشد، Self-RAG یک مهارت بنیادیتر را به آن میآموزد: خودنگری. این مدل به جای اینکه برای هر پرسشی کورکورانه به دنبال اطلاعات بگردد، یاد میگیرد که ابتدا از خودش سؤال کند: «آیا برای پاسخ به این سؤال به کمک نیاز دارم؟». این تصمیمگیری هوشمندانه با استفاده از توکنهای ویژهای به نام «توکنهای بازتابی» (reflection tokens) انجام میشود. اگر پاسخ در دانش داخلی مدل موجود باشد، از فرآیند پرهزینه بازیابی اطلاعات صرفنظر میکند.
این یک جهش بزرگ به سمت نوعی خودآگاهی یا به عبارت دقیقتر، یک شکل ابتدایی از «فراشناخت» (metacognition) در مدلهای هوش مصنوعی است. هوش مصنوعی که میداند چه چیزی را نمیداند، ایمنتر، کارآمدتر و قابل اعتمادتر است، زیرا میتواند عدم قطعیت خود را به کاربر اعلام کند. این قابلیت، یک گام حیاتی به سوی هوش مشارکتی واقعی است. SELF-RAG پس از تولید پاسخ، دوباره با استفاده از توکنهای بازتابی، ارتباط پاسخ با منبع و میزان پشتیبانی آن را ارزیابی میکند که این امر شفافیت و امکان راستیآزمایی پاسخها را به شدت افزایش میدهد.
"چارچوب ما یک مدل زبان دلخواه را آموزش میدهد که به صورت تطبیقی و در صورت نیاز، قطعاتی را بازیابی میکند و با استفاده از توکنهای ویژه به نام توکنهای بازتابی، به ارزیابی قطعات بازیابی شده و تولیدات خود میپردازد."
--------------------------------------------------------------------------------
اگر دانستنِ «آنچه نمیدانیم» اولین قدم باشد، قدم بعدی این است که بدانیم «چگونه آن را پیدا کنیم». اینجا است که هوش مصنوعی از خودنگری به سوی تحقیق فعال حرکت میکند. چارچوبهای تکرارشونده مانند FAIR-RAG فرآیند بازیابی را به یک چرخه هوشمند تحقیق تبدیل میکنند. این سیستمها به یک بار بازیابی اطلاعات بسنده نمیکنند. در عوض، مانند یک کارآگاه عمل میکنند: ابتدا تمام شواهد موجود را بررسی کرده، سپس به طور سیستماتیک تشخیص میدهند که چه اطلاعاتی «مفقود» است. این نقاط ضعف، «شکافهای اطلاعاتی» نامیده میشوند.
RAG سنتی مانند یک کتابدار عمل میکند: شما سؤالی میپرسید و او کتابهای مرتبط را به شما تحویل میدهد. اما FAIR-RAG مانند یک کارآگاه یا به قول مقاله مرجع آن، یک «تحلیلگر اطلاعات استراتژیک» (Strategic Intelligence Analyst) است. این مدل با استفاده از یک ماژول به نام «ارزیابی شواهد ساختاریافته» (Structured Evidence Assessment)، به طور فعال شکافها را شناسایی کرده و سپس پرسوجوهای جدید و هدفمندی برای پر کردن دقیق همان شکافها ایجاد میکند. این فرآیند چرخهای برای پاسخ به سؤالات پیچیده و چند مرحلهای (multi-hop) که نیاز به ترکیب اطلاعات از چندین منبع دارند، حیاتی است. این سیستمها به جای پرسیدن «چه چیزی مرتبط است؟»، میپرسند «برای تکمیل تصویر، چه چیزی کم است؟».
--------------------------------------------------------------------------------
اما چه میشود اگر کلید استدلال هوشمندانهتر، نه فقط یافتن اطلاعات بیشتر، بلکه فراموش کردن استراتژیک اطلاعات باشد؟ SEAL-RAG یک ایده غیرمنتظره را معرفی میکند: «جایگزین کن، اضافه نکن» (replace, don’t expand). یکی از مشکلات بزرگ در سیستمهای RAG، پدیدهای به نام «رقیق شدن زمینه» (context dilution) است. وقتی اطلاعات بیش از حد (حتی اگر کمی مرتبط باشند) به مدل داده میشود، مدل دچار سردرگمی شده و کیفیت پاسخ نهایی کاهش مییابد.
این رویکرد تقلیدی از یک جنبه کلیدی یادگیری مؤثر انسان است: تمرکز توجه. مغز ما دائماً نویز را فیلتر میکند تا روی مهمترین اطلاعات تمرکز کند. SEAL-RAG به هوش مصنوعی توانایی مشابهی برای حفظ «تمرکز» بر روی مهمترین شواهد میدهد. این سیستم با یک «بودجه» یا ظرفیت زمینه ثابت کار میکند. در هر مرحله از چرخه جستجوی خود، با استفاده از یک تابع سودمندی، به طور استراتژیک اطلاعاتی را که کمترین فایده را دارند حذف کرده و آن را با شواهد جدیدی که شکافهای اطلاعاتی را بهتر پر میکنند، جایگزین میکند. این استراتژی تضمین میکند که پنجره زمینه مدل همیشه با مرتبطترین و مفیدترین اطلاعات پر شده است.
"ما SEAL-RAG را پیشنهاد میکنیم، یک کنترلکننده بدون نیاز به آموزش که استراتژی «جایگزین کن، اضافه نکن» را برای مقابله با رقیق شدن زمینه تحت یک عمق بازیابی ثابت k اتخاذ میکند."
--------------------------------------------------------------------------------
سیر تکامل RAG نشان میدهد که هوش مصنوعی از یک ابزار بازیابی ساده در حال تبدیل شدن به یک فرآیند هوشمند، پویا و بازتابنده است. ما شاهد ظهور سیستمهایی هستیم که نه تنها اطلاعات را پیدا میکنند، بلکه آن را ارزیابی (CRAG)، در مورد نیاز به آن تأمل (Self-RAG)، شکافهای آن را تحلیل (FAIR-RAG) و حتی برای حفظ دقت، اطلاعات اضافی را جایگزین (SEAL-RAG) میکنند. این پیشرفتها فراتر از بهبود پاسخهای یک چتبات است؛ آنها پایههای استدلال ماشینی را بنا میکنند.
همانطور که این سیستمها از کتابداران دیجیتال به شرکای استدلالگر تبدیل میشوند، سؤال حیاتی برای هر رهبری این است: چگونه باید فرآیندهایی را طراحی کنیم که نه تنها از دانش هوش مصنوعی، بلکه از قضاوت نوظهور آن نیز بهرهمند شویم؟
https://notebooklm.google.com/notebook/c40c4458-a880-4a50-8689-795de5e3d21f?authuser=1

