
طراحی و توسعه موتور عمومی ساخت و تکامل آنتولوژی مبتنی بر گراف دانش، شواهد و عاملهای هوش مصنوعی
وقتی با مجموعهای از کتابها، مقالات، اسناد یا آثار یک متفکر روبهرو میشویم، معمولاً میتوانیم با کمک ابزارهای هوش مصنوعی آنها را خلاصه کنیم، جستوجوی معنایی انجام دهیم یا به پرسشها پاسخ دهیم. اما مسئله عمیقتری نیز وجود دارد: آیا میتوان سیستمی ساخت که بهتدریج ساختار دانش نهفته در این منابع را کشف کند، روابط میان مفاهیم را بشناسد و با نقد مداوم ساختار خود، به یک گراف دانش دقیقتر و کاملتر برسد؟
ایده پروژه «Ontology Maker» از همین پرسش آغاز میشود.
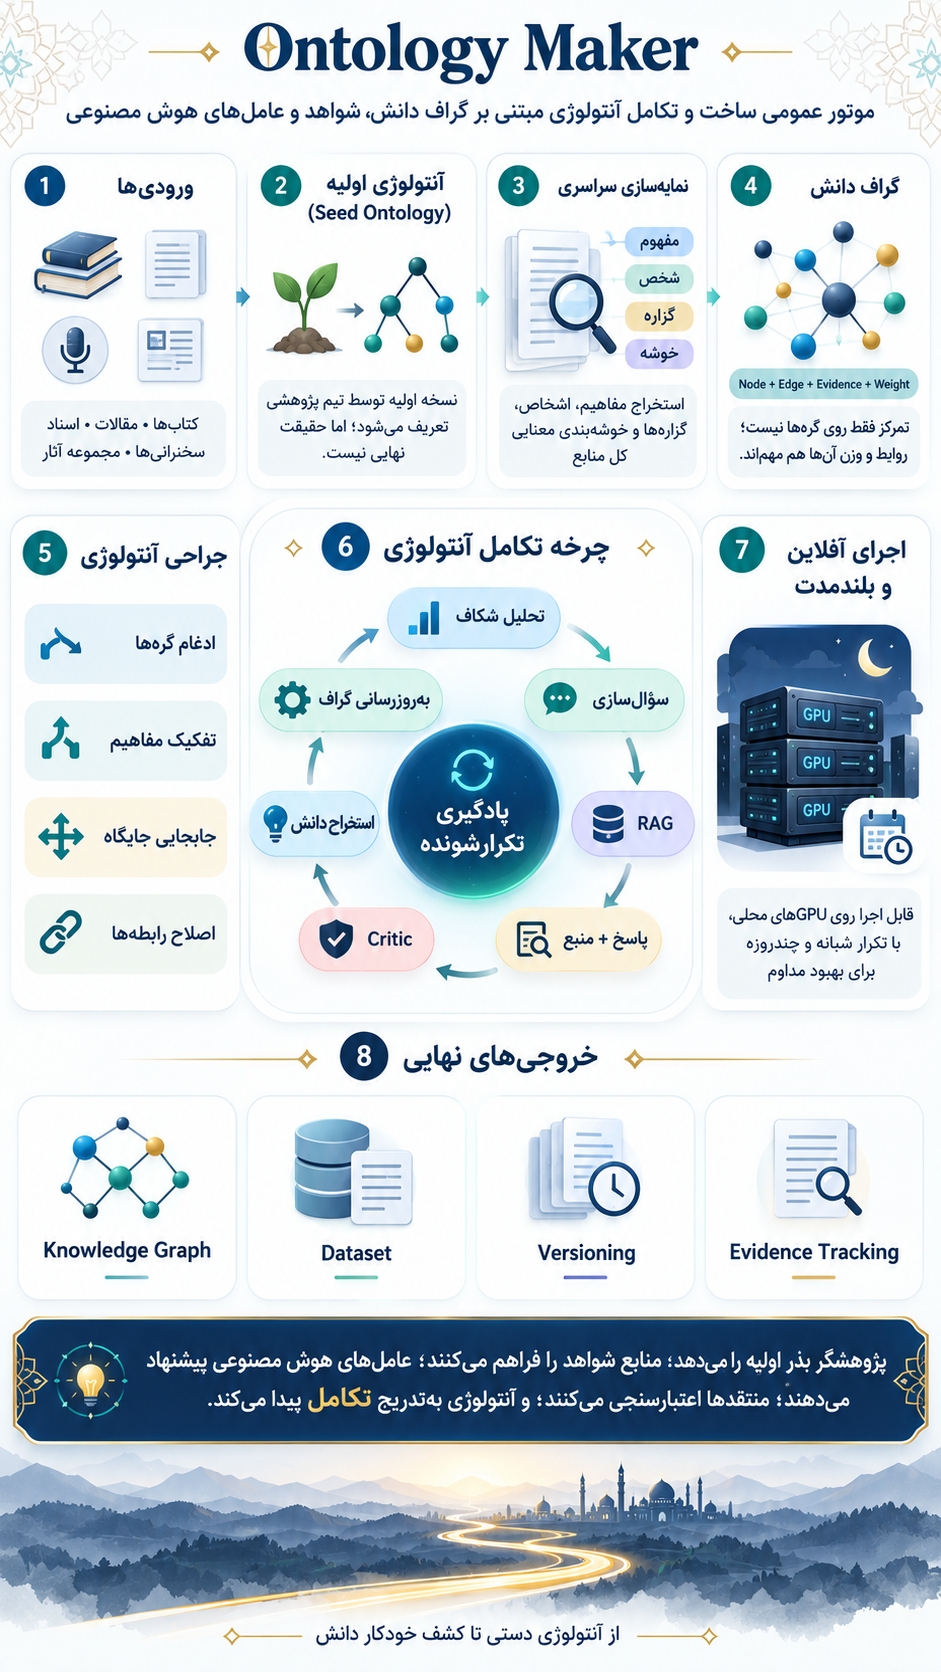
هدف، ساخت ابزاری عمومی است که بتواند روی موضوعات و منابع متفاوت اجرا شود؛ از قرآن کریم، مفاتیح و مجموعههای حدیثی گرفته تا آثار یک فیلسوف، نوشتههای یک دانشمند، کتابهای یک نویسنده یا مجموعهای تخصصی از اسناد علمی.
در این رویکرد، آنتولوژی محصول یک طراحی ثابت و یکباره نیست؛ بلکه ساختاری است که در طول زمان، با اتکا به شواهد، نقد و بازنگری تکامل پیدا میکند.
ساخت آنتولوژی از صفر، بدون هیچ چارچوب اولیهای، ممکن است هزینهبر و نامنظم باشد. از طرف دیگر، تکیه کامل بر ساختار ذهنی چند پژوهشگر نیز میتواند محدودیتها و پیشفرضهای انسانی را به سیستم منتقل کند.
راهکار پیشنهادی، شروع با یک آنتولوژی اولیه یا Seed Ontology است که به کمک یک تیم پژوهشی و با دستورالعمل مشخص ساخته میشود.
در این نسخه اولیه، مفاهیم اصلی، انواع موجودیتها، روابط احتمالی، دستهبندیها و ساختارهای اولیه مشخص میشوند. این ساختار نقطه شروع سیستم است، نه حقیقت نهایی آن.
سیستم باید بتواند در ادامه، هر بخش از این ساختار را با شواهد منابع مقایسه کند و در صورت نیاز، تغییر آن را پیشنهاد دهد.
پس از تعریف ساختار اولیه، لازم است کل مجموعه منابع بررسی شود.
در این مرحله، سیستم مفاهیم، اشخاص، آثار، اصطلاحات، گزارهها و نشانههای معنایی موجود در متن را استخراج میکند. سپس با استفاده از جستوجوی معنایی و روشهای خوشهبندی، موارد مشابه و مرتبط را شناسایی میکند.
برای مثال، ممکن است چند اصطلاح در ظاهر متفاوت باشند، اما در یک زمینه معنایی به یک مفهوم نزدیک اشاره کنند. در مقابل، دو واژه مشابه ممکن است در دو متن یا دوره تاریخی معنای متفاوتی داشته باشند.
بنابراین شباهت معنایی بهتنهایی برای ادغام مفاهیم کافی نیست؛ هر ادغام یا تفکیک باید با توجه به بافت متن و شواهد موجود بررسی شود.
نتیجه این مرحله، مجموعهای از مفاهیم و ارتباطات احتمالی است که میتوان آنها را با آنتولوژی اولیه مقایسه کرد.
در یک گراف دانش، فقط تعداد گرهها اهمیت ندارد. بخش مهمی از دانش در روابط میان گرهها قرار دارد.
برای نمونه، رابطه میان دو مفهوم میتواند از نوع «علت بودن»، «مستلزم بودن»، «تعارض داشتن»، «نمونهای از بودن» یا صرفاً «مرتبط بودن» باشد. این روابط از نظر معنایی یکسان نیستند و جهت آنها نیز ممکن است اهمیت داشته باشد.
به همین دلیل، مدل داده باید علاوه بر Nodeها، انواع Edgeها، جهت روابط، شواهد پشتیبان، میزان اطمینان و وضعیت اعتبارسنجی آنها را نگهداری کند.
همچنین نباید تمام اطلاعات در یک عدد به نام وزن خلاصه شوند. تعداد شواهد، تنوع منابع، اطمینان استخراج، نتیجه نقد و میزان تعارض با شواهد دیگر، ابعاد متفاوتی هستند که باید جداگانه ثبت شوند.
در صورت نیاز، میتوان از این ویژگیها برای محاسبه یک وزن عملیاتی استفاده کرد؛ اما منشأ و معنای هر مؤلفه باید مشخص باقی بماند.
هسته اصلی Ontology Maker یک چرخه تکرارشونده است:
۱. تحلیل وضعیت فعلی آنتولوژی و گراف دانش.
۲. شناسایی خلأها، روابط نامطمئن، مفاهیم تکراری و دستهبندیهای نامناسب.
۳. تولید پرسشهای هدفمند برای بررسی بخشهای مبهم.
۴. بازیابی شواهد از منابع با استفاده از RAG.
۵. استخراج مفاهیم و روابط جدید از پاسخهای مستند.
۶. ارزیابی پاسخها و روابط پیشنهادی توسط عاملهای منتقد.
۷. پیشنهاد اصلاح ساختار گراف.
۸. ارزیابی تغییرات و ثبت نسخه جدید آنتولوژی.
در این چرخه، سیستم ممکن است گرهای جدید اضافه کند، دو گره را ادغام کند، یک مفهوم را به چند مفهوم دقیقتر تقسیم کند، جایگاه یک گره را تغییر دهد یا رابطهای را حذف یا بازتعریف کند.
البته تغییر ساختار نباید صرفاً بر اساس پیشنهاد یک مدل زبانی انجام شود. تغییرات باید شواهد کافی داشته باشند، از آزمونهای اعتبارسنجی عبور کنند و در موارد حساس برای بررسی انسانی قابل ارجاع باشند.
نکته مهم این است که نقد سیستم نباید فقط به صحت پاسخهای تولیدشده محدود شود.
خود آنتولوژی نیز باید بهطور دورهای مورد بررسی قرار گیرد:
آیا ساختار فعلی مفاهیم مهم موجود در منابع را پوشش میدهد؟
آیا برخی گرهها بیش از حد کلی یا بیش از حد جزئی هستند؟
آیا دو مفهوم متفاوت بهاشتباه ادغام شدهاند؟
آیا روابط مهمی میان بخشهای مختلف گراف نادیده گرفته شدهاند؟
آیا ساختار فعلی پیشفرضهای اولیه پژوهشگران را بیش از اندازه منعکس میکند؟
آیا شواهد جدید با روابط پذیرفتهشده قبلی تعارض دارند؟
در این نگاه، حتی آنتولوژیای که چندین بار بازبینی شده است، همچنان میتواند موضوع نقد قرار گیرد.
هدف، رسیدن به ساختاری نیست که صرفاً بزرگتر باشد؛ هدف رسیدن به ساختاری است که با شواهد موجود سازگارتر، از نظر مفهومی دقیقتر و برای تحلیل دانش مفیدتر باشد.
یکی از ویژگیهای موردنظر این پروژه، امکان اجرای کامل فرآیند روی زیرساخت محلی و کارتهای گرافیک اختصاصی است.
در چنین محیطی، میتوان چرخههای تحقیق، نقد و اصلاح را برای ساعتها یا روزها اجرا کرد؛ برای مثال، اجرای پردازشهای سنگین در بازه شبانه، از ساعت ۱۲ شب تا ۵ صبح.
البته اجرای طولانی بهتنهایی تضمینکننده کیفیت نیست. سیستم باید بتواند وضعیت هر مرحله را ذخیره کند، از تکرار بیفایده جلوگیری کند، تغییرات ناموفق را بازگرداند و میزان پیشرفت را با معیارهای قابلاندازهگیری ارزیابی کند.
برای مثال، میتوان کاهش روابط نامطمئن، افزایش پوشش شواهد، کاهش موارد تکراری و پایداری نتایج در چند دور متوالی را بررسی کرد.
در این معماری، نسخهبندی گراف و قابلیت بازگشت به نسخههای قبلی ضروری است؛ زیرا تکامل دانش باید قابل ردیابی و اصلاح باشد.
هر گره و هر رابطه باید منشأ مشخصی داشته باشد. آیا ابتدا توسط پژوهشگر تعریف شده است؟ از متن استخراج شده؟ توسط یک مدل زبانی پیشنهاد شده؟ یا پس از نقد و بررسی انسانی تأیید شده است؟
ثبت این اطلاعات کمک میکند مسیر تحول گراف قابل بررسی باشد.
برای نمونه، ممکن است رابطهای در نسخه اول صرفاً یک ارتباط احتمالی میان دو مفهوم باشد، اما پس از بررسی منابع متعدد، نوع رابطه دقیقتر شود و شواهد بیشتری از آن پشتیبانی کنند.
در مقابل، ممکن است یک رابطه اولیه پس از بررسی شواهد کنار گذاشته شود.
بنابراین تاریخچه نسخهها فقط برای مدیریت نرمافزار نیست؛ بخشی از سازوکار اعتمادپذیری و ارزیابی دانش تولیدشده است.
چشمانداز نهایی پروژه، ساخت سیستمی نیست که فقط برای یک نویسنده یا یک مجموعه کتاب کار کند.
هسته نرمافزار باید تا حد امکان مستقل از دامنه دانش طراحی شود. برای استفاده در یک حوزه جدید، بتوان منابع، تنظیمات، دستورالعملهای پژوهشی، آنتولوژی اولیه و معیارهای ارزیابی متناسب با آن حوزه را به سیستم ارائه کرد.
به این ترتیب، یک موتور مشترک میتواند برای حوزههای مختلف به کار گرفته شود؛ درحالیکه ساختار مفهومی هر حوزه از شواهد و ویژگیهای خاص منابع خودش تأثیر میگیرد.
این استقلال به معنای یکسان بودن آنتولوژی تمام حوزهها نیست؛ بلکه به معنای قابلیت استفاده مجدد از فرآیند ساخت، نقد و تکامل آنتولوژی است.
Ontology Maker را میتوان تلاشی برای ساخت یک موتور عمومی کشف و سازماندهی دانش دانست؛ موتوری که با یک آنتولوژی اولیه شروع میکند، کل منابع را بررسی میکند، مفاهیم و روابط را استخراج میکند، شواهد را به ساختار دانش پیوند میدهد و با چرخههای متوالی نقد و بازسازی، گراف را تکامل میدهد.
اصل محوری این ایده چنین است:
پژوهشگر ساختار اولیه را پیشنهاد میدهد؛ منابع شواهد را فراهم میکنند؛ عاملهای هوش مصنوعی روابط و اصلاحات احتمالی را کشف میکنند؛ منتقدها پیشنهادها را میسنجند؛ و نسخهبندی، تاریخ تکامل دانش را حفظ میکند.
این پروژه در نهایت به دنبال تولید یک گراف بزرگتر به هر قیمت نیست؛ بلکه به دنبال ساخت گرافی است که روابط آن معنادار، شواهد آن قابل ردیابی و تغییرات آن قابل ارزیابی باشد.
چنین سیستمی میتواند زیرساختی برای پژوهشهای عمیقتر، جستوجوی دانش، تحلیل اندیشه متفکران، توسعه سامانههای RAG و تولید مجموعهدادههای مستند فراهم کند؛ البته میزان موفقیت آن باید با آزمایشهای واقعی و ارزیابی مستقل سنجیده شود.
یک معماری اجرایی به متن اضافه کنمرز آنتولوژی و گراف را روشن کن

