
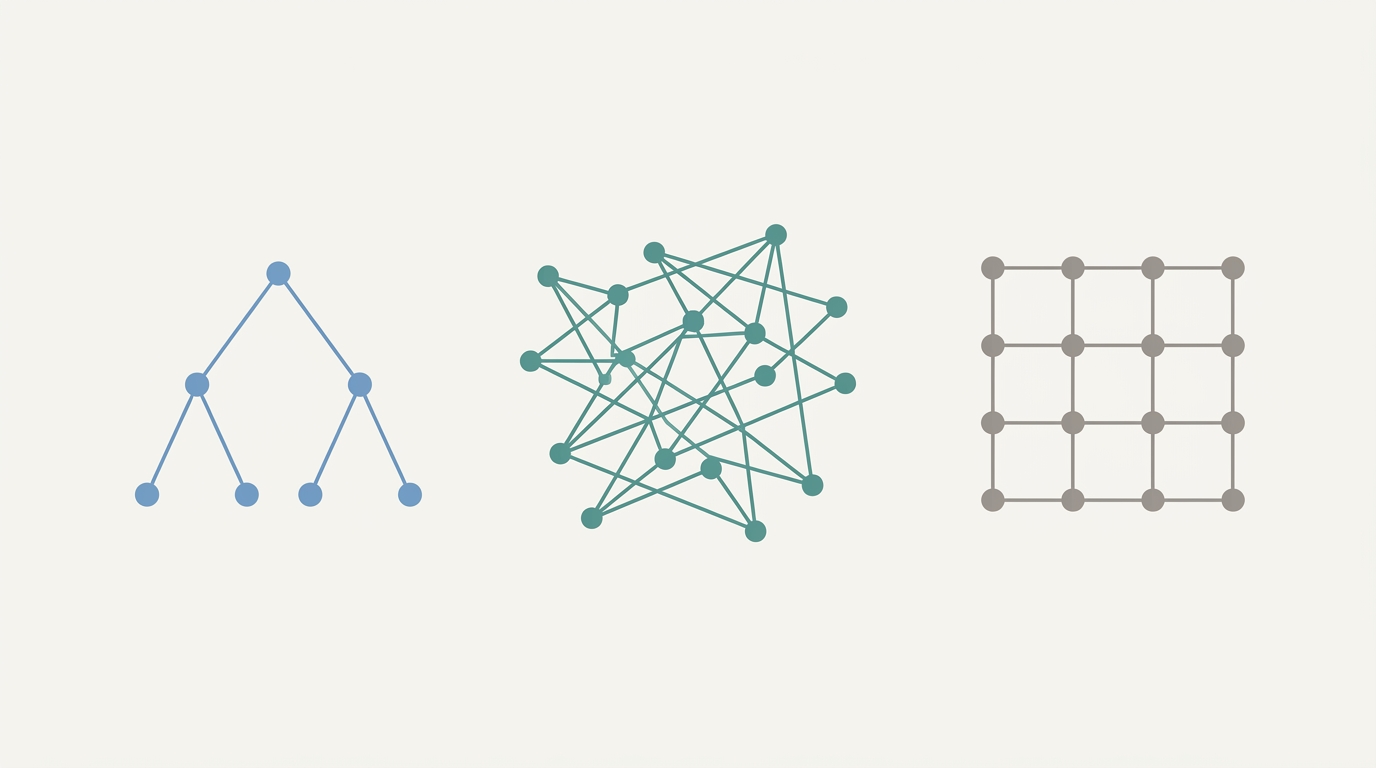
در این مقاله سعی دارم به مفاهیم بنیادی مربوط به مدیریت داده ها بپردازم. دیتا مدل (Data Model)، سیستم مدیریت پایگاه داده (DBMS), SQL, NOSQL و سه دیتا مدل (Relational, Hierarchical, Newtork) مواردی هستند که قرار است در این مقاله به آنها پرداخته شود. همچنین کمی تاریخچه از ظهور اولین RDBMS ها و علت شکل گیریشان و یک سری مباحث مربوط به برنامه نویسی. این مقاله صرفا میتواند مقدمه خوبی باشد برای ورود به دنیای مدیریت داده ها در نرم افزار ها. بسیار کوشیدم تا اصطلاحات را تا حد ممکن توضیح دهم. با این حال قطعا کاستی هایی دارد. اگر بخشی را متوجه نشدید از خود خُرده نگیرید. ایراد از من بوده که نتوانستم آن بخش را به نحو بهتری توضیح دهم. مقاله هم مقاله نسبتا طولانی است و اگر در چندین روز بخوانید طبیعی است. ( اینکه کلا نخوانید معمولی تر است. مگر اینکه معمولی نباشید! )
لازم به ذکر است که به دیتا مدل های مورد توجه در این مقاله به صورت مجزا پرداخته شده و وابستگی خاصی بین آنها برای فهم مقاله وجود ندارد. میتوانید هر کدام که خواستید را رد کنید.
به تعدادی توضیح داخلِ پرانتزی هم برخورد خواهید کرد که این عبارات مهم هستند و لطفا رد نکنید.
به طور خلاصه دیتا مدل یعنی روشی برای ساختار دهی دیتا. در دنیای کامپیوتر نرم افزار بسیاری از مفاهیم و چیز ها، مدلی از دنیای واقعی و یا حتی از بعضی موارد دیگر در درون خود کامپیوتر هستند. مثلا class/object در برنامه نویسی شی گرا، از دنیای واقعی الهام گرفته شده است.یا مثلا نام فولدر، فایل، window و ... . همه مدلی از دنیای واقعی هستند.
در واقع ما زمانی که سعی داریم برنامه ای را در دنیای نرم افزار بسازیم، در تلاشیم تا یک تکه از دنیای واقعی را به یک جهان مصنوعی داخل نرم افزار تبدیل کنیم، با کمی چاشنی دقت و ساختار سخت گیرانه.
و در مورد داده ها هم این اصل صدق میکند. ما داده هایی داریم که نیاز دارند به روشی ذخیره و مدیریت شوند.
حال مدل هایی از پیش تعیین و تعریف شده اند که ما میتوانیم داده های خودمان را در آن ساختار ها تعریف کنیم و به این مدل ها، دیتا مدل میگویند.
چند دیتا مدلی که قرار است به آنها در این مقاله بپردازیم:
Relational, Hierarchical, Network
پس از بررسی این دیتا مدل ها درک این مفاهیم آسان میشود.
ما هر برنامه ای که داشته باشیم، قطعا داده ای نیز خواهد داشت. حالا منظور از داده چیست؟ فرض کنید میخواهید از یک فروشگاه اینترنتی محصولی را خریداری کنید. ابتدا در سایت ثبت نام میکنید(شامل نام، شماره، آدرس) محصولات را به سبد خرید خود اضافه میکنید و سپس پرداخت را نهایی میکنید. اطلاعات شما، اطلاعات محصولات،اطلاعات سایت،بخش مقاله های سایت، همه و همه داده به شمار میروند.
چالش برانگیز ترین بخش ماجرا دریافت و جمع آوری این داده ها نیست! بله نگهداری و مدیریت این داده ها است.
اگر شما داده های برنامه خود را در قالب فایل text ذخیره کنید قطعا با چالش های فرآوانی دست و پنجه نرم خواهید کرد. باید برنامه را طوری توسعه دهید که به طور مستقیم با نگهداری داده ها دست و پنجه نرم کند. بداند که هر کاربر دقیقا در کدام فایل و کدام بخش از فایل است. الگوریتم های بهینه و پیچیده برای ذخیره و یافتن داده ها بنویسید و خلاصه، کلی پیچیدگی و برنامه نویسی که در این قرن برای برنامه ای با این اسکیل، عقلانی نیست 😬
اینجاست که DBMS (Database management system) ها به دادمان میرسند. DBMS ها برنامه هایی هستند که ما میتوانیم به کمک آنها داده های برنامه خودمان را بسیار بهینه ذخیره و مدیریت کنیم. و در بسیاری از RDBMS و DBMS های معروف این دوران ( مانند PostgreSQL, MySQL, Oracle DBMS, MongoDB و ... ) ما را از دردسر نگهداری و مدیریت داده ها در سطح دیسک خلاص کرده اند. و ما صرفا کافی است از زبان های مخصوص این DBMS ها استفاده کنیم و موتور پیشرفته این DBMS ها با کلی امکانات افزوده، داده های ما را مدیریت میکنند.
یک نکته حائز اهمیت و مهم این است که دیتا مدل و DBMS یکسان نیستند! همانطور که در بخش دیتا مدل چیست توضیح دادیم، دیتا مدل روشی برای ساختار دهی دیتا است. و DBMS های موجود هم اکثرااا، از دیتا مدل خاصی پیروی میکنند. مثلا PostgreSQL از دیتا مدل Relational پیروی میکند. ولی چیزی که DBMS ها را خاص میکند این است که در سطح فنی، این کار را بسیار بهینه و تمیز انجام میدهند! مثلا ممکن است همین فردا من یک DBMS بسازم و بگویم ایشان از دیتا مدل رابطه ای پیروی میکند. و بله واقعا هم پیروی میکند، شما داده هایتان را در قالب جداول(از قوانین مدل رابطهای) ساختار دهی میکنید، اما در آن پشت من کدی نوشته باشم که به شدت کثیف و غیر بهینه است. یک جستجوی ساده در دیتابیس چندین دقیقه طول بکشد! به این نکته اشاره کردم تا ثابت کنم معیار انتخاب DBMS مناسب برای پروژه، دیتا مدل آن DBMS نیست. و یک کلی معیار هست که باید در نظر گرفته شوند. ( اللخصوص دانش در مورد DBMS های موجود و نحوه کارکردشان. )
مدل رابطهای در سال 1970 توسط Edgar Frank Codd ( ادگار کاد )، یک محقق در شرکت IBM (این شرکت خدمت بزرگی در حوزه مدیریت داده در نرم افزار کرده. از سازندگان اولین DBMS ها است و مقاله های خوبی که در طول زمان منتشر کرده، باعث ظهور اولین RDBMS ها هم شد! البته بماند که پول خوبی هم به جیب زده 😁) معرفی شد. ادگار کاد در یک مقاله ای دیتا مدل رابطهای را به صورت تئوری معرفی کرد.
قبل از Relational Model، سیستمهای مهمی مثل IMS از شرکت IBM و سیستمهای Network Database وجود داشتند.( در ادامه به صورت مجزا به هر دو این دیتا مدل نامبرده خواهیم پرداخت ) ساختار داده در آنها تا حد زیادی به شکل tree یا network بود و برنامه برای رسیدن به داده باید مسیر دسترسی به آن را میشناخت.
برنامه باید تقریباً بداند از کجا شروع کند و از چه مسیری به رکورد مورد نظر برسد (به اصطلاح به این روش برنامه نویسی imperative میگویند که در ادامه به این هم خواهیم پرداخت). اما کاد ایده ای را مطرح کرد :
برنامه نباید لازم باشد بداند داده از نظر فیزیکی کجا و چگونه ذخیره شده است.
هستهٔ مدل Codd از ریاضیات میآمد؛ بهخصوص مفهوم Relation در نظریه مجموعهها (Set Theory) و همچنین Predicate Logic.( که برای ما مصرف کنندگان خیلی مهم نیست این دیتا مدل از کجا آمده.خود بنده به شخصه مفاهیم ریاضی استفاده شده در خلق این دیتا مدل را مطالعه نکرده ام :) ) و اساسا داده را از دید ریاضی نگاه کرد و نه فایل بر روی دیسک.
پیاده سازی این مدل در سطح یک DBMS، در نگاه اول برای افراد آن دوره غیرممکن به نظر میرسید. اما چندین سال بعد، نخستین DBMS های مبتنی بر این Data Model شکل گرفتند. در همین مسیر، زبان SQL نیز برای تعامل با این سیستم ها توسعه یافت و دیگر لازم نبود برنامه مستقیماً با منطق مدیریت و نگهداری دادهها روی دیسک درگیر شود.
در عوض، با استفاده از SQL، درخواست خود را به صورت Declarative (در ادامه بیشتر به مفهموم Imperative و Declarative میپردازیم) بیان میکنیم؛ یعنی مشخص میکنیم چه داده ای میخواهیم، نه اینکه دقیقاً چگونه به آن دست پیدا کند. این DBMS است که با استفاده از Query Optimizer و سایر اجزای داخلی خود، روش مناسب اجرای درخواست را انتخاب و آن را اجرا میکند.
به DBMS های مبتنی بر مدل رابطهای، RDBMS یا Relational Database Management System گفته میشود. ( پس همچنان یک DBMS هستند. اما به تفکیک بهتر DBMS های مبتنی بر مدل رابطهای توجه ویژهای شده و به آن ها RDBMS را اختصاص داده اند. )
مدل رابطهای Codd با مجموعه ای از مفاهیم و قواعد مشخص معرفی شد. اما RDBMS های امروزی در طول دههها تکامل، این ایده ها را به شکل عملی و مهندسی شده پیادهسازی کردهاند و امروزه با مفاهیم و اصطلاحات زیر سر و کار داریم:
در مدل رابطهای، دادهها در قالب Relation سازمان دهی میشوند که در RDBMS های امروزی آن ها را به صورت Table (جدول) میبینیم. به عنوان مثال ما تصمیم داریم داده های کاربران برنامه را مدیریت کنیم. یک جدول میسازیم با نام Users.
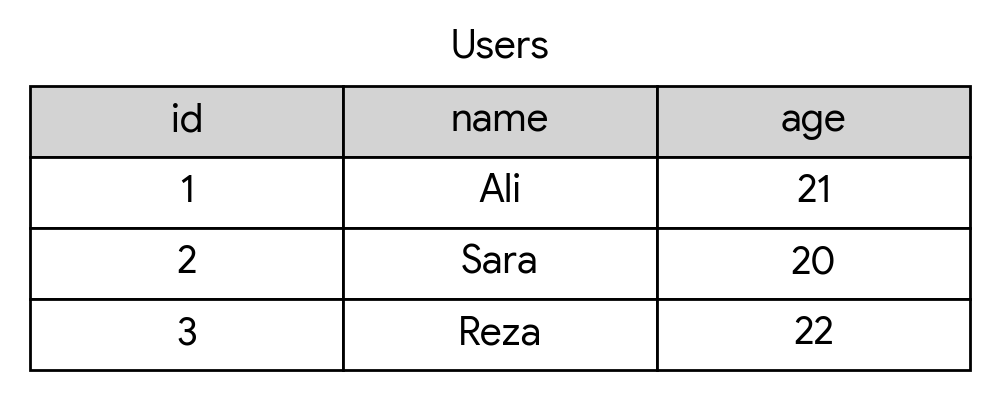
هر جدول مجموعه ای از اطلاعات مرتبط را نگهداری میکند. مثلا جدول کاربران مجموعه از اطلاعات مرتبط مربوط به کاربران را نگهداری میکند. و از چند Column (ستون) و Row (ردیف) تشکیل شده است.
هر Row یک مورد از اطلاعات موجود در جدول را نمایش میدهد.
برای مثال :
1 | Ali | 21
یک ردیف از جدول Users است که اطلاعات یک کاربر را در خود نگه میدارد.
هر Column یک ویژگی مشخص از دادهها را نگهداری میکند و یک نوع داده مشخصی دارد که مشخص میکند چه نوع مقادیری قابل پذیرش هستند.
برای مثال در جدول Users:
id name age
سه ستون داریم که به ترتیب شناسه، نام و سن کاربر را مشخص میکنند.
در بسیاری از جدول ها لازم است بتوانیم هر ردیف را به صورت یکتا شناسایی کنیم.( به یاد دارید که هر ردیف داده ای بخصوص است دیگر؟) برای این کار از Key (کلید) استفاده میشود. حالا چرا نیاز است هر ردیف به صورت یکتا شناسایی شود؟ واضح است. مثلا در جدول کاربران اگر چندین کاربر با مشخصات دقیقا یکسان داشته باشیم چطور میان آنها تمایز قایل شویم؟ یا حتی در جدول محصولات و ... . ایجاد یک ستون کاملا متمایز و یکتا برای هر ردیف تمایز میان ردیف ها را ممکن میکند.
یکی از مهمترین انواع آن Primary Key (کلید اصلی) است:
CREATE TABLE users (
    id   INTEGER PRIMARY KEY,
    name TEXT,
    age  INTEGER
);
در این مثال، id کلید اصلی جدول است. بنابراین مقدار آن نمیتواند برای دو ردیف تکراری باشد و نمیتواند NULL باشد.(NULL بیانگر این است که برای یک فیلد مقدار مشخصی وجود ندارد یا مقدار آن ناشناخته است).
خب مشخصا داده های یک سیستم فقط در یک جدول قرار نمیگیرند. و در یک برنامه ما نیاز به چندین جدول داریم. اما در بسیاری از سناریو ها ما نیاز داریم که جداول با یکدیگر ارتباط داشته باشند.
مثلا جدول کاربران که در بالا ترسیم شده را در نظر بگیرید. در یک سیستم فروشگاهی ما به یک جدول با نام Products هم نیاز داریم. که هر محصول دارای مشخصاتی مانند: نام،قیمت،توضیحات،عکس ها، تعداد و ... است.
حالا در نظر بگیرید که کاربران میخواهند محصولاتی را سفارش دهند.یک رویکرد این است که ما جدولی با نام Orders(سفارش ها) بسازیم، و مشخص کنیم که هر ردیف به کدام محصول و کدام کاربر اشاره میکند. به مثال زیر توجه کنید:
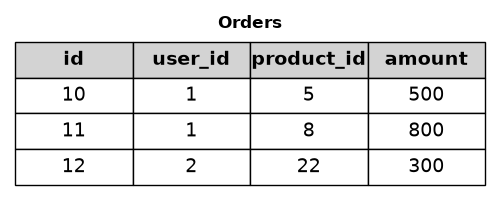
همانطور که در جدول مشخص است، ما دارای ستون های id, user_id , product_id , amount هستیم. هر ردیف یک سفارش است. id شناسه منحصر به فرد هر سفارش، user_id به کاربری که آن سفارش را داده اشاره میکند، و product_id به محصولی که آن کاربر انتخاب کرده اشاره میکند. یک فیلد هم هست با نام amount که قیمت همان محصول است. حالا چرا قیمت محصول را برای هر سفارش ذخیره کردیم؟ مگر این قیمت در خود ردیف محصول نیست؟ به این دلیل که اگر کاربر ساعت در یک ساعتی محصول را ثبت سفارش کرده باشد و ما چندین ساعت بعد قیمت محصول را تغییر دادیم، برای کاربری که قبلا آن محصول را سفارش داده و مبلغ را پرداخت کرده، قیمت تغییر نکند. همچنین برای گزارش گیری میتواند مفید باشد که بدانیم هر محصول در بازه زمانی مختلف به چه قیمت هایی فروخته شده است. و دیگر کاربرد ها ... . به ستونی که شناسه ردیفی خارجی را ذخیره میکند، در این مثال یعنی id کاربر از یک جدول دیگر ( Users ) و id محصول از جدول Products، ستون Foreign Key ( کلید خارجی ) میگویند.
و در واقع با این کار ما ارتباطی بین جداول ایجاد کرده ایم. و از آنجایی که مدل رابطهای مستقیما از ارتباط بین جداول پشتیبانی میکند، RDBMS ها هم به Referential Integrity (یکپارچگی ارجاعی) داده ها حساس هستند.مثلا اگر ما تلاش کنیم در جدول سفارشات ردیفی بسازیم با id کاربری که وجود ندارد، خطا میدهد.
وقتی داده ها را در جدول های مختلف نگهداری میکنیم، لازم است بتوانیم در زمان نیاز آنها را دوباره در کنار یکدیگر قرار دهیم. نگاهی به جدول سفارشات بیاندازید که شامل user_id ,amount است.فرض کنید که تصمیم داریم نام کاربران و قیمت سفارش را در کنار هم داشته باشیم. اما نام کاربر در یک جدول دیگر است و قیمت سفارش در یک جدول دیگر.برای این کار از JOIN استفاده میکنیم.
مثلا:
SELECT users.name, orders.amount
FROM users
JOIN orders
    ON users.id = orders.user_id;
این Query میتواند نتیجهای مانند زیر تولید کند:
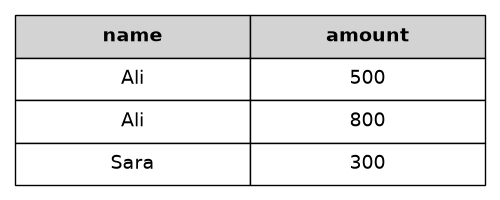
Query نوشته شده با زبان SQL است. در خط اول و دوم از RDBMS خواستیم که نام کاربران و قیمت سفارشی که ثبت کرده اند را از جدول کاربران برای ما نمایش دهد. اما مگر قیمت سفارش در جدول کاربران است؟ خیر. پس از JOIN استفاده میکنیم. و در خط 3 و 4 صراحتا جدول سفارشات را هم وارد بازی کردیم و گفتیم که در جدول سفارشات فقط ردیف هایی را پیدا کن که user_id آن ها برابر با id هر ردیف در جدول کاربران است. بدین ترتیب فقط کاربرانی یافت میشوند که در جدول سفارشات حداقل یک سفارش ثبت کرده باشند. مبحث JOIN در نگاه اول شاید کمی گُنگ به نظر برسد اما اصلا چیز پیچیده ای نیست و با دیدن 10 الی 60 مثال جا میافتد.
یکی از مفاهیم مهم در طراحی پایگاه های داده رابطهای Normalization (نرمال سازی) است.
هدف اصلی نرمال سازی، سازمان دهی داده ها به شکلی است که از تکرار غیر ضروری داده ها (Data Redundancy) و مشکلات ناشی از آن جلوگیری شود. یعنی به عنوان مثال لازم نیست در هر سفارش نام کاربر را هم در جدول سفارشات ثبت کنیم. زیرا user_id کاربر در جدول سفارشات وجود دارد و با یک JOIN میتوانیم به نام کاربر دسترسی داشته باشیم. اما اگر نام کاربر را برای هر سفارش ثبت کنیم چه اتفاقی میافتد؟ در این صورت Data Redundancy رخ داده است. زیرا ما یک تکرار غیر ضروری انجام داده ایم. و اگر فردا روزی کاربر نام خود را تغییر دهد، باید نام کاربر در تمااامی ردیف های سفارشات هم تغییر دهیم.
به همین دلیل معمولاً اطلاعات مربوط به موجودیت های ( هر جدول را میتوانیم یک موجودیت هم بنامیم ) مختلف را در جدول های جداگانه قرار میدهیم و با استفاده از کلید ها بین آن ها ارتباط ایجاد میکنیم.
در این بخش، قوانین و روش کار و ساختار دهی داده ها در مدل رابطهای را توضیح دادیم. اما یک RDBMS امروزی بسیار بیشتر از مجموعه ای از جدول ها و رابطه ها است.
در پشت این ساختار، اجزای دیگری مانند Index ، Query Optimizer ، Transaction ، Concurrency Control Recovery و Storage Engine وجود دارند که وظیفه دارند دادهها را با سرعت، قابلیت اطمینان و سازگاری مناسب مدیریت کنند.
پیش از فراگیر شدن مدل رابطهای، یکی از مهم ترین مدل های داده، Network Data Model (مدل دادهای شبکهای) بود.
این مدل در دهه ۱۹۶۰ شکل گرفت و یکی از معروف ترین DBMS های مبتنی بر این مدل Integrated Data Store (IDS) شرکت General Electric بود که توسط شخصی به نام Charles Bachman توسعه پیدا کرد. بعدها این ایده ها در قالب استاندارد CODASYL Data Model نیز گسترش پیدا کردند.
دلیل شکل گیری مدل شبکهای، مشکلی بود که سیستم های اولیه مدیریت داده با آن مواجه بودند: دادهها فقط مجموعه ای از رکورد های مستقل نبودند، بلکه بین رکورد ها ارتباط وجود داشت و سیستم باید بتواند این ارتباط ها را نیز مدیریت کند. ( به طور کلی این ارتباط بین موجودیت ها یکی از اصلی ترین دلایل شکل گیری مدل رابطهای بود. )
در مدل شبکهای، دادهها معمولا به صورت Record (رکورد) ذخیره میشوند و رکورد ها میتوانند با یکدیگر ارتباط داشته باشند.
برای مثال، فرض کنید یک سیستم فروشگاهی داریم:
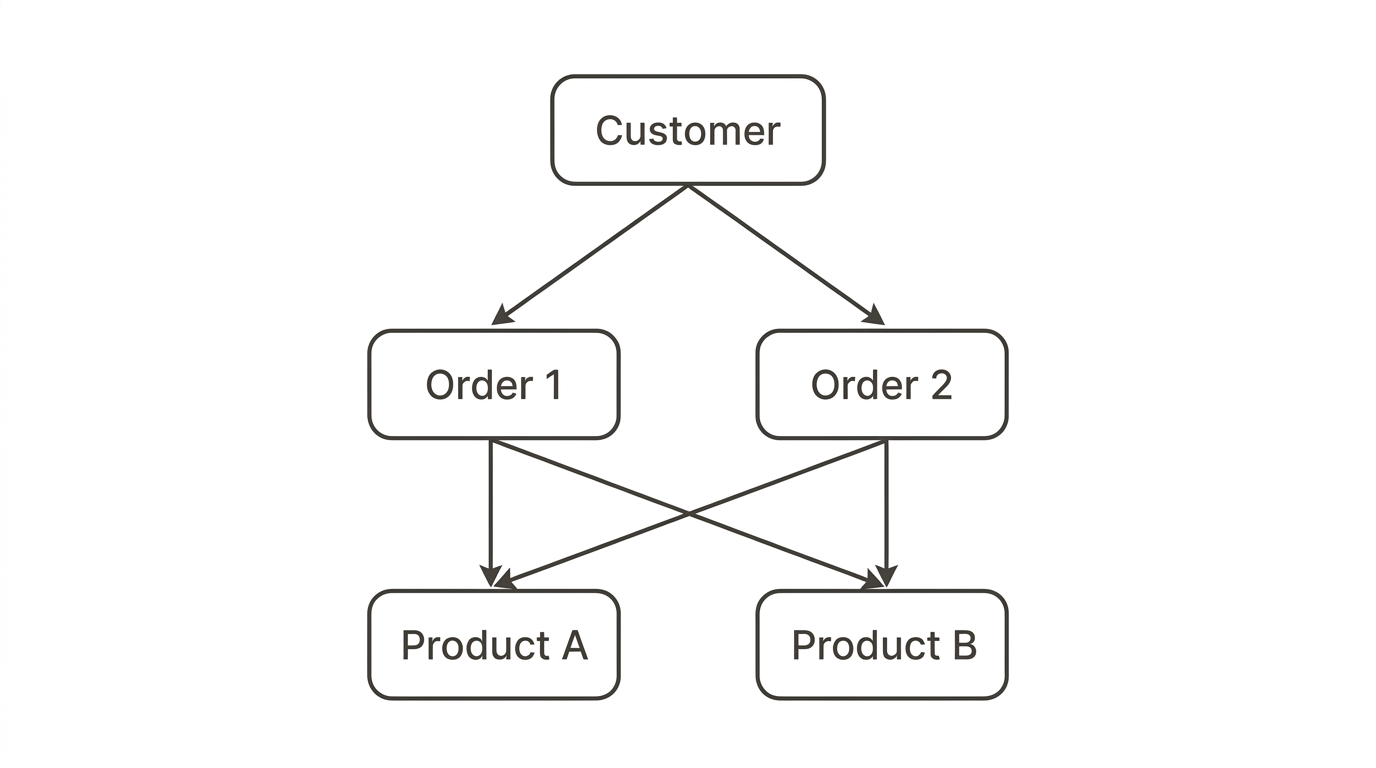
در اینجا یک Customer میتواند چند Order داشته باشد و یک Order نیز میتواند با چند Product مرتبط باشد.
بنابراین ساختار داده دیگر صرفاً یک درخت نیست ( بر خلاف مدل سلسه مراتبی که جلوتر میپردازیم )؛ بلکه میتواند یک گراف از رکورد ها و ارتباط ها باشد.
به همین دلیل نام آن Network است.
دو مفهوم مهم در مدل شبکهای عبارت اند از:
Record (رکورد):
واحد اصلی داده است. برای مثال:
Customer
{
    id: 1
    name: Reza
}
Set (مجموعه ارتباطی):
ارتباط مشخصی میان Record ها را تعریف میکند.
مثلا:
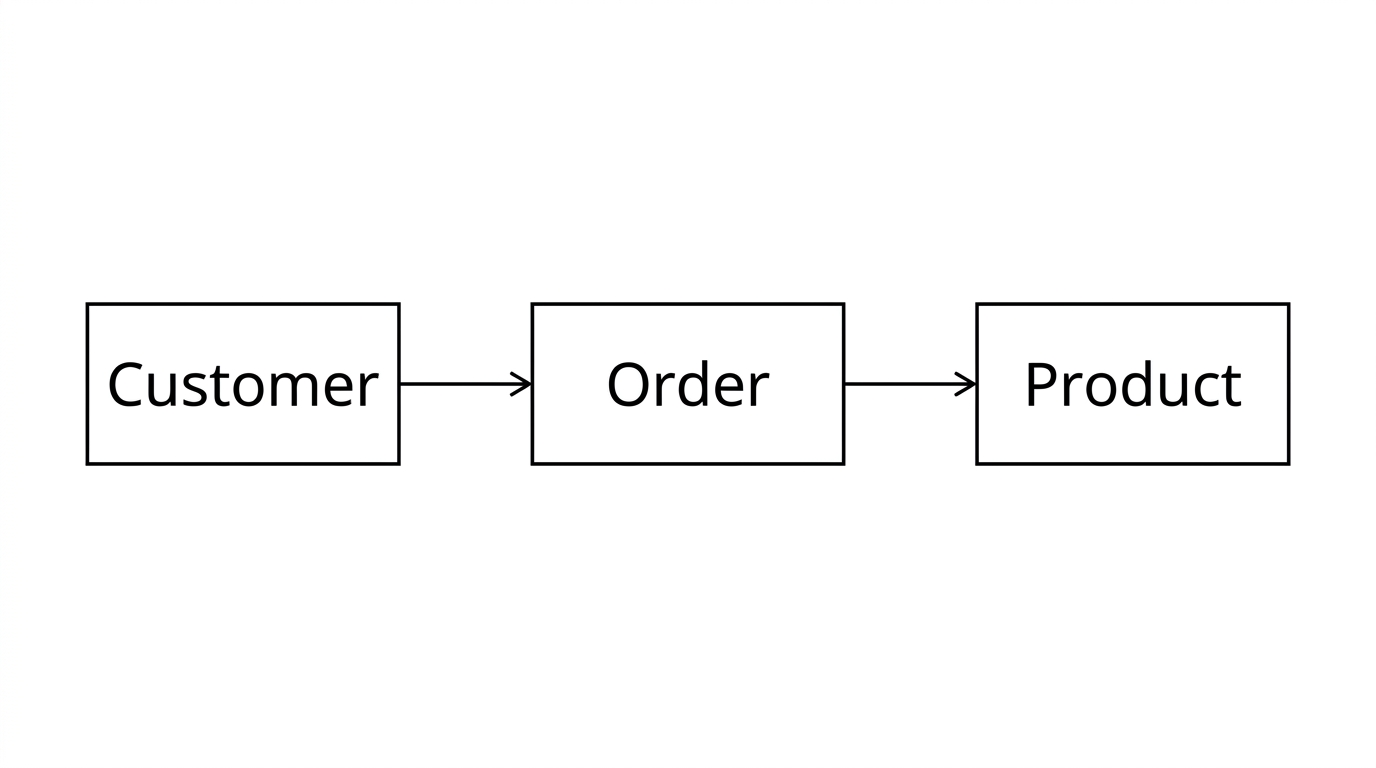
این Set مشخص میکند که Customer چه Order هایی دارد.
بنابراین ساختار کلی میتواند به صورت زیر باشد:
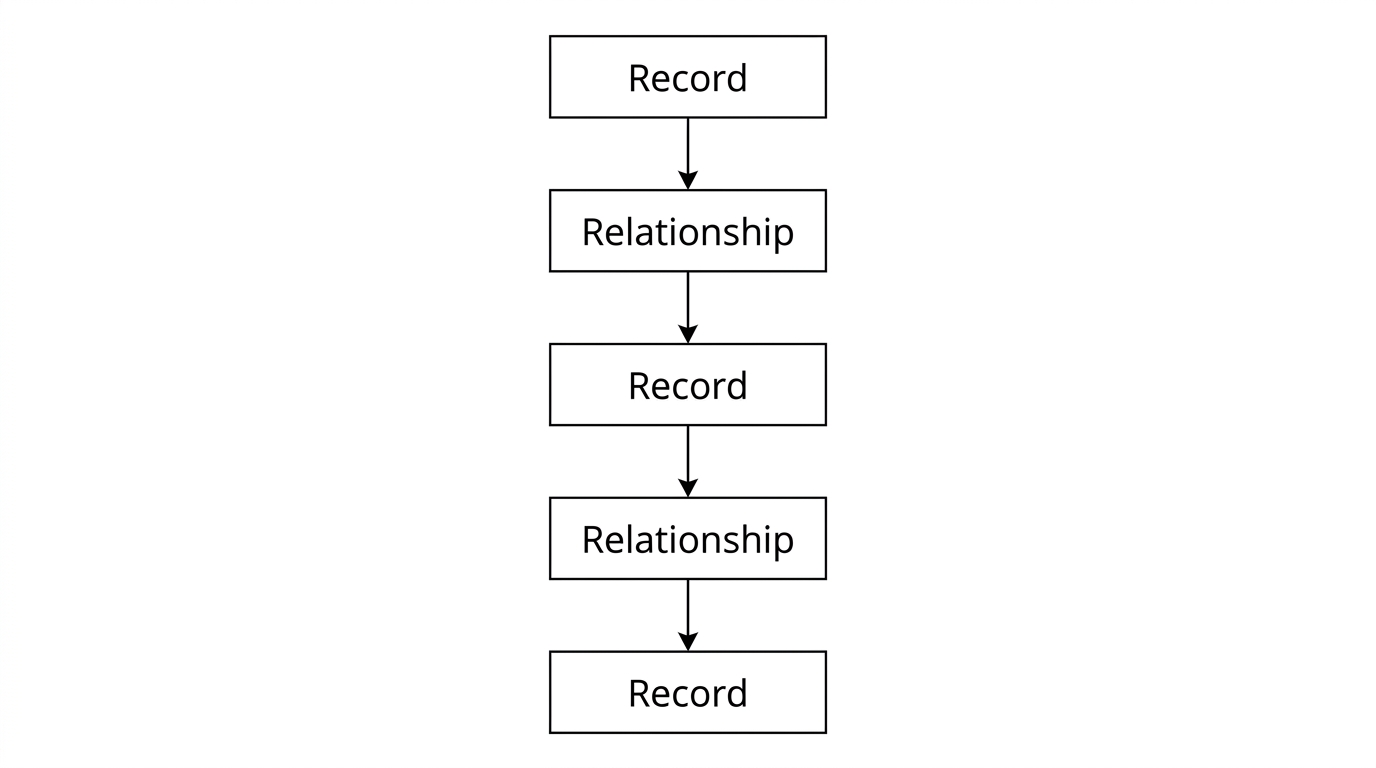
این ساختار اجازه میدهد یک Record از طریق ارتباطهای مختلف به چند Record دیگر متصل شود.
یکی از ویژگی های مهم سیستم های شبکهای این بود که برنامه معمولاً با استفاده از مسیر های از پیش تعریف شده در ساختار داده حرکت میکرد.
برای مثال، ممکن بود برنامه چنین مسیری را طی کند:
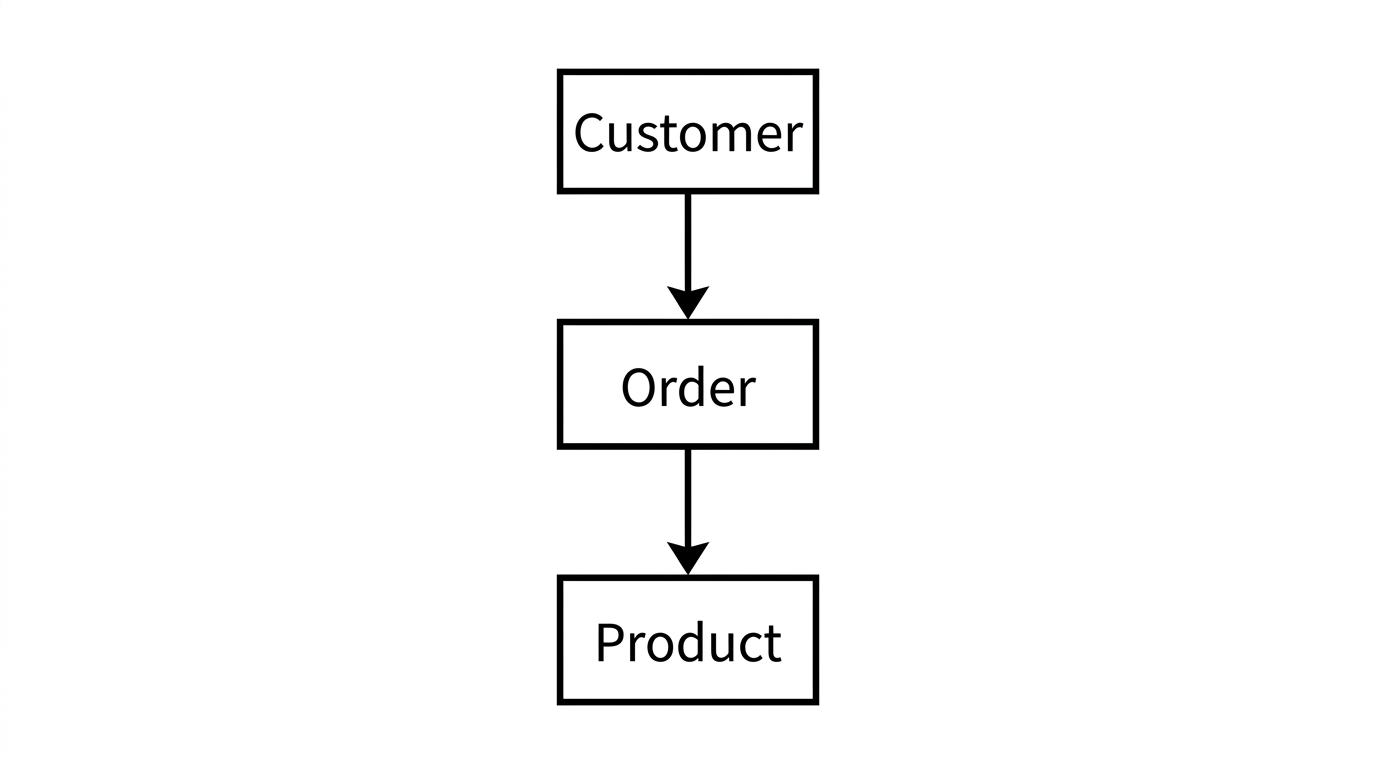
یعنی ابتدا Customer پیدا شود، سپس از طریق رابطه مربوطه به Order برسیم و بعد از آن به Product برویم.
به این رویکرد Navigational Access (دسترسی پیمایشی) گفته میشود.
در این مدل، برنامه بیشتر درگیر ساختار و مسیر دسترسی به داده بود.
این موضوع از یک طرف باعث میشد دسترسی به مسیرهای مشخص بسیار سریع باشد، اما از طرف دیگر برنامه را به ساختار فیزیکی و منطقی داده وابستهتر میکرد.
مدل شبکهای برای زمان خودش مزایای مهمی داشت.
مدل سازی روابط پیچیده
ساختار شبکهای میتوانست روابط پیچیده و حتی چند به چند را به خوبی نمایش دهد.
دسترسی سریع به داده
از آنجا که مسیر های دسترسی به داده از قبل مشخص بودند، پیمایش در مسیر های شناخته شده میتوانست بسیار کارآمد باشد.
مناسب برای سیستم های بزرگ و عملیاتی
سیستم هایی که ساختار داده و الگوی دسترسی آنها از قبل مشخص بود، میتوانستند از این مدل بهره زیادی ببرند.
همین ویژگی هایی که باعث سرعت آن میشدند، مشکلاتی نیز ایجاد میکردند.
مهمترین مشکل، وابستگی برنامه به ساختار داده و مسیرهای دسترسی بود.
فرض کنید برنامه برای رسیدن به Product این مسیر را میشناسد:
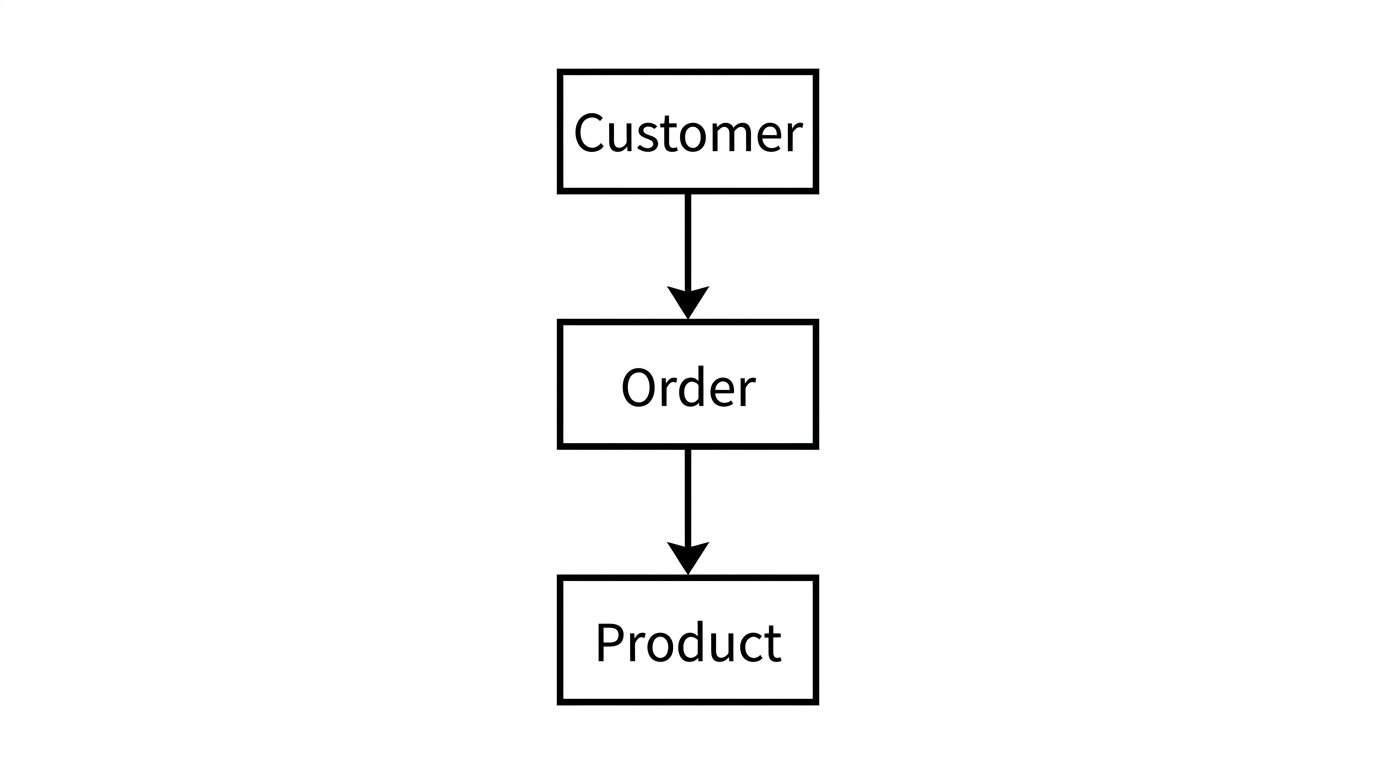
اگر ساختار داده تغییر کند، ممکن است لازم باشد منطق برنامه نیز تغییر کند.
در نتیجه، برنامه نویس فقط با داده سر و کار نداشت؛ بلکه باید تا حد زیادی ساختار و نحوه پیمایش داده را نیز میشناخت و این دقیقاً یکی از زمینه هایی بود که بعد ها مدل رابطهای تلاش کرد از آن فاصله بگیرد.
وقتی به این موضوع اشاره میکنیم دقیقا منظورمان چیست؟ آیا دیگر لازم نیست برنامه ساختار و نحوه پیمایش داده را بداند؟ پاسخ این است که خیر، در بسیاری از DBMS های امروزی، برنامه لازم نیست که مسیر پیمایش داده یا نحوه کار DBMS انتخاب شده را بداند. برای درک بهتر این موضوع، به دو مفهوم Imperative و Declarative در ادامه پرداخته ایم که میتوانید قبل از ادامه خواندن این بخش، اول درباره این دو مفهموم بخوانید.
مدل شبکهای دیگر مدل غالب در DBMS های عمومی امروزی نیست و RDBMS ها بخش بسیار بزرگ تری از کاربرد های سنتی پایگاه داده را در اختیار گرفتهاند.
با این حال، ایده اصلی آن کاملاً از بین نرفته است. امروزه مفهوم Graph Database (پایگاه داده گرافی) از ساختارهایی استفاده میکند که در نگاه مفهومی شباهت زیادی به ایده شبکهای دارند.
برای مثال:
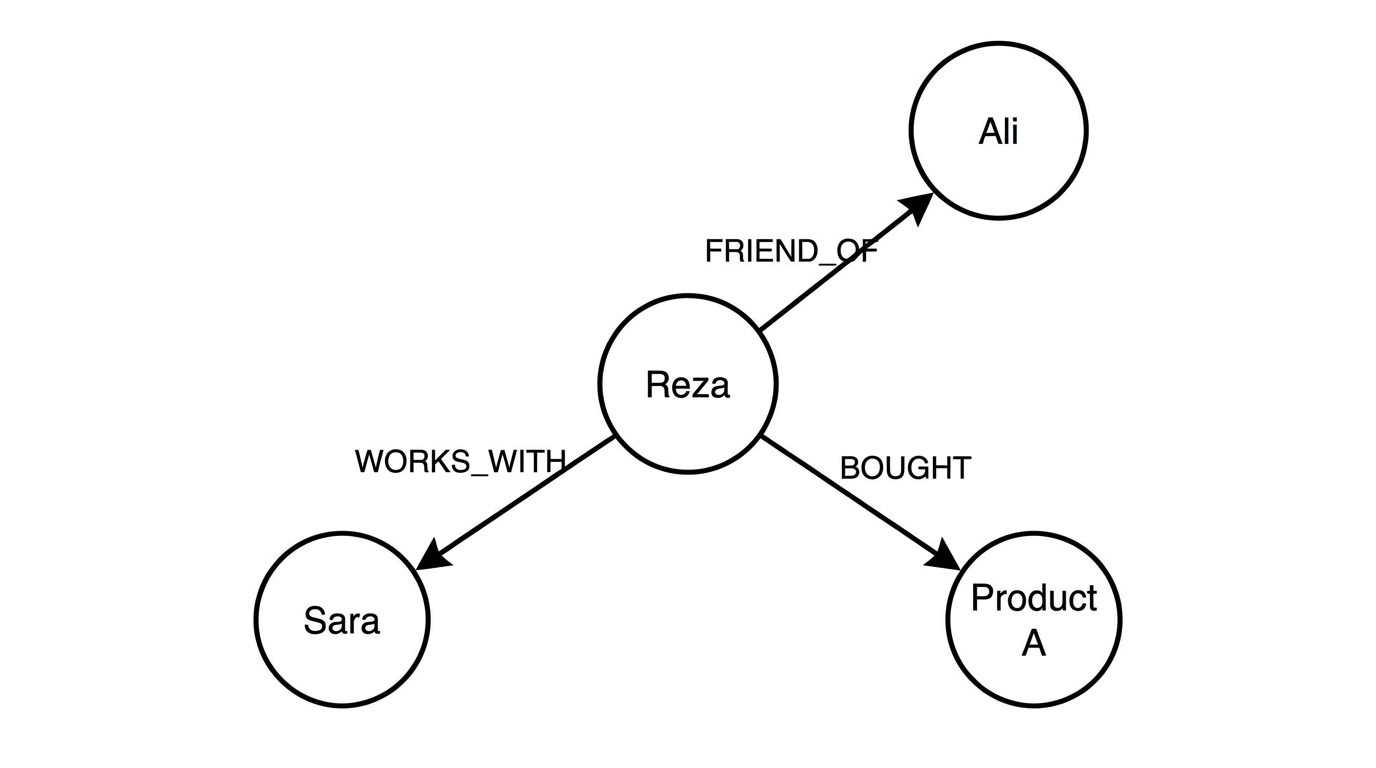
البته Graph Database ها مدل ها و معماری های مدرن خودشان را دارند و نباید آنها را صرفاً نسخه جدید Network Database دانست؛ اما شباهت مفهومی آنها نشان میدهد که ایده نمایش مستقیم روابط میان دادهها همچنان بسیار مهم است.
یکی از نخستین مدلهای مهم برای مدیریت ساختاریافته دادهها، Hierarchical Data Model (مدل دادهای سلسله مراتبی) بود.
در این مدل، داده ها به صورت یک Tree (درخت) سازمان دهی میشوند. هر داده در ساختار درختی قرار میگیرد و ارتباط میان دادهها بر اساس رابطه Parent-Child (والد-فرزند) شکل میگیرد.
یکی از معروف ترین سیستمهای مبتنی بر این مدل، IBM IMS (Information Management System) است که IBM آن را برای پروژه Apollo توسعه داد و نخستین نسخه آن در سال ۱۹۶۸ عملیاتی شد.
IMS در ابتدا برای مدیریت حجم زیادی از اطلاعات مربوط به قطعات و ساختارهای پروژه Apollo طراحی شده بود و بعدها به یکی از مهمترین سیستمهای Hierarchical Database تبدیل شد.
ساختار ساده یک مدل سلسله مراتبی را میتوان اینگونه دید: (عکس hm-1)
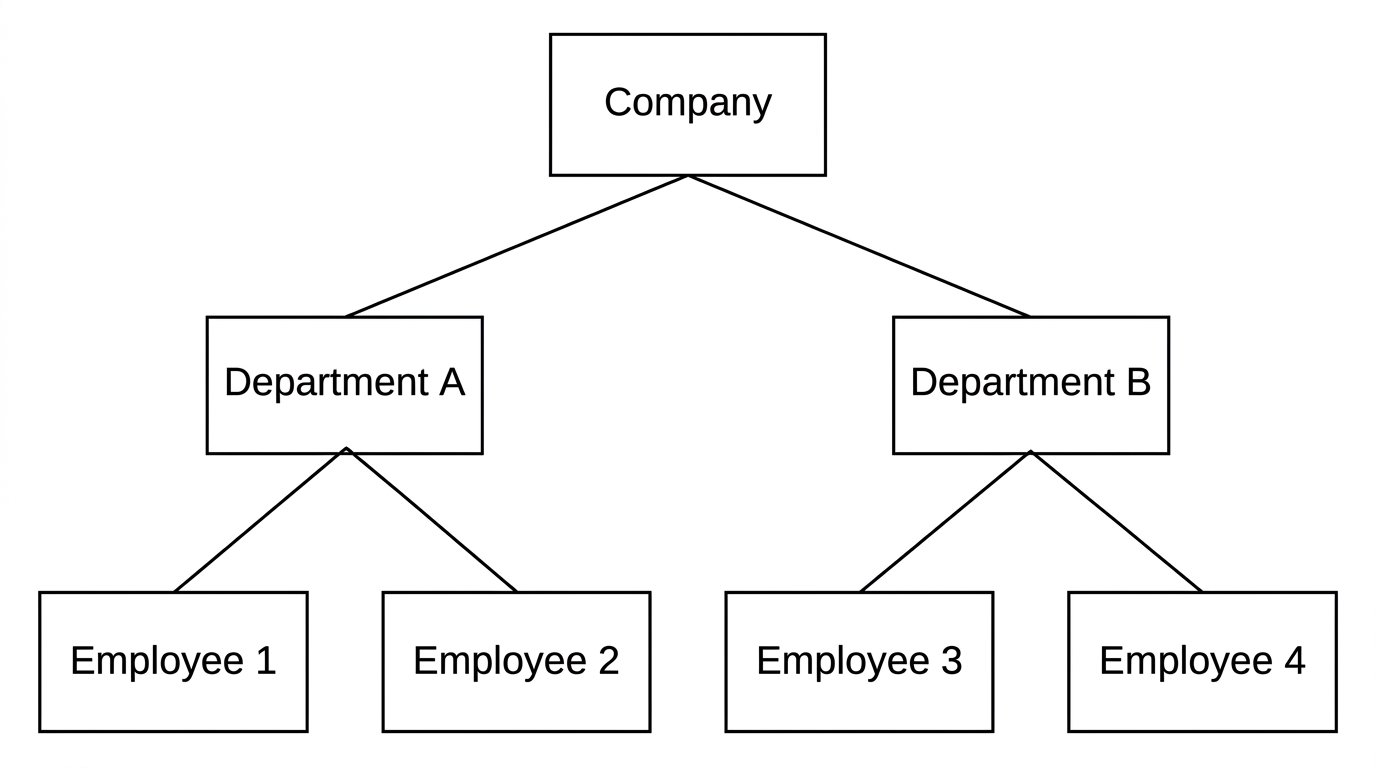
در این مثال:
Company ریشه درخت (Root) است.
Departmentها فرزندان Company هستند.
Employeeها فرزندان Department هستند.
بنابراین دادهها از بالا به پایین و در قالب یک سلسله مراتب سازمان دهی شدهاند.
مهم ترین مفهوم در این مدل، رابطه Parent-Child (والد-فرزند) است.با اشاره به عکس (hm-1)،Department والد و Employee ها فرزندان آن هستند.
در اینجا Department والد و Employee ها فرزندان آن هستند.
یک Parent میتواند چند Child داشته باشد، اما هر Child در ساختار سلسله مراتبی کلاسیک فقط یک Parent دارد.
به همین دلیل ساختار این مدل ذاتاً یک One-to-Many (یک به چند) است.
( روابط میان موجودیت ها به طور کلی به 3 حالت One-to-Many , Many-to-One , Many-to-Many تقسیم میشوند. که ارزش توجه به صورت جداگانه به این 3 روابط را دارند. و در بسیاری از بخش های این مقاله این روابط بین موجودیت ها شکل گرفته اند اما به طور محسوس پرداخته نشده است. )
بالاترین Node (گره) در درخت، Root (ریشه) نام دارد.
برای مثال در عکس بالا Department ریشه ساختار است و تمامی فرزند های دیگر زیر مجموعه آن قرار میگیرند.
در سیستمهای Hierarchical Database، داده ها در قالب Record (رکورد) نگهداری میشوند و رکوردها بر اساس رابطه والد-فرزند سازمان دهی میشوند.
وابستگی به ساختار (پیمایشی)
مشابه مدل شبکهای، برنامه باید دقیقا میدانست از کجا باید پیمایش را شروع کند و چطور به رکورد موردنظر برسد. اگر ساختار درخت تغییر میکرد (مثلا یک Department جا به جا میشد یا سلسله مراتب سازمانی عوض میشد)، منطق برنامه هم باید برروزرسانی میشد.
ناتوانی در مدلسازی طبیعی روابط Many-to-Many
این مهم ترین محدودیت مدل سلسلهمراتبیه. به یاد بیاورید که هر Child فقط یک Parent دارد. حالا این سناریو را در نظر بگیرید: فرض کنید یک Employee به دلیل یک پروژه مشترک، هم زمان عضو دو Department باشد (مثلا هم Department فنی و هم Department محصول). در ساختار درختی، این Employee نمیتواند هم زمان فرزند دو Parent باشد.
راهحلی که معمولا در عمل استفاده میشد این بود که رکورد همان Employee را زیر هر دو Department کپی کنند. اما این کار دقیقا همان مشکلی است که قبلا در بخش Normalization به آن اشاره کردیم: Data Redundancy. اگر فردا شماره تماس آن کارمند تغییر کند، باید آن را در چندین جای مختلف برروزرسانی کنید؛ در غیر این صورت دادهها با هم ناسازگار میشوند.
این دقیقا همان مشکلی بود که مدل رابطهای، با پشتیبانی مستقیم از ارتباط بین جداول (به جای تو در تو کردن داده ها)، سعی کرد آن را حل کند.
مدل سلسله مراتبی دیگر انتخاب عمومی و غالب برای طراحی Database های جدید نیست، اما ایده ساختار درختی همچنان در سیستمهای مدرن بسیار استفاده میشود.
برخی سیستمهای امروزی برای کاربردهای خاص همچنان از مدلهای سلسله مراتبی استفاده میکنند؛ IMS یکی از نمونههای مهمی است که با وجود قدمت زیاد، هنوز به عنوان یک سیستم پایگاه داده سلسله مراتبی مورد استفاده قرار میگیرد.
در مدل سلسله مراتبی، ساختار اساسا یک Tree (درخت) است و هر Node یک Parent مشخص دارد.
اما در مدل شبکهای، یک Record میتواند از طریق ارتباط های مختلف به چند Record دیگر متصل شود.در نتیجه، ساختار شبکهای میتواند روابط Many-to-Many (چند به چند) را مستقیماً مدل کند.
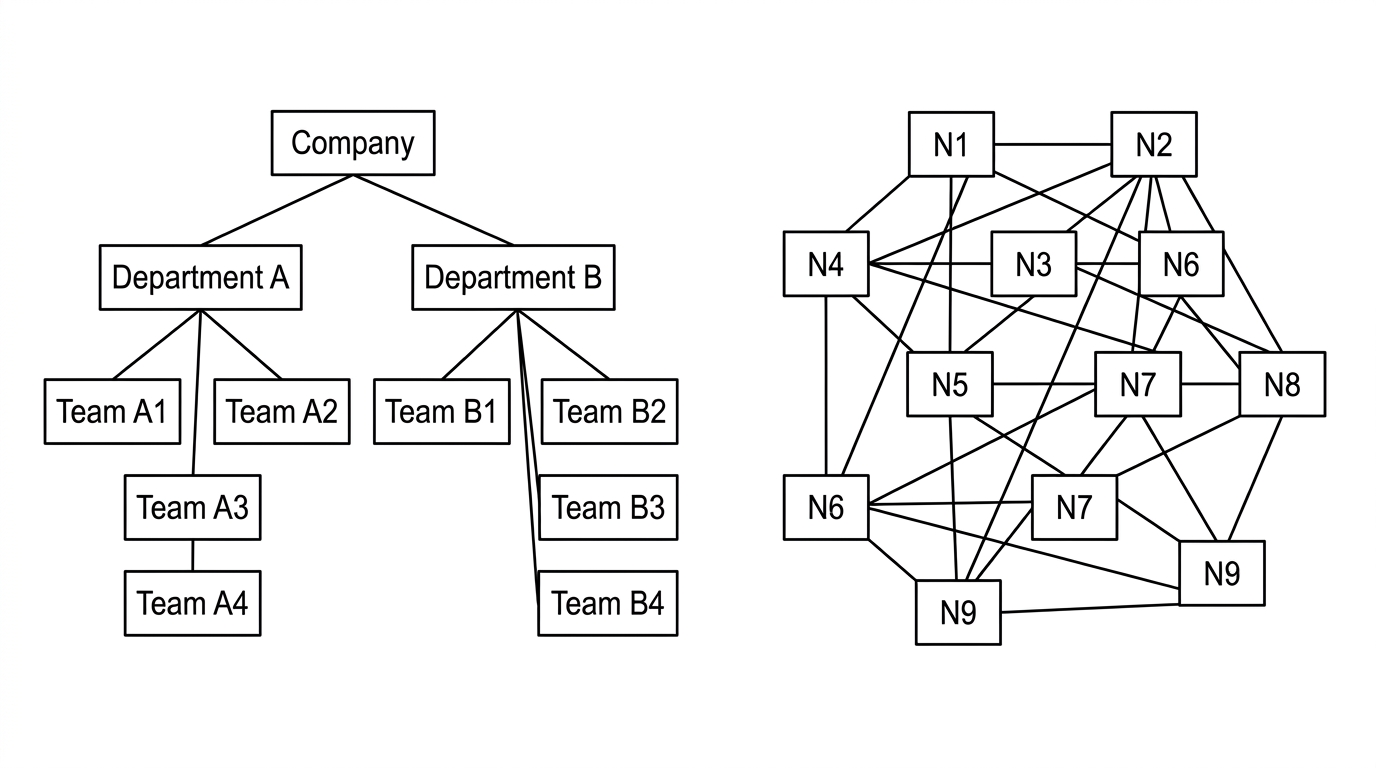
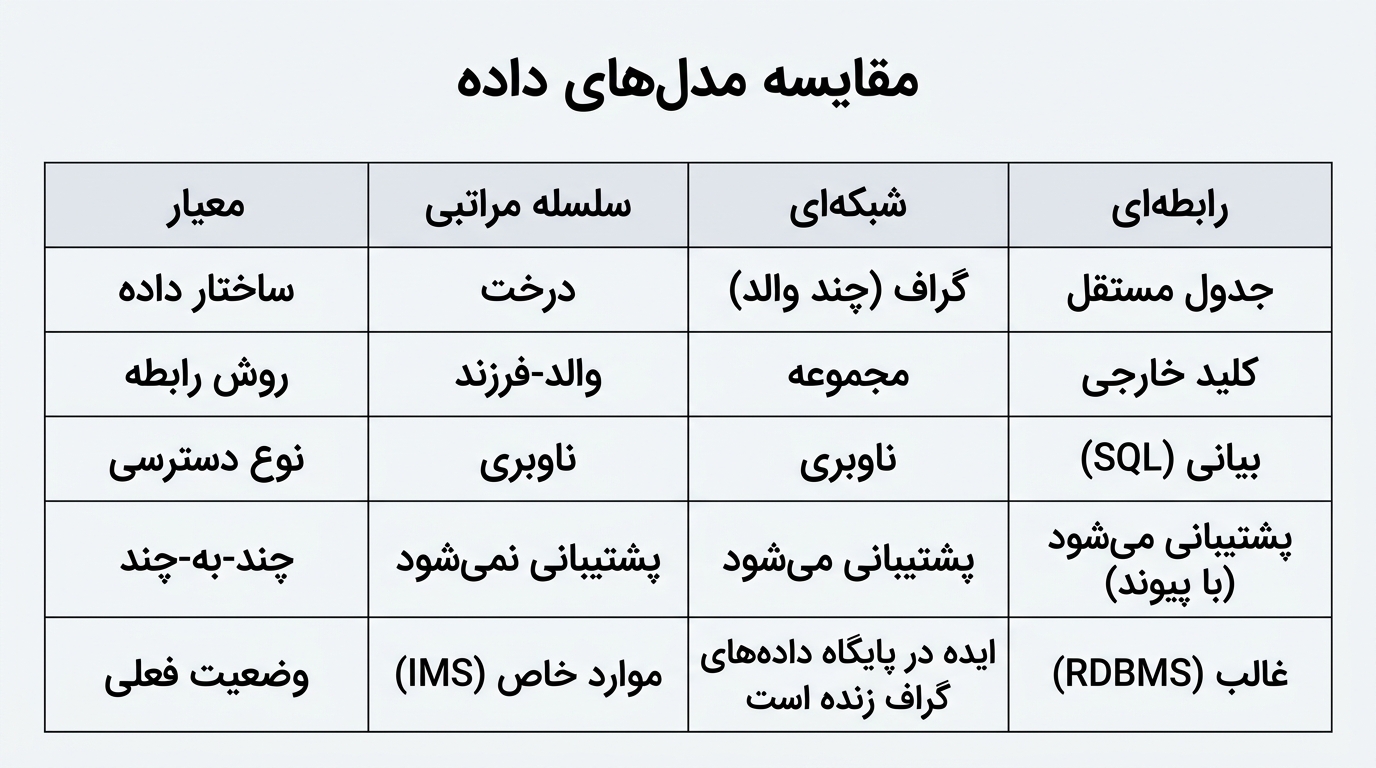
در بخش های قبلی اشاره کردیم که یکی از تفاوت های مهم میان DBMS های مبتنی بر مدل های سلسله مراتبی و شبکهای با RDBMS ها، نحوه تعامل برنامه با دادهها و ساختار آن ها است.
در سیستم های مبتنی بر مدل های سلسله مراتبی و شبکهای، دسترسی به داده ها معمولاً به صورت Navigational (پیمایشی) انجام میشد. یعنی برنامه باید تا حد زیادی ساختار داده و مسیر رسیدن به اطلاعات را بشناسد.
برای مثال، ممکن بود برنامه برای رسیدن به یک رکورد، از مسیر رکورد های دیگر عبور کنیم.
در این حالت، برنامه تا حدی با ساختار و نحوه پیمایش داده نیز درگیر است. اگر ساختار یا مسیر دسترسی تغییر کند، لازم است منطق برنامه نیز تغییر کند.
این نوع بیان دستور ها به مفهوم Imperative (دستوری) نزدیک است.
در رویکرد Imperative، مشخص میکنیم چگونه یک کار انجام شود؛ یعنی مراحل و دستورهایی را که باید اجرا شوند بیان میکنیم.
در مقابل، Declarative (اعلانی) رویکرد متفاوتی دارد. در این روش بیشتر مشخص میکنیم چه چیزی میخواهیم و جزئیات مربوط به نحوه انجام کار را به سیستم واگذار میکنیم.
یکی از مثال های مهم آن در دنیای پایگاه داده، SQL است:
SELECT name
FROM users
WHERE age > 20;
در این Query فقط مشخص کردهایم که چه دادهای میخواهیم: نام کاربرانی که سن آنها بیشتر از ۲۰ سال است.
نگفته ایم:
ابتدا کدام فایل را بخوان.
از کدام ردیف شروع کن.
داده ها را با چه الگوریتمی جست و جو کن.
این تصمیمها بر عهده خود DBMS است. DBMS Query را تجزیه و تحلیل میکند، برای آن Execution Plan (برنامه اجرایی) میسازد و با استفاده از اجزایی مانند Query Optimizer (بهینه ساز پرس و جو) تلاش میکند آن را به شکل مناسبی اجرا کند.
البته این دو مفهوم فقط به Database و حتی فقط به برنامه نویسی محدود نمیشوند. در حوزه های مختلف علوم کامپیوتر و مهندسی نرما فزار میتوان نمونه هایی از هر دو رویکرد را مشاهده کرد.
برای مثال، در توسعه رابط کاربری با React معمولاً به جای اینکه مستقیماً و مرحله به مرحله DOM را تغییر دهیم، وضعیت و ساختار مورد نظر UI را بیان میکنیم.
برای نمونه:
function Counter({ count }) {
    return <h1>{count}</h1>;
}
ما مشخص میکنیم که وقتی count مقدار مشخصی دارد، UI باید چگونه باشد. لازم نیست خودمان کد هایی بنویسیم که پیدا کردن عنصر DOM، تغییر متن آن و مدیریت جزئیات بروزرسانی را انجام دهند.
React این جزئیات را در پشت abstraction خود مدیریت میکند.
به همین دلیل React را معمولاً یک رویکرد Declarative UI در نظر میگیریم.
البته نباید این دو مفهوم را به صورت «خوب و بد» یا «قدیمی و جدید» در نظر گرفت. هر دو رویکرد کاربرد خودشان را دارند.
برای مثال، در جا هایی که کنترل دقیق مراحل اجرا اهمیت دارد، رویکرد Imperative میتواند مناسب تر باشد. در مقابل، وقتی میخواهیم جزئیات پیچیده پیاده سازی را به یک ابزار یا سیستم واگذار کنیم، رویکرد Declarative میتواند abstraction مناسب تری در اختیار ما قرار دهد.
در واقع بسیاری از ابزارهای مدرن ترکیبی از هر دو رویکرد هستند.
SQL یکی از معروفترین نمونههای زبانهای Declarative است و در RDBMS های مختلف برای بیان Query ها استفاده میشود.
در دنیای MongoDB نیز MongoDB Query Language (MQL) برای جستوجو و کار با دادهها استفاده میشود. بخش زیادی از MQL نیز ماهیتی Declarative دارد؛ یعنی به جای مشخص کردن مراحل پایینسطح دسترسی به داده، نتیجه یا عملیاتی را که میخواهیم بیان میکنیم و MongoDB نحوهٔ اجرای آن را مدیریت میکند.
زمانی که کسی میگوید به NOSQL مسلط است، در واقع جمله ای گُنگ و نامفهوم بیان کرده است؛ زیرا NOSQL طیف وسیعی از DBMS ها را دربر میگیرد. به تمامی DBMS ها به غیر از RDBMS ها، NOSQL میگویم.
که میتواند Key-Value Store مانند redis باشد، یا Document Database مانند MongoDB، یا سلسه مراتبی مانند IMS!
داستان انتخاب این نام برای این طیف وسیع از DBMS ها هم بر میگردد به سال 2009 که چند نفر از فعالان حوزهٔ دیتابیس میخواستند یک دورهمی برگزار کنند و دربارهٔ دیتابیسهای جدید و غیررابطهای که آن زمان در حال شکلگیری بودند صحبت کنند. برای پیدا کردن یک اسم کوتاه و مناسب برای دورهمی، در فضای آنلاین و توییتر دنبال یک نام بودند و در نهایت NoSQL پیشنهاد شد.
اسم خیلی سریع بین جامعه فنی پخش شد و کمکم از نام یک دورهمی فراتر رفت و تبدیل شد به عنوانی برای مجموعهای از دیتابیسهای غیررابطهای و جنبشی که حول آنها شکل گرفته بود.
حرف آخر را اول زدم (بخش مقدمه) و در اینجا حرفی نیست. اگر این مقاله را خواندید و نقدی داشتید، دوست داشتید یا خوشتان نیامد، ما را در بخش نظرات مطلع کنید.

