
در این قسمت از معماری مایکروسرویس ها از وبسایت پرووید ما در رابطه با یک موضوع بسیار مهم در این سبک معماری صحبت خواهیم کرد و آن موضوع نیز decentralized data management و یا مدیریت داده ها به صورت غیر متمرکز می باشد. برای درک هرچه بهتر این ویژگی، به خواندن این درس از این سری آموزشی ادامه بدهید.
در بسیاری از معماریهای monolithic، نرم افزار مورد نظر داده ها را در یک database متمرکز و تک، ذخیرهسازی میکند و از این طریق نیازمندی های مختلف نرم افزار را پیاده سازی می نماید. تصویر زیر دقیقاً همین موضوع را نشان میدهد.
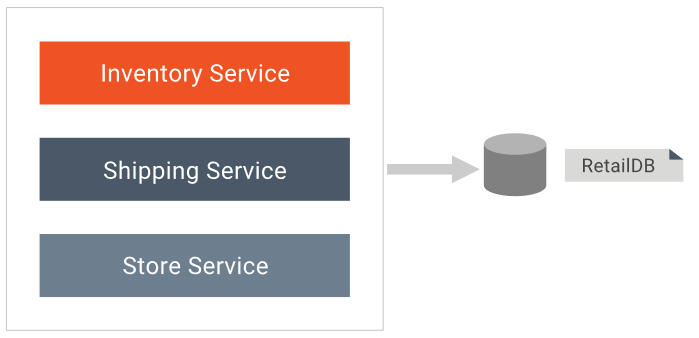
این موضوع در حالی است که در معماری مایکروسرویس ها نیازمندی های تجاری اغلب بین مایکروسرویس های مختلف تقسیم می گردند. بنابراین اگر بخواهیم از یک database تک و متمرکز استفاده کنیم، پیادهسازی loose coupling بین سرویس ها دشوار خواهد شد. در رابطه با loose coupling می توانید از آموزش متنی معکوس سازی کنترل (Inversion of Control) در برنامه نویسی استفاده کنید. منظور از دشوار شدن پیادهسازی loose coupling برای مثال این است که اگر database schema در یک مایکروسرویس تغییر کند، این موضوع باعث میشود که دیگر سرویس ها نیز نتوانند به کار خود ادامه دهند. بنابراین هر مایکروسرویس نیاز است که database منحصر به فرد خود را داشته باشد. این موضوع در تصویر زیر نشان داده شده است.
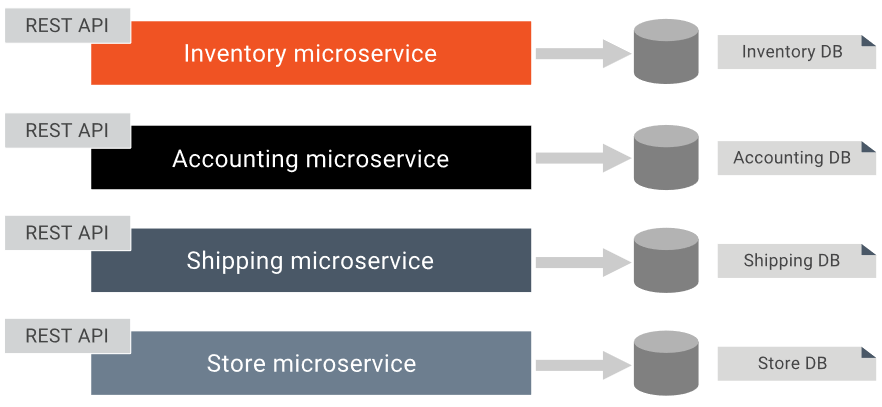
در ادامه در رابطه با مهمترین جنبههای پیاده سازی سیستم مدیریت داده به صورت غیر متمرکز در معماری مایکروسرویس صحبت خواهیم کرد.
با استفاده از سیستم مدیریت داده به صورت غیرمتمرکز شما به سادگی مایکروسرویس ها را از یکدیگر decoupled میکنید و به راحتی میتوانید تکنیکهای مدیریت داده را به صورت کاملاً اختصاصی در هر مایکروسرویس پیاده سازی کنید. به عبارت دیگر؛ می توانید در یکی از مایکروسرویس ها از بانکهای اطلاعاتی رابطه ای استفاده کنید و در دیگر مایکروسرویس ها از بانکهای اطلاعاتی NoSql. این موضوع بر اساس نیازمندی های هر مایکروسرویس اتفاق می افتد. ضمناً زمانی که نیاز به پیادهسازی synchronous messaging بین مایکروسرویس های مختلف داریم میتوانیم از چندین تکنیک مختلف استفاده کنیم. به عبارت دیگر؛ به سادگی می توان مایکروسرویس ها را با یکدیگر ترکیب کرد و با استفاده از فراخوان های سرویس و یا اصطلاحاً service call ها، داده های درون database مایکروسرویس های مختلف را با API هر کدام از آنها بروزرسانی نمود. علاوه بر این؛ می توانیم برای انتشار داده ها مابین چندین مایکروسرویس از event-based messaging و یا ارسال پیام مبتنی بر رویداد استفاده کنیم.
الگو های متعدد و متنوعی از قبیل CQRS وجود دارد که در مدیریت داده ها در مایکروسرویس ها مورد استفاده قرار میگیرند. در این رابطه توصیه میکنیم از بسته ی آموزش ویدئویی معماری مدرن نرم افزار Domain Model، CQRS و Event Sourcing استفاده کنید.
در این قسمت، این درس را به اتمام می رسانیم و درس بعدی را آغاز خواهیم کرد.

