
از یک فایل بودجه پرسیدم «هزینهٔ کل پروژه چقدر است؟» و مدل زبانی با خیال راحت عددی گفت. عدد درست بود. فقط یک مشکل داشت: نمیدانستم از کجای سند آمده، و اگر غلط بود، راهی برای فهمیدنش نداشتم. همین سؤال را از یک جزوهٔ اسکنشده پرسیدم و این بار پاسخ کاملاً ساختگی بود.
پارسرگ را برای همین ساختم. پارسرگ برنامهای است برای پرسیدن از اسناد فارسی و انگلیسی (فایلهای PDF، Word و PowerPoint، اسکنها و عکسها) که روی رایانهٔ خودتان اجرا میشود. کنار هر پاسخ، شمارهٔ ارجاع به همان فایل و صفحه، اسلاید، بند، جدول یا تصویری را میبینید که پاسخ از آن آمده. خواندن فایلها، OCR، ساخت بردارها و جستوجو همه روی سیستم شما انجام میشود.
نمونهٔ زنده و معرفی کامل را در وبسایت پارسرگ گذاشتهام. کد هم در مخزن پارسرگ در گیتهاب است.
اگر ترجیح میدهید اول خود برنامه را در حال کار ببینید، ویدیوی دموی پارسرگ را ضبط کردهام.
در این نوشته تعریف میکنم RAG روی سند فارسی کجاها از انتظارم سختتر بود، برای هر کدام چه کردم، و نسخهٔ تازه (۱.۱) چه چیزهایی اضافه کرده. آخر نوشته هم محدودیتها را بیتعارف گفتهام.
اگر پارسرگ را از قبل میشناسید، اینها تغییرهای اصلیاند:
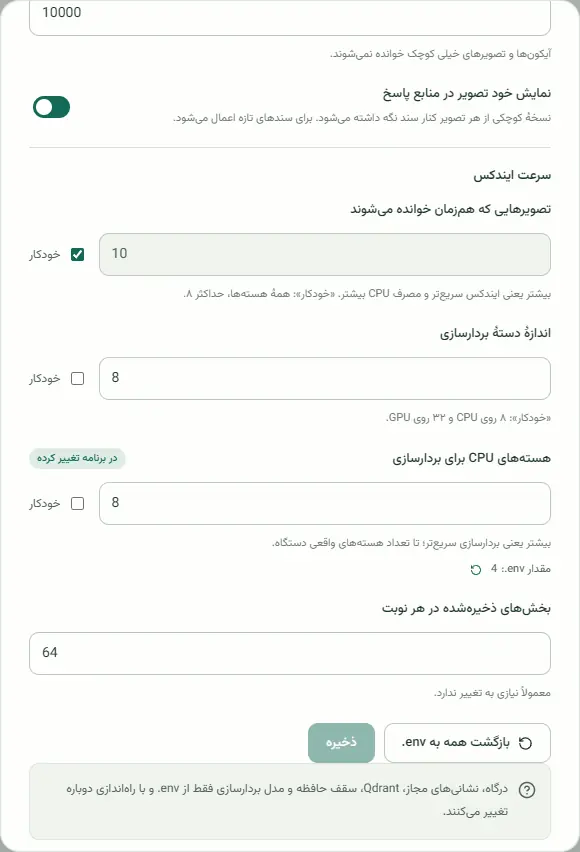
تنظیمات داخل خود برنامه: ۲۷ تنظیم که قبلاً فقط با ویرایش فایل .env و راهاندازی دوباره عوض میشدند، حالا از صفحهٔ تنظیمات عوض میشوند. کنار هر کدام مقدار .env هم نوشته شده و با یک کلیک به همان برمیگردد.
اتصال به Ollamaی نصبشده روی همان رایانه، با مدلها و کارت گرافیک خودش. دیگر لازم نیست Ollama را جداگانه داخل داکر بیاورید.
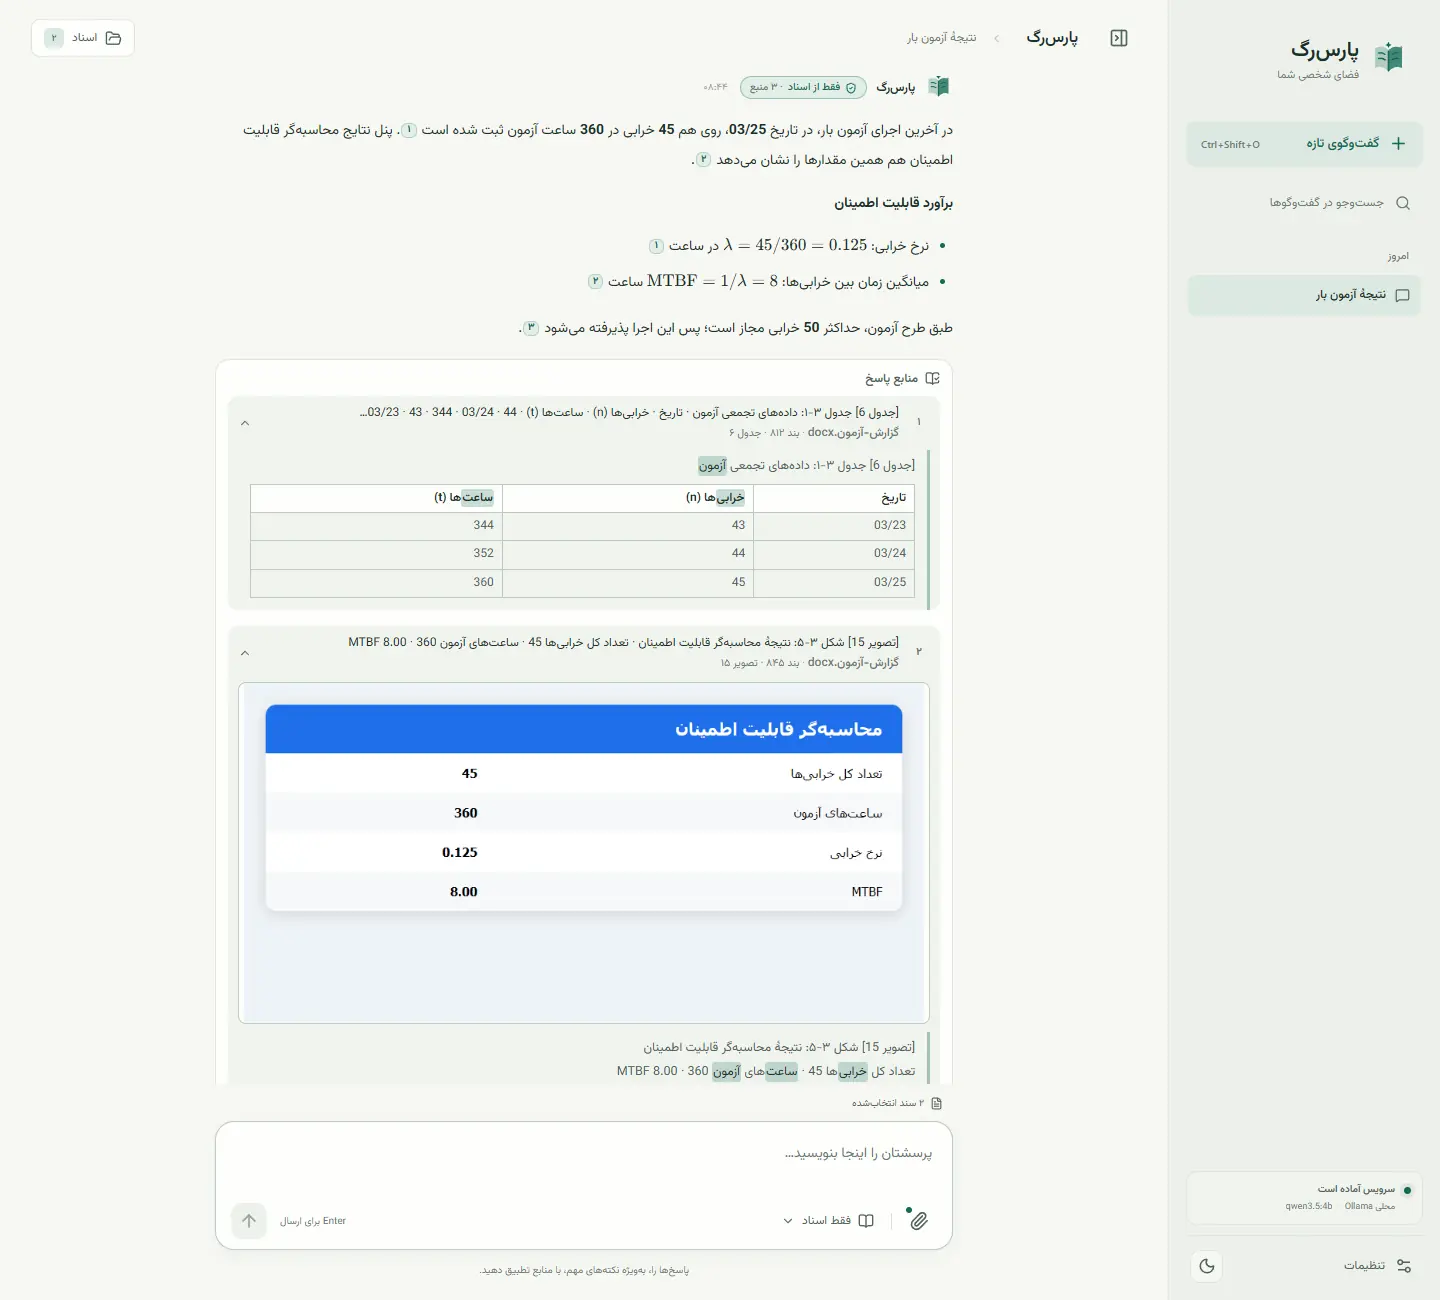
ارجاع به تصویر و جدول: متنی که از یک عکس داخل فایل Word یا PowerPoint خوانده شده، جدا ارجاع داده میشود (مثلاً «بند ۸۴۵ · تصویر ۱۵») و خود تصویر هم کنار منبع نمایش داده میشود. جدولهای Word هم شماره دارند.
پرسشهای چندبخشی: سؤالی که چند چیز را با هم میپرسد، بخشبهبخش جستوجو میشود. در مجموعهٔ آزمون، از ۶ پاسخی که یک بخش از سؤال را جا انداخته بودند، ۵ تا کامل شدند.
سرعت بیشتر: تصویرهای داخل اسناد همزمان خوانده میشوند. گزارشی با ۹۶ تصویر بهجای ۱۲۱ ثانیه در ۳۳ ثانیه خوانده شد و ایندکس کل آن از حدود ۴٫۵ دقیقه به حدود ۳ دقیقه رسید.
خیلی از PDFهای فارسی لایهٔ متنی دارند، ولی آن لایه به درد نمیخورد. بعضی را ابزارهای قدیمی ساختهاند و بهجای حروف اصلی، شکلهای نمایشی حروف را ذخیره کردهاند (همان شکلهای چسبیده و جدا). در بعضی دیگر متن به ترتیب دیداری بیرون میآید و کلمههای جمله برعکس میشوند. خیلیها هم اصلاً اسکناند و متنی ندارند.
پارسرگ متن PDF فارسی را از روی جای قرارگیری حروف و به ترتیب خواندن بازسازی میکند. اگر صفحه لایهٔ متنی یونیکد قابلاستفاده نداشته باشد، بهجای اینکه متن خراب ایندکس شود، به OCR سپرده میشود.
موتور OCR همان Tesseract است، با دادههای فارسی و انگلیسی. تنظیمش بیشتر از چیزی که فکر میکردم اثر داشت. وقتی صفحهها را خاکستری و با وضوح ۲۰۰ dpi خواندم، کشیدگی کنتراست را حذف کردم، یک دور دوم بر اساس میزان اطمینان گذاشتم و نشانههای نامرئی جهت متن را برداشتم، میانگین خطای نویسهای از ۰٫۲۲۵ به ۰٫۱۳۳ رسید. صفحههای کج حالشان بدتر بود. حالا جهت صفحه تشخیص داده میشود و صفحهٔ چرخیده یا وارونه دوباره خوانده میشود. روی صفحههایی که ۹۰ درجه چرخیده بودند، خطا از ۰٫۸۵ به ۰٫۰۹ رسید.
در نسخهٔ ۱.۱ به عکسهای داخل اسناد هم رسیدم، چون گزارشهای واقعی پر از اسکرینشاتاند. بعد از دور اصلی OCR، یک دور دیگر مخصوص متنهای پراکنده اجرا میشود؛ همان پنلهای وضعیت، نوارهای تیره و جعبههای رنگی که دور اول جا میانداخت. روی اسکرینشاتهای مجموعهٔ آزمون، تعداد واقعیتهایی که درست خوانده شد از ۳۳ به ۳۷ از ۴۰ رسید. سقف تصویرهایی که از هر فایل Word یا PowerPoint خوانده میشود هم از ۳۰ به ۲۰۰ رفت.
هر کسی که با متن فارسی کد زده، این یکی را میشناسد. «ی» و «ک» فارسی با نسخهٔ عربیشان روی صفحه تقریباً یکیاند، ولی برای کامپیوتر دو رشتهٔ کاملاً متفاوتاند. کشیده، اِعراب، رقمهای عربی و نیمفاصله را هم اضافه کنید؛ ممکن است پرسش شما به بخشی از سند نرسد که دقیقاً جوابش را دارد.
راهحلش هیجانی ندارد، ولی بدون آن بقیهٔ کار بیفایده است. متن همهٔ بخشها پیش از ایندکس به یک املای فارسی یکسان میشود: «ی» و «ک» فارسی، حروف اصلی بهجای شکلهای نمایشی، حذف کشیده و اِعراب، و یکسان شدن رقمها. نکتهٔ مهمتر این است که پرسش شما هم از همین مسیر رد میشود. اینطوری سؤالی که با صفحهکلید فارسی تایپ شده، به متنی میرسد که کسی سالها پیش با صفحهکلید عربی تایپش کرده. فایلهای متنی قدیمی با کدگذاری Windows-1256 هم درست خوانده میشوند.
متن فنی فارسی پر از اسم انگلیسی، عدد، کد و فرمول است. موقع استخراج، نشانههای کنترل جهت لابهلای متن مینشینند. در رابط کاربری هر پاسخ باید جهت خودش را داشته باشد، و نمایشگر فرمول هم عادت دارد کلمهٔ فارسی را مثل متغیر ریاضی کج چاپ کند. پارسرگ جهت هر پاسخ را از روی محتوایش تعیین میکند و نمایش ریاضی طوری اصلاح شده که کلمههای فارسی هیچوقت فرمول حساب نشوند.
برای دانشجویی که آییننامه را چک میکند، یا کسی که قراردادش را میخواند، پاسخ روانی که منبع ندارد از نبودِ پاسخ بدتر است. برای همین ارجاع در پارسرگ یک قابلیت جانبی نیست. مدل به بخشهایی که استفاده کرده با شماره ارجاع میدهد و رابط این شمارهها را به دکمههایی تبدیل میکند که همان بخش سند را باز میکنند. کنار هر پاسخ هم نوشته میشود محتوایش از کجا آمده: فقط از اسناد، از اسناد و دانش مدل، فقط از دانش مدل، یا اینکه جواب در اسناد پیدا نشد.
پاسخگویی هم سه حالت دارد. در حالت «فقط سند»، اگر شاهد کافی پیدا نشود، بهجای حدس زدن صریح میگوید جواب در اسناد نیست. حالت «ترکیبی» اجازه میدهد دانش مدل هم کمک کند و حالت «فقط مدل» اصلاً سراغ اسناد نمیرود.
بکاند با FastAPI نوشته شده و رابط کاربری با React، و همه با Docker Compose بستهبندی شدهاند. معماری از نوع پورت و آداپتور است: هستهٔ برنامه فقط رابطها را میشناسد و یک نقطهٔ ترکیب، آنها را به Qdrant، پارسرها، OCR و مدل وصل میکند.
برای خواندن فایلها از PyMuPDF، python-docx و python-pptx استفاده کردهام و هر جا لازم باشد OCR وارد کار میشود. فایلهای Word زیر سرعنوانهایشان بخشبندی میشوند، و همین باعث شد میانهٔ طول بخشها از ۱۳ کلمه به ۹۱ کلمه برسد. بقیهٔ متن با SentenceSplitter از LlamaIndex در تکههای ۵۱۲ توکنی با ۵۰ توکن همپوشانی تقسیم میشود. بین هر دو صفحهٔ پشتسرهم PDF هم یک تکهٔ پل ساخته میشود (۹۰ کلمهٔ آخر یک صفحه و ۹۰ کلمهٔ اول صفحهٔ بعد)، تا جملهای که وسط شکستن صفحه افتاده گم نشود.
بردارها با مدل multilingual-e5-base روی خود سیستم ساخته میشوند و در Qdrant میمانند. هر گفتوگو دادههای جدای خودش را دارد و جستوجو فقط در اسناد همان گفتوگو انجام میشود. گفتوگو را که پاک کنید، دادههایش هم پاک میشود.
جستوجوی برداری روی اسمها، شناسهها و عددهای دقیق ضعیف است، برای همین کنارش جستوجوی کلیدواژهای BM25 هم هست. روی ۱۲۷ پرسش کلیدواژهای، این ترکیب MRR را از ۰٫۷۴۸ به ۰٫۸۲۳ رساند. در حالت ترکیبی یک cross-encoder مخصوص خط فارسی و عربی هم نتایج را دوباره مرتب میکند. در مقایسه با مدل انگلیسی قبلی، MRR از ۰٫۳۵۴ به ۰٫۷۱۰ رسید.
پاسخ را مدلی مینویسد که خودتان انتخاب میکنید: Ollama روی همین رایانه، یک API سازگار با OpenAI روی سرور خودتان، یا یک سرویس خارجی. فقط همین مرحله ممکن است چیزی را از سیستم شما بیرون ببرد، آن هم وقتی خودتان انتخابش کنید. پارسرگ تا شما تأیید نکنید، به سرویس خارجی وصل نمیشود.
به Docker، Ollama و ۸ تا ۱۶ گیگابایت رم نیاز دارید. مسیر پیشنهادی نسخهٔ ۱.۱ از همان Ollamaی روی رایانهتان استفاده میکند:
ollama pull qwen2.5:7b git clone https://github.com/Pooria82/ParsRAG.git cd ParsRAG cp .env.example .env docker compose up -d --build
در ویندوز بهجای cp از Copy-Item .env.example .env استفاده کنید. در فایل .env فقط مقدار LLM_MODEL_NAME را نام مدلی بگذارید که گرفتهاید؛ بقیهٔ پیشفرضها برای همین حالت تنظیم شدهاند. در لینوکس یک قدم دیگر هم هست: Ollama بهطور پیشفرض فقط روی 127.0.0.1 گوش میدهد و کانتینر به آن نمیرسد. باید در سرویس Ollama مقدار OLLAMA_HOST=172.17.0.1:11434 را تنظیم کنید. جزئیاتش در راهنمای نصب فارسی آمده.
بعد نشانی http://127.0.0.1:8000 را باز کنید، سند بارگذاری کنید و بپرسید. اگر Ollama روی سیستم ندارید، میتوانید آن را داخل داکر اجرا کنید یا از صفحهٔ تنظیمات به یک API وصل شوید. وقتی مدلها یک بار دانلود شدند، حالت Ollama بدون اینترنت هم کار میکند.
حالت «فقط سند» محافظ است، نه تضمین. روی مجموعهٔ ارزیابی خودم، امتیاز شباهت پرسشهای مربوط و نامربوط خیلی به هم نزدیک بود (میانهٔ ۰٫۸۰۶ و ۰٫۸۰۷). پس این دروازه فقط چیزهای کاملاً بیربط را کنار میگذارد و تصمیم آخر با مدل است. پاسخهای مهم را حتماً با منبعشان چک کنید؛ ارجاعها دقیقاً برای همیناند.
برای OCR هم سقف گذاشتهام. بهطور پیشفرض ۳۰ صفحهٔ اسکنشده از هر PDF و ۲۰۰ تصویر از هر فایل Office خوانده میشود و برای بقیه، پیامی زیر سند میبینید. اسکن بیکیفیت هم هنوز متن بیکیفیت میدهد.
اجرای مدل روی CPU همهجا کار میکند، ولی کند است. روی کارتی با حدود ۶ گیگابایت حافظه، مدلهای ۳ تا ۴ میلیارد پارامتری کامل روی GPU جا میشوند. اگر هم API خارجی انتخاب کنید، پرسش و بخشهای بازیابیشدهٔ سند به آن سرویس میرود؛ بردارها و Qdrant در همهٔ حالتها محلی میمانند.
برنامه برای یک نفر روی یک رایانه طراحی شده: بهطور پیشفرض ۱۰ سند در هر گفتوگو و تا ۱۰۰ مگابایت برای هر فایل. اگر مدل embedding را عوض کنید، باید سندها را دوباره بارگذاری کنید. عددهای این نوشته هم از مجموعههای ارزیابی خودم آمدهاند، نه از یک بنچمارک عمومی.
و دربارهٔ مجوز: پارسرگ «کد منبع در دسترس» است، نه متنباز. میتوانید کد را بخوانید و نسخهٔ رسمی و دستنخورده را برای استفادهٔ شخصی، دانشگاهی، پژوهشی، آموزشی و داخل سازمان اجرا کنید. تغییراتتان را هم میتوانید با Pull Request به همین مخزن بفرستید. انتشار دوباره، تغییر نام و ارائه بهعنوان سرویس بدون اجازه مجاز نیست.
پارسرگ بدون اینترنت کار میکند؟ بله. بعد از اینکه ایمیجهای داکر و مدلها یک بار دانلود شدند، با Ollama همهچیز روی رایانهٔ خودتان اجرا میشود.
برای استفاده کارت گرافیک لازم است؟ نه. روی CPU هم کار میکند، فقط کندتر. با کارت گرافیک، پاسخها خیلی سریعتر نوشته میشوند.
فایل PDF اسکنشدهٔ فارسی را میخواند؟ بله، با OCR فارسی و انگلیسی. صفحههای کج یا وارونه هم دوباره خوانده میشوند.
میتوانم از مدلهای OpenAI یا Gemini استفاده کنم؟ بله؛ هر سرویسی که API سازگار با OpenAI داشته باشد کار میکند، از جمله نسخهٔ رایگان Google AI Studio. فقط بدانید در این حالت بخشهایی از سند برای آن سرویس فرستاده میشود.
بیشتر زحمت RAG فارسی ربطی به خود مدل زبانی نداشت. وقتم رفت سر درست درآوردن متن: ترتیب خواندن، یکسانسازی حروف، تنظیم OCR و مرز تکهها. وقتی متن درست شد، ارجاع دقیق به صفحه هم چیزی شد که میشد رویش حساب کرد.
اگر با اسناد فارسی کار میکنید و جایی از کار برایتان خراب میشود، خوشحال میشوم بشنوم؛ در بخش Issues مخزن یا همینجا در نظرها. برای دیدن نمونهٔ زنده و معرفی کامل به وبسایت پارسرگ سر بزنید، و اگر به کارتان آمد، یک ستاره در گیتهاب کمک میکند دیگران هم پیدایش کنند.
در پست لینکدینم هم پارسرگ را معرفی کردهام و ویدیوی دمو را آنجا هم گذاشتهام. اگر لینکدین دارید، نظرتان را آنجا هم بنویسید.

