
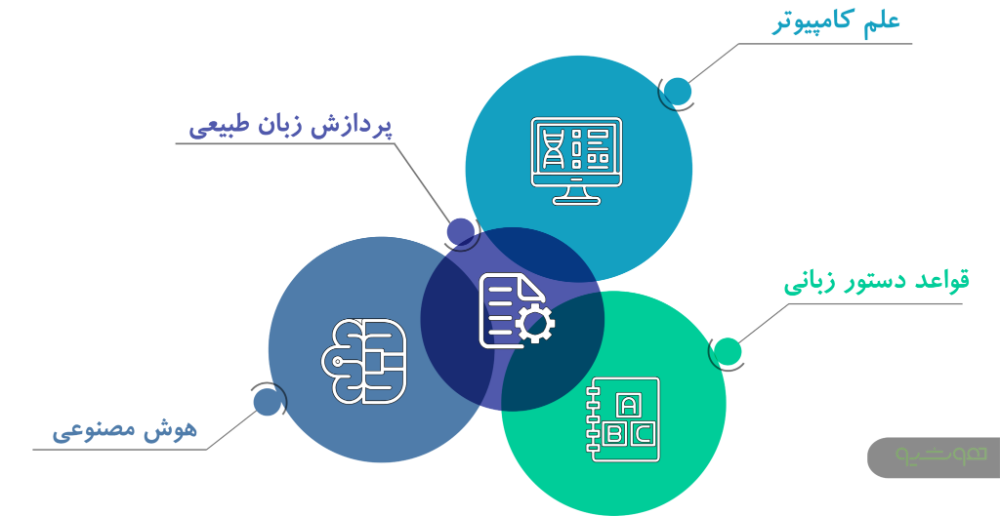
پردازش زبان طبیعی (NLP) به شاخهای از علوم رایانه و بهطور خاص، شاخهای از هوش مصنوعی یا AI مربوط میشود که در آن با استفاده از مدلهای آماری، یادگیری ماشین و یادگیری عمیق میتوان رایانه ها را نهتنها قادر ساخت که زبان انسان را در قالب متن یا دادههای صوتی پردازش کرده و معنای آن را “کاملاً” درک کنند بلکه نیت و احساس نویسنده را نیز متوجه شوند.
انسان دائماً محیط خود را بر اساس نیازهایش شکل میدهد و این تغییرات به اشکال مختلف ظاهر میشوند، مهمترین تغییر به وجود آمده توسط بشر تولید و استفاده از زبانهای طبیعی برای برقراری ارتباط با همنوعان خود هست. بشر به کمک زبانهای طبیعی میتواند افکار، خواستهها و رؤیاهایش را بیان کند و با برقراری ارتباط سبب ایجاد جوامع مختلف شود.
حال انسان امروزی درحالتوسعه و آموزش زبان طبیعی به ماشینها است تا آنها نیز بتوانند زبان انسان را در درجه اول درک کرده و سپس آن را تولید کنند و با انسانها به برقراری ارتباط بپردازند.
مطالعه پردازش زبان طبیعی بهطورکلی در دهه ۱۹۵۰ آغاز شد، اگرچه برخی آثار را میتوان از دورههای قبلی نیز یافت. در سال ۱۹۵۰ ، آلن تورینگ مقالهای تحت عنوان “ماشینهای محاسبه و هوش” منتشر کرد که آنچه را که امروزه آزمایش تورینگ نامیده میشود بهعنوان معیار هوش ارائه میدهد.
بیشتر بخوانید: یادگیری انتقالی در پردازش زبان طبیعی – بخش دوم
برای شروع پردازش یک متن و آموزش یک سیستم باید چند مرحله مختلف طی شود. در ادامه این مراحل به تشریح آمده است:
کتابخانههای مورداستفاده در پردازش زبان طبیعی فارسی
زبان فارسی قواعد دستور زبانی خاص خود را دارد؛ همین امر سبب شده است تا برای پردازش متون فارسی نیاز به ابزارها و کتابخانههایی باشد که بتواند به محققین در این راستا کمک کند. در طی این سالها کتابخانههای بسیاری جهت حل این مشکل توسعه دادهشده است که در ادامه به برخی از آنها برای نمونه اشارهشده است:
در قرن حاضر هوش مصنوعی بخشی از زندگی روزمره انسانها شده است. Alexa و Siri ، تصحیح خودکار پیامک و ایمیل، چت باتهای خدمات مشتری، همگی از الگوریتمهای یادگیری ماشین و پردازش زبان طبیعی (NLP) برای پردازش، درک و پاسخگویی به زبان انسان، چه نوشتاری و چه گفتاری استفاده میکنند. بااینوجود ابن فناوری هنوز چالشهای را در بردارد که محققین در حال تلاش برای رفع آنها هستند و در ادامه به این چالشها پرداختهشده است.
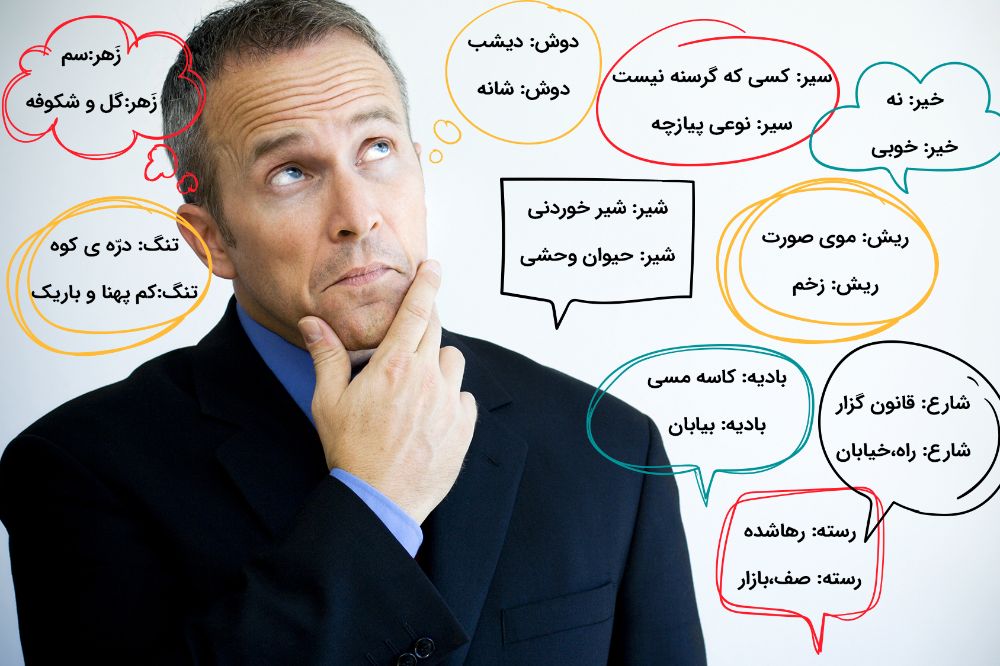
پردازش زبان طبیعی فارسی و انگلیسی از حیث ماهیت وجودیشان با یکدیگر متفاوت است. در زبان انگلیسی و عموم زبانهای اروپایی و آمریکایی حروف از هم جدا هستند و کلمات باقاعدهی خاصی از هم فاصلهدارند. این در حالی است که در زبان فارسی بعضی از حروف به هم چسبیده و برخی حروف جدا هستند. کلمات نیز گاهی یکپارچهاند و گاهی به کمک فاصله و یا نیمفاصله به دو یا چند بخش تقسیم میشوند.
متنکاوی (که به آن تجزیهوتحلیل متن نیز گفته میشود) یک فناوری هوش مصنوعی (AI) است که از پردازش زبان طبیعی (NLP) برای تبدیل متن آزاد (بدون ساختار) در اسناد و پایگاههای داده به دادههای عادی و ساختاریافته مناسب برای تجزیهوتحلیل استفاده میکند.
پردازش زبان طبیعی نیروی محرکه هوش ماشینی در بسیاری از کاربردهای مدرن دنیای واقعی است. در اینجا به چند نمونه اشارهشده است:
بیشتر بخوانید: GPT-3: قابلیتی خلاقانه در پردازش زبان طبیعی (NLP)
کاربردهای پردازش زبان طبیعی در آموزش
کاربردهای پردازش زبان طبیعی در فین تک
کاربردهای پردازش زبان طبیعی در تولید
کاربردهای پردازش زبان طبیعی در رسانه و شبکههای اجتماعی
درک زبان طبیعی شاخهای از پردازش زبان طبیعی است که از نرمافزارهای رایانهای برای درک ورودی در قالب جملات با استفاده از متن یا گفتار استفاده میکند. NLU تعامل میان انسان و کامپیوتر را برقرار میکند که هدف اصلی آن ایجاد رباتهایی باقابلیت چت و مکالمه است که میتوانند بدون نظارت با مردم تعامل داشته باشند. بسیاری از شرکتهای بزرگ فناوری اطلاعات مانند آمازون، اپل، گوگل و مایکروسافت پروژههای درک زبان طبیعی را در دست اجرا دارند.
تولید زبان طبیعی زیرمجموعه دیگری از پردازش زبان طبیعی است. درحالیکه درک زبان طبیعی بر درک خواندن رایانه متمرکز است، تولید زبان طبیعی رایانهها را قادر به نوشتن میکند. NLG فرآیند تولید یک پاسخ متنی به زبان انسانی بر اساس برخی از ورودی دادهها است. همچنین میتوان این متن را از طریق سرویسهای تبدیل متن به گفتار به قالب گفتاری تبدیل کرد.
پردازش زبان طبیعی (NLP) به دنبال تبدیل دادههای زبان بدون ساختار به یک قالب داده ساختاریافته است تا ماشینها را قادر به درک گفتار و متن و فرمولبندی پاسخهای مرتبط و متنی کند. زیرمجموعههای فرعی آن شامل درک زبان طبیعی و تولید زبان طبیعی است.
منبع:

