
کتاب هنر شفاف اندیشیدن که چند سال پیش ترجمهاش در ایران منتشر شد، خیلی گَُل کرد؛ یک علت اساسیاش شاید این بود که عادل فردوسیپور ترجمهاش کرده بود.
در این کتاب فهرستی از خطاهای شناختی به همراه مثالهای تاثیرگذار و البته ارجاعات فراوان به نیکلاس طالب! به مخاطب تقدیم میشه. با این حال خود نویسنده تاکید داره که:
من پیش از هر چیز رماننویس و سرمایهگذارم، نه دانشمند جامعهشناس. [...] به نظر خودم نقش مترجمی را دارم کارش جمعبندی و تبیین چیزی است که خوانده و آموخته.
اگه شما هم مثل من مهندس باشین و این کتاب رو حداقل دو بار خونده باشین، بعید نیست این ایده در ذهنتون جرقه خورده باشه که: برخی از مباحث کتاب رو میشه به بیان علم آمار و احتمال مطرح کرد. این نوشته به بررسی همین ایده اختصاص داره.
برای فهم این نوشته بهتره که یه آشنایی اولیه با مفهوم توزیعهای آماری داشته باشین، با این حال من چند خط توضیح در حدی که برای فهم مطلب لازمه ارائه میدم. در اینجا بیشتر میتونید دربارهاش بخونید.
راستی این اولین نوشته من درباره این کتاب نیست. در ماهنامه شبکه یکی از فصلهای کتاب رو نقد کرده بودم و در یک پست لینکدین هم گریزی به یکی از مباحث زده بودم.
قبل از ادامه بحث، تعریف شفاف اندیشیدن رو از زبان نویسنده مرور کنیم:
ناتوانی در شفافاندیشی - یا به قول متخصصان «خطای شناختی»، یک انحراف اصولی از منطق است، انحراف از افکار و رفتار بهینه، عقلانی و مستدل.
حتی اگه با این حوزه آشنا هستین این بخش رو یه نگاهی بندازین چون در ادامه بهش ارجاع میدم.
ببینید هر پدیدهای که یه مقدار عددی داشته باشه که قابل محاسبه برای ما نباشه، میتونیم واسش یک مقدار احتمال به دست بیاریم.
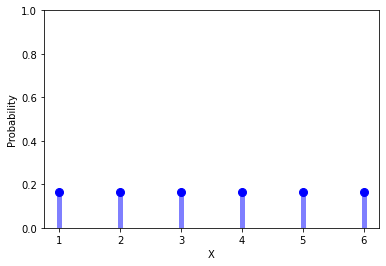
مثلاً یک تاس رو که پرتاب کنیم نمیدونیم چه عددی قراره بیاد، اما انتظار داریم که یکی از اعداد 1 تا 6 بیاد.با این حساب اگه یک تاس رو هزاران بار پرتاب کنیم و تعداد دفعاتی که هر عدد میاد رو بشمریم و تقسیم بر تعداد کل پرتابها کنیم، شکل زیر ایجاد میشه که بهش میگن توزیع احتمال یکنواخت:
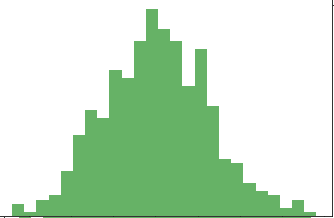
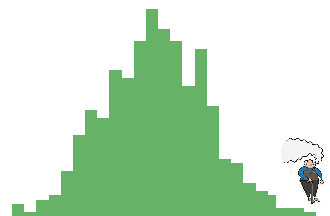
اما همه پدیدههای طبیعت چنین توزیع احتمالی ندارن. برای مثال اگه وزن تعداد زیادی آدم رو بگیریم و تعداد افراد هر وزن رو روی محور نسبت به تعداد کل افراد رسم کنیم، چیزی شبیه شکل ایجاد میشه که بهش میگن توزیع نرمال. خیلی از پدیدههای طبیعت از توزیع نرمال پیروی میکنن.
حالا چند تا نکته بگم و بریم سراغ بحث اصلی:
یکی از محورهای مشترک برخی خطاهای شناختی ذکرشده در کتاب، همین مثالیه که آخر بخش قبل زدیم: این که با تعداد نمونههای محدود از یک جامعه آماری، به درک نادرستی از اون جامعه میرسیم.
در ادامه چند فصل رو (از 98 فصل کتاب) مثال میزنم و ربطشو به این قضیه روشن میکنم.
فصل یک (خطای بقا)
پشتسر هر نویسندهی موفق میتوانی صد نویسندهی دیگر را پیدا کنی که کتابهایشان هرگز به فروش نمیرسد.
ما تنها نمونههای موفق هر حوزه را میبینیم: نویسندهها، بازیگرها و استارتاپها. برای تصمیمگیری باید همه جامعه آماری را بررسی کرد. به قول نویسنده:
قدم زدن در این قبرستانِ [پروژههای شکستخورده]، ناخوشایند ولی برای شفاف شدن ذهنت لازم است.
فصل هفت و هشت (مراقب موارد استثناء باش)
در این دو فصل، موضوع جالبی مطرح شده: این که ما گاهی در اندازهگیریهایمان صادق نیستیم. مثلاً در همان مسئله آمارگیری وزن افراد، وزن افراد چاق رو در نظر نگیریم. خب شاید این کار عجیب به نظر برسه اما مثالهای کتاب نشون میده اگه این کار منافعی واسمون داشته باشه، خودآگاه یا ناخودآگاه چنین رفتاری رو انجام میدیم.
راهکار رولف دوبلی برای کاهش این خطا چیست؟
سعی کن باورهای خودت را (در مورد جهانبینی، سرمایهگذاریها، ازدواج، سلامت، رژیم غذایی و استراتژیهای شغلی) بنویسی و شروع کنی به پیدا کردن شواهد متناقض.
شاید بدونید آدام گرنت یه کتاب کامل و آموزنده درباره همین موضوع نوشته به اسم دوباره فکر کن.
فصل ده (اثر مقایسهای)
اثر مقایسهای به این صورت کار خودش رو میکنه که شما بر اساس اطلاعات اخیر (به جای کل جامعه آماری) تصمیم میگیری.
یادمه یکی از رفقای قدیمی داشت به استرالیا مهاجرت میکرد. به خاطر شرایط خاص کرونا، بلیط سفرش 120 میلیون تومن شده بود. ما بهش میگفتیم حالا که 120 میلیون خرج کردی، یک میلیون هم بیا به ما شیشلیک بده! ما از عمد دچار اثر مقایسهای شده بودیم و البته شیشلیک خوشمزهای هم خوردیم.
فصل یازده (خطای در دسترس بودن)
شاید بهترین فصلی که با ایده من مطابقت داشته باشه، همین فصله. این که ما بر اساس اطلاعات در دسترس یک توزیع آماریِ نادرست در ذهنمون بنا میکنیم.
«سیگار کشیدن نمیتواند برایت آنقدرها بد باشد؛ پدربزرگ من روزی سه بسته سیگار میکشید و بیشتر از صد سال عمر کرد.»
اگه توزیع طول عمر افراد نرمال باشه، طبیعیه که عده اندکی عمر بالایی داشته باشن و سیگاری هم باشن.
فصل بیست (خطای نتیجه)
در اینجا هم ما با نتیجهگیری از یک سری مشاهده محدود سر و کار داریم که در نتیجه پیشنهاد شده:
هرگز یک تصمیم را صرفاً بر اساس نتیجهاش ارزیابی نکن، به خصوص زمانی که تصادفی بودن یا «عوامل خارجی» در آن نقش داشته باشد.
فصل بیست و چهار (اتفاق تصادفی)
این فصل هم به گوشههای نمودار توزیع احتمال توجه داره، و این که گاهی رویدادهای نادری رخ میده که به قول نویسنده:
اتفاق عجیبتر این است که هرگز رخ ندهند.
مثلاً همزمان تماس گرفتن دو نفر با همدیگه از این رویدادهاست که موجب میشه فکر کنیم دل به دل راه داره!
فصل بیست و شش (نادیده گرفتن احتمالات)
در این روزهایی که این نوشته را مینویسم، سویه اُمیکرون کرونا شتاب گرفته. شاید ده سال دیگه کسی ندونه این عبارت اصلاً یعنی چی اما در حال حاضر دغدغهای جدی برای ماست. خوشبختانه درصد مرگ و میر این سویه نسبت به سویههای قبلی کمتره (به خصوص که اکثراً واکسن زدن) اما چون شیوع بیشتری داره، در مجموع باعث مرگ خیلی از مردم شده.
نادیده گرفتن احتمالات یعنی همین. همین امروز 104 نفر از هموطنان ما بابت کرونا جونشون رو از دست دادن...
فصل پنجاه و پنج (مشکل با میانگینها)
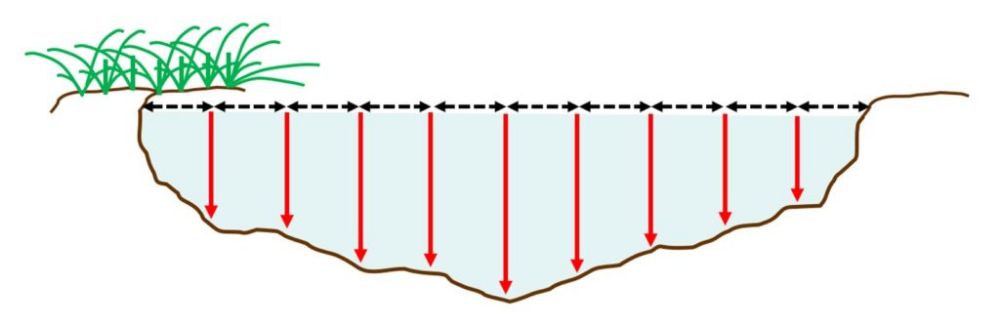
گاهی ما یک توزیع آماری پیچیده را به یک عدد میانگین تقلیل میدیم که میتونه خطرناک باشه. در کتاب این مثال به نقل از نسیم طالب ذکر شده که:
از رودخانهای که (به طور میانگین) عمقش 1.2 متر است عبور نکنید.
این همه قلمفرسایی کردم و هنوز در فصلهای میانی کتاب هستیم. اما به نظرم تونستم منظورمو برسونم که خیلی از خطاهای شناختی از نگاه ناقص ما در زمینه آمار و احتمال ناشی میشه.
هنوز خیلی حرفا میشه درباره این کتاب خوندنی گفت اما اجازه بدین این نوشته رو با این جملات به پایان برسونیم.
(1) اجازه بدین گریزی هم به ماجرای عدم حضور زنان در مصاحبه آقای شعبانعلی بزنم (نوشته قبلی من و این مطلب رو میتونید بخونید تا داستان دستتون بیاد):
بله ممکنه سه نفر مصاحبهکننده در یک جلسه مصاحبه، حتی در یک جهان با برابری جنسیتی، همگی مرد یا همگی زن باشن. این حرف از دیدگاه آماری درسته؛ اما ما در جهانی زندگی میکنیم که میتونیم در اون تغییر ایجاد کنیم و صرفاً مشاهدهگر آمار و احتمالات نیستیم! در یک روزگاری درصد مشخصی از جمعیت مردم دنیا برده و کنیز بودن و خدا رو شکر این توزیع آماری تغییر کرد. من همچنان بر این باورم حضور یک خانم در این مصاحبه مصداق سوء استفادهٔ جنسی آنطور که آقای شعبانعلی گفته نیست و میتونست آموزنده باشه، هر چند که شاید دچار یک خطای شناختی شده باشم.

