
چکیده:
ریزش مشتری یکی از شاخصهای مهم در ارزیابی سلامت و پایداری کسب وکارهای آنلاین است. در این مقاله، با استفاده از الگوریتم XGBoost و دادههای فرضی فروش آنلاین، مدلی برای پیشبینی ریزش مشتری طراحی شده است. با بهرهگیری از مهندسی ویژگی، متعادلسازی دادهها و پیادهسازی رابط تعاملی، تلاش شده راهکاری عملی و قابل استفاده برای شناسایی مشتریان در معرض ریزش ارائه شود. نتایج مدل با استفاده از معیارهای ارزیابی متداول بررسی شده است.
مقدمه:
ریزش مشتری (Customer Churn) یکی از چالشهای مهم در صنایع مختلف خدماتی و فروش آنلاین است. این پدیده بهمعنای قطع ارتباط مشتریان با شرکت در بازهای از زمان بوده و معمولاً از طریق لغو اشتراک یا توقف خرید تشخیص داده میشود. اهمیت موضوع به این دلیل است که نگهداشت مشتریان فعلی بهمراتب کمهزینهتر و سودآورتر از جذب مشتریان جدید است؛ بهطوریکه حتی کاهش جزئی در نرخ ریزش میتواند منجر به افزایش قابلتوجهی در سودآوری شود.
در این پروژه، هدف طراحی و پیادهسازی مدلی برای پیشبینی ریزش مشتریان بر اساس دادههای فرضی یک فروشگاه آنلاین است. مدل انتخابشده XGBoost بوده و تلاش شده با استفاده از تکنیکهایی همچون مهندسی ویژگی، متعادلسازی داده (SMOTE)، و طراحی رابط گرافیکی با Streamlit، مدلی کاربردی و قابلفهم ایجاد گردد.
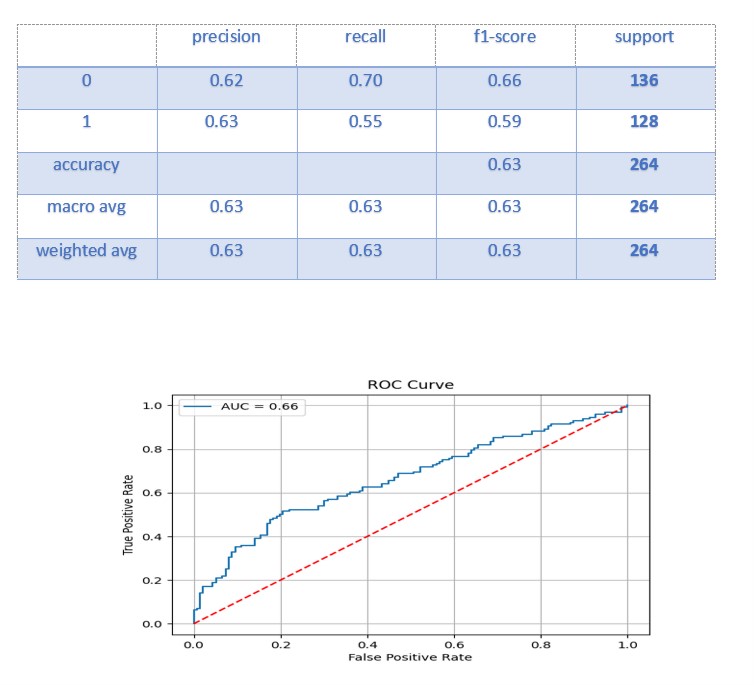
برای ارزیابی مدل، از معیارهای دقت (Accuracy)، بازیابی (Recall)، دقت پیشبینی (Precision)، و نمره F1 استفاده شده و نمودار ROC نیز جهت بررسی عملکرد کلی آورده شده است. در انتها، داشبوردی تعاملی جهت نمایش نتایج و امکان تست آنلاین مدل پیادهسازی گردیده است.
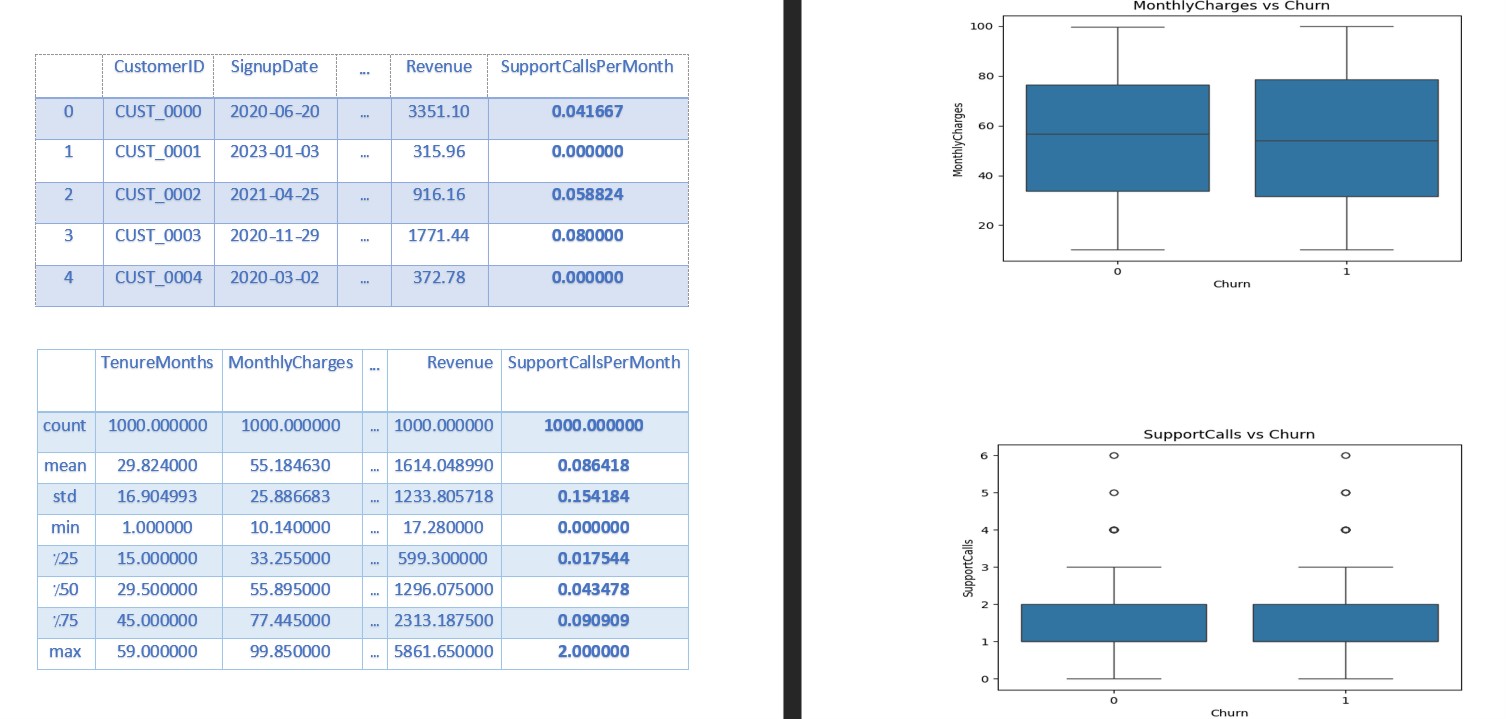
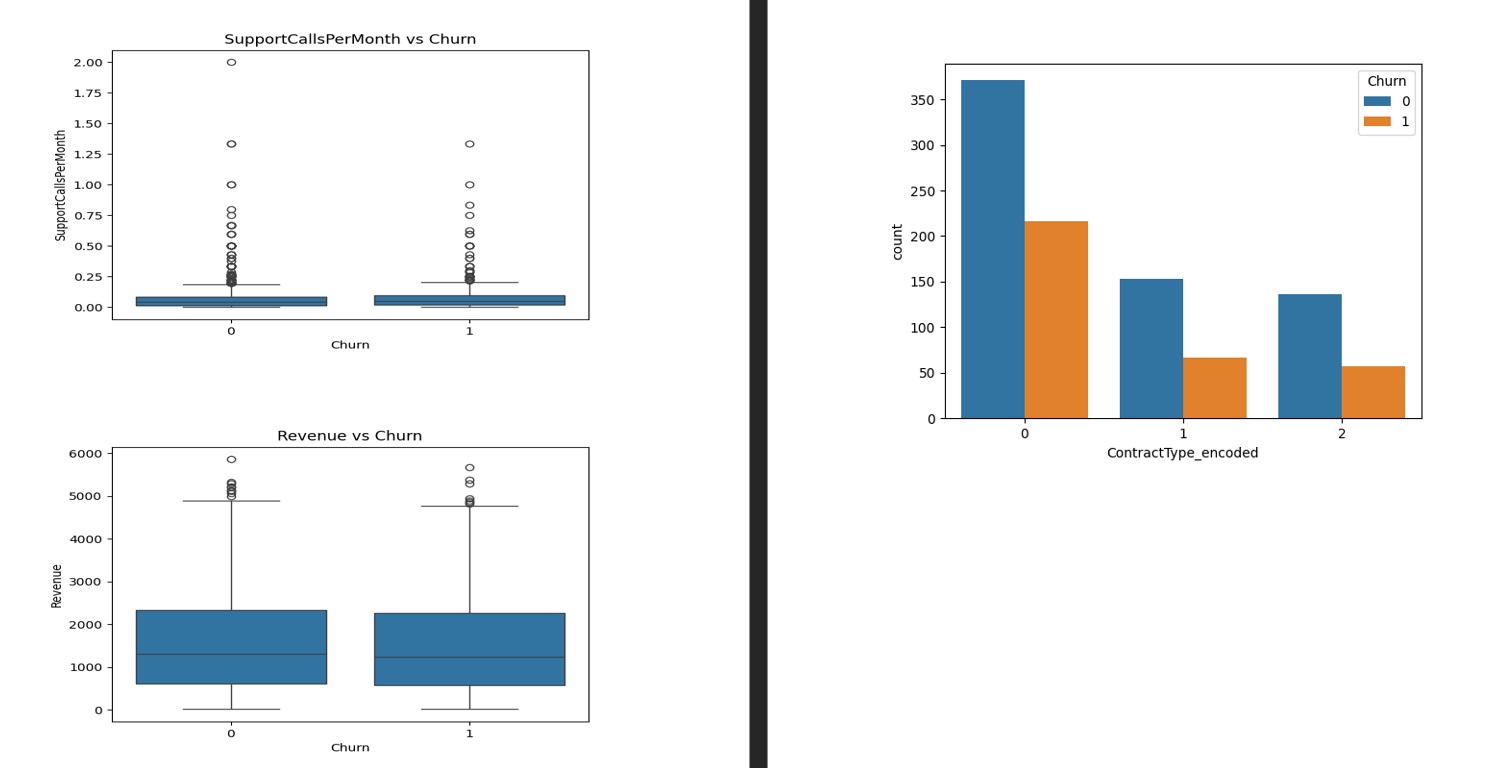
داده ها و تحلیل اولیه :
روششناسی:
در این پروژه برای پیشبینی ریزش مشتری از مدل درخت تصمیمی تقویت شده XGBoost استفاده شده است. مراحل اصلی روششناسی به شرح زیر میباشد:
پیشپردازش و مهندسی ویژگیها:
ابتدا دادهها از فایل CSV بارگذاری شدند. برای پاکسازی، نمونههایی که دارای مقادیر گمشده بودند حذف گردیدند. سپس با استفاده از مهندسی ویژگی چند ویژگی جدید ساخته شد که شامل:
ایجاد متغیر باینری «تماسگیرنده مکرر» (Frequent caller) که اگر تعداد تماسهای پشتیبانی بیش از ۲ بود، مقدار Yes داشت.
رمزگذاری ویژگی قراردادی (ContractType) به عددی و ایجاد متغیر جدید «قرارداد بلندمدت» (IsLongContract) برای مشخص کردن نوع قرارداد.
محاسبه درآمد کل (Revenue) بهصورت حاصلضرب مدت زمان عضویت (TenureMonths) در مبلغ ماهیانه (MonthlyCharges).
محاسبه نرخ تماسهای پشتیبانی در هر ماه (SupportCallsPerMonth) برای نرمالسازی تعداد تماسها نسبت به مدت عضویت.
حل مشکل عدم تعادل دادهها:
چون تعداد مشتریان ریزش کرده کمتر از مشتریان فعال بود، از روش SMOTE (Synthetic Minority Over-sampling Technique) برای افزایش نمونههای کلاس اقلیت (ریزشی) استفاده شد تا مدل در یادگیری ویژگیهای آن کلاس عملکرد بهتری داشته باشد.
تقسیم دادهها:
دادههای بازنمونهبرداری شده به نسبت ۸۰ درصد برای آموزش و ۲۰ درصد برای تست تقسیم شدند.
مدلسازی:
مدل XGBoost بهعنوان الگوریتم یادگیری ماشین انتخاب شد. پارامتر scale_pos_weight بر اساس نسبت وزن کلاسها تنظیم گردید تا مدل بتواند بهطور متعادلتر به هر دو کلاس توجه کند.
ارزیابی مدل:
پس از آموزش، مدل روی دادههای تست ارزیابی شد و معیارهای دقت (Accuracy)، دقت مثبت (Precision)، بازیافت (Recall)، امتیاز F1 و نمودار ROC با مقدار AUC محاسبه و رسم شدند.
نتایج:
بحث:
در این پروژه، مدل XGBoost با استفاده از مهندسی ویژگیهای دقیق و روش SMOTE برای مقابله با عدم تعادل دادهها آموزش داده شد و توانست به دقت حدود ۶۳٪ و امتیاز F1 نزدیک به ۰.۶ برسد. این نشان میدهد مدل عملکرد نسبتاً مناسبی در پیشبینی ریزش مشتریان دارد، هرچند که هنوز جای پیشرفت وجود دارد.
از نتایج مشاهده میشود که دقت مثبت (Precision) مدل کمی بالاتر از بازیافت (Recall) است، به این معنا که مدل در شناسایی صحیح مشتریانی که ریزش میکنند دقت قابل قبولی دارد اما برخی موارد ریزش را ممکن است شناسایی نکند. این موضوع در کاربردهای تجاری مهم است، چون شناسایی درست مشتریان در معرض ریزش برای حفظ و تعامل با آنها حیاتی است.
استفاده از SMOTE برای تعادل کلاسها کمک کرد تا مدل حساستر به نمونههای ریزش شده شود، اما همزمان ممکن است باعث ایجاد نمونههای مصنوعی شود که به طور کامل نماینده واقعیات دنیای واقعی نیستند. بنابراین، دادههای بیشتر یا روشهای پیشرفتهتر مانند ترکیب SMOTE با تکنیکهای کاهش ابعاد یا الگوریتمهای دیگر میتواند به بهبود عملکرد منجر شود.
همچنین، مهندسی ویژگیها نقش مهمی در افزایش توان پیشبینی مدل داشت؛ ویژگیهایی مانند تعداد تماسهای پشتیبانی ماهانه و نوع قرارداد توانستند اطلاعات ارزشمندی برای مدل فراهم کنند.
در نهایت، پیادهسازی داشبورد تعاملی با Streamlit امکان استفاده کاربردی و سریع از مدل را برای تصمیمگیرندگان فراهم میکند که میتواند به واکنش به موقع و کاهش ریزش کمک کند.
نتیجهگیری و پیشنهادات
در این پروژه، با استفاده از مدل XGBoost و مهندسی ویژگیهای هدفمند، توانستیم مدل پیشبینی ریزش مشتری را با دقت قابل قبول (حدود ۶۳٪) توسعه دهیم. همچنین، با بهکارگیری تکنیک SMOTE به منظور مقابله با عدم تعادل دادهها، عملکرد مدل در شناسایی مشتریان مستعد ریزش بهبود یافت. نتایج نشان داد که ویژگیهایی مانند تعداد تماسهای پشتیبانی ماهانه و نوع قرارداد تاثیر قابل توجهی در پیشبینی ریزش دارند.
با وجود این موفقیتها، دقت و یادآوری مدل هنوز جا برای بهبود دارند. در پروژههای آینده میتوان از دادههای بیشتر و متنوعتر بهره برد، از جمله افزودن ویژگیهای رفتاری و تعاملات مشتریان برای افزایش دقت پیشبینی. همچنین استفاده از مدلهای پیشرفتهتر مانند یادگیری عمیق یا ترکیب چند مدل (Ensemble) میتواند به بهبود نتایج کمک کند.
منابع:
در این پروژه برای مدلسازی از کتابخانههای Python مانند scikit-learn، XGBoost و imblearn استفاده شده است. دادهها به صورت مصنوعی (Synthetic) بوده و پیشپردازش و تحلیل داده با کمک مدلسازی از ChatGPT انجام شده است.

