
پیش بینی خطای نرم افزار به دنبال تخمین مکان های خطاست، که فعالیتش را روی بخش های مشکوک متمرکز میکند، که در نتیجه آن، نرمافزاری با کیفیت بالاتر، با زمان و تلاش کمتر منتشر میشود. در واقع هدف این است که یک مدل پیشبینی خطایی را بسازد که بتواند statement یک برنامه را به عنوان مکان های مستعد خطا یا مکان های بدون خطا طبقه بندی کند.
در ادامه به جزییات مقاله که شامل متدولوژی و تعریف مساله میباشد، به طور مختصر میپردازیم .
تکنیک های فعلی پیشبینی خطای نرم افزار، روی ماژول و کلاس کار میکند و همچنین پیدا کردن مکان های خطا برای برنامه نویسان سخت است. برای پرداختن به این مسئله، این مقاله یک روش جدیدی را پیشنهاد میدهد که statement-level نام دارد، که برای پیشبینی خطا از یادگیری عمیق استفاده میکند.(sldeep)
یک ویژگی منحصر به فرد sldeep این است که، یک روش جدید از یادگیری عمیق را نشان می دهد، که برنامهنویسان میتوانند در مواجهه با مشکل از آن استفاده کنند. در این مقاله از 32 معیار statement-level استفاده می شود. همچنین از حافظه کوتاهمدت طولانی (LSTM=long short term memory) به عنوان الگوی یادگیری استفاده میشود.
در این مقاله برای ارزیابی SLDEEP بر روی بیش از 100 هزار خط از کد C یا ++C ارزیابی هایی با استفاده از code4bench انجام میدهند.
ویژگی code4bench: جداولی را فراهم می کند، که در آن نسخه های صحیح و خطادار برنامه را مشخص میکند و همچنین خطوط خطادار برنامه را نیز مشخص میکند. سپس هر عبارت را توکن توکن میکند و برای داده های خطادار از اطلاعات مربوطه در code4bench استفاده میکند. در ادامه برای هر برنامه یک ماتریس درست میکند، که هر سطر آن به statement ای اختصاص داده شده است. و از هر ستون آن برای معیار های مربوط داده، از جمله برچسب های شامل مکان مستعد خطا یا مکان فاقد خطا استفاده میشود. در نهایت یک مدل LSTM با استفاده از ماتریس، برای همه برنامه ها انجام میدهد.
این مقاله برای اینکه بتواند یک سیستم SDP موثر تولید کند، کار در سطح statement را پیشنهاد میدهد. برای این منظور باید یک سری معیار مربوط به کد را برای تخمین مکان های خطای هر statement تعریف کند. داده هایی که این مقاله تولید میکند، از نظر ماهیت و اندازه با داده های معمولی تولید شده متفاوت است. به همین منظور یک الگوی یادگیری مناسب با داده ها را استفاده می کند که این مقاله LSTM را پیشنهاد داده است. این تکنیک جدید را SLdeep نامیدند، که با ادغام کردن معیارهای سطح statement با مدل یادگیری، توسعه داده شده است.
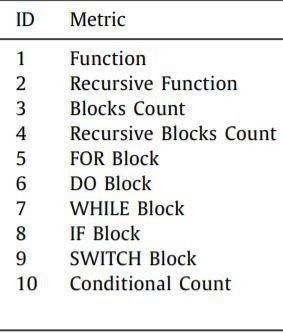
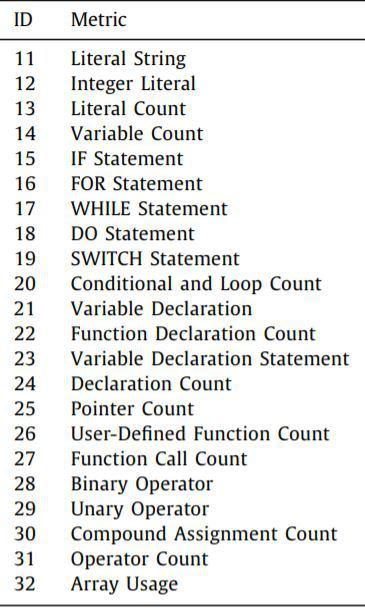
معیارها در SDP به عنوان متغیرهای مستقل در نظر گرفته میشوند. در این مقاله 32 معیار در نظر گرفته میشود که شامل 10 معیار خطی خارجی و22 معیار خطی داخلی میشوند. تعریف هر کدام به صورت جداگانه این گونه است که معیارهای خطی خارجی ویژگی های بیرونی را در خود نگهداری میکنند که ممکن است بر روی پیچیدگی یک statement تاثیر بگذارند و معیارهای خطی داخلی، پیچیدگی یک statement را بر اساس خصوصیات موجود در آن statement تخمین میزنند.
دلیل استفاده از یادگیری ماشین در این مدل این است که، یادگیری ماشین، حساس به داده های نادرست و خطادار است. در روش پیشنهادی این مقاله از تکنیک یادگیری ماشین به نام LSTM استفاده کردند که از زیر شاخه های یادگیری عمیق است.
این مدل یادگیری در سال ۱۹۹۷ اختراع شد تا به برخی از مسائل ریاضی که هنگام مدل سازی دنباله های طولانی معرفی شدهاند بپردازد. امروزه از آن برای مدل سازی روابط بین دنباله ها استفاده میشود.
مقاله به توصیف و توجیه کاربرد LSTM در SLDeep میپردازد. برای مسائل SDP ما نیاز به یک معیار طبقه بندی کننده داریم که قادر باشد هر statement ای(چه خطا دار و چه بدون خطا) را طبقهبندی کند. در نهایت ما نیاز به مدلی داریم که ساختار کد را بهعنوان دنبالهای از statement ها در نظر بگیرد.
در این قسمت مجموعه معیارهای معرفی شده را با LSTM ادغام میکنیم تا سیستم SDP پیشنهادی خود را توسعه دهیم. برای ساختن یک مدل LSTM باید یک ماتریس Mp برای هر برنامه p ساخته شود که i امین خط از ماتریس M به i امین خط از استیتمنت p اختصاص دارد. ستون های ماتریس M به دو دسته گسترده تقسیم میشوند. دسته اول به ۳۲ معیار معرفی شده اختصاص دارد، و برای هر برنامه ثابت است. دسته دوم ستونها به توکن های موجود در هر خط اختصاص دارند. این دسته اهمیت بالایی دارند، زیرا به عنوان ابزاری برای ضبط ساختار کد به ما کمک میکند. که هر توکن زوج مرتب (t,v) ذخیره میکند، کهt نشان دهنده نوع توکن و v نشان دهنده مقدار توکن است.
برای استفاده از SLDeep، نیاز به محاسبه معیارها ، استخراج توکن ها و ساخت یک ماتریس برای برنامه داریم. سپس یک مدل LSTM، ساخته میشود و برای اینکه پیشبینی کند، statement جدید است، بدون عیب است و یا مستعد خطا است، استفاده میشود.
این مقاله تمرین درس "آزمون، اشکال زدایی و ترمیم نرم افزار پیشرفته" دانشگاه شهید بهشتی است و جهت انتشار محتوای فارسی بیشتر میباشد.

