
فرض کنید کارمندی از دستیار هوشمند سازمان میپرسد: «شرایط ارتقای شغلی من چیست؟»
دستیار در چند ثانیه پاسخی مرتب و مستند ارائه میکند. شماره بخشنامه را هم میآورد. اما یک مشکل وجود دارد: بخشنامه مورد استناد، سال گذشته اصلاح شده و نسخه جدید در مجموعه اسناد دستیار قرار نگرفته است.
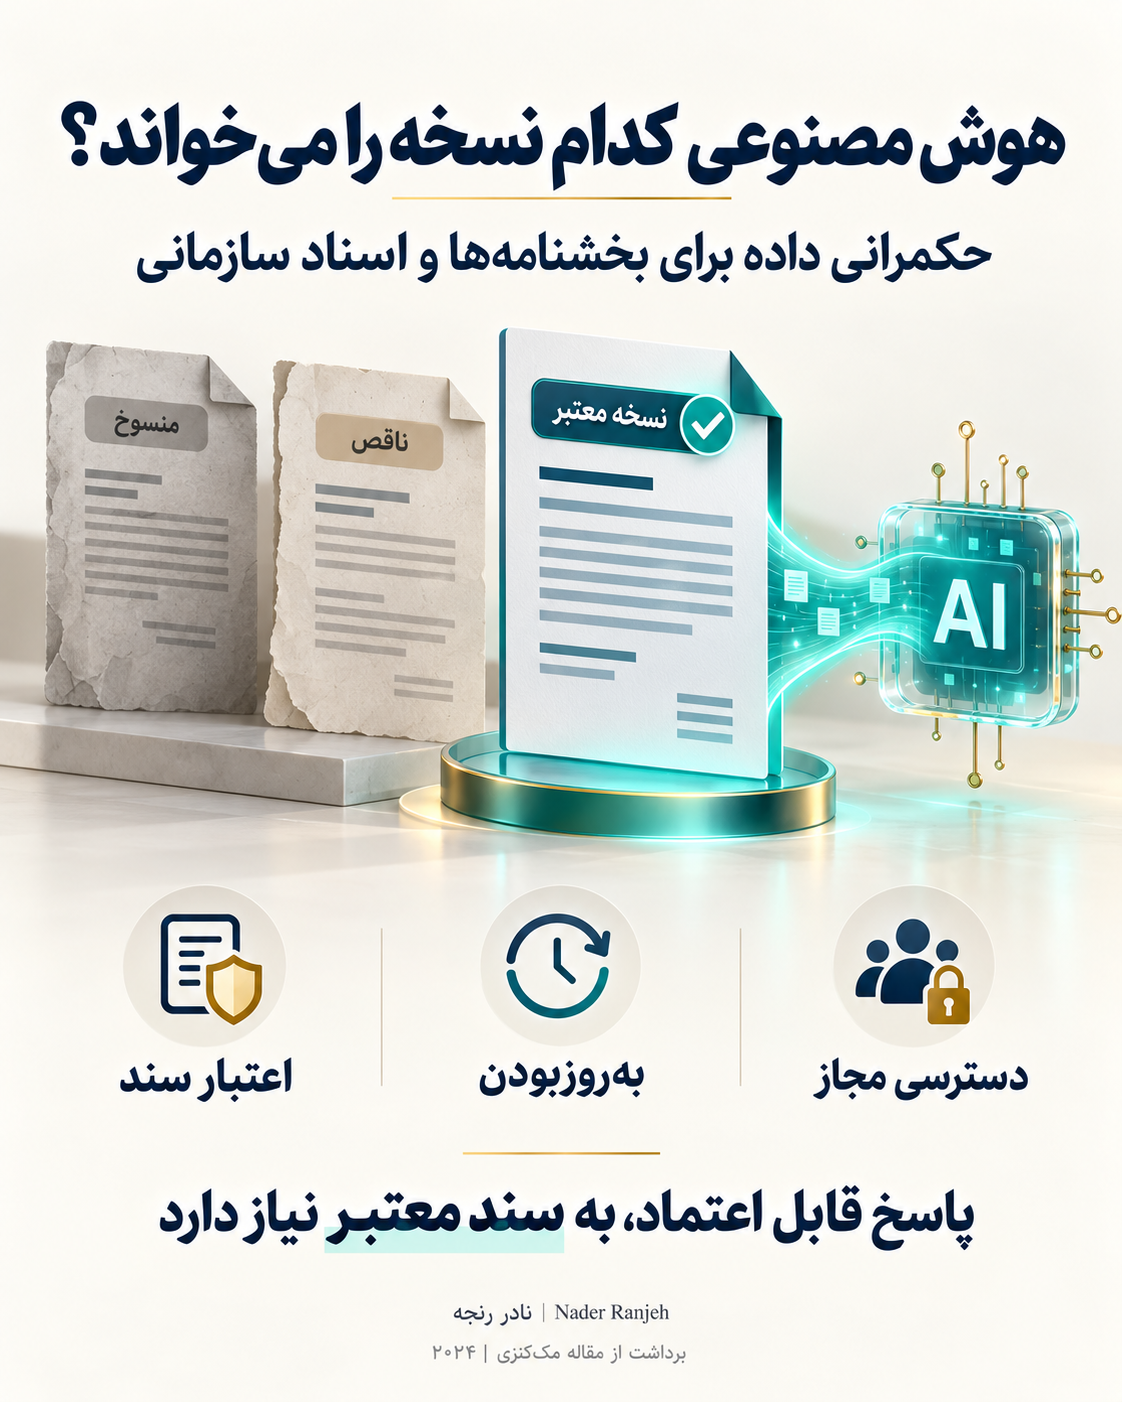
این مثال فرضی نشان میدهد درستی پاسخ هوش مصنوعی، به اعتبار اسنادی که در اختیار آن قرار میدهیم نیز وابسته است. پاسخی که با اطمینان نوشته شده، ممکن است بر سندی منسوخ، ناقص یا نامرتبط تکیه داشته باشد.
با گسترش استفاده از هوش مصنوعی در سازمانها، چنین مسئلهای اهمیت بیشتری پیدا میکند؛ بهویژه در دستگاههای دولتی که تصمیمها و پاسخهای اداری میتوانند بر حقوق کارکنان و مردم اثر بگذارند.
وقتی از حکمرانی داده صحبت میکنیم، معمولاً به یاد پایگاههای اطلاعاتی، جدولها، کدهای شناسایی و سامانههای ثبت اطلاعات میافتیم. اما بخش مهمی از دانش و مبنای تصمیمگیری سازمان در قالب دیگری نگهداری میشود:
بخشنامهها، دستورالعملها، صورتجلسات، قراردادها، گزارشها، مکاتبات و پروندهها.
این اسناد نیز داده دارند؛ گاهی دادهای که تفسیر یک عدد یا تصمیم درباره یک پرونده به آن وابسته است. برای مثال، دانستن تعداد کارکنان مشمول یک مزایا کافی نیست؛ باید مشخص باشد «مشمولبودن» بر اساس کدام مقرره و با چه استثناهایی تعیین شده است.
مککنزی در مقاله «ترسیم مسیر سازمان دادهمبنا و هوش مصنوعیمحور تا سال ۲۰۳۰» به گسترش فرصت استفاده از دادههای بدون ساختار، مانند متن، تصویر و مکاتبات، در عصر هوش مصنوعی مولد اشاره میکند. نویسندگان در عین حال تأکید دارند که آمادهسازی، مدیریت، حفاظت و استفاده ارزشآفرین از این دادهها، به سرمایهگذاری و قابلیتهای تازه نیاز دارد.
برای سازمانهای اداری، یکی از مصداقهای روشن این بحث، مدیریت اعتبار و وضعیت اسناد است.
ممکن است تصور کنیم برای ساخت دستیار هوشمند مقررات، کافی است فایلهای سازمان را جمعآوری و در اختیار یک ابزار قرار دهیم. اما یک پوشه بزرگ از اسناد، لزوماً مجموعهای قابل اعتماد برای پاسخگویی نیست.
پیش از استفاده، باید بتوانیم به پرسشهایی مانند اینها پاسخ دهیم:
کدام نسخه از سند معتبر است؟
آیا سند اصلاح، لغو یا با مقرره دیگری جایگزین شده است؟
از چه تاریخی اجرا میشود؟
برای چه اشخاص، دستگاهها یا موقعیتهایی کاربرد دارد؟
کدام پیوستها، استثناها و ارجاعات باید همراه آن خوانده شوند؟
چه کسی مسئول تأیید و بهروزرسانی آن است؟
چه کسانی اجازه دارند به آن دسترسی داشته باشند؟
اگر این اطلاعات روشن نباشد، ابزار ممکن است متن را درست بخواند، اما آن را در جای نادرست به کار ببرد.
برای مثال، یک دستورالعمل میتواند معتبر باشد، اما فقط درباره گروه مشخصی از کارکنان اجرا شود. یا نسخهای قدیمی برای بررسی یک پرونده مربوط به سالهای گذشته لازم باشد، در حالی که برای پاسخ به وضعیت امروز کاربرد ندارد.
بنابراین، همیشه جدیدترین سند، پاسخ همه پرسشها نیست؛ سند باید با زمان و موضوع پرسش تناسب داشته باشد.
از نگاه من، حکمرانی داده برای اسناد یعنی سازمان درباره اعتبار، مسئولیت، دسترسی و نحوه استفاده از آنها تصمیمهای روشن و قابل اجرا داشته باشد.
این موضوع با آرشیو و مدیریت اسناد ارتباط نزدیک دارد، اما به محل نگهداری فایل محدود نمیشود. باید معلوم باشد چه کسی درباره وضعیت سند تصمیم میگیرد و این تصمیم چگونه به سامانهها و کاربران منتقل میشود.
برای روشنشدن موضوع، چند نمونه را ببینیم:
موضوعپرسش اجراییمنبع معتبرنسخه رسمی سند را از کجا دریافت میکنیم؟وضعیت اعتبارچه کسی تأیید میکند سند جاری، اصلاحشده یا لغوشده است؟ارتباط اسناداصلاحیه، پیوست و مقرره جایگزین چگونه به سند اصلی متصل میشوند؟بهروزرسانیپس از ابلاغ مقرره جدید، چه کسی مجموعه اطلاعات دستیار را اصلاح میکند؟دسترسیکدام سند عمومی است و کدام فقط برای کاربران مجاز قابل استفاده است؟ردیابی پاسخآیا میتوان فهمید پاسخ بر اساس کدام سند و نسخه تهیه شده است؟
حل این مسائل به همکاری واحد تخصصی، حقوقی، مدیریت اسناد، حکمرانی داده و فناوری اطلاعات نیاز دارد. واحد فناوری میتواند سازوکار را پیاده کند، اما تأیید اعتبار حقوقی یا دامنه اجرای یک بخشنامه به مسئولیت و صلاحیت تخصصی نیاز دارد.
لازم نیست سازمان از ابتدا تمام اسناد خود را برای استفاده در هوش مصنوعی آماده کند. میتوان یک حوزه محدود، مانند پاسخگویی به پرسشهای آموزشی یا بررسی یک گروه مشخص از مقررات اداری، انتخاب کرد و کار را مرحلهای پیش برد.
دستیار قرار است به چه پرسشهایی پاسخ دهد و درباره چه موضوعاتی نباید پاسخ قطعی بدهد؟ دامنه محدود، بررسی کیفیت و شناسایی خطا را آسانتر میکند.
اسناد از منابع رسمی دریافت شوند و برای هر سند، اطلاعاتی مانند عنوان، مرجع صادرکننده، شماره، تاریخ، دامنه کاربرد، وضعیت اعتبار و سطح دسترسی ثبت شود. ارتباط آن با اصلاحیهها و پیوستها نیز مشخص باشد.
اگر بخشنامهای تغییر کرد، باید معلوم باشد چه کسی تغییر را شناسایی، تأیید و در مجموعه اطلاعات اعمال میکند. بهروزرسانی نباید به پیگیری اتفاقی یک کارمند وابسته بماند.
آزمون فقط شامل پرسشهای ساده نباشد. موارد دارای استثنا، اسناد اصلاحشده، پرسشهای مبهم و موقعیتهایی که پاسخ کافی وجود ندارد نیز بررسی شوند.
دستیار باید بتواند در نبود اطلاعات معتبر، محدودیت پاسخ را اعلام کند یا موضوع را به کارشناس ارجاع دهد.
نمایش شماره سند، بهتنهایی درستی پاسخ را تضمین نمیکند. باید بررسی شود آیا سند واقعاً از نتیجه پشتیبانی میکند و آیا همه شرایط مرتبط در نظر گرفته شدهاند. پاسخهای مؤثر بر حقوق اشخاص نیز به کنترل متناسب با حساسیت موضوع نیاز دارند.
حتی اگر مجموعه اسناد دقیق و بهروز باشد، احتمال خطای مدل از بین نمیرود. ابزار ممکن است بخشی از متن را نادیده بگیرد، میان اسناد ارتباط نادرست برقرار کند یا نتیجهای فراتر از مستندات ارائه دهد.
به همین دلیل، آمادهسازی اسناد باید با ارزیابی ابزار، آزمون پاسخها و تعیین مسئولیت انسانی همراه شود.
برای دستگاههای اجرایی، پرسش مهم پیش از راهاندازی دستیار هوشمند این است:
آیا میدانیم کدام سند، برای چه موضوع و چه زمانی معتبر است و چه کسی مسئول نگهداری این اعتبار است؟
پاسخ به این پرسش، بخشی از زیرساخت اعتماد به هوش مصنوعی در سازمان است.
Tavakoli, A., Harreis, H., Rowshankish, K., & Bogobowicz, M. (2024). Charting a path to the data- and AI-driven enterprise of 2030. McKinsey & Company، سپتامبر ۲۰۲۴، بهویژه صفحات ۵ و ۶.
بحث دادههای بدون ساختار برگرفته از مقاله مککنزی است؛ مثال اداری و پیشنهادهای اجرایی این نوشته، تحلیل و برداشت نویسنده برای سازمانهای ایرانی است.

