
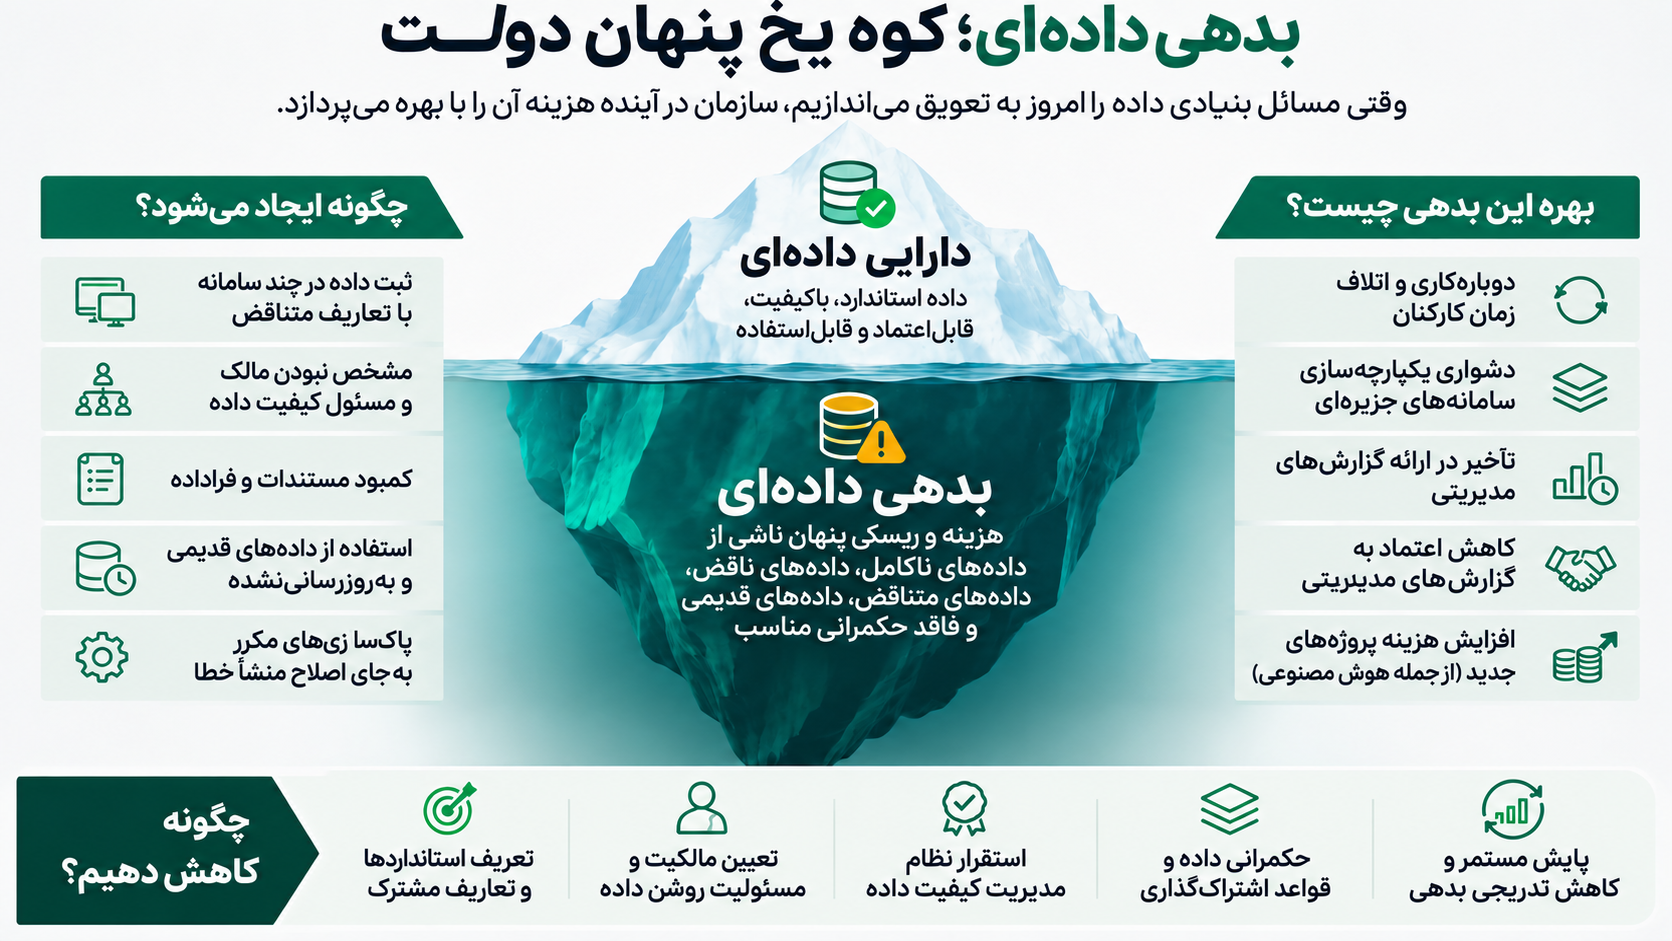
همه بدهیهای یک سازمان در صورتهای مالی ثبت نمیشوند.
گاهی سازمان سالها داده جمعآوری میکند، سامانههای جدید میسازد و پایگاههای اطلاعاتی متعددی ایجاد میکند، اما بخشی از این دادهها ناقص، تکراری، قدیمی، متناقض یا فاقد تعریف و متولی مشخص هستند.
در ظاهر، سازمان صاحب میلیونها رکورد، دهها سامانه و انبوهی از گزارشهاست؛ اما در عمل، کارشناسان برای تهیه یک گزارش ساده باید ساعتها وقت صرف تطبیق آمار، رفع مغایرتها و پیدا کردن «عدد درست» کنند.
این همان نقطهای است که میتوان از مفهوم «بدهی دادهای» (Data Debt) سخن گفت؛ بدهیای که شاید امروز دیده نشود، اما سازمان ناچار است هزینه آن را در آینده بپردازد.
مفهوم بدهی دادهای هنوز مانند «بدهی فنی» تعریف واحد و کاملاً تثبیتشدهای ندارد، اما ادبیات جدید آن را به مجموعهای از مشکلات مرتبط با کیفیت، ساختار، دسترسی، مستندسازی و حکمرانی داده مرتبط میداند.
اگر بخواهیم آن را به زبان مدیریتی توضیح دهیم، میتوان گفت:
بدهی دادهای زمانی ایجاد میشود که حل مسائل اساسی داده را امروز به تعویق میاندازیم و هزینه آن را در آینده، با بهره، پرداخت میکنیم.
برای مثال، وقتی:
دادههای یک موضوع در چند سامانه با تعاریف متفاوت ثبت میشوند؛
مالک یا متولی داده مشخص نیست؛
قواعد کنترل کیفیت در نقطه ورود داده وجود ندارد؛
مستندات و فراداده کافی در دسترس نیست؛
اطلاعات قدیمی همچنان مبنای گزارشگیری قرار میگیرد؛
یا به جای اصلاح منشأ خطا، هر بار دادهها بهصورت دستی پاکسازی میشوند؛
در ظاهر ممکن است کار سازمان متوقف نشود، اما بدهی دادهای در حال انباشتهشدن است.
وجه مهم این مفهوم در همان تشبیه با بدهی مالی نهفته است.
وقتی یک سازمان حل مشکلات داده را به آینده موکول میکند، فقط با همان مشکل اولیه روبهرو نخواهد شد؛ بلکه هزینههای جدیدی نیز به آن اضافه میشود.
بهره بدهی دادهای را میتوان در موارد مختلف مشاهده کرد: دوبارهکاری کارکنان، اصلاح مکرر گزارشها، دشواری اتصال سامانهها، طولانی شدن اجرای پروژههای جدید، افزایش هزینه یکپارچهسازی، کاهش اعتماد مدیران به داشبوردها و افزایش ریسک تصمیمگیری.
ممکن است یک مغایرت کوچک در ابتدای زنجیره داده چندان مهم به نظر نرسد، اما همان مغایرت اگر به سامانههای دیگر، گزارشهای مدیریتی و در نهایت تصمیمهای اجرایی منتقل شود، میتواند هزینهای بسیار بیشتر ایجاد کند.
در این شرایط، مسئله فقط «کیفیت چند رکورد» نیست؛ سازمان در حال پرداخت هزینه انباشتهشده تصمیمهای گذشته درباره داده است.
یکی از نشانههای مهم بدهی دادهای، شکاف میان حجم داده موجود و اعتماد به داده است.
ممکن است یک دستگاه اجرایی حجم عظیمی از داده داشته باشد، اما هنگام تصمیمگیری این پرسش همچنان مطرح باشد:
«کدام عدد درست است؟»
اگر دو سامانه درباره یک شاخص، دو عدد متفاوت ارائه کنند، یا هر واحد سازمانی تعریف خاص خود را از یک مفهوم داشته باشد، افزایش حجم داده الزاماً تصمیمگیری را بهتر نمیکند.
در چنین شرایطی، سازمان نه با کمبود داده، بلکه با کمبود داده قابلاتکا روبهرو است.
به همین دلیل، داده زمانی میتواند یک دارایی راهبردی محسوب شود که استاندارد، بهروز، قابلردیابی، امن و دارای مسئول مشخص باشد. در غیر این صورت، همان دادهای که قرار بود ارزش ایجاد کند، میتواند به بدهی سازمانی تبدیل شود.
یکی از خطاهای رایج این است که مشکلات داده صرفاً به واحد فناوری اطلاعات نسبت داده شوند.
در حالی که ریشه بدهی دادهای میتواند بسیار گستردهتر باشد: نبود استانداردهای مشترک، ضعف تعامل میان واحدهای تخصصی و فناوری، نامشخص بودن مالک داده، فقدان قواعد اعتبارسنجی، نبود کاتالوگ داده، سامانههای قدیمی، ضعف مستندسازی یا حتی نبود سازوکار پاسخگویی.
بنابراین، پاکسازی مقطعی دادهها بهتنهایی راهحل پایدار نیست.
ممکن است امروز یک پایگاه اطلاعاتی پاکسازی شود، اما اگر فرآیند تولید داده اصلاح نشده باشد، همان خطا چند ماه بعد دوباره بازخواهد گشت.
برای کاهش بدهی دادهای، باید از اصلاح موردی داده به سمت حکمرانی داده حرکت کرد؛ یعنی مسئولیتها، استانداردها، قواعد کیفیت، مالکیت، امنیت، دسترسی و سازوکار پاسخگویی بهصورت روشن تعریف شوند.
اهمیت این موضوع با گسترش هوش مصنوعی بیشتر شده است.
سازمانهایی که امروز به دنبال استفاده از هوش مصنوعی هستند، ممکن است تصور کنند مسئله اصلی انتخاب مدل، خرید ابزار یا طراحی الگوریتم است؛ در حالی که بسیاری از پروژههای هوش مصنوعی پیش از هر چیز به کیفیت داده وابستهاند.
مطالعات حوزه هوش مصنوعی نشان دادهاند که مشکلات داده میتوانند بهصورت زنجیرهای به مراحل بعدی منتقل شوند.
Sambasivan و همکاران این پدیده را «آبشارهای دادهای» (Data Cascades) نامیدهاند؛ مشکلاتی که در مراحل اولیه داده شکل میگیرند، اما اثر آنها در مراحل بعدی و گاهی با تأخیر آشکار میشود.
به بیان ساده، هوش مصنوعی بدهی دادهای را حذف نمیکند؛ ممکن است آن را آشکارتر و حتی پرهزینهتر کند.
اگر دادههای آموزشی یا عملیاتی ناقص، قدیمی یا سوگیرانه باشند، سامانه هوشمند نیز ممکن است همان ضعفها را در مقیاسی بزرگتر بازتولید کند.
بنابراین، آمادگی برای هوش مصنوعی از «خرید فناوری» آغاز نمیشود؛ از آمادگی داده آغاز میشود.
شاید یکی از مهمترین تغییرات نگرش در مدیریت داده این باشد که از پرسش «چه میزان داده داریم؟» به پرسشهای دقیقتری برسیم:
آیا میدانیم مهمترین دادههای سازمان کداماند؟
آیا برای آنها مالک و مسئول مشخص داریم؟
آیا کیفیت آنها بهصورت مستمر سنجیده میشود؟
آیا دادهها در سامانههای مختلف تعریف یکسانی دارند؟
آیا میتوان منشأ یک عدد را تا نقطه تولید آن ردیابی کرد؟
و مهمتر از همه:
چه میزان بدهی دادهای در سازمان انباشته کردهایم و برنامه ما برای بازپرداخت آن چیست؟
داده لزوماً با انباشتهشدن به دارایی تبدیل نمیشود.
اگر کیفیت، استاندارد، مسئولیتپذیری و قابلیت ردیابی آن مدیریت نشود، همان دادهای که قرار بود ظرفیت تصمیمگیری سازمان را افزایش دهد، میتواند به منبعی از دوبارهکاری، هزینه، ابهام و ریسک تبدیل شود.
از این منظر، بدهی دادهای فقط یک اصطلاح فنی نیست؛ مفهومی مدیریتی برای فهم هزینه تصمیمهایی است که امروز درباره داده میگیریم و آثار آن را در آینده پرداخت خواهیم کرد.
برای سازمانهای دولتی این موضوع اهمیت بیشتری دارد؛ زیرا هزینه داده بیکیفیت فقط در بودجه یا بهرهوری سازمان منعکس نمیشود، بلکه ممکن است در کیفیت سیاستگذاری، تخصیص منابع و حتی حقوق شهروندان ظاهر شود.
شاید زمان آن رسیده باشد که در کنار داراییهای دادهای، درباره بدهیهای دادهای سازمان نیز گزارش مدیریتی داشته باشیم.
Foidl, H., Felderer, M., & Biffl, S. (2019). Technical Debt in Data-Intensive Software Systems. Euromicro Conference on Software Engineering and Advanced Applications (SEAA).
Sculley, D., et al. (2015). Hidden Technical Debt in Machine Learning Systems. Advances in Neural Information Processing Systems (NeurIPS).
Sambasivan, N., et al. (2021). “Everyone wants to do the model work, not the data work”: Data Cascades in High-Stakes AI. Proceedings of CHI 2021.
Mäki, N., Penttinen, E., & Rinta-Kahila, T. (2023). A Domino Effect: Interdependencies among Different Types of Technical Debt. Proceedings of the Hawaii International Conference on System Sciences (HICSS).
Hahn, N., & Sales, A. (2026). A Multivocal Literature Review on Data Smells and Data Debt Nuances. ICEIS 2026.
Moreschini, S., et al. (2026). The Evolution of Technical Debt from DevOps to Generative AI: A Multivocal Literature Review. Journal of Systems and Software, 231, 112599.

