
من کیمیام. داستان من در دنیای داده آن جایی شروع شد که با آموختن مقدار قابل قبولی برنامهنویسی و ریاضی در دانشگاه، چند روز قبل از این که از پروژه کارشناسیم دفاع کنم با یک شرکت سرمایهگذاری برای کارآموزی دیتا ساینس مصاحبه کردم و پذیرفته شدم و پس از گذراندن یک دورهی آزمایشی همانجا مشغول به کار شدم. بعد از دو سال هم به یکتانت پیوستم و عنوان شغلیم از دیتا ساینتیست تکامل پیدا کرد به دیتا ساینتیست - آنالیتیکس.
این مطلب تلاشی برای پاسخ دادن به پرتکرارترین پرسشهایی است که از وقتی به عنوان یک کارشناس علم داده مشغول به کار شدهام افراد مختلف از من میپرسند. از آنجایی که شغل من جواب دادن به سوالات است، این سوالات و جوابی که برایشان نداشتم همیشه اذیتم میکرد.
مطلب کلا ۴ بخش دارد که هر کدام پاسخ به یک سوال پرتکرار است.
در توییتر زیاد به این اعتراض برخوردهام که چرا دیتاساینتیستها به خودشان میگویند ساینتیست در حالی که لایق لفظ دانشمند نیستند.
در مورد این که اصلاً علم داده چیست و به چه کسی دیتا ساینتیست میگویند و ریشهی این کلمه از کجاست من مطلب درخوری ندارم که بگویم ولی به نظرم این گفتوگو را حتما گوش کنید. گفتوگوی جذابی است چون چند تا از افرادی که خیلی در این حوزه قبولشان دارم در آن حضور دارند. از تعریف علم داده شروع میکنند و با ذکر مثال فضای کاریش در ایران را ترسیم میکنند.
اما در جواب این اعتراض میتوانم این را بگویم که در سه سالی که در این حوزه در دو شرکت متفاوت با کلی آدم مختلف کار کردهام، حتی یک نفر را هم ندیدم که خودش را حضوراً «دانشمند» داده معرفی کند. این کلمه صرفا یک کلیدواژه برای پیدا کردن کورسهای آنلاین و موقعیتهای شغلی این حوزه است و در بلاگپستهایی مثل اینی که دارید میخوانید به کار میرود و به جز آن کاربرد دیگری ندارد.
من و همکارانم، توی فضای تکنولوژی بچههای دیتا هستیم و در جامعه هم اگر شانس بیاوریم برنامهنویس وگرنه هم که مهندس نرمافزار.
از وقتی که -Analytics را بعد از عنوان Data Scientist به لینکدینم اضافه کردم سوالی که زیاد میشنوم این است که آیا اگر تجربهات بیشتر شود یا چندتایی کورس خوب بگذرانی میتوانی دیتا ساینتیست واقعی شوی. این سوال مثل این است که به یک پزشک متخصص اطفال بگویید بیشتر درس بخوان تا بتوانی بزرگسالان را هم درمان کنی.
ML Engineering یا AI Engineering گرایشی از علم داده است که بر توسعهی مدلها تمرکز میکند در حالی که تمرکز Data Analytics بر استخراج الگوها و روندهای معنادار از داده است. هر بیزینسی در هر زمان ممکن است به هر دوی این تخصصها یا افرادی با تسلط نسبی به هر دو شاخه نیاز داشته باشد. بازار کار هر دو در جهان خوب است و سختی کار هیچ یک از آن یکی کمتر نیست.
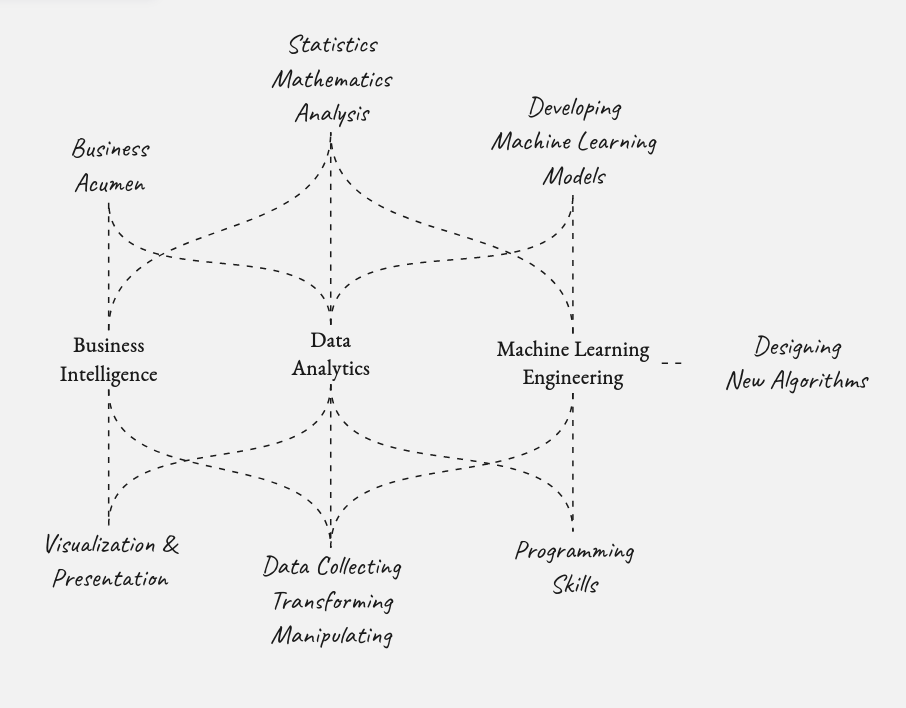
البته لازم به ذکر است که در حال حاضر مرزبندی شاخههای مختلف علم داده مشخص نیست و شغلهای با عنوان یکسان در دو شرکت مختلف، شرح وظایف متفاوتی دارند. افراد زیادی سعی کردهاند این مرزبندی را یک بار برای همیشه انجام دهند. یک نمونهی خوبش این پست است. من هم اینجا سعی کردم شغلهای حوزهی دیتا را با توجه به مهارتهایشان (با حذف Data Engineering چون فضایش متفاوت است و من تسلطی بهش ندارم) در خلاصهترین حالت نمایش دهم. تفسیرش به این شکل است که هر قدر فاصلهی شغلی از یکی از مهارتها کمتر باشد، یعنی آن شغل به آن مهارت بیشتر نیاز دارد.
طبق تجاربم، انتخاب بین مهندسی یادگیری ماشین و تحلیل داده صرفا یک انتخاب بر اساس علایق، شخصیت و پیشزمینهی تحصیلی و شغلی فرد است و فضای رشد در هر دو گرایش به اندازهی کافی وجود دارد. ولی دربارهی گرایش خودم دوست دارم بگویم یکی از چیزهایی که analytics را برای من جذاب میکند شباهت کارم به science of deduction است. همان کاری که شرلوک هلمز میگفت میکند.
راستش هر شرکتی با توجه به کسب و کارش و نیازی که در لحظه دارد یک مجموعه تواناییهای خاص از متخصص علم دادهاش میخواهد. برای مثال ممکن است شما در Time Series Forecasting خبره باشید و هزاران فرصت شغلی پیش رویتان باشد اما شرکتی که دوستش دارید دنبال سه نفر متخصص در Image Processing باشد و رزومهی شما را رد کند. از طرفی هر روز یک مطلب جدید با عنوان «چگونه دیتا ساینتیست حرفهای را از آماتور تشخیص دهیم؟» در مدیوم یا امثالش گذاشته میشود. نشان از این که هیچ جوره نمیتوان به این سوال یک جواب ثابت داد. اما اگر از من بپرسید به نظرم چهار تا چیز ضروری است:
مورد دوم هم تواناییهای تکنیکال میخواهد و هم مهارتهای نرم. برای یاد گرفتن هر کدامش منابعی میشود یافت. برای مورد سوم و چهارم هم منبع یادگیری زیاد است. اما منبع جامعی برای یادگیری مورد اول در دسترس نیست. چون راه تمرینش حل مثالهای متعدد است و شرکتها مسائل بیزینسی خود را تا وقتی کاملا از دهن نیفتاده، منتشر نمیکنند. شاید هم هرگز منتشر نکنند. پس چه کنیم؟ یک راهش شرکت در مسابقاتی مثل مسابقات کگل و کوئرا است. راه دیگرش هم این است که این مدل تفکر را روی هر چیزی در زندگی امتحان کنیم. اینجا یک مثال میزنم و سعی میکنم نکات مهمی را که باید در این روش تفکر در نظر بگیریم در آن بگنجانم.
این مدل حل مسئله دو مرحلهی اصلی دارد:
یک: تجزیهی مسئله به مسائل کوچکتر.
دو: پیدا کردن دادهای که به مسئلهی کوچک جواب بدهد.
سوال: بهترین جاده برای سفر شمال کجاست؟
در این مرحله باید به یک نکتهی بسیار مهم توجه کنیم: به دست آوردن دادهی مورد نیاز برای هر یک از عوامل هزینهای دارد. پس باید هزینه-فایده کنیم و فقط تا حدی پیش برویم که هزینهی جواب دادن به سوال از مطلوبیتی که برای ما ایجاد میکند بالاتر نرود. یعنی اگر قرار است مسیر سفر روز بعدمان را انتخاب کنیم قطعا نمیخواهیم زمان زیادی روی پیدا کردن پاسخ صرف کنیم. (کما این که زمان زیادی هم نداریم.) اما اگر میخواهیم یک بلاگپست با موضوع بهترین جاده برای سفر شمال بنویسیم ممکن یک ماه وقت بگذاریم و همهی عوامل اثرگذار را به دقت بررسی کنیم.
خلاصهی این مثال را میتوانید در نقشهی زیر ببینید:
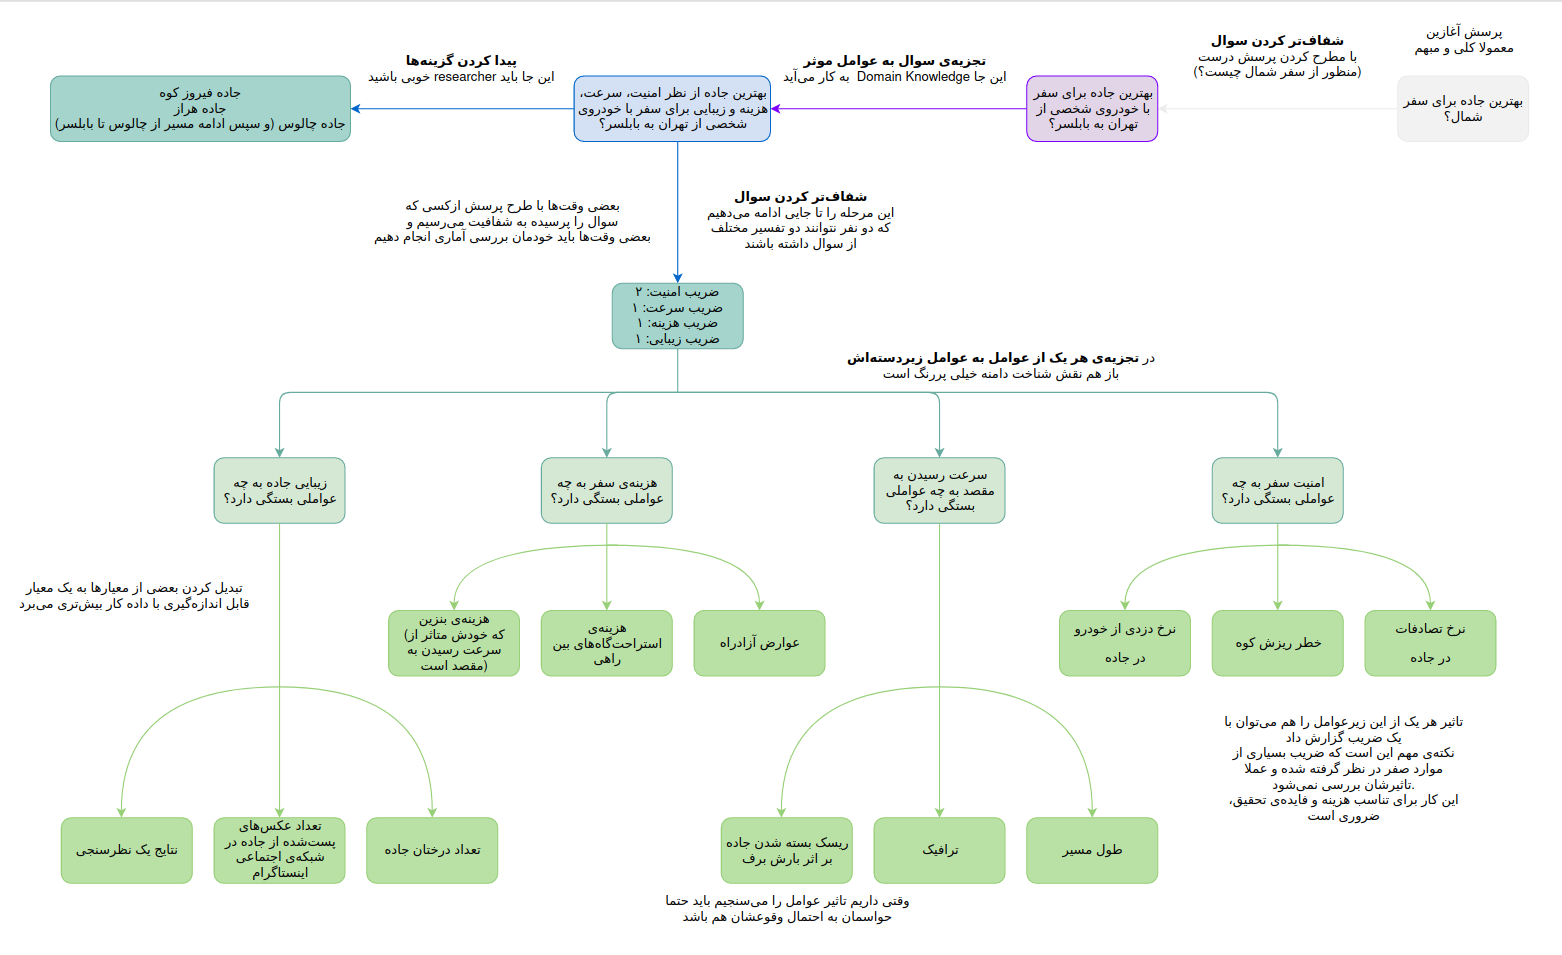
یادآوریای که خوب است این جا بکنم این است که در دنیای کار، سوالهایی که از تحلیلگر داده میپرسند ممکن است از مرحلهی تبدیل به پاسخ دادهای خیلی دور باشند. یعنی اگر مدیر پروژه از من بپرسد علت افت درآمد کمپینهای محتوا محور چیست، تبدیل سوالش به داده خیلی سریعتر است تا وقتی که از من بپرسد چهجوری درآمد تیم ریتارگتینگ را افزایش دهیم.
معالاسف این سوال را هم من نمیتوانم جواب بدهم. فهمیدن این که فضای دیتا چهقدر به شخصیت شما میخورد که هیچجوره کار من نیست. اگر هم از من راجع به این میپرسید که این حوزه چهقدر خواهان دارد، باز هم اشتباه میکنید. چون من بین تمام گزینههایی که بتوانند به این سوال جواب بدهند نفر آخر لیستم. چون نه دنبال پیدا کردن کار هستم و نه دنبال استخدام. (سوال را از کسی بپرس که دیتا دستش است.) البته یک سال پیش در یک مصاحبهی ویدیویی با شرکت لیان این طور گفتم که سرمایهگذاریای که دارد در این حوزه میشود نشاندهندهی این است که همه بهش باور دارند و از طرفی در ایران این حوزه نسبتا تازه شروع شده و خیلی جای پیشرفت دارد. اما یک سال در حوزهی کسب و کار آن هم در ایران که همه چیز متلاطم است، زمان طولانیای است و در حال حاضر من دیدی نسبت به وضعیت رشد علم داده در ایران ندارم. اما میتوانم این پرسش را به یک مسئلهی دادهای تبدیل کنم. مثل کاری که در سوال قبل کردیم.
فرض کنید ما به تمام دادهی سایتهای جابویژن، جابینجا، کوئرا و ایرانتلنت دسترسی داریم. این طوری میشود سوالاتی مطرح کرد که به تصمیمگیری ما کمک کند:
در اولین قدم باید پاسخ محدود شود به خواستهی پرسشگر. با این فرض که پرسشگر فقط دربارهی فرصت شغلی در ایران پرسیده (و کاری به بازار کار کشورهای دیگر و موقعیت مهاجرت ندارد) شروع میکنیم. آیا فقط دنبال علم داده و یادگیری ماشین است یا هوش تجاری هم دوست دارد؟ Data Engineering چهطور؟ اگر علم داده مد نظر است، کدام گرایش را میخواهد؟ فرض کنیم انتخاب فرد هر آگهیای است که عنوان شغلی با data scientist آغاز شود.
این طور گزارش میکنیم: به طور میانگین، روی هم رفته در ماه n موقعیت شغلی دیتا ساینتیست در این ۴ وبسایت از سمت کارفرماها قرار میگیرد.
البته هر کارفرمایی احتمالا در بیش از یکی از این وبسایتها آگهی میگذارد پس باید یک عدد mی هم موجود باشد که تعداد را بر آن تقسیم کنیم و موقعیتهای شغلی متمایز به دست بیاید. توجه به این نکته در کار دیتا خیلی مهم است. اعدادی که گزارش میشوند نباید گمراهکننده باشند.
نکتهی مهم در نحوهی گزارش این بخش این است که با توجه به عددی که به دست میآید بهتر است بازهزمانی را تغییر دهیم تا جواب به مدلی که مغز انسان میتواند آن را راحت پردازش کند نزدیک باشد. مثلا ۳۰ موقعیت شغلی در ماه میتواند گزارش شود هر روز یک موقعیت شغلی جدید. از طرفی ۱۰۰۰ موقعیت شغلی در ماه بهتر است گزارش شود در هر ساعت یک موقعیت شغلی جدید. (این بخش نیاز به شناخت حوزه دارد و بهترین مدل گزارش هرگز با یک فرمول ثابت به دست نمیآید.)
یک نکتهی حیاتی نیز اینجا این است که برای هر سطحی باید تعداد موقعیت شغلی جداگانه گزارش شود. اگر ۸۰۰ موقعیت شغلی برای دیتا ساینتیست کارکشته (همان سینیور) موجود باشد ولی مجموعا ۱۰ شرکت دنبال یک تازهوارد بگردند، برای تازهواردها آنچنان خبر خوبی نیست. (برای شرکتها هم همینطور)
فرض کنیم ما تقاضای این حوزه را به دست آوردیم. حالا از کجا بفهمیم این تقاضا زیاد است یا چی؟
قاعدتاً پاسخ این پرسش را باید میزان عرضه بدهد. پس باید (با همان روشی که تعداد موقعیتها را گزارش کردیم) تعداد کارجوها را گزارش کنیم. مثلا در هر روز ۱۰ کارجو به ازای ۱ موقعیت شغلی. در اینجا هم حتما باید تعداد افراد متمایز گزارش شود و یک فرد دو بار و چند بار شمارش نشود.
عامل مهم دیگری که باید به آن دقت کرد کیفیت رزومهها است. ممکن است از ۱۰ کارجو در روز فقط ۲تاشان شانس رفتن به مرحلهی بعدی مصاحبه را داشته باشند.
مسئلهای که نباید فراموش شود این است که این سوالات نباید ماهیت مطلق داشته باشند. قاعدتاً هر کسی که دارد سبک سنگین میکند که این حوزه را انتخاب کند یا نه، گزینههای دیگری هم دارد. پس گزارشی که خیلی میتواند به کارجوها کمک کند این شکلی است:
هر روز ۸ کارجو به ازای ۲ موقعیت شغلی در دیتا ساینس و ۴ کارجو به ازای ۳ موقعیت شغلی در امنیت شبکه و روزانه ۶ نفر تایید شده برای مرحلهی بعدی در دیتا ساینس و ۱ نفر تایید شده برای مرحلهی بعدی در امنیت شبکه.
یک پرسش هم میتواند راجع به حقوق و مزایای این رشته باشد که جوابش را پیدا خیلی بهتر از من میتواند بدهد.
مشوق اصلی من برای نوشتن این پست، همانطور که گفتم، سوالاتی بود که مکرر ازم پرسیده میشد و جوابی که باید میدادم این بود که دیتای مناسبی ندارم تا بهش استناد کنم. همچنین اشاعهی این دیدگاه که داده دروغ نمیگوید. پس بهترین مشورت، پرسیدن سوال از داده است نه افراد!

