
مرور و تحلیل معماری نرمافزارهای عاملمحور
در دو سال گذشته، عاملهای مبتنی بر مدلهای زبانی بزرگ (LLM-based Agents) از دموهای نمایشی به قلب محصولات واقعی رسیدهاند؛ سیستمهایی که هدف میگیرند، برنامه میریزند، ابزار صدا میزنند و مسیر خود را اصلاح میکنند. اما یک نکته بنیادین اغلب نادیده گرفته میشود: قلب تصمیمگیری این سیستمها یک مدل زبانی است که رفتارش احتمالاتی است، نه قطعی. ما یک جزء غیرقطعی را در مرکز معماری نشاندهایم و بعد انتظار داریم مثل نرمافزار سنتی، قابلاعتماد و آزمونپذیر رفتار کند. همین تناقض، ریشه بیشتر مشکلاتی است که در این سند بررسی میکنیم.
در نرمافزار سنتی، یک مؤلفه با ورودی مشخص، خروجی مشخص میدهد؛ میتوان قرارداد (contract) تعریف کرد، تست نوشت و رفتار را تضمین کرد. اما در یک عامل LLM‑محور، سه ویژگی این تضمینها را میشکند:
ناپایداری خروجی: همان ورودی ممکن است هر بار خروجی متفاوتی بدهد.
خطاهای خاموش: عامل ممکن است ابزار اشتباه صدا بزند، در حلقه بیفتد، یا با اطمینان کامل چیز غلطی بگوید.
انباشت خطا: اشتباه اغلب فقط در پایان کار آشکار میشود، وقتی چند مرحله غلط روی هم انباشته شدهاند.
نتیجه این است که بخش بزرگی از آنچه امروز «عامل خودمختار» نامیده میشود، در عمل چیزی جز «خودکارسازی با کمک LLM» نیست: زنجیرهای از پرامپتها که وقتی همهچیز خوب پیش برود کار میکند، اما هیچ سازوکار قطعی و آزمونپذیری برای مهار رفتارش ندارد. سبکهای کلاسیک (لایهای، رویدادمحور، میکروسرویس) هرکدام بخشی از راهحلاند، اما هیچکدام بهتنهایی برای مهار یک هسته احتمالاتی طراحی نشدهاند.
برای درک درست مسئله، لازم است بدانیم معماری این سیستمها چطور تکامل یافت:
ReAct ایده ترکیب «استدلال» و «کنش» را در یک حلقه معرفی کرد؛ پایه تقریباً همه عاملهای امروزی.
Generative Agents نشان داد حافظه و بازتاب (reflection) چطور رفتار باورپذیر میسازد.
HuggingGPT مدل زبانی را بهعنوان ارکستریتور فراخوانی ابزارها و مدلهای دیگر به کار گرفت.
چارچوبهای چندعاملی مانند AutoGen، MetaGPT و AgentVerse الگوهای همکاری، نقشمحوری و رفتارهای نوظهور را آوردند.
MemGPT و LangGraph روی مدیریت حافظه و حالت تمرکز کردند؛ ایدههایی مانند صفحهبندی حافظه، مدیریت وضعیت گرافمحور و checkpoint.
این پیشرفتها یک نقطه اشتراک دارند: همه در «قابلیت» و «هماهنگی» قویاند. عاملها باهوشتر و هماهنگتر شدهاند. اما درست همینجا یک شکاف پنهان است که در ادامه آن را میشکافیم.
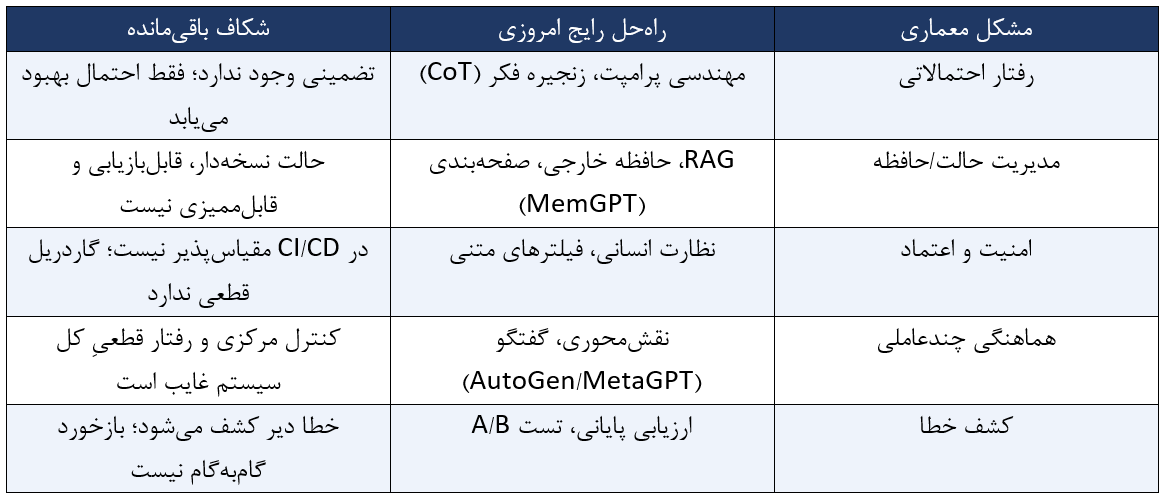
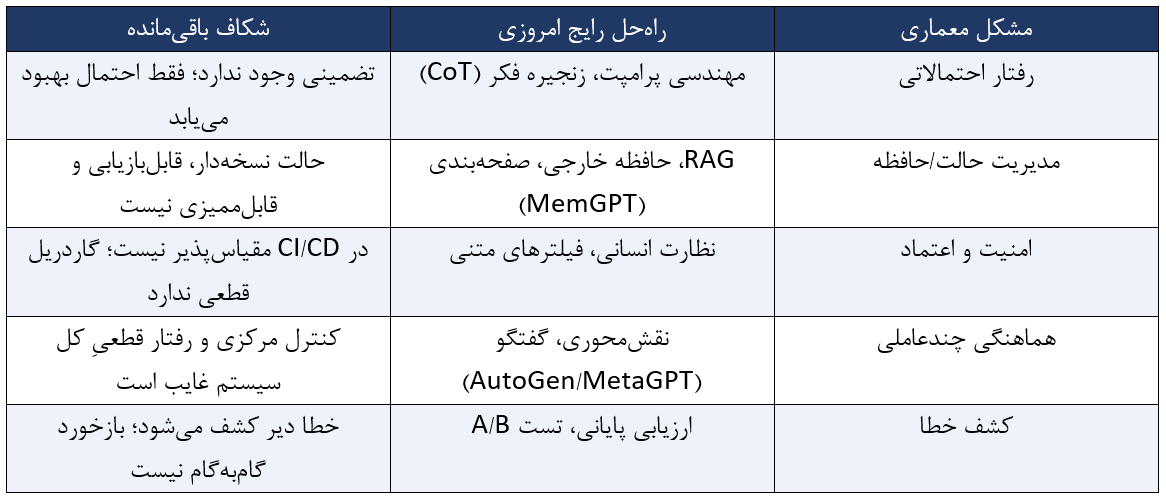
با مرور معماریمحور مقالات — نگاه از زاویه ساختار، نه صرفاً قابلیت — پنج دسته مشکلِ هنوز حلنشده بهطور مکرر تکرار میشوند:
مهار رفتار احتمالاتی: هیچ لایه قطعی و آزمونپذیری میان «تصمیم مدل» و «اثرگذاری روی دنیای واقعی» وجود ندارد.
مدیریت حالت و حافظه: حالت اغلب داخل پرامپت و پنجره کانتکست پخش است؛ نه نسخهدار است، نه قابل بازیابی، نه قابل بازرسی.
امنیت و اعتماد: دادن اختیار اجرای ابزار یا کد به یک جزء غیرقطعی، سطح حمله بزرگی میسازد (تزریق پرامپت، اقدامات مخرب، نشت داده).
کنترل تعامل انسان و عامل: اتکای بیش از حد به نظارت انسانی (Human‑in‑the‑loop) که در مقیاس تولید و خطلولههای CI/CD عملاً ناممکن است.
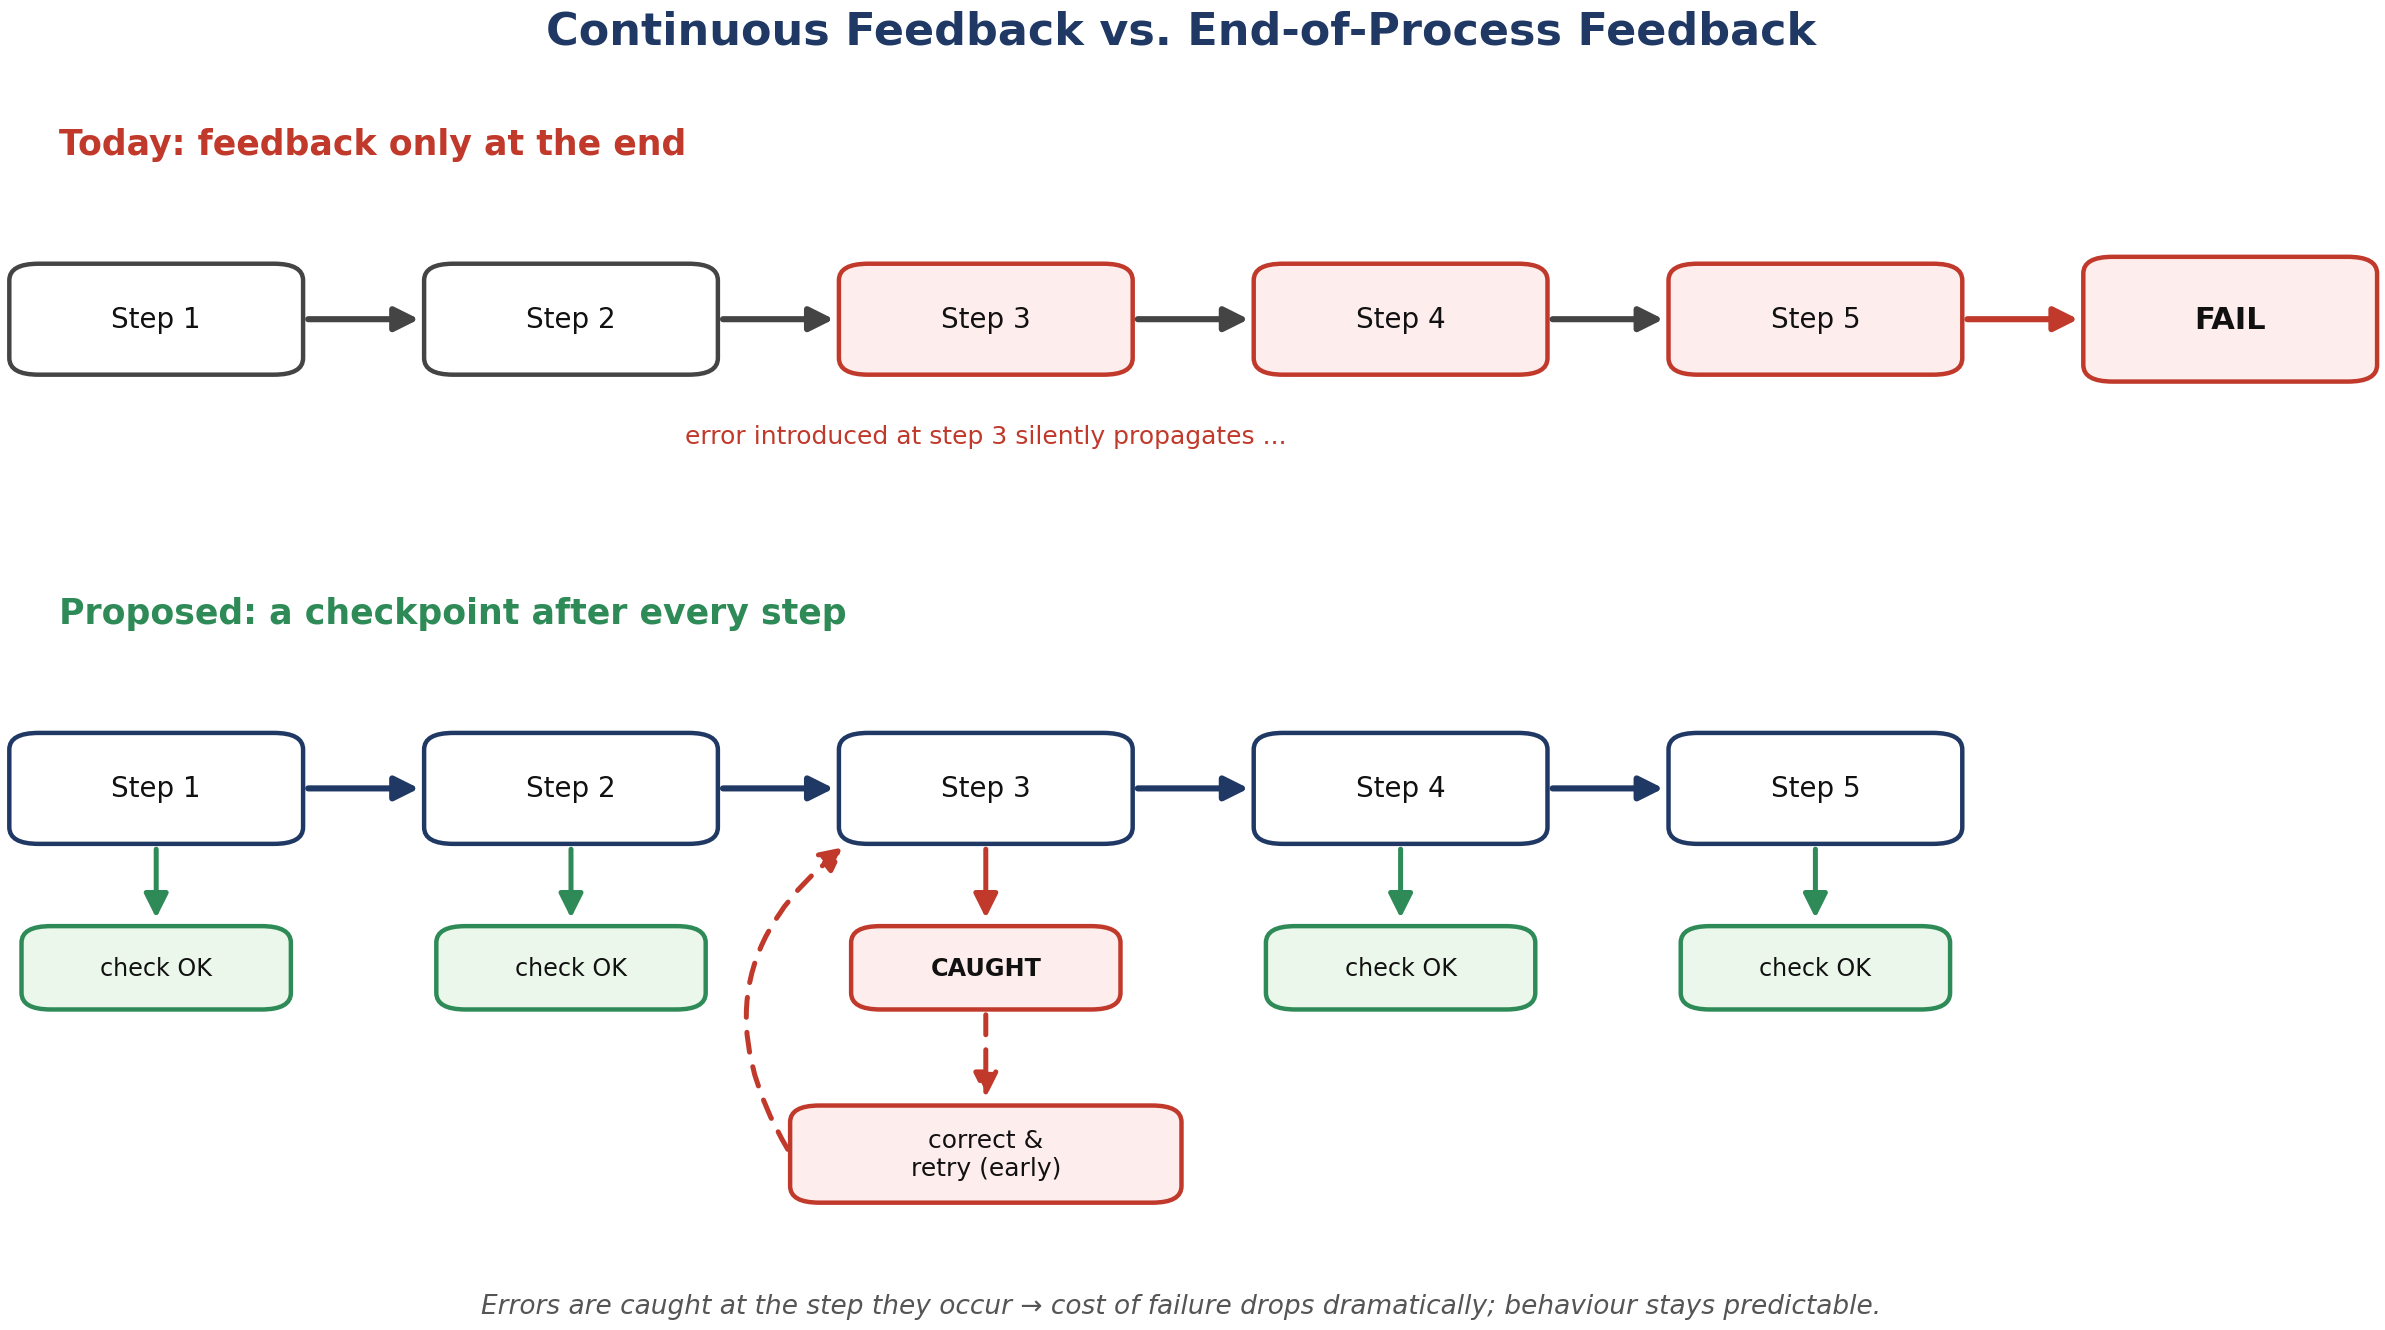
بازخورد فقط پایانی: سیستم تا انتها پیش میرود و تازه در پایان میفهمد شکست خورده است.
برای شفافیت، همان نگاشت «مشکل ← راهحل رایج ← شکاف باقیمانده» را اینجا خلاصه میکنیم:
جالب اینجاست که خودِ مقالات هم گاه در بخش محدودیتها به همین سمت اشاره میکنند:
مطالعه «Measuring Agents in Production» با داده از دهها سیستم عملیاتی نشان میدهد تیمها بیش از حد به مهندسی پرامپت و به انسانِ ناظر وابستهاند و صراحتاً میگوید این حوزه به راستیآزمایی رسمی (Formal Verification) و گاردریلهای قطعی نیاز دارد تا مدل احتمالاتی را مهار کند.
مرورهای امنیت عاملها و برنامهنویسی عاملمحور بارها روی مفاهیم ماشین حالت (State Machine)، رفتار قطعی (Deterministic) و کنترل در خطلوله CI/CD تأکید میکنند.
کارهای حافظه‑محور مانند MemGPT و LangGraph عملاً میگویند حالت را باید مثل یک منبع درجهیک مدیریت کرد، نه اینکه در متن پرامپت رهایش کنیم.
جمعبندی ما: ادبیات موجود در «قابلیت و هماهنگی» قوی است، اما در «کنترل، قطعیت و مدیریت حالت» ضعیف. همین خلأ، محور معماری ماست.
ایده مرکزی ما از یک اصل کلاسیک مهندسی نرمافزار میآید: جداسازی دغدغهها (Separation of Concerns). مشکل بنیادین این است که در معماریهای فعلی، «تصمیمگیری» و «کنترل» در یک جزءِ واحد درهمتنیدهاند و آن جزء احتمالاتی است. پیشنهاد ما این است که این دو مسئولیت را در دو صفحه مجزا از هم جدا کنیم — درست مانند جدایی «صفحه کنترل» از «صفحه داده» در معماری شبکه:
صفحه استدلال (Reasoning Plane): احتمالاتی، خلاق، مبتنی بر LLM. جای فکر کردن.
صفحه کنترل (Control Plane): قطعی، آزمونپذیر، قابلممیزی. جای تصمیم گرفتن و اجازه دادن.
قاعده طلایی: صفحه استدلال فکر میکند، صفحه کنترل اجازه میدهد.
شکل ۱ نمای کلی این معماری را نشان میدهد. توجه کنید که صفحه استدلال هیچ دسترسی مستقیمی به دنیای بیرون ندارد؛ هر کنش پیش از اثرگذاری باید از هسته کنترلی قطعی عبور کند و بازخورد بهصورت پیوسته (نه فقط در پایان) جریان دارد.
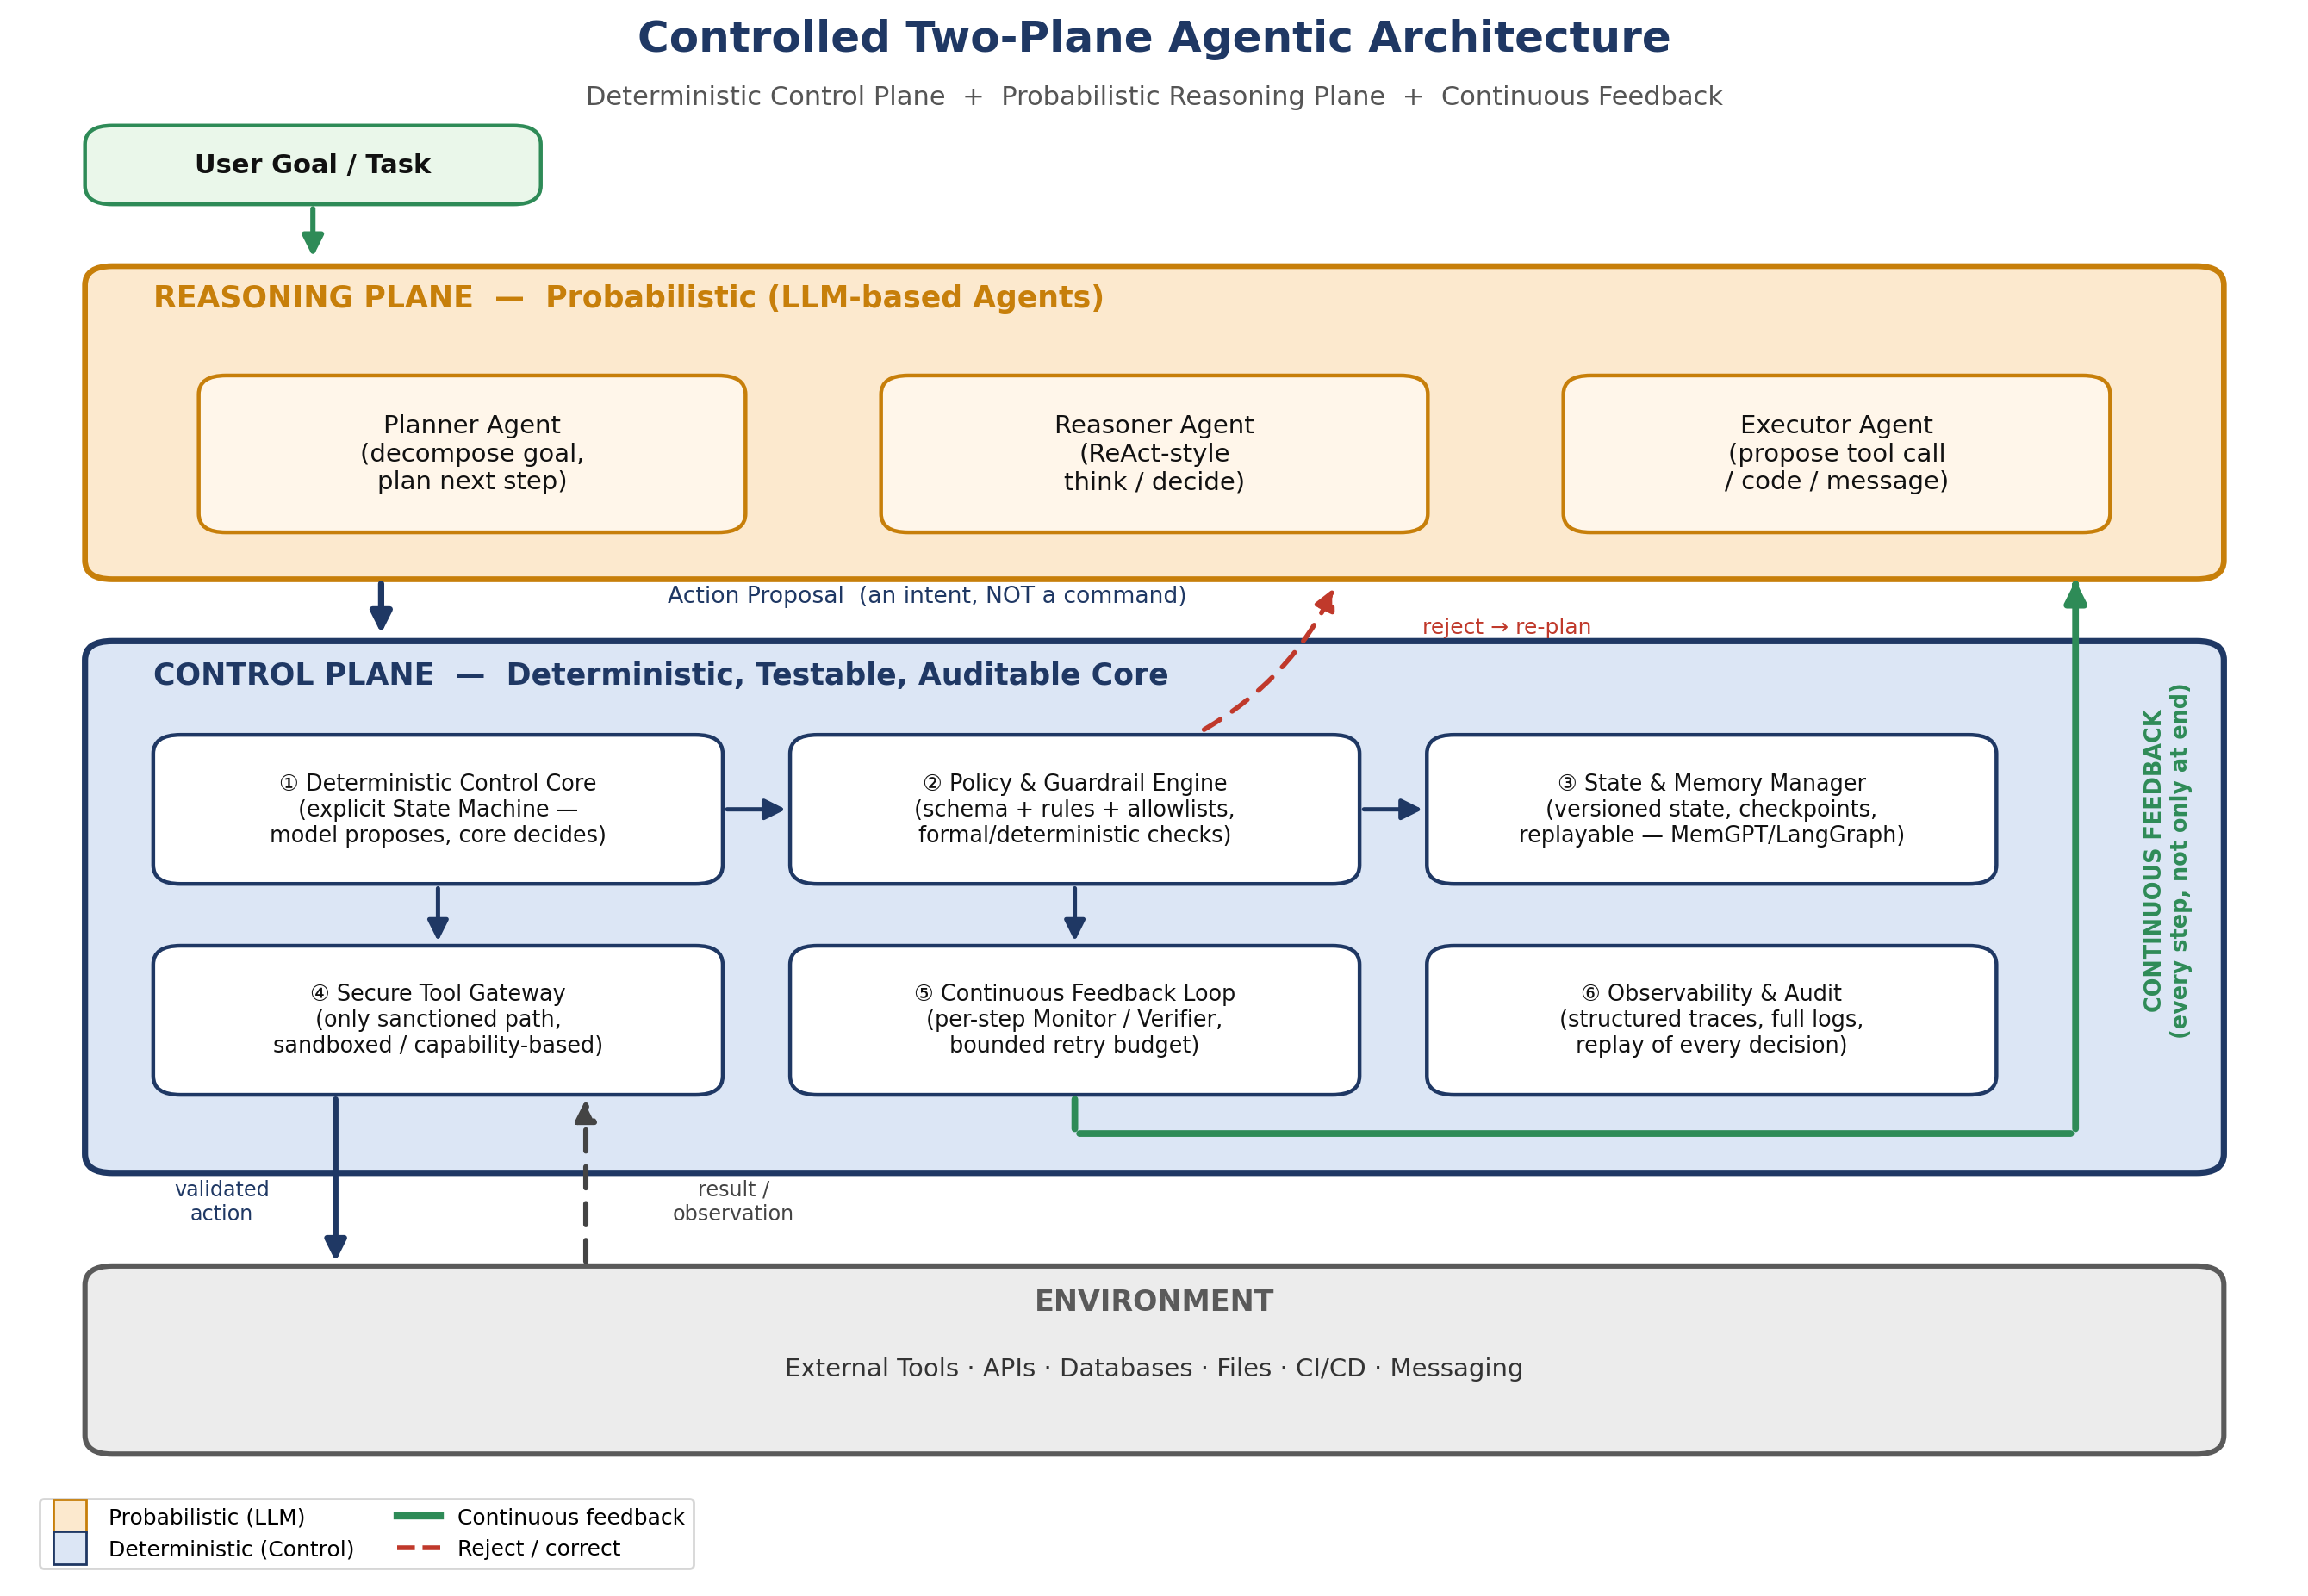
صفحه کنترل قلب قطعیِ معماری است. آن را از شش مؤلفه میسازیم که هرکدام یک مسئولیت روشن و آزمونپذیر دارند. برای هر جزء، هم نقش معماری و هم یک مسیر پیادهسازی واقعی را میآوریم تا از سطح تئوری فاصله بگیریم:
1. هسته کنترلی/ارکستریتور (Deterministic Control Core): جریان کار را بهصورت یک ماشین حالتِ قطعی اجرا میکند. مدل فقط محتوای گام «پیشنهاد کنش» را پر میکند؛ تمام گذارها (transitions) در اختیار هسته است. پیادهسازی: یک ارکستریتور کدنویسیشده (نه LLM) بر پایه یک گراف حالت صریح؛ در عمل میتوان از موتورهای گردشکار حالتدار یا یک ماشین حالت سبک در همان زبان سرویس استفاده کرد.
2. موتور سیاست و گاردریل (Policy & Guardrail Engine): هر کنش پیشنهادی را در برابر مجموعهای از قیدهای قطعی میسنجد: اعتبارسنجی طرحواره (JSON Schema)، بررسی نوع و بازه پارامترها، فهرستهای مجاز/ممنوع، پیششرطها و بودجه اجرا. پیادهسازی: ترکیبی از اعتبارسنجی طرحواره و یک زبان سیاست جدا از کد (مانند موتورهای سیاست از نوع OPA/Rego)، بهعلاوه راستیآزمایی قیدهای بحرانی بهشکل قطعی.
3. مدیر حالت و حافظه (State & Memory Manager): حالت را بهعنوان یک منبع درجهیک نگه میدارد: نسخهدار، checkpointشده و قابل بازپخش (replay). پیادهسازی: یک لاگ رویداد (event log) بهعلاوه ذخیره نقاط وارسی؛ الهامگرفته از checkpointهای LangGraph و صفحهبندی حافظه MemGPT، اما بهعنوان یک سرویس قطعی و مستقل از پرامپت.
4. درگاه امن ابزار (Secure Tool Gateway): تنها مسیر مجاز برای هر اثر جانبی. عامل هرگز مستقیم ابزار صدا نمیزند. پیادهسازی: اجرای ایزوله (sandbox/container)، مجوزهای مبتنی بر قابلیت (capability tokens)، حالت اجرای آزمایشی (dry-run) و محدودسازی منابع و شبکه.
5. حلقه بازخورد مستمر (Continuous Feedback Loop): یک ناظر/راستیآزما که خروجی هر گام را در برابر انتظارات میسنجد و بازخورد ساختاریافته را بلافاصله به صفحه استدلال برمیگرداند؛ با یک بودجه محدود برای تلاش مجدد تا از حلقه بیپایان جلوگیری شود. پیادهسازی: مجموعهای از بازبینهای قطعی (قواعد) بهعلاوه در صورت نیاز یک داورِ مدلزبانی (LLM-as-a-judge) بهعنوان سیگنال مکمل، نه مرجع نهایی.
6. رصدپذیری و ممیزی (Observability & Audit): هر تصمیم، هر پیشنهاد و هر گذار بهصورت ساختاریافته لاگ و ردگیری میشود تا کل اجرا قابل بازپخش و حسابرسی باشد. این جزء دقیقاً پاسخی است به شکافی که مقاله محیط تولید درباره «نبود لاگهای واقعی» مطرح کرد.
برای اینکه معماری ملموس شود، مسیر یک تککنش را دنبال میکنیم. نکته کلیدی این است که خروجی صفحه استدلال یک «قصد/پیشنهاد» است، نه یک «دستور»؛ و تا وقتی از فیلتر قطعی عبور نکند، هیچ اثری بر دنیای واقعی ندارد (شکل ۲).
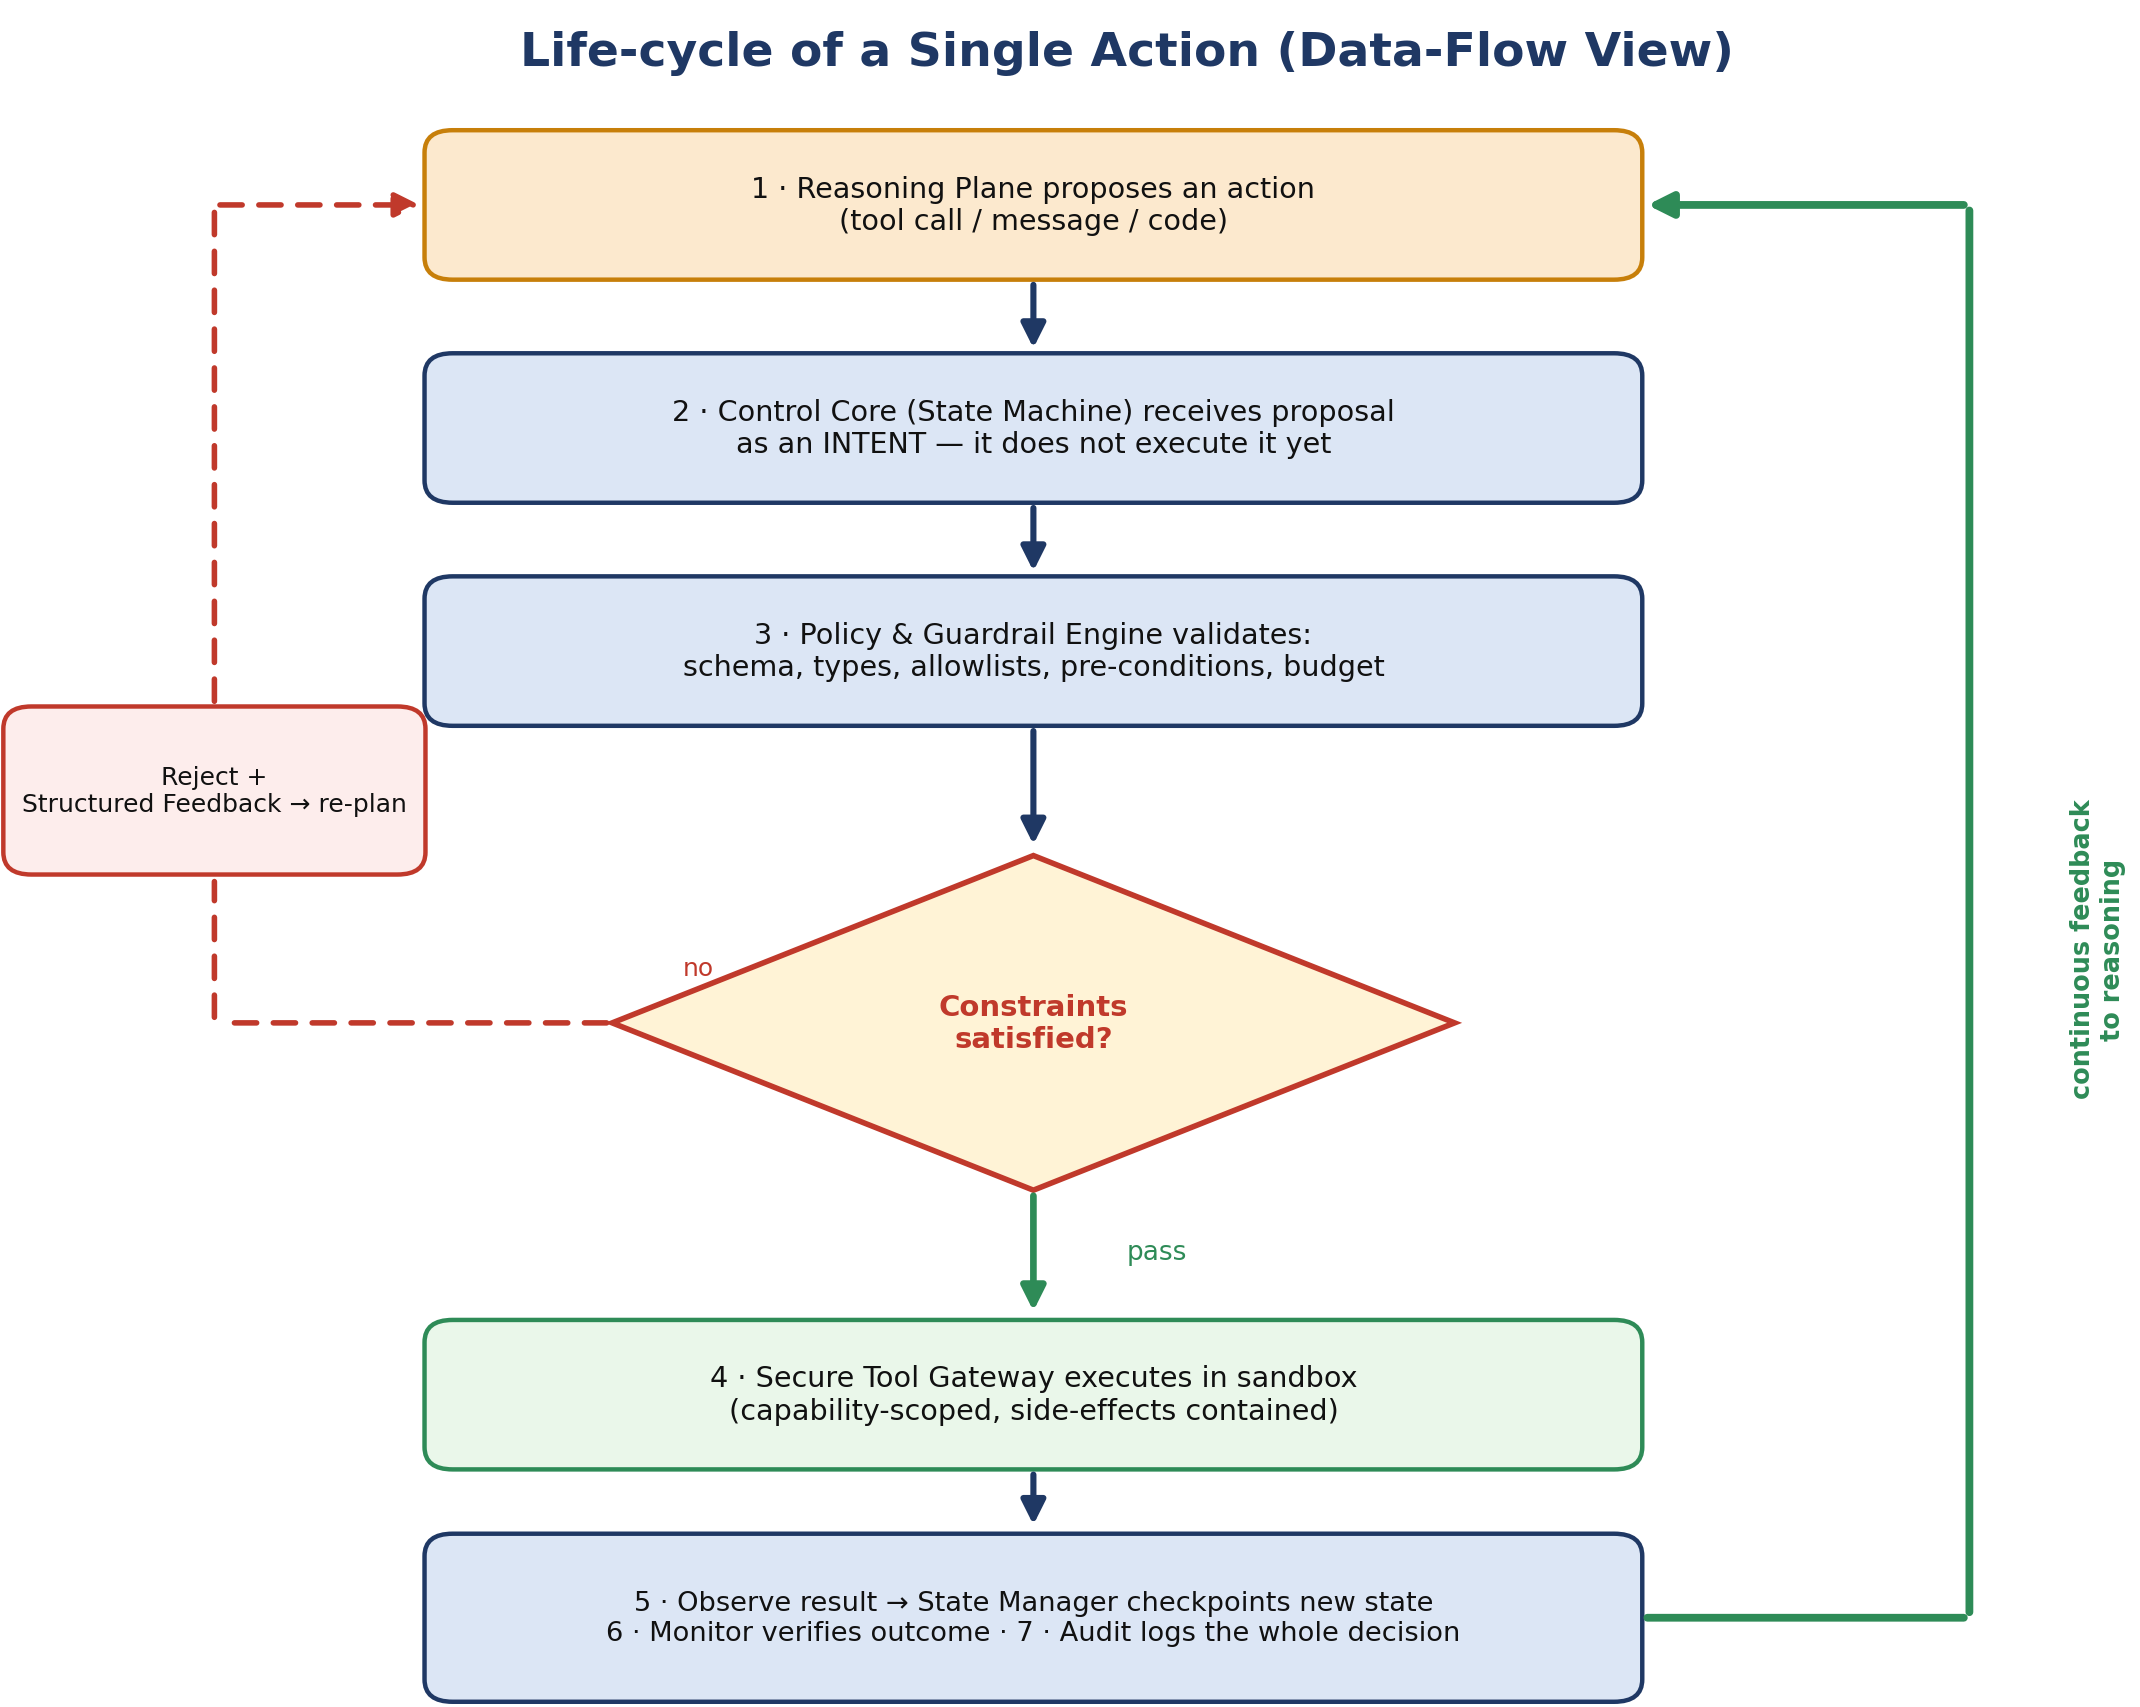
همین منطق را میتوان بهشکل یک حلقه کنترلیِ ساده و قطعی نوشت. شبهکد زیر نشان میدهد که هسته چگونه پیشنهاد مدل را مهار میکند:
state = init_state(goal)
while not state.done and state.budget_left():
    proposal = reasoning_plane.next_action(state)   # LLM: فقط پیشنهاد
    verdict  = guardrails.check(proposal, state)     # قطعی
    if not verdict.ok:
        state = state.with_feedback(verdict.reason)  # رد → اصلاح
        continue
    result = tool_gateway.execute(proposal)          # اجرای امن/ایزوله
    check  = monitor.verify(result, proposal, state) # بازبینی گام
    state  = state_manager.checkpoint(state, result, check)
    audit.log(proposal, verdict, result, check)      # ممیزی کامل
return state.summary()
توجه کنید که تنها یک خط از این حلقه (پیشنهاد کنش) احتمالاتی است؛ بقیه منطق قطعی، آزمونپذیر و قابل بازپخش است. این همان تعادلی است که ادبیات موجود پیدا نکرده بود: حفظ قدرت مدل بدون قربانیکردن قابلیت اطمینان.
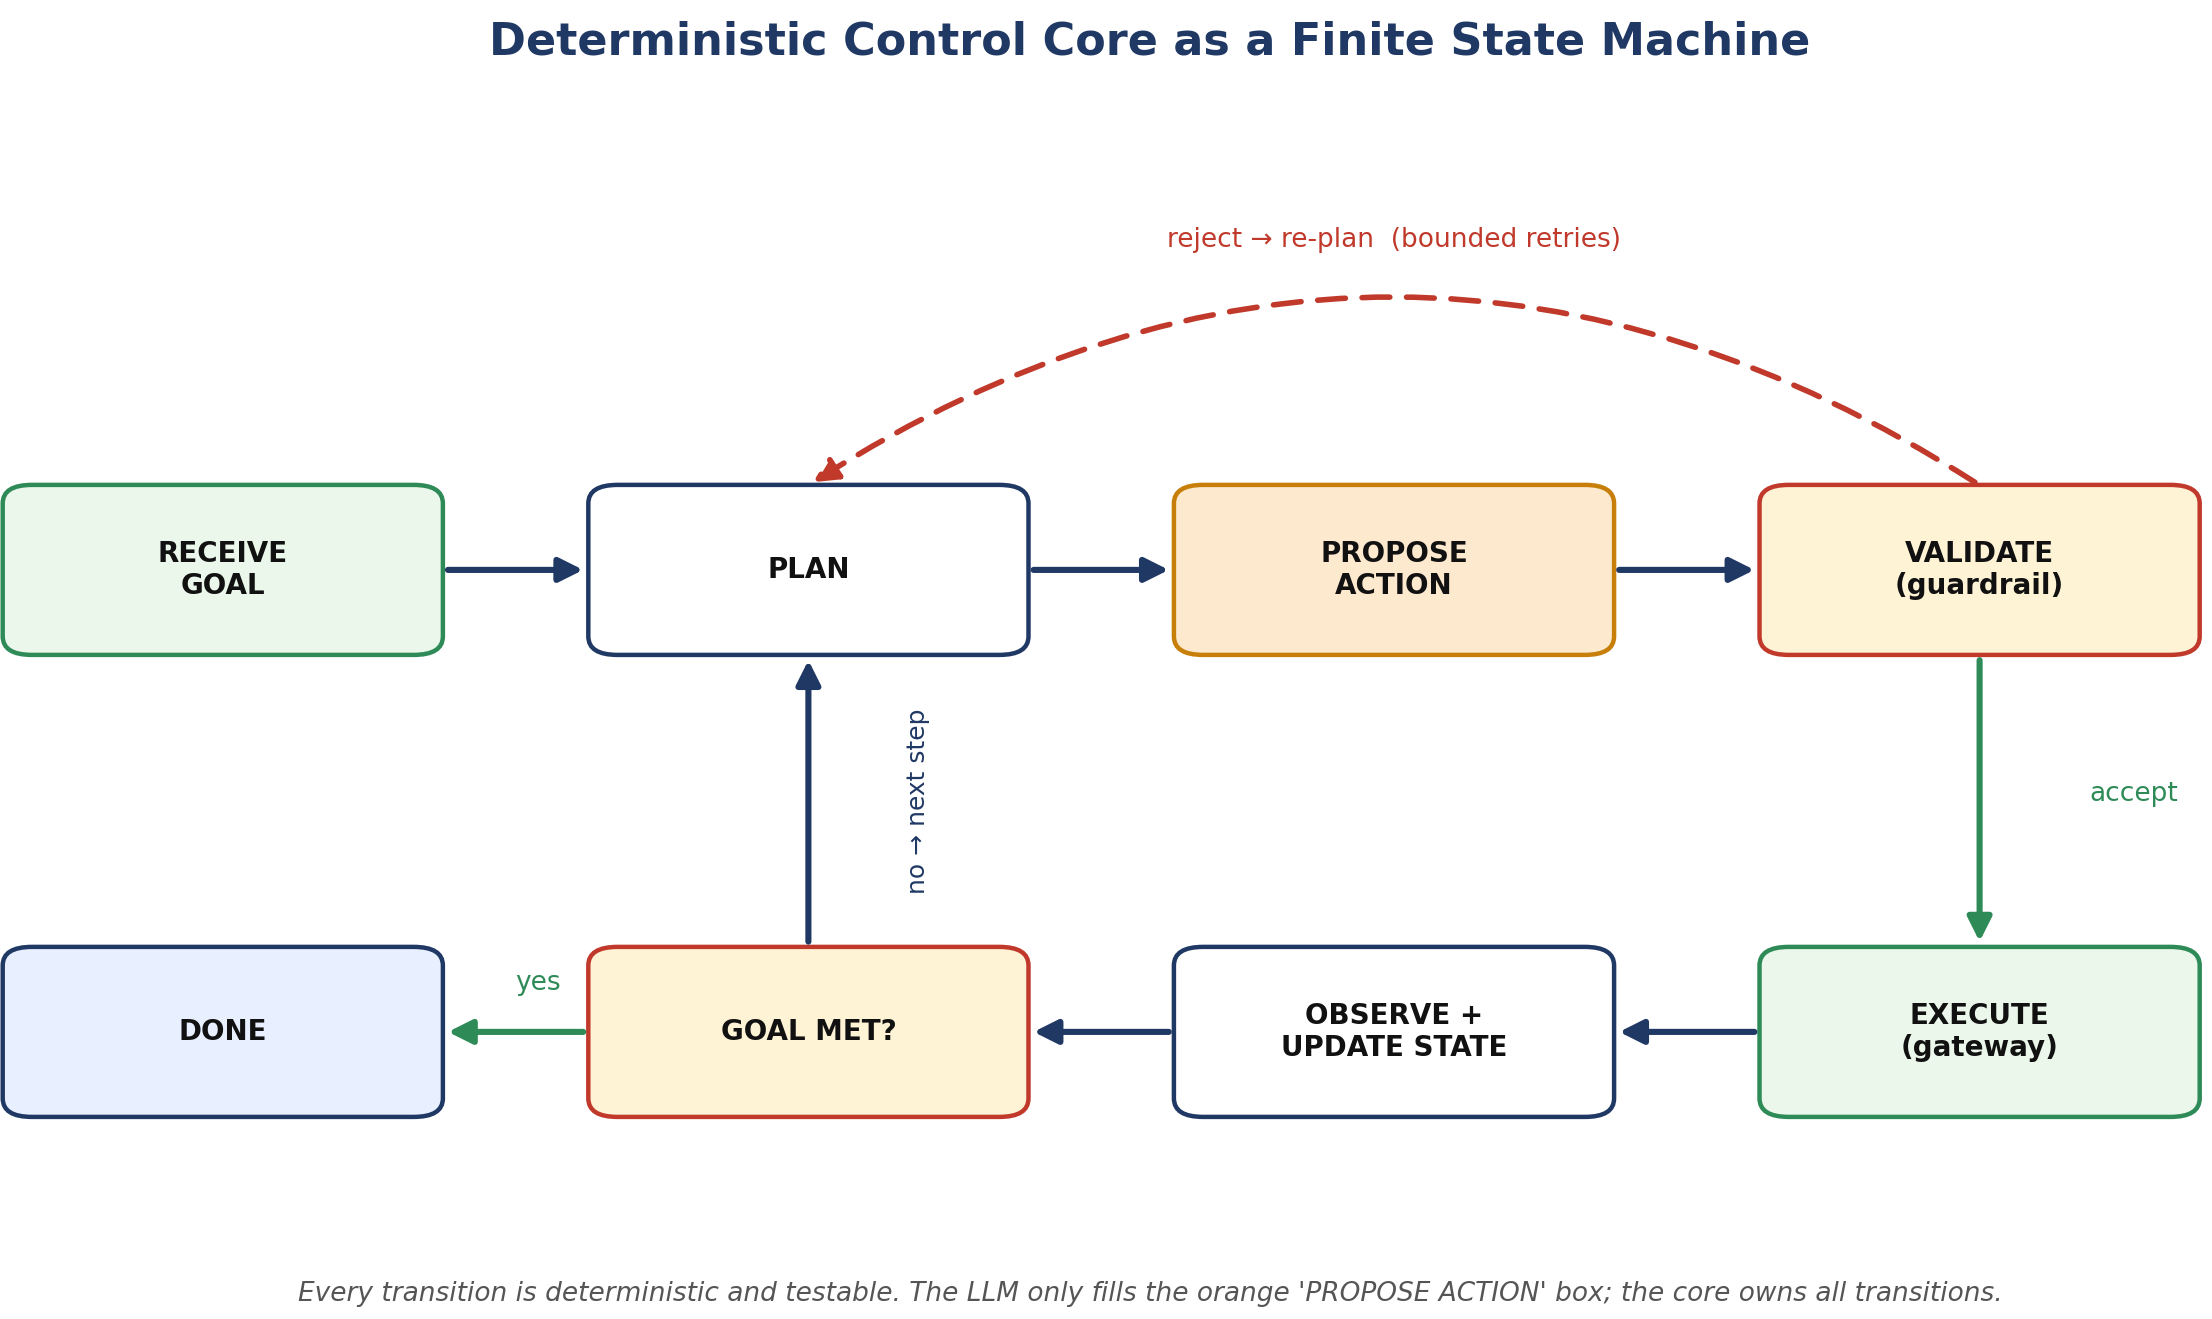
قلب هماهنگی، یک ماشین حالتِ متناهی و قطعی است. مدل تنها محتوای حالتِ «پیشنهاد کنش» را تولید میکند؛ اما اینکه از کدام حالت به کدام حالت میرویم، کاملاً در اختیار هسته و آزمونپذیر است. این ساختار دقیقاً همان چیزی است که مقالات امنیت و برنامهنویسی عاملمحور بر آن تأکید داشتند (شکل ۳).
در معماریهای رایج، خطاها مانند بهمن انباشته میشوند و در انتها فرو میریزند. در مدل ما هر گام یک ایست بازرسی دارد؛ اگر کنش پیشنهادی قید را نقض کند، همانجا رد یا اصلاح میشود. نتیجه این است که خطاها زودهنگام و ارزان گرفته میشوند و رفتار کل سیستم پیشبینیپذیر میماند (شکل ۴).
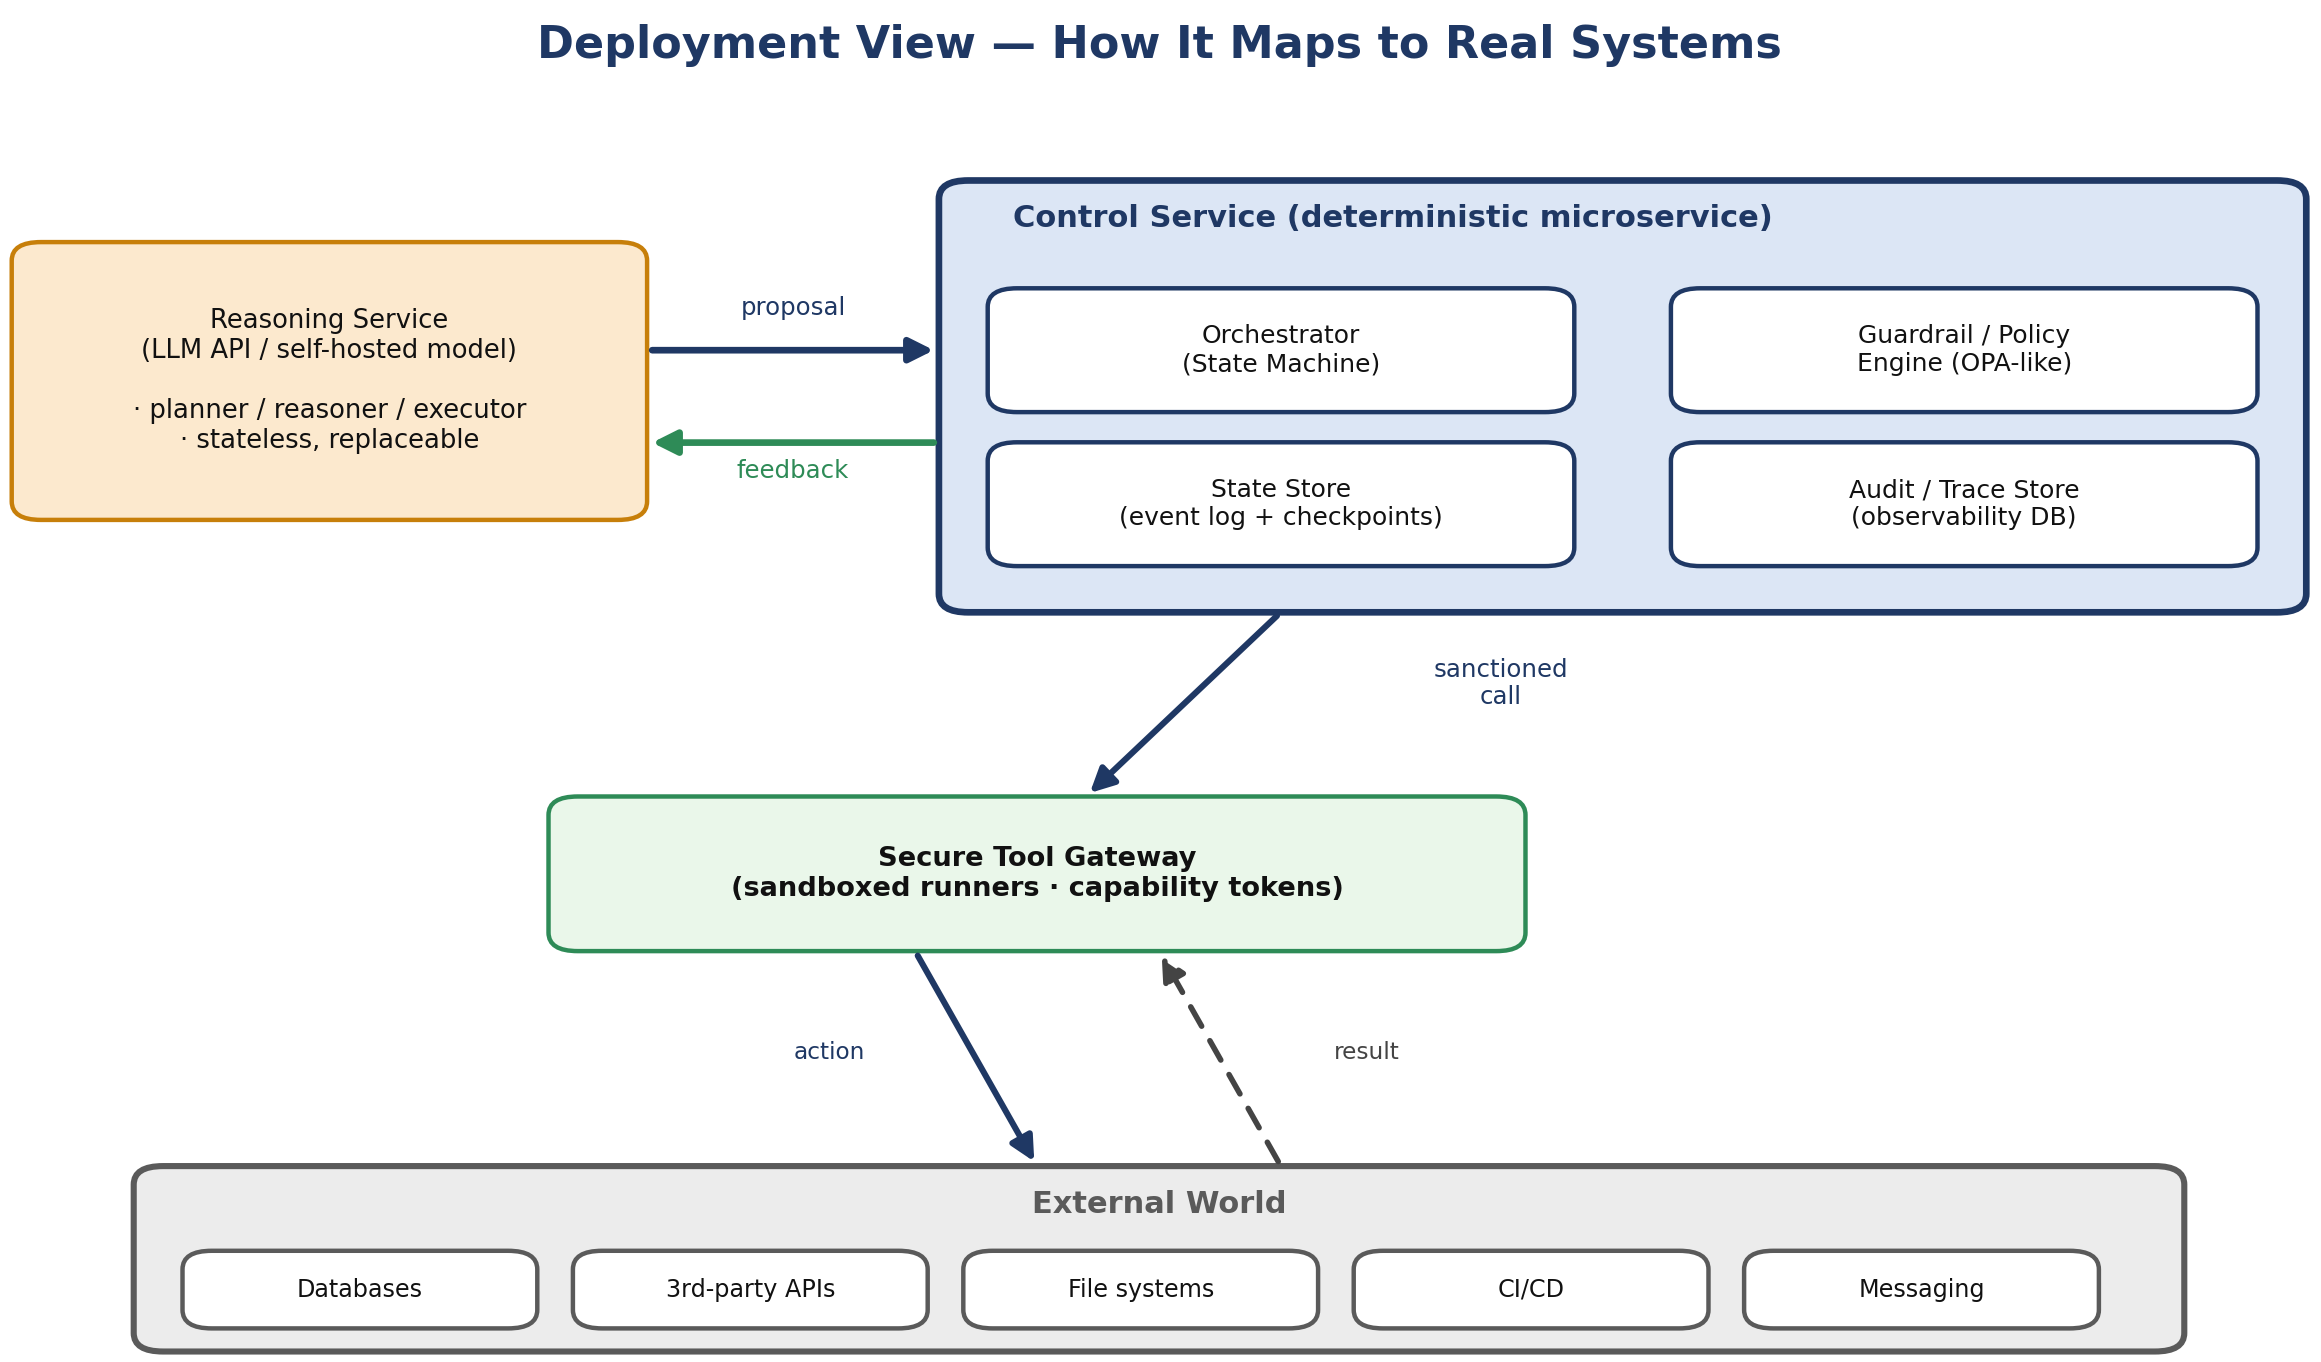
این معماری صرفاً یک نمودار مفهومی نیست؛ بهروشنی به یک ساختار استقرار واقعی نگاشت میشود. صفحه استدلال یک سرویس بدونحالت و قابلتعویض روی یک مدل زبانی است؛ صفحه کنترل یک میکروسرویس قطعی با ذخیرهگاه حالت، ذخیرهگاه سیاست و پایگاه ممیزی؛ و درگاه امن ابزار، اجراکنندههای ایزوله را مدیریت میکند (شکل ۵).
برای اینکه پیادهسازی کاملاً زمینی شود، هر جزء را به فناوریهای رایج نگاشت میکنیم:
فرض کنید یک عامل قرار است فاکتورهای یک شرکت را پردازش کند و برای مشتریان ایمیل تأیید بفرستد. مسیر را در هر دو معماری مقایسه کنیم:
• در معماری امروزی: مدل در گام سوم یک مبلغ را اشتباه میخواند، در گام چهارم بر اساس همان اشتباه تصمیم میگیرد و در گام پنجم ایمیلِ غلط را به مشتری ارسال میکند. هیچکس تا لحظه ارسال متوجه نمیشود؛ خطا برگشتناپذیر است.
• در معماری پیشنهادی: مدل «پیشنهاد» میدهد که ایمیلی با فلان مبلغ به فلان آدرس ارسال شود. این پیشنهاد به صفحه کنترل میرود. گاردریل بررسی میکند: آیا آدرس در فهرست مجاز است؟ آیا مبلغ با رکورد پایگاهداده میخواند؟ چون مبلغ ناسازگار است، کنش رد میشود و بازخورد ساختاریافته به مدل برمیگردد تا اصلاح کند. تنها پس از عبور از فیلتر قطعی، درگاه امن ابزار ایمیل را واقعاً ارسال میکند و کل تصمیم در پایگاه ممیزی ثبت میشود.
تفاوت، شب و روز است: در حالت اول خطا در پایان و در دنیای واقعی رخ میدهد؛ در حالت دوم خطا در همان گام، پیش از هر اثر بیرونی، گرفته و اصلاح میشود.
در فاز پیشین مجموعهای از سنجههای کیفی (مقیاسپذیری، قابلیت اطمینان، امنیت و تطبیقپذیری) را برای داوری معماری تعریف کردیم. جدول ۳ ارزیابی کیفی معماری پیشنهادی را در برابر رویکرد رایج «زنجیره پرامپت» نشان میدهد و توضیح میدهد که هر بهبود از کدام تصمیم معماری میآید:
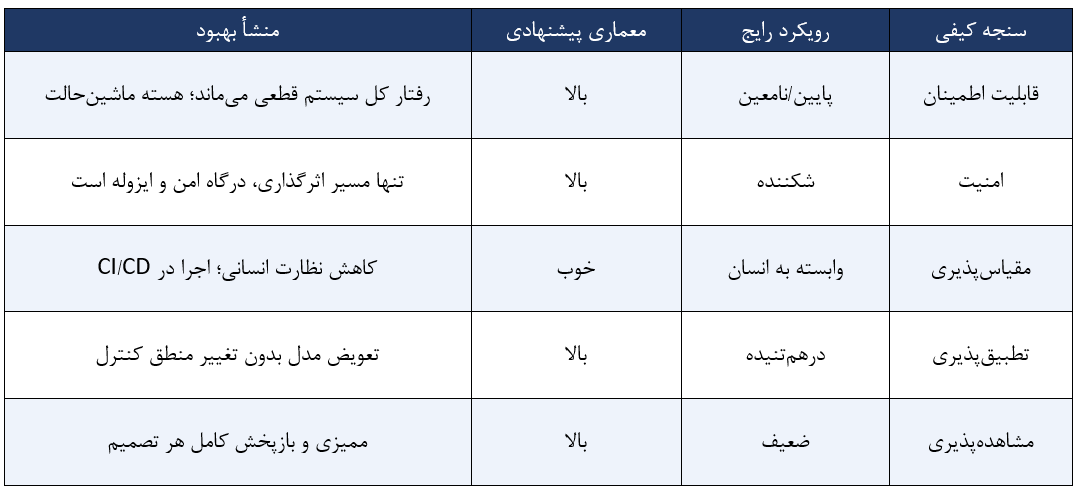
در سناریوی سختِ بخش ۱۲ (پردازش فاکتور با دادههای ناسازگار)، معماری پیشنهادی بهجای تولید یک خروجی غلطِ برگشتناپذیر، خطا را در نقطه وقوع مهار کرد؛ این دقیقاً همان رفتاری است که یک سیستم عملیاتی قابلاعتماد باید نشان دهد.
هیچ معماریای بدون هزینه نیست؛ صادقانه سه مبادله اصلی و پاسخ ما به آنها را میآوریم:
1. سربار تأخیر: عبور هر کنش از گاردریل و بازبینی، اندکی تأخیر اضافه میکند. اما یافتههای میدانی نشان میدهند در عمل بیشتر کاربردهای عاملمحور تحمل تأخیر بالایی دارند؛ در برابرِ هزینه یک خطای عملیاتی، این سربار ناچیز است.
2. هزینه نوشتن سیاستها: تعریف قیدها و طرحوارهها کار اولیه میطلبد. راهحل: شروع با یک هسته کوچک از قیدهای بحرانی و گسترش تدریجی؛ سیاستها جدا از کد نگهداری میشوند و قابل نسخهبندیاند.
3. پوشش گاردریل: گاردریل فقط چیزهایی را میگیرد که برایش تعریف شدهاند. راهحل: لایهبندی دفاع — قیدهای قطعی برای موارد بحرانی، بهعلاوه داور مدلزبانی و ممیزی کامل برای کشف موارد پیشبینینشده و افزودن قید جدید.
نکته مهم این است که هیچکدام از این مبادلات، اصل معماری را نقض نمیکنند؛ بلکه پارامترهای تنظیمشدنیاند که بسته به حساسیت کاربرد کم و زیاد میشوند.
این پروژه از یک پرسش ساده آغاز شد: چطور میتوان سیستمی ساخت که قلبش احتمالاتی است اما رفتارش قابلاعتماد است؟ مسیر ما از مرور مفاهیم پایه ، به یک چارچوب تحلیل سهسطحی و دستهبندی معماریمحور ، و سرانجام به یک معماری مصور و نزدیک به پیادهسازی رسید.
یافته محوری ما این بود که ادبیات موجود در «قابلیت و هماهنگی» قوی اما در «کنترل، قطعیت و مدیریت حالت» ضعیف است. پاسخ معماری ما به این خلأ، جداسازی صفحه کنترل قطعی از صفحه استدلال احتمالاتی است؛ همراه با یک هسته کنترلی بهشکل ماشین حالت، موتور گاردریل، مدیریت حالتِ نسخهدار، درگاه امن ابزار، و مهمتر از همه، بازخورد مستمر بهجای بازخورد پایانی.
ارزش این معماری در چهار جمله خلاصه میشود: قابلیت اطمینان، چون رفتار کل سیستم قطعی میماند حتی وقتی قلب آن احتمالاتی است؛ امنیت، چون تنها مسیر اثرگذاری یک درگاه امن و ایزوله است؛ مقیاسپذیری، چون وابستگی به نظارت انسانی کم میشود و اجرا در محیط تولید و CI/CD ممکن میگردد؛ و تطبیقپذیری، چون میتوان مدل زیرین را بدون دستزدن به منطق کنترل عوض کرد.
نکته کلیدی که میخواهیم با آن تمام کنیم این است که ما هوش مدل را محدود نمیکنیم؛ خلاقیت و قدرت آن دستنخورده در صفحه استدلال باقی میماند. کاری که میکنیم فقط این است که مسیر اثرگذاریاش را از یک لایه قطعی، آزمونپذیر و قابلممیزی عبور میدهیم. به بیان دیگر: هوش را در صفحه استدلال آزاد بگذارید، اما کنترل را به یک صفحه قطعی بسپارید. این همان قطعه گمشدهای است که ادبیات امروزِ سیستمهای عاملمحور کم دارد — و کوشیدیم در این سند آن را روشن، مصور و قابلساخت ارائه کنیم.
1. Measuring Agents in Production (2026).
2. Strategic Heterogeneous Multi-Agent Architecture for Cost-Effective Code Vulnerability Detection (2026).
3. ENGIAI: A Multi-Agent Framework and Benchmark Suite for LLM-Driven Engineering Design (2026).
4. Process-Centric Analysis of Agentic Software Systems (2026).
5. Software Self-Extension with SELFEVOLVE: An Agentic Architecture for Runtime Code Generation (2026).
6. ReAct: Synergizing Reasoning and Acting in Language Models (ICLR 2023).
7. Generative Agents: Interactive Simulacra of Human Behavior (2023).
8. HuggingGPT: Solving AI Tasks with ChatGPT and its Friends in Hugging Face (2023).
9. Implementing Multi-Agent Systems Using LangGraph: A Comprehensive Study LangGraph.
10. AutoGen: Enabling Next-Gen LLM Applications via Multi-Agent Conversation (2023).
11. MetaGPT: Meta Programming for a Multi-Agent Collaborative Framework (ICLR 2024).
12. AgentVerse: Facilitating Multi-Agent Collaboration and Exploring Emergent Behaviors (2023).
13. A Survey on Large Language Model based Autonomous Agents (Xi et al., 2024).
14. AWS Prescriptive Guidance: Agentic AI Frameworks, Platforms, Protocols and Tools on AWS (2026).
15. MemGPT: Towards LLMs as Operating Systems (2024).
16. Agentic AI — The Rise of Autonomous Intelligent Agents in the Era of LLMs (2025).
17. Agentic AI: A Comprehensive Survey of Architectures, Applications, and Future Directions (2026).
18. AI Agentic Programming: A Survey of Techniques, Challenges, and Opportunities.
19. The Attack and Defense Landscape of Agentic AI: A Comprehensive Survey (2026).
20. AI Agentic Programming: A Survey of Techniques, Challenges, and Opportunities.
گردآوردندگان: حسن احمدیان نیا ، سید محمدرضا نظام خیرآبادی
استاد راهنما: دکتر علی اکبری
این مطلب، بخشی از تمرین های درس معماری نرم افزار در دانشگاه شهید بهشتی است.

