
درس 30: Transforming Programming
تمام برنامه ها تبدیل اطلاعاتو انجام میدن، پردازش و تبدیل ورودی ها به خروجیها، اما به ندرت وقتی به طراحی فکر میکنیم به این بعد سیستم نگاه میکنیم و اکثرا تمرکزمون روی کلاسها، ماژولها، ساختار داده، الگوریتم، زبان برنامه نویسی و فریمورک هاست.
ما عقیدمون اینه که اگر یک قدم به عقب برگردید و به این فکر کنید که سیستم قراره چه ورودی و خروجیهایی داشته باشه، خیلی مسیرو واضح تر میکنه، خیلی از نگرانی هایی که داشتیمو روشن و یا حل میکنه، خطایایی راحت تر و همچنین وابستگی رو هم کاهش میده.
فرض کنید به یک برنامه نویس یونیکس در سال 1970 میگید که برنامه ای بنویسه که لیست 5 تا فایله بزرگ یک مسیر فولدری رو بهتون خروجی بده، شما فکر میکنید که یک ادیتور باز میکنه و شروع میکنه به زدن کد C، اما در واقعیت اون توی ترمینال ی همچین کامندی رو میزنه:
$ find . -type f | xargs wc -l | sort -n | tail -5
این کامند شامل یکسری تبدیلهاست(transformations).
find . -type f
لیستی از فایلهای داخل مسیر (.) رو خروجی میده
xargs wc -l
ورودی رو میخونه و در خروجی تعداد خط و نام فایل رو بهمون میده
sort -n
سورت میکنه ورودی رو، با این فرض که هر خط با یک نامبر شروع میشه برا همین دش ان رو به عنوان اپشن بهش دادیم
tail -5
ورودی رو میخونه و 5 خط اخرش رو توی خروجی نمایش میده
به عنوان مثال ی همچین خروجی رو بهمون میده:
470 ./debug.pml
470 ./test_to_build.pml
487 ./dbc.pml
719 ./domain_languages.pml
727 ./dry.pml
برای گرفتن این خروجی مدنظرصورت مسئله، این سری تبدیل ها انجام شد:
directory name
→ list of files
→ list with line numbers
→ sorted list
→ highest five
** برنامه نویسی حول محور کد است و برنامه ها حول محور داده.
· تبدیل ها رو پیدا کنید FINDING TRANSFORMATIONS
معمولا ساده ترین راه برای پیدا کردن تبدیلها اینه که به نیازمندیهای سیستم فکر کنیم و ورودی و خروجی هاشون. بعد میتونید به قدمهایی که لازمه برای اینکه از ورودی به خروجی برسید فکر کنید. این یک نگاه از بالا به پایینه.
فرض کنید میخاید یک سایت بازی برای مردم درست کنید که توش با انتخاب حروف الفبا کلمه سازی کنند. ورودی تون لیستی از حروف الفباست و خروجی هم لیستی از کلمات دو، سه، چهار و ... حرفی.
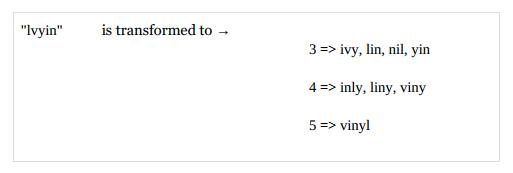
اره این خروجیای سمت راست عکس کلمه ان، حداقل توی دیکشنری مک اواس ?
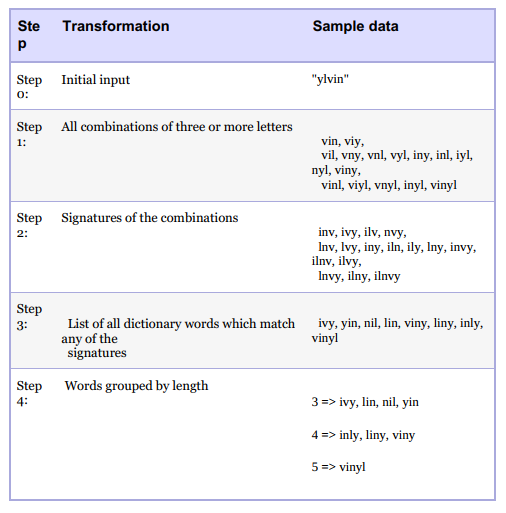
ما یک دیکشنری از کلمات داریم که با سیگنچر(signature) گروه بندی شدن، در نتیجه هر دو کلمه ای که تمام حروفشون مثل هم باشه سیگنچر یکسان هم خاهند داشت. ساده ترین متود محاسبه سیگنچر هم اینه که که یک لیست سورت شده از حروف هر کلمه رو خروجی بده. ما رشته ورودی رو میگیریم سیگنچرش رو حساب میکنیم، بعد چک میکنیم ایا کلمه ای با این سیگنچر وجود داره یانه.
بنابرین ریشه یاب کلمه ها به 4 تبدیل شکسته میشه:
به مرحله 1 اگر نگاه کنید، که یک کلمه میگیره و تمام ترکیب های مختلف سه چهار پنج و .. حرفی شو لیست میکنه، این مرحله خودش میشکنه به تبدیل های زیر:
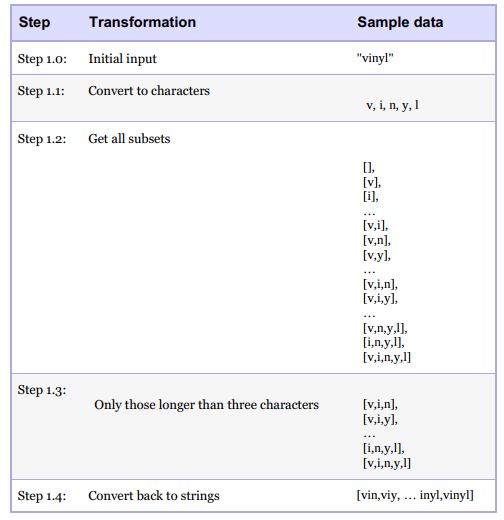
خوب به نقطه ای رسیدیم که خیلی راحت میتونیم هر تبدیلو پیاده سازی کنیم:(نمونه کد به زبون Elixir)
function-pipelines/anagrams/lib/anagrams.ex
defp all_subsets_longer_than_three_characters(word) do
word
|> String.codepoints()
|> Comb.subsets()
|> Stream.filter(fn subset -> length(subset) >= 3 end)
|> Stream.map(&List.to_string(&1))
end
اپراتور |>توی زبون Elixirبرای پایپلاین(pipeline) استفاده میشه. کاری که میکنه اینه که مقدار سمت چپش رو به عنوان اولین پارامتر فانکشن سمت راستش پاس میده، توی اکثر زبونها به شکل های مختلف این پایپ لاین رو داریم ممکنه حتی نحوه و سمت پاس دادنشون هم متفاوت باشه مثلا اپراتور پایپلاین توی زبونهایElm, F#, Swiftمثه همین Elixirهست، توی Clojure -> هست یا توی R به این شکل %>% ، بگذریم...
توی زبون Elixir این:
"vinyl" |> String.codepoints |> Comb.subsets()
از نظر نحوه اجرا و پاس دادن مقادیر به این معنیه:
Comb.subsets(String.codepoints("vinyl"))
معمولا جاهایی که از پایپ لاین استفاده میکنید یک تبدیل داده وجود داره.
حالا به مرحل 2 ام برنامه نگاه کنید ترکیب کلماتو به سیگنچر تبدیل میکنیم، بازم تبدیل داریم. به این شکل:
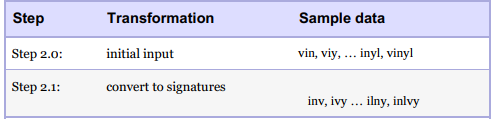
ادامه کدو بریم:
function-pipelines/anagrams/lib/anagrams.ex
defp as_unique_signatures(subsets) do
subsets
|> Stream.map(&Dictionary.signature_of/1)
end
حالا لیست سیگنچرها رو تبدیل میکنیم، هر سیگنچر یک لیست مپ شده از کلمه های ممکن رو نگهداری میکنه، یا ممکنه حتی nil نگهداری کنه به این معنی که کلمه ای باهاش مچ نمیشه که البته بعدش نالها رو حذف و لیستو فلت میکنیم:
function-pipelines/anagrams/lib/anagrams.ex
defp find_in_dictionary(signatures) do
signatures
|> Stream.map(&Dictionary.lookup_by_signature/1)
|> Stream.reject(&is_nil/1)
|> Stream.concat(&(&1))
end
مرحله 4، گروه بندی کردن کلمات براساس طولشون، یک تبدیل ساده است که داریم. و همچنین کانورت لیست مون به مپ به صورتی که کلید این مپ میشه طول رشته و ولیوش میشه خوده کلمه:
function-pipelines/anagrams/lib/anagrams.ex
defp group_by_length(words) do
words
|> Enum.sort()
|> Enum.group_by(&String.length/1)
end
** نکته: ممکنه زبون برنامه نویسی که استفاده میکنید پایپ لاین نداشته باشه، اصن مهم نیست، تبدیل داده در برنامه نویسی یک فلسفه است، حالا اگر ابزار پایپ لاین هم در اختیارتون نباشه، کدو مثل زیر مینویسید سه خط دستور جدا:
const content = File.read(file_name);
const lines = find_matching_lines(content, pattern)
const result = truncate_lines(lines)
خوب ما همه تبدیل ها رو جدا جدا نوشتیم، وقتشه که همه رو سرجمع کنیم توی یک تابع و بدنه اصلی رو بنویسیم:
function-pipelines/anagrams/lib/anagrams.ex
def anagrams_in(word) do
word
|> all_subsets_longer_than_three_characters()
|> as_unique_signatures()
|> find_in_dictionary()
|> group_by_length()
end
ی اجرا بگیریم ازش:
iex(1)> Anagrams.anagrams_in "lyvin"
%{
3 => ["ivy", "lin", "nil", "yin"],
4 => ["inly", "liny", "viny"],
5 => ["vinyl"]
}
عالیه. به تابع اصلی که نگاه کنید(anagrams_in) یک زنجیره ای از تبدیل ها رو میبینید که طبق براورده شدن خاسته مون پیش میره، هر کدوم ورودی شونو از تبدیل قبل و خروجی شونو به تابع بعدی میدن. خیلی ام خوانا و روتینه.
اما یک نکته عمیق تری وجود داره، اگر با برنامه نویسی شی گرا آشنا باشید، نسبت به مخفی کردن دیتاها داخل آبجکت ها عکس العمل نشون میدید، و در نهایت یکسری آبجکت داریم که با آبجکت قبل و بعدشون پچ پچ میکنن و استیت همو تغییر میدن. این وابستگی(coupling) زیادی رو بوجود میاره. برای همینه که تغییر در سیستم های شی گرا خیلی سخت تره.
در مدل برنامه نویسی transformationalبجای اینکه داده ها رو توی pool های پخش شده در سیستم نگهداری کنیم، داده ها رو مثل رودخونه جریان میدیم، کد -> دیتا -> کد -> دیتا
دیتا به یک تابع خاص اختصاص نداره، بلکه توابع ورودی رو به خروجی تبدیل و به تابع بعدی میدن. این تا حد زیادی به کاهش وابستگی کمک میکنه، یک تابع فقط وقتی میتونه استفاده و استفاده مجدد بشه که ورودی و خروجیش با اون مکان استفاده مچ بشه. درسته هنوز حدی از وابستگی وجود داره ولی نسبت به تجربه ای که روی شی گرایی داشتیم، درجه وابستگی خیلی کمتره.
· مدیریت خطاها رو چه کنیم؟
خوب تبدیلهایی که نوشتیم درست کار کرد توی دنیایی که همه چی ایده ال و روبه راهه، چجوری توی دنیای واقعی ببریمش زیر بار؟ فکر کنید، وقتی زنجیره ای رو تشکیل دادیم، حالا میخایم خطایی رو در چک های منطقی کد پیدا کنیم.
راه های مختلفی وجود داره، که همشون بر یک چیز تکیه می کنند: ما هیچ وقت دیتای خام پاس نمیدیم بین تبدیلها. در عوض دیتا رو توی قالب دیتا استراکچرها یا تایپها wrapمیکنیم که خیلی راحت valid بودنشون رو هم چک میکنیم. توی زبون Hasekllاین رپر maybeهست یا توی F# و Scala، optionهست. در اینجا دو راه توی کدنویسی پیش رو داریم، میتونیم چک کردن برای خطاها رو داخل تبدیل ها ببریم یا خارج اونها.
- اول یک Representationانتخاب کنید
برای رپرمون یک representationمیخایم، مثلا میتونیم یک struct برای داده مون بنویسیم یا زبون Elixirیک چیز قشنگ تر داره، اینکه تابع ها میتونن به عنوان خروجی یک tupleشامل
{:ok, value}
یا
{:error, reason}
برگردونن. مثلا تابع File.Openمیتونه یکی از این دو رو برگردونه یا خطا میده یام درست انجام میده که اوکی میده. توی نمونه کد ذیل ما از tuple ذکر شده بالا به عنوان رپر برای پاس دادن دیتا در پایپ لاین استفاده میکنیم:
iex(1)> File.open("/etc/passwd")
{:ok, #PID<0.109.0>}
iex(2)> File.open("/etc/wombat")
{:error, :enoent}
- خطا رو داخل هر تبدیل هندل کنید
فرض کنید یک تابع میخایم بنویسیم که توی یک فایل خطوطی که با پترن خاصی مچ میشن رو برگردونه و بعد 20 کاراکتر اول رو ترانکیت کنه، این کد زیرو میزنیم:
def find_all(file_name, pattern) do
File.read(file_name)
|> find_matching_lines(pattern)
|> truncate_lines()
end
خوب توی این تابع هیچ مدیریت خطایی نکردیم، اگر یک استپ توی پایپ لاین خطا برگردونه، هندلش نکردیم. کد زیر میشه همین تابع با مدیریت خطاها:
defp find_matching_lines({:ok, content}, pattern) do
content
|> String.split(~r/\n/)
|> Enum.filter(&String.match?(&1, pattern))
|> ok_unless_empty()
end
defp find_matching_lines(error, _), do: error
# ----------
defp truncate_lines({ :ok, lines }) do
lines
|> Enum.map(&String.slice(&1, 0, 20))
|> ok()
end
defp truncate_lines(error), do: error
# ----------
defp ok_unless_empty([]), do: error("nothing found")
defp ok_unless_empty(result), do: ok(result)
defp ok(result), do: { :ok, result }
defp error(reason), do: { :error, reason }
- یا اینکه خطا رو توی پایپ لاین هندل کنید
برای اینکار نیاز داریم function ها رو به function values تبدیل کنیم.
defmodule Grep1 do
def and_then({ :ok, value }, func), do: func.(value)
def and_then(anything_else, _func), do: anything_else
def find_all(file_name, pattern) do
File.read(file_name)
|> and_then(&find_matching_lines(&1, pattern))
|> and_then(&truncate_lines(&1))
end
defp find_matching_lines(content, pattern) do
content
|> String.split(~r/\n/)
|> Enum.filter(&String.match?(&1, pattern))
|> ok_unless_empty()
end
defp truncate_lines(lines) do
lines
|> Enum.map(&String.slice(&1, 0, 20))
|> ok()
end
defp ok_unless_empty([]), do: error("nothing found")
defp ok_unless_empty(result), do: ok(result)
defp ok(result), do: { :ok, result }
defp error(reason), do: { :error, reason }
end
تابع and_then یک مثال از bind functionهست که یک ولیو رپ شده میگیره، و اونو به خورد یک فانکشن میده، و خروجی یک رپ ولیو دیگه میده.
** فکر کردن به کد به شکل سریالی از تبدیلها میتونه رویکرد آزادسازی توی برنامه نویسی بوجود بیاره. مدتی زمان میبره تا بهش عادت کنید، اما اگر استفادش کنید به کد کلین تری میرسید، توابع کوتاه تر، و دیزاین فلت تر.
امتحانش کنید.
دروس مرتبط: 8, 17, 26, 28, 35
منبع کانال تلگرامی: https://t.me/pragmaticprogrammer_fa

