چند هفته اخیر مشغول انجام پروژه Data Analyst و Data Science بودم که پروژه پایانی دوره آموزشی بوت کمپ دیتا بود. این دوره شامل بخشهای Data Analyst و Data Engineering و Data Science بود و توسط آکادمی دیجینکست در بازه زمانی مرداد تا آبان 1402 برگزار شد.
سعی کردم در این گزارش کارهایی که در مسیر حل این مسئله انجام دادم رو با همراه جزئیات بنویسم.
دیتایی که در اختیار داریم شامل آگهیهای فروش مسکن تهران در یک ماه از سال 2021 و یک ماه از سال 2023 هست که پلتفرم دیوار منتشر شدن. میخوایم بدانیم اگر قصد سرمایه گذاری داشته باشیم با خرید آپارتمان در چه منطقهای از تهران، سود بیشتری دریافت خواهیم کرد.
دیتاست سال 2021 و 2023 از نظر محتوا و فرمت متفاوت هستند.
دیتای 2021 به فرمت json هست و شامل اطلاعات همه املاک(فروش، اجاره، آپارتمان، تجاری، صنعتی و ..) میباشد و شامل این ستونها زیر هست:
-محله(district): محله آگهی موردنظر است مانند یوسف آباد، شهران و ...
-آیدی مخصوص هم آگهی(token)
-نوع آگهی(sub_category): مثل فروش آپارتمان، اجاره واحد تجاری و ...
-تجاری یا مسکونی بودن آگهی(category)
-نوع آگهی دهنده(business_type): آگهی توسط اشخاص معمولی گذاشته شده یا توسط آژانس املاک
-قیمت(price)
-رهن(credit)
-اجاره(rent)
-عنوان آگهی(title)
-موقعیت مکانی(location): شامل موقعیت مکانی حدودی آگهی(latitude, longtitude)
-مساحت(area)
-سال ساخت(year)
-تعداد اتاق(room)
-داشتن/نداشتن انباری(storage)
-داشتن یا نداشتن پارکینگ(parking)
-داشتن یا نداشتن(آسانسور)
-طبقه واحد آگهی شده(floor)
دیتا سال 2023 به فرمت CSV بوده و فقط شامل آگهیهای فروش آپارتمان است و شامل ستونهای زیر است:
Area,Construction,Room,Warehouse,Parking,Elevator,Address,Price
-قیمت به صورت عددی نمیباشد و به همراه واحد پول آورده شده است(مثلا: ۱۹۷۰۰۰۰۰۰۰۰ تومان) و همچنین
-در این دیتاست محله به صورت مستقیم داده نشده است و در ستون Address میباشد.(مثلا: ۱ ساعت پیش در تهران، درکه)
دیتاست مناطق 22 گانه و محلات تهران شامل دو ستون محله و منطقه که مشخص میکند هر محله در کدام منطقه 22 گانه قرار دارد.(این دیتاست جز ورودیهای اصلی مسئله نبوده و توسط خودم ساخته شده است! این دیتا برای محلات مشترک میان دیتا 2021 و 2023 میباشد.) هدف از ایجاد این دیتاست یادگیری محلات نزدیک به یکدیگر توسط مدلهای ماشین لرنینگ است. بدون وجود این دیتا محلات مختلف ارتباطی به یکدیگر نخواهند داشت.
1- یکسان کردن اطلاعات موجود در هر دو دیتاست به صورت CSV و یکسان سازی ستونها و مقادیر معتبر برای ستون یا feature
2- گزارش EDA از فیچرهای مختلف و تأثیرشون روی افزایش قیمت با در نظر گرفتن ثابت بودن بقیه فیچرها
3- مدل رگرسیون مناسب برای تخمین رشد قیمت آپارتمانها و تحلیل خطا براساس متریک، دیتاست Train و Test انتخابی
4- دسته بندی آپارتمانها براساس براساس میزان رشد قیمت در ماکزیمم 30 کلاس مختلف
5- فیت کردن مدل رگرشن مناسب در هر کلاس از آپارتمانها که در مرحله قبل ساختید و تحلیل خطا بر اساس این مدل رگرسیون جدید
6- ارائه مراحل پروژه و پیاده سازی و نمودارها با storytelling مناسب
7- براساس آگهی اجاره آپارتمان در دیتاست 2021 به صرفه بودن اجاره در محلههای مختلف را بررسی کنید.
این پروژه کاملا با زبان پایتون انجام شده است و از packageهای مورد استفاده عبارتند از:
Numpy, Pandas, Sklearn, Pycaret, Sweetviz, Seaborn, Plotly, Matplotlib, Re
مرحله اول: ورود اطلاعات
در این بخش اطلاعات به کمک پکیج پانداس و توابع read_csv و read_json و read_excel خوانده شدند.
مرحله دوم-تمیزسازی دیتا ورودی
مهمترین بخش و زمانگیرترین بخش پروژه احتمالا تمیزسازی داده اولیه میباشد. داده ورودی به دلیل آنکه مربوط به آگهی میباشد و توسط افراد تکمیل میشود کاملا غیر تمیز میباشد. در زیر مراحل تمیزسازی داده گفته میشود. مراحل مشترک برای دیتاست 2021 و 2023 برای جلوگیری از تکراری شدن مطلب گفته نمیشود.
دیتاست 2023:
دیتاست 2021:
بررسی محله آگهیها:
دیتا فریم 2021 شامل 360 محله و دیتا فریم 2023 شامل 337 محله میباشد. تعدادی از محلات در دیتا 2021 که شامل محلات شهرهای اطراف تهران است که در دیتا 2023 آگهی این محلات آورده نشده است. و در نتیجه امکان مقایسه این محلات در طی این 2 سال وجود نخواهد داشت.
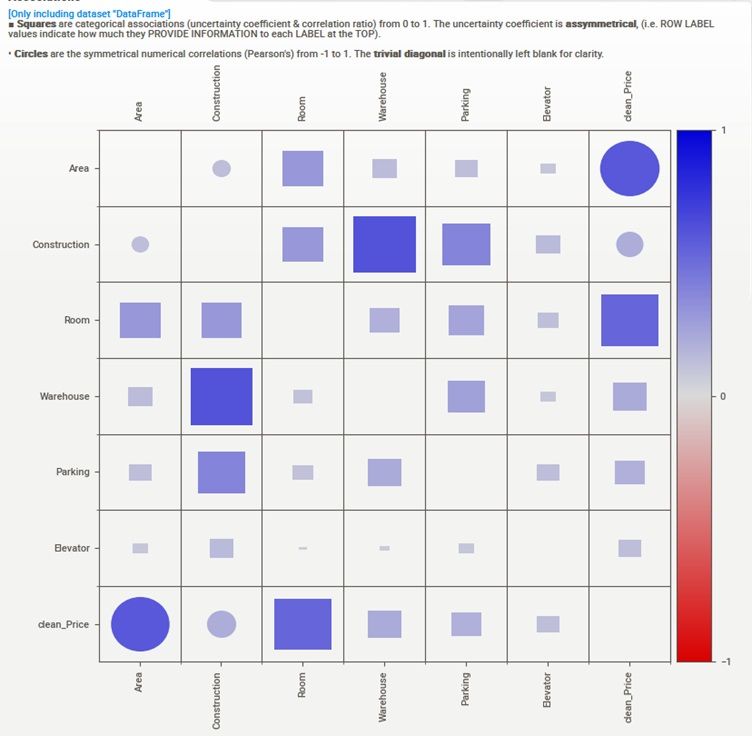
پس از تمیزسازیهای گفته شده به کمک پکیج sweetviz گزارش EDA استخراج میشود. نحوه توزیع دیتا و ارتباط(correlation) بین فیچرهای مختلف را میتوانیم مشاهده کنیم.(خیلی از تمیزسازیهایی که در بالا انجام شده است به کمک این اطلاعات بودهاست.)
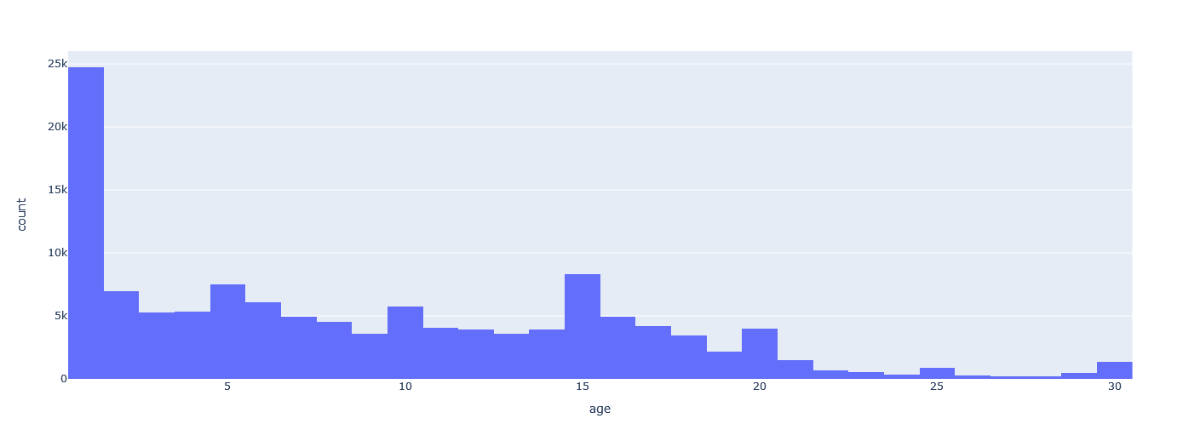
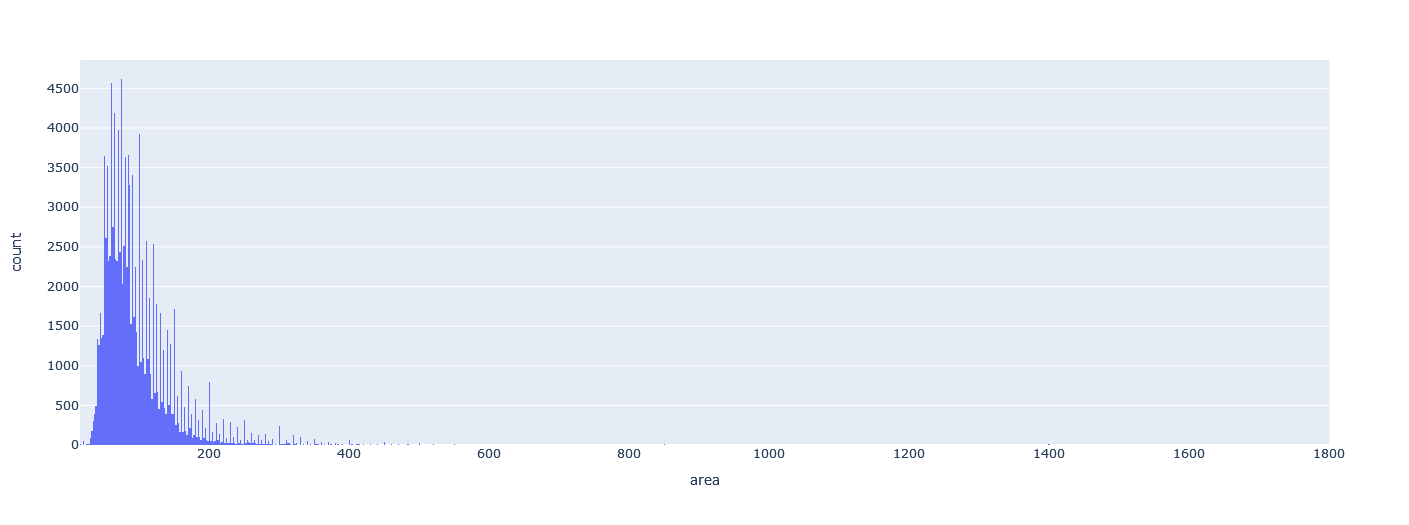
نمونهای از نمودارهای استفاده شده در زیر آمده است.
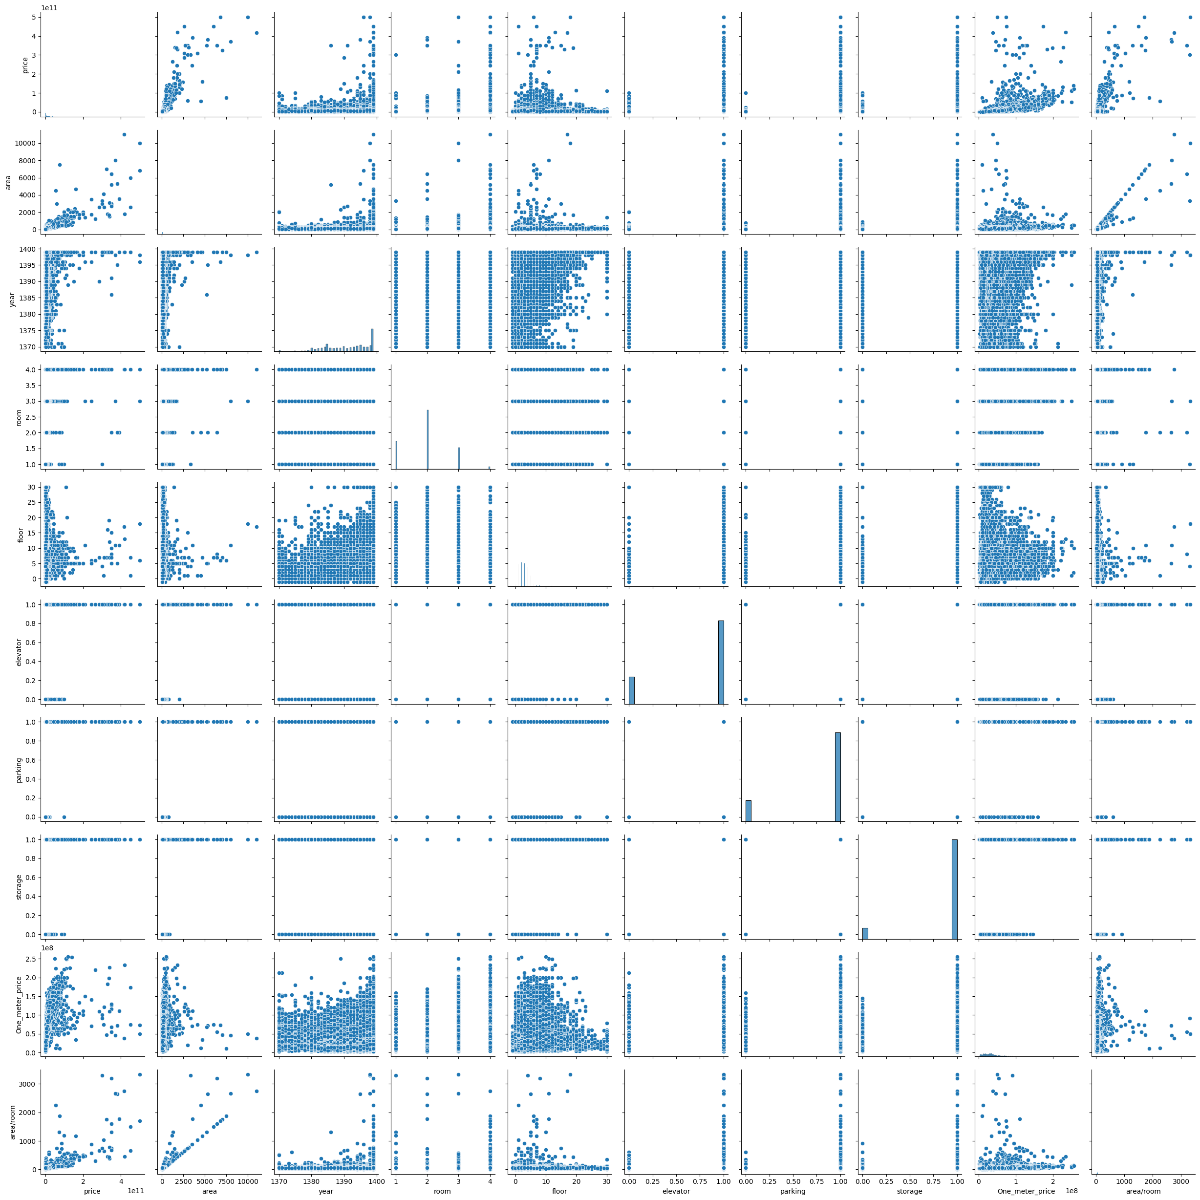
همچنین برای تشخیص ارتباط میان فیچرهای مختلف از نمودار pairplot پکیج seaborn استفاده شده است که در زیر آورده شده.
همچنین کوریلیشن میان فیچرها مختلف داده با یکدیگر نیز به کمک sweetviz استخراج شده، این نمودار کوریلیشن تمام ستونها با یکدیگر را نمایش میدهد. بخش مهم برای ما correlation میان فیچرها مختلف با قیمت است.
مرحله سوم-حل سوالات:
برای حل سوالات به دو روش کلی میتوان عمل کرد. 1-میتوان سوالات را به صورت کامل با روشهای دیتا آنالیز و بدون مدل ماشین لرنینگ حل کرد و 2-میتوان برای پیش بینی قیمت و دسته بندی دادهها از مدلهای ماشین لرنینگ کمک گرفت. در روند حل تقریبا هر دو روش برای حل سوال استفاده شده است که در ادامه به توضیح این روشها خواهیم پرداخت.
حل به کمک روشهای دیتا آنالیز(روش1):
در این بخش ما میخواهیم متناسب با سطوح مختلف بودجه بگوییم در چه محلاتی میتوانیم سرمایه گذاری کنیم و احتمالا چه میزان بازدهی خواهیم داشت.به این منظور چون دیتا محلات را در هر دو سال داریم و نیازی به پیش بینی قیمت نیست. در مرحله اول تنها ویژگیهای متوسط قیمت و متوسط قیمت هر متر در محلههای مختلف را در 2021 و 2023 به کمک گروه بندی روی محلات محاسبه میکنیم و با merge کردن جدولها میتوانیم میزان رشد قیمت در محلات مختلف را محاسبه کنیم.
برای دستهبندی مناطق مختلف نیز در این مرحله تنها با دو ویژگی قیمت متوسط محله(به عنوان بودجه) و درصد رشد اطلاعات را دسته بندی میکنیم. در این دستهبندی از اکثر فیچرها صرف نظر شده است اما درک آن آسان است و برای گام اول میتوان مسیر حل سوال را تعیین کند. همچنین به کمک روش elbow تعداد کلاسترها را تعیین میکنیم.
در مرحله دوم: برای دسته بندی بهتر آگهیها را با ستون متراژ(کوچک-نسبتا کوچک-متوسط-بزرگ با بازه 15-60-100-180-...) و سن ساختمان(نوساز-عادی-نسبتا قدیمی-قدیمی با بازههای 0-3-9-16-...) به 4 دسته تقسیم میکنیم(binning). و گروه بندی را با 3 فیچر منطقه،رده سنی و سایز خانه انجام میدهیم و متوسط قیمت هر متر و متوسط قیمت خانهها را برای 2021 و 2023 محاسبه میکنیم. و با merge کردن جدول رشد هر گروه را مقایسه میکنیم. در نهایت با روش k-means میتوانیم کلاسترینگ را انجام دهیم.
مزیت این روش مقایسه بهتر خانههای مشابه یکدیگر در دو سال مختلف است.(خانههای همسایز در منطقه خاص با شرایط سنی نزدیک به همدیگر مقایسه میشوند و نتیجه نیز بر همین اساس خواهد بود.)
در bucket کردن دیتا سعی میکنیم مرزها به گونهای انتخاب شوند که تعداد آگهیهای موجود در هر دسته نزدیک به یکدیگر باشند.(توزیع داده در سال 2021 و 2023 متفاوت میباشد و بازههایی در دو سال انتخاب شدهاند که معنیدار باشند.)
نکته: برای کلاسترنیگ بهتر است قبل از اجرای مدل اعداد اسکیل(scale) شوند.
برای تعیین بهترین محل برای اجاره، تمام آگهیهای اجاره آپارتمان که در مراحل قبل استخراج شده است را با تبدیل رهن و اجاره به رهن کامل تبدیل میکنیم(نرخ تبدیل رهن به اجاره 3 درصد در نظر گرفته شده است). و متوسط قیمت هر متر خانه در محلات مختلف را با رهن هر متر خانه مقایسه میکنیم. در نتیجه هر محلهای که پایینترین نسبت رهن به خرید را داشته باشد بهترین محله برای اجاره خواهد بود.(میتوان دسته بندی خانهها براساس سن بنا و متراژ را نیز در اینجا انجام داد)
حل به کمک روشهای ماشین لرنینگ(روش 2):
برای حل به کمک مدل ماشین لرنینگ، به دنبال مدلهایی هستیم که بتوانیم به کمک آنها افزایش قیمت آپارتمانها را در بازه سال 2021 و 2023 محاسبه کنیم. برای این کار از 3 روش مختلف میتوانیم استفاده کنیم، این سه روش توضیح داده میشود اما روش سوم به عنوان روش اصلی مورد استفاده قرار گرفته است.
نکته: در تمامی مدلهای ماشین لرنینگ از پیش بینی قیمت هر متر خانه(price/area) استفاده کردهایم. این فیچر درک بهتری برای بررسیهای آتی خواهد داشت و همچنین قابل تفسیرتر میباشد. همچنین دقت مدل نیز بهتر خواهد بود. و قیمت کل خانههای پیش بینی شده از حاصل ضرب قیمت هر متر(پیشبینی شده) در متراژ محاسبه شده است.
1-ترکیب دو دیتاست 2021 و 2023 در این روش ابتدا نام ستونها و فرمت اطلاعات دو دیتابیس را یکسان کرده و یک ستون سال که نشان دهنده سال آگهی میباشد به دیتاستها اضافه میکنیم و سپس هر دو دیتاست را با دستور concat ادغام میکنیم. در نهایت یک مدل رگرسیون خطی برای پیش بینی قیمت آپارتمانها خواهیم داشت.
ایراد اصلی این مدل ابهام در پیش بینی میزان رشد و همچنین ابهام در سنجش دقت میباشد و همچنین مدل دقت کمتری در این روش خواهد داشت. مهمترین عامل رشد قیمت در املاک تهران تورم(تغییر سال) میباشد و مدل مستقل دقت بهتری خواهد داشت.
2- دو مدل ML مجزا برروی دیتاستهای 2021 و 2023 اجرا کنیم و یک دیتاست شامل محلات مختلف تهران، دستهها مختلف قیمت، متراژ و سن ساختمان به هر دو مدل داده شود و قیمت پیش بینی شده توسط دو مدل مقایسه شود. اختلاف قیمت پیش بینی شده توسط دو مدل به عنوان درصد رشد گزارش میشود.
این روش نیز همانند روش قبل دقت کمتری خواهد داشت و نتایج آن مناسب مرحله clustering نیست.
*مدل رگرسیون دیتاست 2021 نسبت به مدل رگرسیون دیتاست 2023 دقت کمتری دارد.
3- در این روش یک مدل رگرسیون روی دیتاست 2023، train و بهینه میکنیم و دیتا سال 2021 که از نظر فرمت با دیتاست 2023 یکسان شده است را به عنوان ورودی به این مدل میدهیم تا قیمت آگهیهای 2021 را در 2023 پیش بینی کند. برای یافتن بهترین مدل رگرسیون پس از تمیزسازی دیتا به کمک پکیج Pycaret متدهای مختلف رگرسیون را بر روی دیتا بررسی میکنیم تا بهترین مدل را انتخاب کنیم.
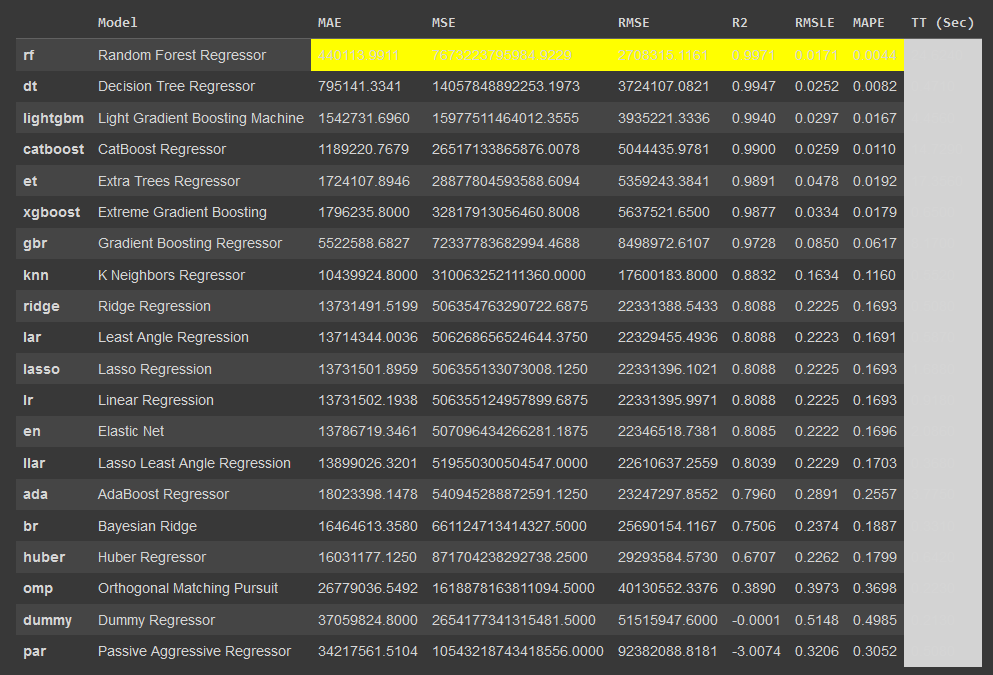
با چندین بار اجرای این مدلسازی میتوان متوجه شد استفاده از روش Random forest regressor بهترین مدل برای این مسئله میباشد.
دقت تصویر آورده شده به دلیل حضور ستون price در دیتا به صورت غیرمنطقی بالا میباشد که میتوان این اتفاق را به نوعی leakage در مدل برداشت کرد(تارگت قیمت هر متر میباشد).
با حذف ستون قیمت و تبدیل سال ساخت به سن بنا که عدد بامفهومتری نسبت به سال ساخت است، همچنین با اجرای Grid search برای hyper-parameter tuning مقادیر مختلف model__max_depth و model__n_estimators بررسی میشود. و در نهایت به ترتیب مقادیر None و 200 به دست میآید. دقت r2 در تست 84.7 و در train، 93 خواهد بود.
همچنین باید دقت کنیم در محاسبه سن بنا دیتاست 2021 توسط مدل ایجاد شده روی دیتا 2023 باید سن ساختمان را 2 سال افزایش دهیم.
برای تعیین نزدیک بودن محلات مختلف نسبت به یکدیگر دیتا مناطق 22 گانه مختلف تهران را به صورت یک ستون به تمام آگهیها در دیتاست 2021 و 2023 اضافه میکنیم و مناطق خارج از شهر را به عنوان منطقه 25 فرض میکنیم. و در نهایت ستون محله و مناطق 22گانه را به دلیل نبود ترتیب و اولویت در آن به صورت One-hot انکود میکنیم.
در نهایت قیمت هر متر خانه برای آگهیهای 2021 محاسبه شده و میتوانیم قیمت کل خانه(پیشبینی)، و میزان رشد را محاسبه کنیم. برای مقایسه دقت مدل میتوانیم نتایج حاصل مدل ماشین لرنینگ و دیتا انالیز را مقایسه کنیم.
*در اجرای مدل
کلاسترینگ(دستهبندی) آگهیها براساس میزان رشد
حل این سوال را در دو مرحله انجام میدهیم. 1-دسته بندی آگهیها با دو شاخص قیمت در 2021 و میزان رشد. 2-دسته بندی با شاخصهای قیمت در 2021، میزان رشد، سایز خانه(کوچک-بزرگ-متوسط و ...) و سن خانه(نوساز، قدیمی و...).
به کمک دستهبندی آگهیها، میخواهیم بدانیم با سطوح مختلف بودجه در چه مناطقی از تهران، خانهای بخریم تا سود بیشتری داشته باشیم. نتایج حاصل از مدلماشین لرنینگ را در ستونهای سن بنا و متراژ به 4 دسته تقسیم میکنیم، و برروی ستونهای قیمت اولیه و میزان رشد کلاسترینگ را با روشk-means اجرا میکنیم.(روش DBSCAN نیز اجرا شده است.) نتایج حاصل به صورت زیر خواهد بود.
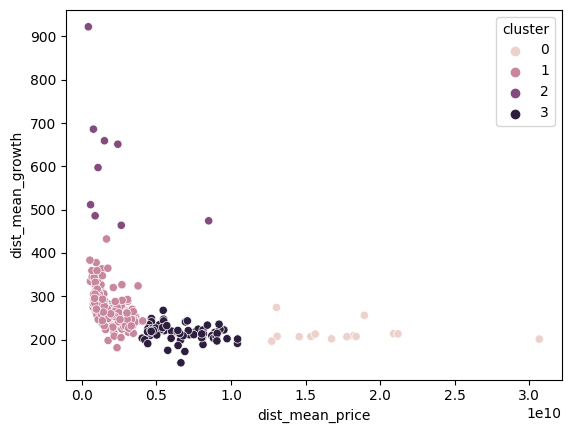
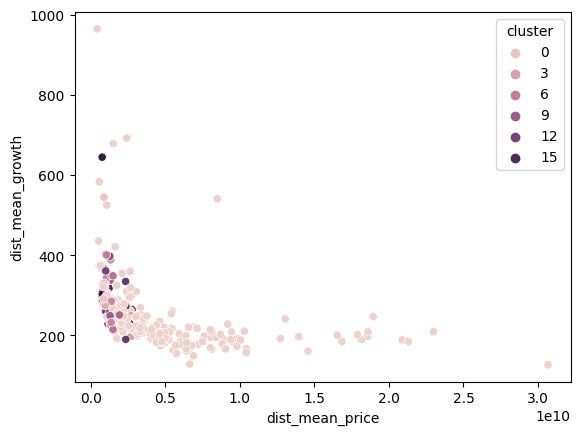
پس از scale کردن دیتا ورودی نتیجه کلاسترینگ بهتر شده است زیرا order اعداد با یکدیگر تفاوت خیلی زیادی دارد.
به صورت کلی مراحل انجام پروژه چندین بار به صورت loop طی شده است و با مشاهده نتایج، متوجه وجود anomaly و outlier و خطا در مدل سازی و ... شدهایم و مجدد این چرخه طی شده است. و بسیاری از تمیزسازیهای گفته شده حاصل این گردش در مراحل مختلف میباشد. با این وجود در نتایج نهایی همچنان اعداد غیرمنطقی مشاهده میشود که احتمالا به دلیل تمیز نشدن کامل دیتا اولیه میباشد.
در زیر به چند مورد از این نتایج اشاره میکنیم:
محله با بیشترین رشد قیمت(ML): خانههای نوساز نسبتا بزرگ در محله حصارک با 1250 درصد رشد
محله با بیشترین رشد قیمت(Data analysis): خانههای قدیمی نسبت بزرگ در محله مسعودیه با 650 درصد رشد
به صرفهترین محله برای اجاره: حصار بوعلی در منطقه 1 با حدود 7 درصد از قیمت خرید آپارتمان
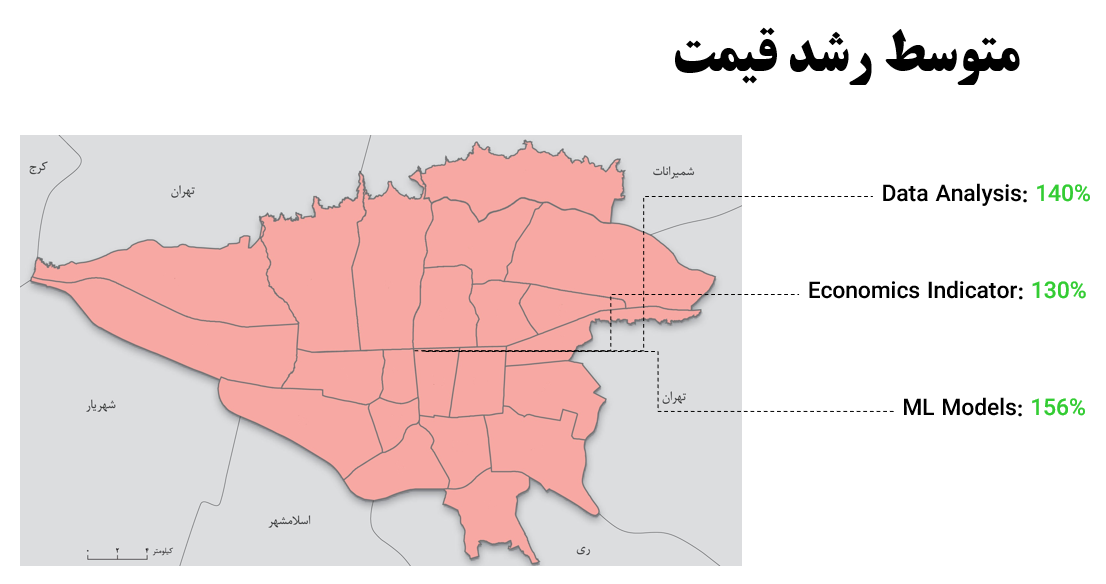
احتمالا هر سه مورد ذکر شده غیر واقعی هستند ولی میزان رشد محاسبه شده املاک در تهران در طی این دو سال نزدیک به رقم گزارش شده در گزارشهای اقتصادی میباشد.
در ادامه تعدادی از گزارشهای تجمیعی آماده شده آورده شدهاست.