
هموارسازی با میانگین متحرک (Moving Average Smoothing) یک تکنیک ساده و مؤثر برای پیشبینی سریهای زمانی است.
از این روش میتوان برای آمادهسازی دادهها (Data Preparation)، مهندسی ویژگی (Feature Engineering) و حتی پیشبینی مستقیم مقادیر آینده استفاده کرد.
در این آموزش یاد میگیرید که چگونه از هموارسازی میانگین متحرک برای پیشبینی سریهای زمانی با استفاده از پایتون استفاده کنید.
پس از پایان این آموزش، با موارد زیر آشنا خواهید شد:
نحوه عملکرد هموارسازی میانگین متحرک و پیشفرضهای لازم درباره دادهها پیش از استفاده از این روش.
نحوه استفاده از هموارسازی میانگین متحرک برای آمادهسازی دادهها و مهندسی ویژگی.
نحوه استفاده از هموارسازی میانگین متحرک برای انجام پیشبینی.
بیایید شروع کنیم.
هموارسازی (Smoothing) تکنیکی است که روی دادههای سری زمانی اعمال میشود تا تغییرات جزئی و کوتاهمدت بین گامهای زمانی کاهش یابد.
هدف از هموارسازی، حذف نویز (Noise) و آشکارتر کردن سیگنال مربوط به فرایندهای علّی زیربنایی دادهها است.
میانگین متحرک یکی از سادهترین و رایجترین روشهای هموارسازی است که در تحلیل سریهای زمانی و پیشبینی آنها استفاده میشود.
محاسبه میانگین متحرک شامل ایجاد یک سری زمانی جدید است که مقادیر آن از میانگین مشاهدات خام سری زمانی اصلی تشکیل شدهاند.
برای محاسبه میانگین متحرک باید اندازه یک پنجره، با عنوان عرض پنجره (Window Width)، مشخص شود. این اندازه تعیین میکند که چند مشاهده خام برای محاسبه هر مقدار میانگین متحرک استفاده شود.
واژه «متحرک» در میانگین متحرک به این موضوع اشاره دارد که پنجره تعریفشده در طول سری زمانی حرکت میکند و در هر موقعیت، میانگین جدیدی برای سری زمانی محاسبه میشود.
دو نوع اصلی میانگین متحرک وجود دارد:
میانگین متحرک مرکزی (Centered Moving Average)
میانگین متحرک دنبالهدار (Trailing Moving Average)
در این روش، مقدار میانگین متحرک در زمان (t) با استفاده از میانگین مشاهدات قبل، در همان زمان و بعد از زمان (t) محاسبه میشود.
برای مثال، میانگین متحرک مرکزی با اندازه پنجره ۳ بهصورت زیر محاسبه میشود:
center_ma(t) = mean(obs(t-1), obs(t), obs(t+1))
این روش به دانستن مقادیر آینده نیاز دارد. بنابراین، معمولاً در تحلیل سریهای زمانی برای درک بهتر ساختار مجموعه داده استفاده میشود.
میانگین متحرک مرکزی میتواند بهعنوان روشی عمومی برای حذف مؤلفههای روند و فصلی از سری زمانی استفاده شود؛ روشی که در بسیاری از مسائل پیشبینی نمیتوانیم از آن استفاده کنیم.
در این روش، مقدار میانگین متحرک در زمان (t) با استفاده از میانگین مشاهدات زمان (t) و زمانهای قبل از آن محاسبه میشود.
برای مثال، میانگین متحرک دنبالهدار با اندازه پنجره ۳ بهصورت زیر محاسبه میشود:
trail_ma(t) = mean(obs(t-2), obs(t-1), obs(t))
میانگین متحرک دنبالهدار فقط از مشاهدات تاریخی استفاده میکند و در پیشبینی سریهای زمانی کاربرد دارد.
در این آموزش، تمرکز ما بر همین نوع میانگین متحرک خواهد بود.
محاسبه میانگین متحرک برای یک سری زمانی مستلزم در نظر گرفتن برخی فرضها درباره دادهها است.
فرض میشود که مؤلفههای روند (Trend) و فصلی (Seasonality) از سری زمانی حذف شدهاند.
این بدان معناست که سری زمانی شما ایستا (Stationary) است؛ یعنی روند مشخصی مانند افزایش یا کاهش بلندمدت یا الگوی فصلی آشکاری مانند ساختار تکرارشونده دورهای ندارد.
روشهای مختلفی برای حذف روند و فصلی بودن از یک مجموعه داده سری زمانی هنگام پیشبینی وجود دارد.
دو روش مناسب برای این کار عبارتاند از:
استفاده از روش تفاضلگیری (Differencing).
مدلسازی رفتار روند یا فصلی بودن و کمکردن صریح آن از سری زمانی.
مقادیر میانگین متحرک را میتوان به روشهای مختلفی هنگام استفاده از الگوریتمهای یادگیری ماشین برای مسائل سری زمانی به کار گرفت.
در این آموزش بررسی میکنیم که چگونه میتوان مقادیر میانگین متحرک دنبالهدار را برای آمادهسازی دادهها، مهندسی ویژگی و پیشبینی مستقیم محاسبه کرد.
پیش از ورود به این مثالها، ابتدا مجموعه داده تولد روزانه نوزادان دختر را بررسی میکنیم که در تمام مثالها از آن استفاده خواهیم کرد.
این مجموعه داده تعداد تولدهای روزانه نوزادان دختر در کالیفرنیا در سال ۱۹۵۹ را توصیف میکند.
واحد اندازهگیری آن تعداد تولد است و شامل ۳۶۵ مشاهده میشود. منبع این مجموعه داده به نیوتن (۱۹۸۸) نسبت داده شده است.
در ادامه، نمونهای از پنج ردیف نخست دادهها نمایش داده شده است:
"Date","Births"
"1959-01-01",35
"1959-01-02",32
"1959-01-03",30
"1959-01-04",31
"1959-01-05",44
در تصویر زیر، نمودار کل مجموعه داده نمایش داده شده است.
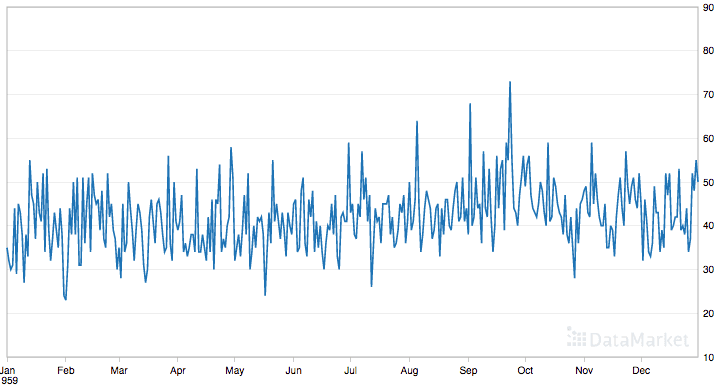
این مجموعه داده مثال مناسبی برای بررسی روش میانگین متحرک است؛ زیرا هیچ روند یا الگوی فصلی مشخصی در آن مشاهده نمیشود.
مجموعه داده را دانلود کنید و با نام daily-total-female-births.csv در پوشه کاری فعلی قرار دهید.
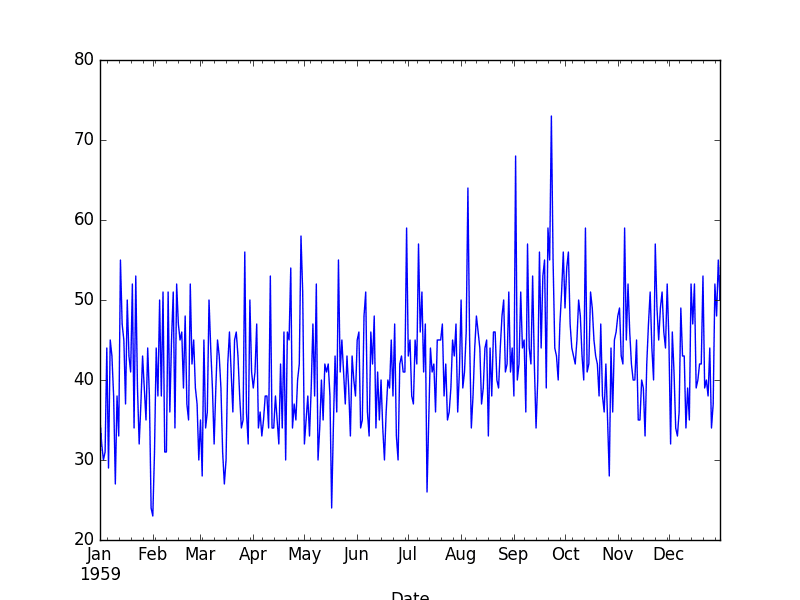
قطعه کد زیر مجموعه داده را بهعنوان یک سری از دادهها بارگذاری میکند، پنج ردیف نخست را نمایش میدهد و سپس کل سری زمانی را به شکل نمودار خطی رسم میکند.
from pandas import read_csv
from matplotlib import pyplot
series = read_csv('daily-total-female-births.csv', header=0, index_col=0)
print(series.head())
series.plot()
pyplot.show()
با اجرای این مثال، پنج ردیف نخست بهصورت زیر چاپ میشوند:
Date
1959-01-01 35
1959-01-02 32
1959-01-03 30
1959-01-04 31
1959-01-05 44
میانگین متحرک میتواند بهعنوان یک تکنیک آمادهسازی دادهها برای ایجاد نسخهای هموارشده از مجموعه داده اصلی استفاده شود.
هموارسازی بهعنوان یک روش آمادهسازی دادهها مفید است؛ زیرا میتواند تغییرات تصادفی در مشاهدات را کاهش دهد و ساختار فرایندهای علّی زیربنایی را بهتر آشکار کند.
تابع ()rolling در شیء Series کتابخانه Pandas، مشاهدات را بهصورت خودکار در پنجرههای مشخص گروهبندی میکند. شما میتوانید اندازه پنجره را تعیین کنید. بهصورت پیشفرض، یک پنجره دنبالهدار ایجاد میشود. پس از ایجاد پنجره، میتوانیم میانگین مقادیر داخل آن را محاسبه کنیم. نتیجه، مجموعه داده تبدیلشده ما خواهد بود.
مشاهدات جدید در آینده نیز بهسادگی قابل تبدیل هستند؛ کافی است مقادیر خام چند مشاهده اخیر را نگه داریم و مقدار میانگین جدید را محاسبه کنیم.
برای روشنتر شدن موضوع، با اندازه پنجره ۳، مقدار تبدیلشده در زمان(t) از میانگین سه مشاهده اخیر، یعنی (t-2)، (t-1) و (t)، محاسبه میشود:
obs(t) = 1/3 * (t-2 + t-1 + t)
برای مجموعه داده تولد روزانه نوزادان دختر، اولین میانگین متحرک مربوط به سوم ژانویه خواهد بود:
obs(t) = 1/3 * (t-2 + t-1 + t)
obs(t) = 1/3 * (35 + 32 + 30)
obs(t) = 32.333
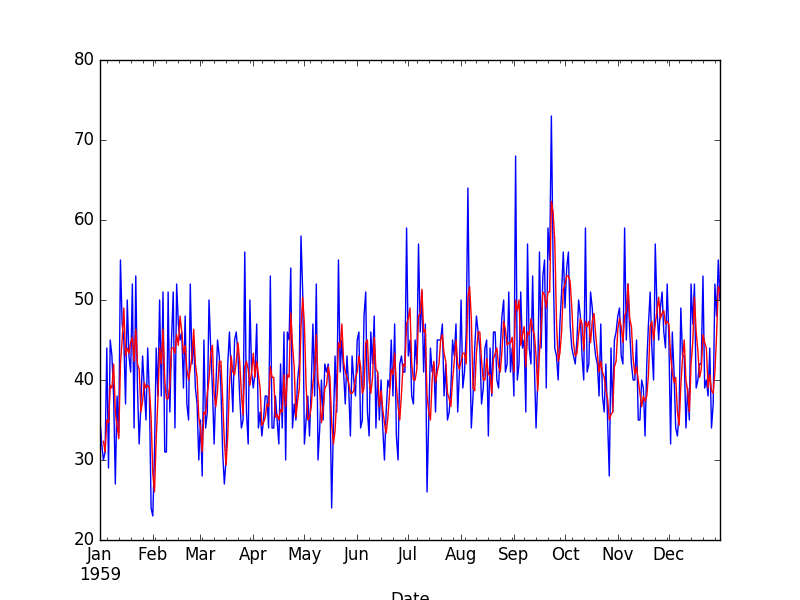
در ادامه، مثالی از تبدیل مجموعه داده تولد روزانه نوزادان دختر به میانگین متحرک با اندازه پنجره ۳ روز ارائه شده است. این اندازه پنجره بهصورت دلخواه انتخاب شده است.
from pandas import read_csv
from matplotlib import pyplot
series = read_csv('daily-total-female-births.csv', header=0, index_col=0)
# Tail-rolling average transform
rolling = series.rolling(window=3)
rolling_mean = rolling.mean()
print(rolling_mean.head(10))
# plot original and transformed dataset
series.plot()
rolling_mean.plot(color='red')
pyplot.show()
اجرای این مثال، نخستین ۱۰ مشاهده از مجموعه داده تبدیلشده را چاپ میکند.
مشاهده میکنیم که دو مقدار نخست باید کنار گذاشته شوند.
Date
1959-01-01          NaN
1959-01-02          NaN
1959-01-03    32.333333
1959-01-04    31.000000
1959-01-05    35.000000
1959-01-06    34.666667
1959-01-07    39.333333
1959-01-08    39.000000
1959-01-09    42.000000
1959-01-10    36.000000
مشاهدات خام با رنگ آبی و دادههای تبدیلشده با میانگین متحرک با رنگ قرمز، روی یک نمودار رسم شدهاند.
برای درک بهتر اثر این تبدیل، میتوانیم روی ۱۰۰ مشاهده نخست بزرگنمایی کنیم و آنها را رسم کنیم.
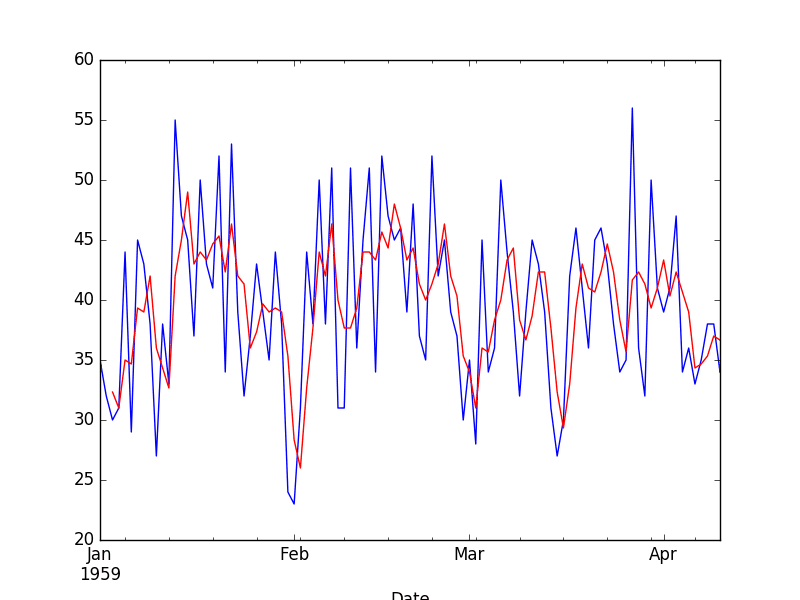
در این نمودار میتوانید تأخیر (Lag) موجود در مجموعه داده تبدیلشده را بهوضوح مشاهده کنید.
در ادامه، استفاده از میانگین متحرک بهعنوان روشی برای مهندسی ویژگی را بررسی میکنیم.
میانگین متحرک میتواند بهعنوان منبعی از اطلاعات جدید هنگام مدلسازی پیشبینی سری زمانی در قالب یک مسئله یادگیری نظارتشده (Supervised Learning) استفاده شود.
در این حالت، میانگین متحرک محاسبه شده و بهعنوان یک ویژگی ورودی جدید به دادهها اضافه میشود تا برای پیشبینی گام زمانی بعدی استفاده شود.
ابتدا باید یک نسخه از سری زمانی را بهاندازه یک گام زمانی به جلو جابهجا کنیم. این نسخه نشاندهنده ورودی مسئله پیشبینی ما خواهد بود، یعنی نسخهای از سری زمانی با تأخیر یک گام (Lag = 1). این روش، یک شیوه استاندارد برای تبدیل مسئله سری زمانی به مسئله یادگیری نظارتشده است. برای مثال:
X, 	y
NaN,	obs1
obs1,	obs2
obs2,	obs3
سپس باید نسخه دومی از سری زمانی ایجاد کنیم که بهاندازه یک واحد کمتر از اندازه پنجره به جلو جابهجا شود. هدف این کار آن است که اطمینان حاصل کنیم میانگین متحرک، چند مقدار قبلی را خلاصه میکند و مقدار موردنظر برای پیشبینی را در محاسبه میانگین وارد نمیکند. واردکردن مقداری که قرار است پیشبینی شود به ورودی مدل، باعث تعریف نادرست مسئله خواهد شد؛ زیرا در این صورت، ورودی مدل شامل اطلاعاتی از آینده خواهد بود که قصد پیشبینی آن را داریم.
برای مثال، با اندازه پنجره ۳، باید سری زمانی را بهاندازه ۲ گام زمانی جابهجا کنیم. دلیل این موضوع آن است که میخواهیم برای پیشبینی مقدار بعدی، دو مشاهده قبلی و مشاهده فعلی را در محاسبه میانگین متحرک لحاظ کنیم. سپس میتوانیم میانگین متحرک را از سری زمانی جابهجاشده محاسبه کنیم.
در ادامه مثالی از نحوه محاسبه پنج مقدار نخست میانگین متحرک ارائه شده است. به خاطر داشته باشید که مجموعه داده بهاندازه دو گام زمانی جابهجا شده است. همچنین با حرکت در طول سری زمانی، حداقل به سه گام زمانی نیاز داریم تا داده کافی برای محاسبه میانگین متحرک با پنجره ۳ وجود داشته باشد.
Observations,		Mean
NaN			NaN
NaN, NaN		NaN
NaN, NaN, 35		NaN
NaN, 35, 32		NaN
30, 32, 35		32
در ادامه، مثالی از اضافهکردن میانگین متحرک سه مقدار قبلی بهعنوان یک ویژگی جدید، همراه با ویژگی ورودی دارای یک گام تأخیر (Lag-1)، برای مجموعه داده تولد روزانه نوزادان دختر ارائه شده است.
from pandas import read_csv
from pandas import DataFrame
from pandas import concat
series = read_csv('daily-total-female-births.csv', header=0, index_col=0)
df = DataFrame(series.values)
width = 3
lag1 = df.shift(1)
lag3 = df.shift(width - 1)
window = lag3.rolling(window=width)
means = window.mean()
dataframe = concat([means, lag1, df], axis=1)
dataframe.columns = ['mean', 't-1', 't+1']
print(dataframe.head(10))
اجرای این مثال، مجموعه داده جدید را ایجاد کرده و ۱۰ ردیف نخست آن را چاپ میکند.
مشاهده میکنیم که سه ردیف نخست قابل استفاده نیستند و باید کنار گذاشته شوند. در نخستین ردیف مجموعه داده دارای تأخیر یک گام، هیچ مشاهده قبلی برای پیشبینی اولین مشاهده وجود ندارد؛ بنابراین از مقدار NaN استفاده میشود.
        mean   t-1  t+1
0        NaN   NaN   35
1        NaN  35.0   32
2        NaN  32.0   30
3        NaN  30.0   31
4  32.333333  31.0   44
5  31.000000  44.0   29
6  35.000000  29.0   45
7  34.666667  45.0   43
8  39.333333  43.0   38
9  39.000000  38.0   27
در بخش بعدی، نحوه استفاده از میانگین متحرک بهعنوان یک مدل ساده برای انجام پیشبینی را بررسی میکنیم.
از مقدار میانگین متحرک میتوان مستقیماً برای انجام پیشبینی استفاده کرد.
این روش یک مدل ساده (Naive Model) است و فرض میکند که مؤلفههای روند و فصلی سری زمانی از قبل حذف شدهاند یا اثر آنها تعدیل شده است. مدل میانگین متحرک برای پیشبینی را میتوان بهسادگی به روش پیشروی گامبهگام (Walk-Forward) استفاده کرد. با در دسترس قرار گرفتن مشاهدات جدید، مثلاً بهصورت روزانه، میتوان مدل را بهروزرسانی کرد و مقدار روز بعد را پیشبینی کرد.
میتوانیم این روش را بهصورت دستی در پایتون پیادهسازی کنیم. در ادامه، مثالی از استفاده مدل میانگین متحرک به روش پیشروی گامبهگام ارائه شده است.
from pandas import read_csv
from numpy import mean
from sklearn.metrics import mean_squared_error
from matplotlib import pyplot
series = read_csv('daily-total-female-births.csv', header=0, index_col=0)
# prepare situation
X = series.values
window = 3
history = [X[i] for i in range(window)]
test = [X[i] for i in range(window, len(X))]
predictions = list()
# walk forward over time steps in test
for t in range(len(test)):
	length = len(history)
	yhat = mean([history[i] for i in range(length-window,length)])
	obs = test[t]
	predictions.append(yhat)
	history.append(obs)
	print('predicted=%f, expected=%f' % (yhat, obs))
error = mean_squared_error(test, predictions)
print('Test MSE: %.3f' % error)
# plot
pyplot.plot(test)
pyplot.plot(predictions, color='red')
pyplot.show()
# zoom plot
pyplot.plot(test[0:100])
pyplot.plot(predictions[0:100], color='red')
pyplot.show()
اجرای این مثال، مقدار پیشبینیشده و مقدار واقعی مورد انتظار را در هر گام زمانی چاپ میکند. این فرایند از گام زمانی چهارم، یعنی تاریخ ۴ ژانویه ۱۹۵۹، آغاز میشود.
در پایان، مقدار میانگین مربعات خطا (Mean Squared Error – MSE) برای تمام پیشبینیهای انجامشده گزارش میشود.
predicted=32.333333, expected=31.000000
predicted=31.000000, expected=44.000000
predicted=35.000000, expected=29.000000
predicted=34.666667, expected=45.000000
predicted=39.333333, expected=43.000000
...
predicted=38.333333, expected=52.000000
predicted=41.000000, expected=48.000000
predicted=45.666667, expected=55.000000
predicted=51.666667, expected=50.000000
Test MSE: 61.379
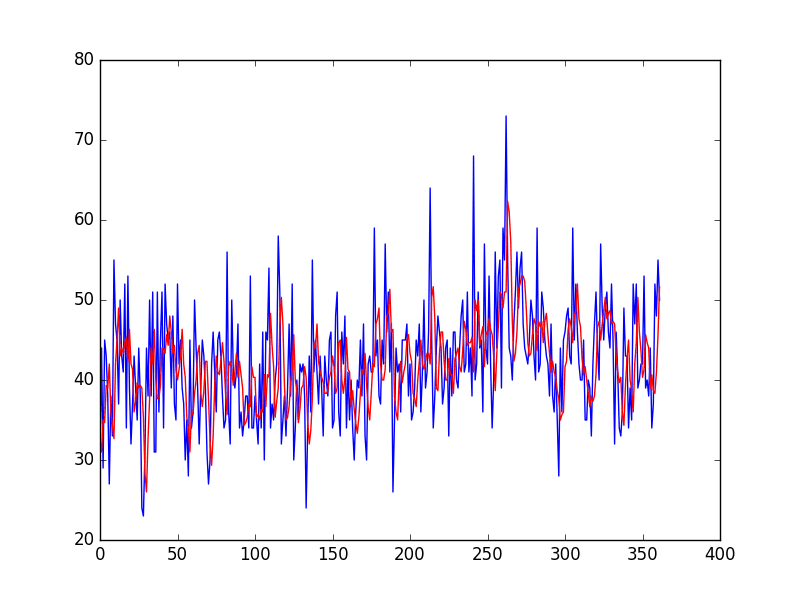
این مثال با رسم نمودار مقادیر واقعی دادههای آزمون (رنگ آبی) و مقایسه آنها با مقادیر پیشبینیشده (رنگ قرمز) به پایان میرسد.
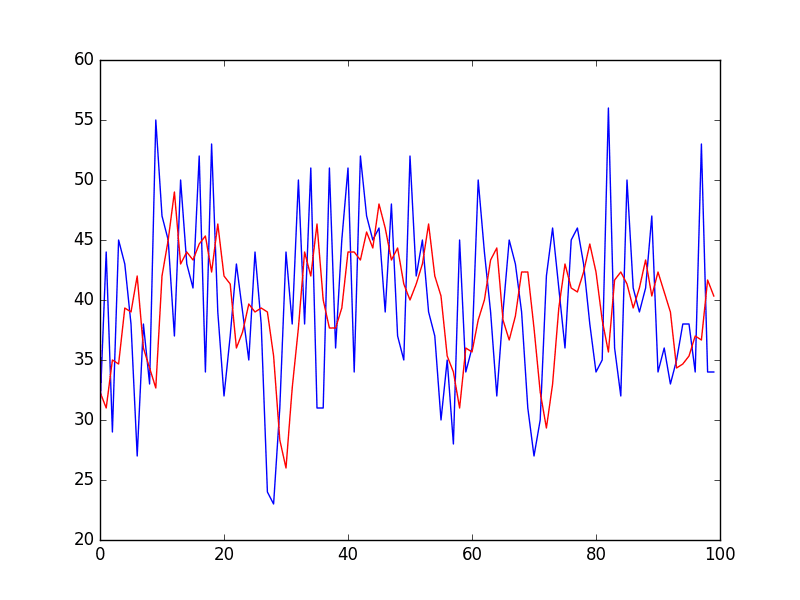
دوباره با بزرگنمایی روی ۱۰۰ پیشبینی نخست، میتوانیم درک بهتری از عملکرد پیشبینیهای میانگین متحرک سهروزه به دست آوریم.
توجه داشته باشید که اندازه پنجره ۳ بهصورت دلخواه انتخاب شده و بهینهسازی نشده است.
این بخش منابعی را معرفی میکند که برای مطالعه بیشتر درباره روشهای هموارسازی و میانگین متحرک در تحلیل سریهای زمانی و پیشبینی آنها مفید هستند.
- فصل چهارم، «روشهای هموارسازی»، از کتاب Practical Time Series Forecasting with R: A Hands-On Guide (پیشبینی عملی سریهای زمانی با R: راهنمای کاربردی).
- بخش ۱.۵.۴، «هموارسازی»، از کتاب Introductory Time Series with R (مقدمهای بر سریهای زمانی با R).
- بخش ۲.۴، «هموارسازی در زمینه سریهای زمانی»، از کتاب Time Series Analysis and Its Applications with R Examples (تحلیل سریهای زمانی و کاربردهای آن با مثالهایی در R).
در این آموزش یاد گرفتید که چگونه از هموارسازی با میانگین متحرک برای پیشبینی سریهای زمانی با استفاده از پایتون استفاده کنید.
بهطور مشخص، با موارد زیر آشنا شدید:
- نحوه عملکرد هموارسازی میانگین متحرک و پیشفرضهای مربوط به دادههای سری زمانی پیش از استفاده از آن.
- نحوه استفاده از هموارسازی میانگین متحرک برای آمادهسازی دادهها در پایتون.
- نحوه استفاده از هموارسازی میانگین متحرک برای مهندسی ویژگی در پایتون.
- نحوه استفاده از هموارسازی میانگین متحرک برای انجام پیشبینی در پایتون.
آیا درباره هموارسازی میانگین متحرک یا این آموزش سؤالی دارید؟
سؤالات خود را در بخش نظرات مطرح کنید و من تمام تلاش خود را برای پاسخدادن به آنها انجام خواهم داد.

