
تصویرسازی دادهها گاهی شامل مرحلهای از تجمیع یا تخمین است؛ در این مرحله چندین نقطه داده به یک خلاصه آماری مانند میانگین یا میانه کاهش داده میشوند. هنگام نمایش یک خلاصه آماری، معمولاً مناسب است که میلههای خطا (error bars) نیز اضافه شوند. این میلهها یک نشانه بصری ارائه میکنند که نشان میدهد این خلاصه تا چه اندازه نماینده نقاط داده اصلی است.
چندین تابع در seaborn هنگام دریافت یک مجموعهدادهٔ کامل، بهصورت خودکار هم خلاصه آماری و هم میلههای خطا را محاسبه میکنند. این فصل توضیح میدهد که چگونه میتوانید کنترل کنید میلههای خطا چه چیزی را نشان دهند و چرا ممکن است هرکدام از گزینههای ارائهشده توسط seaborn را انتخاب کنید.
میلههای خطا در اطراف یک تخمین از گرایش مرکزی میتوانند یکی از دو مفهوم کلی را نشان دهند:
دامنه عدم قطعیت درباره تخمین
پراکندگی دادههای اصلی در اطراف آن تخمین
این دو معیار با یکدیگر مرتبط هستند: با داشتن اندازه نمونه یکسان، تخمینها زمانی عدم قطعیت بیشتری خواهند داشت که دادهها پراکندگی بیشتری داشته باشند. اما عدم قطعیت با افزایش اندازه نمونه کاهش مییابد، در حالی که پراکندگی دادهها لزوماً کاهش پیدا نمیکند.
در seaborn، برای ساخت هر نوع از میلههای خطا دو روش وجود دارد:
یک روش پارامتری (parametric) است که از یک فرمول بر اساس فرضهایی درباره شکل توزیع داده استفاده میکند.
روش دیگر ناپارامتری (nonparametric) است که فقط از دادههایی که شما ارائه میکنید استفاده میکند.
انتخاب روش از طریق پارامتر errorbar انجام میشود؛ این پارامتر در هر تابعی که هنگام رسم نمودار، تخمین آماری انجام میدهد وجود دارد. این پارامتر نام روش مورد استفاده و در صورت نیاز، پارامتری برای کنترل اندازه بازه را دریافت میکند. گزینهها را میتوان در یک طبقهبندی دوبعدی تعریف کرد که به دو عامل وابسته است:
چه چیزی نمایش داده میشود.
چگونه ساخته میشود.
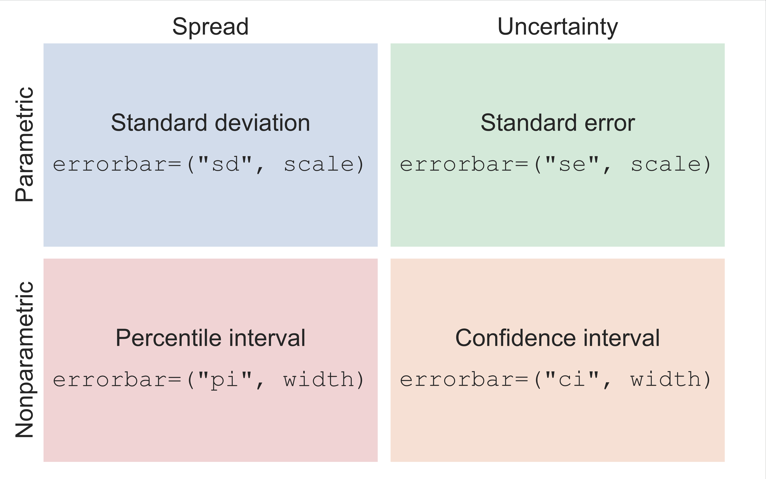
متوجه خواهید شد که پارامتر اندازه در روشهای پارامتری و ناپارامتری به شکل متفاوتی تعریف میشود.
برای میلههای خطای پارامتری، این مقدار یک ضریب عددی است که در آماره تعیینکننده خطا (مانند خطای استاندارد یا انحراف معیار) ضرب میشود.
برای میلههای خطای ناپارامتری، این مقدار عرض درصدی (percentile width) بازه است.
در ادامه، هر روش بهطور دقیقتر توضیح داده خواهد شد.
نکته
رابط برنامهنویسی
errorbarکه در اینجا توضیح داده شده است، در نسخهٔ seaborn v0.12 معرفی شد.در نسخههای قبلی، تنها گزینهها شامل نمایش یک فاصلهٔ اطمینان بوتاسترپ یا انحراف معیار بودند و انتخاب آنها با پارامتر
ciکنترل میشد:
ci=<size>
ci="sd"
برای مقایسه پارامترهای مختلف، از تابع کمکی زیر استفاده میکنیم:
def plot_errorbars(arg, **kws): np.random.seed(sum(map(ord, "error_bars"))) x = np.random.normal(0, 1, 100) f, axs = plt.subplots(2, figsize=(7, 2), sharex=True, layout="tight") sns.pointplot( x=x, errorbar=arg, **kws, capsize=.3, ax=axs[0] ) sns.stripplot( x=x, jitter=.3, ax=axs[1] )
میلههای خطایی که پراکندگی دادهها را نشان میدهند، یک نمایش فشرده از توزیع داده ارائه میکنند. این کار با استفاده از سه عدد انجام میشود؛ در حالی که تابع ()boxplot برای نمایش توزیع معمولاً از ۵ عدد یا بیشتر استفاده میکند و ()violinplot از یک الگوریتم پیچیدهتر بهره میبرد.
میلههای خطای انحراف معیار (standard deviation) سادهترین نوع برای توضیح هستند، زیرا انحراف معیار یک آماره شناختهشده است. انحراف معیار، میانگین فاصله هر نقطه داده از میانگین نمونه است.
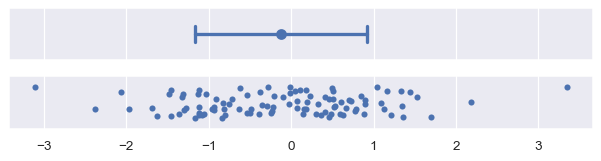
بهصورت پیشفرض، "errorbar="sd میلههای خطا را در محدوده ±۱ انحراف معیار در اطراف تخمین رسم میکند، اما میتوان این محدوده را با ارسال یک پارامتر اندازه مقیاسدهی افزایش داد.
توجه داشته باشید که با فرض اینکه دادهها دارای توزیع نرمال باشند:
حدود ۶۸٪ از دادهها درون یک انحراف معیار قرار میگیرند.
حدود ۹۵٪ از دادهها درون دو انحراف معیار قرار میگیرند.
حدود ۹۹٫۷٪ از دادهها درون سه انحراف معیار قرار میگیرند.
plot_errorbars("sd")
بازههای درصدی (Percentile intervals) نیز محدودهای را نشان میدهند که مقداری از دادهها درون آن قرار دارند، اما این کار را با محاسبه مستقیم صدکها از نمونه شما انجام میدهند.
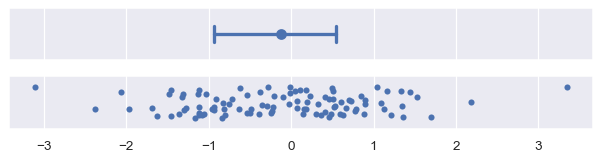
بهصورت پیشفرض، "errorbar="pi یک بازه ۹۵٪ را نمایش میدهد که از صدک ۲٫۵ تا صدک ۹۷٫۵ را شامل میشود.
میتوانید با ارسال یک پارامتر اندازه، محدوده دیگری را انتخاب کنید؛ برای مثال، برای نمایش دامنه بین چارکی (inter-quartile range):
plot_errorbars(("pi", 50))
میلههای خطای انحراف معیار همیشه در اطراف تخمین متقارن خواهند بود. این موضوع زمانی میتواند مشکلساز شود که دادهها چوله (skewed) باشند، بهخصوص زمانی که دادهها دارای محدودیتهای طبیعی هستند (برای مثال، اگر دادهها نشاندهنده کمیتی باشند که فقط میتواند مثبت باشد).
در برخی موارد، میلههای خطای انحراف معیار ممکن است تا مقادیر «غیرممکن» نیز امتداد پیدا کنند.
روش ناپارامتری این مشکل را ندارد، زیرا میتواند پراکندگی نامتقارن را در نظر بگیرد و هرگز فراتر از محدوده واقعی دادهها امتداد پیدا نمیکند.
اگر دادههای شما یک نمونه تصادفی از یک جامعه بزرگتر باشند، آنگاه میانگین (یا هر تخمین دیگر) یک اندازهگیری کامل از میانگین واقعی جامعه نخواهد بود. میلههای خطایی که عدم قطعیت تخمین را نشان میدهند، تلاش میکنند محدودهای از مقادیر احتمالی برای پارامتر واقعی جامعه را نمایش دهند.
آماره خطای استاندارد (standard error) با انحراف معیار مرتبط است؛ در واقع، خطای استاندارد برابر است با انحراف معیار تقسیم بر جذر اندازه نمونه.
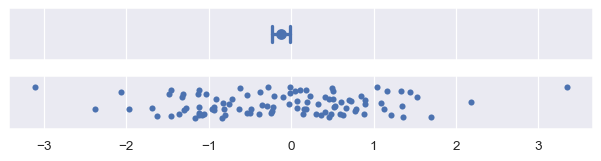
حالت پیشفرض با "errorbar="se یک بازهٔ ±۱ خطای استاندارد در اطراف میانگین رسم میکند:
plot_errorbars("se")
روش ناپارامتری برای نمایش عدم قطعیت از بوتاسترپ (bootstrapping) استفاده میکند.
بوتاسترپ روشی است که در آن:
مجموعهداده چندین بار بهصورت تصادفی و با جایگذاری (with replacement) نمونهبرداری مجدد میشود.
تخمین موردنظر از هر نمونه جدید دوباره محاسبه میشود.
این فرایند یک توزیع از آمارهها ایجاد میکند که تقریباً توزیعی از مقادیری را نشان میدهد که اگر نمونه متفاوتی داشتید، ممکن بود برای تخمین خود به دست آورید.
فاصله اطمینان با گرفتن یک بازه درصدی از توزیع بوتاسترپ ساخته میشود.
بهصورت پیشفرض، "errorbar="ci یک فاصله اطمینان ۹۵٪ رسم میکند:
plot_errorbars("ci")
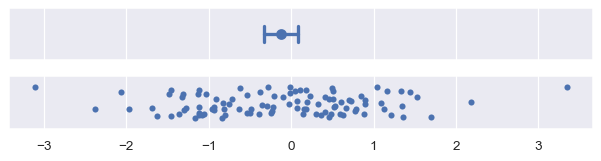
اصطلاحات seaborn کمی خاص هستند، زیرا در آمار، یک فاصله اطمینان میتواند هم پارامتری و هم ناپارامتری باشد.
برای رسم یک فاصله اطمینان پارامتری، خطای استاندارد را با استفاده از فرمولی مشابه فرمول ذکرشده در بالا مقیاسدهی میکنید.
برای مثال، یک فاصلهٔ اطمینان تقریبی ۹۵٪ را میتوان با محاسبه میانگین ± دو خطای استاندارد ساخت:
plot_errorbars(("se", 2))
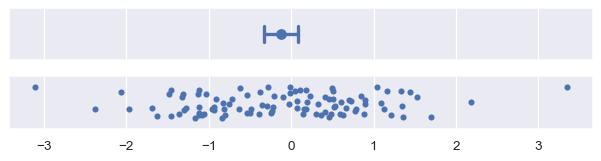
بوتاسترپ ناپارامتری مزایایی مشابه بازه درصدی دارد:
بهصورت طبیعی با دادههای چوله (skewed) و دارای محدودیت (bounded) سازگار میشود؛ در حالی که بازه خطای استاندارد چنین قابلیتی ندارد.
عمومیتر است.
در حالی که فرمول خطای استاندارد مخصوص میانگین است، میتوان میلههای خطا را با استفاده از بوتاسترپ برای هر نوع تخمینگر دیگری نیز محاسبه کرد:
plot_errorbars("ci", estimator="median")
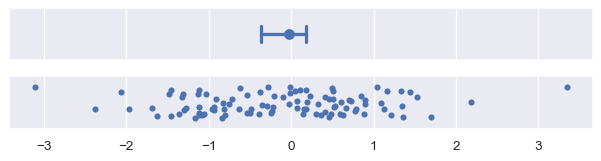
بوتاسترپ شامل تصادفی بودن است، بنابراین میلههای خطا هر بار که کدی را که آنها را ایجاد میکند اجرا میکنید، ممکن است کمی متفاوت ظاهر شوند.
چند پارامتر این موضوع را کنترل میکنند:
یکی تعداد تکرارها (n_boot) را تعیین میکند؛ هرچه تعداد تکرارها بیشتر باشد، بازههای بهدستآمده پایدارتر خواهند بود.
دیگری مقدار seed را برای مولد اعداد تصادفی تعیین میکند که باعث میشود نتایج دقیقاً یکسان تکرار شوند.
مثال:
plot_errorbars("ci", n_boot=5000, seed=10)
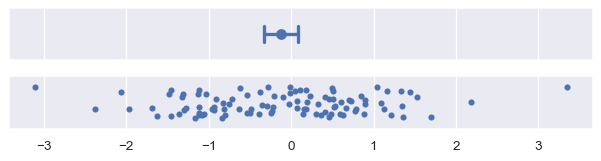
به دلیل فرایند تکراری بوتاسترپ، محاسبه بازههای بوتاسترپ میتواند هزینهبر باشد، بهخصوص برای مجموعهدادههای بزرگ.
اما از آنجا که عدم قطعیت با افزایش اندازه نمونه کاهش مییابد، در چنین شرایطی ممکن است استفاده از یک میله خطا که پراکندگی دادهها را نشان میدهد، اطلاعات بیشتری ارائه کند.
اگر این روشها کافی نباشند، امکان ارسال یک تابع عمومی به پارامتر errorbar نیز وجود دارد. این تابع باید یک بردار را دریافت کند و یک جفت مقدار تولید کند که نشاندهنده نقاط حداقل و حداکثر بازه باشند:
plot_errorbars(lambda x: (x.min(), x.max()))
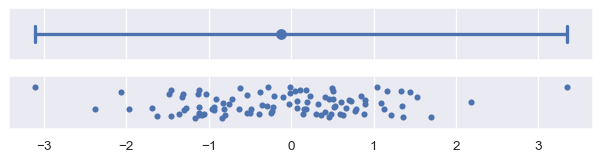
(در عمل، میتوانید کل دامنه دادهها را با استفاده از errorbar=("pi", 100) بهجای تابع سفارشی بالا نمایش دهید.)
توجه داشته باشید که توابع seaborn در حال حاضر نمیتوانند میلههای خطایی را از مقادیری که بهصورت خارجی محاسبه شدهاند رسم کنند؛ اگرچه میتوان از توابع matplotlib برای اضافه کردن چنین میلههای خطایی به نمودارهای seaborn استفاده کرد.
بحثهای قبلی بر روی میلههای خطایی تمرکز داشتند که در اطراف تخمین پارامترها برای دادههای تجمیعشده نمایش داده میشوند.
میلههای خطا در seaborn هنگام تخمین مدلهای رگرسیون برای نمایش روابط بین متغیرها نیز ظاهر میشوند.
در اینجا، میلههای خطا به شکل یک نوار (band) در اطراف خط رگرسیون نمایش داده میشوند:
x = np.random.normal(0, 1, 50)
y = x * 2 + np.random.normal(0, 2, size=x.size)

sns.regplot(x=x, y=y)
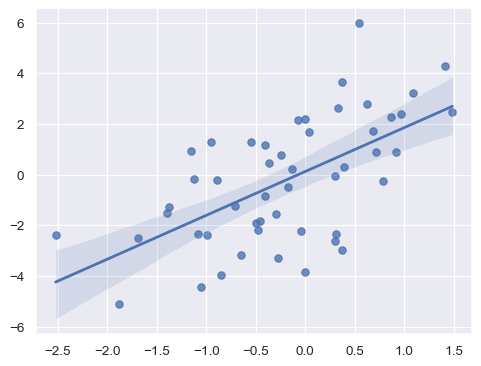
در حال حاضر، میلههای خطا در تخمین رگرسیون انعطافپذیری کمتری دارند و فقط یک فاصله اطمینان را نمایش میدهند که اندازه آن از طریق =ci تعیین میشود. ممکن است این موضوع در آینده تغییر کند.
همیشه باید از خود بپرسید که آیا استفاده از نموداری که فقط یک آماره خلاصه و میله خطا را نمایش میدهد، بهترین انتخاب است یا خیر. در بسیاری از موارد، پاسخ منفی است.
اگر به پرسشهایی درباره خلاصههای آماری علاقهمند هستید (مانند اینکه آیا مقدار میانگین بین گروهها متفاوت است یا در طول زمان افزایش مییابد)، تجمیع دادهها پیچیدگی نمودار را کاهش میدهد و انجام این نوع استنباطها را آسانتر میکند. اما در عوض، اطلاعات ارزشمندی درباره نقاط داده اصلی را پنهان میکند؛ مانند:
شکل توزیع دادهها
وجود دادههای پرت (outliers)
هنگام تحلیل دادههای خود، فقط به آمارههای خلاصه اکتفا نکنید. همیشه توزیعهای اصلی دادهها را نیز بررسی کنید. گاهی اوقات، ترکیب هر دو دیدگاه در یک شکل میتواند مفید باشد.
بسیاری از توابع seaborn میتوانند در این کار کمک کنند، بهخصوص توابعی که در آموزش نمودارهای دستهای (categorical tutorial) معرفی شدهاند.

