
یک جواب اشتباه دربارهٔ پول، گاهی از جواب ندادن بدتر است. کاربر به ربات سرمایهگذاری بله مینویسد: «دیروز طلا فروختم؛ چرا پولش به حساب بانکیام نرسیده؟» یک دستیار میتواند خیلی سریع یک رکورد فروش پیدا کند و بگوید «معاملهٔ شما موفق بوده». جمله آرامشبخش است، اما سؤال را جواب نمیدهد. ثبت فروش، رفتن پول به موجودی داخل محصول، ثبت درخواست واریز بانکی و واریز در بانک مقصد، یک اتفاق نیستند. دیدن مرحلهٔ اول، مرحلهٔ آخر را ثابت نمیکند.
اینجا بود که برای ما، پشتیبانی از یک مسئلهٔ «متن سؤال را بگیر، متن جواب را بساز» فراتر رفت. باید میفهمیدیم کاربر دقیقاً دربارهٔ کدام مرحله میپرسد، چه دادهای برای همان کاربر قابل خواندن است، هر داده تا کجا جواب را پشتیبانی میکند و اگر بخشی از مسیر معلوم نبود، چه بگوییم. مدل زبانی (LLM) در فهم پیامهای کوتاه فارسی و نوشتن پاسخ روان کمک زیادی میکند؛ اما قیمت امروز، موجودی یک نفر یا معنی یک وضعیت مالی را مدل تعیین نمیکند.
در این پست، سؤال کاربر را از لحظهٔ ورود تا جواب دنبال میکنیم و بعد میبینیم گفتوگوهای پایانیافته چه چیزی به تیم یاد میدهند و چگونه میتوانیم با یک گزارش هوشمند روزانه، وضعیت محصول را رهگیری کنیم. مسیر سؤال، تصمیمهای طراحی، راههایی که امتحان کردیم و جواب ندادند و گزارش روزانه را با مثال باز میکنیم. نمونههای این متن برای توضیح طراحی ساخته شدهاند؛ هیچ پیام یا اطلاعات حساب یک مشتری واقعی در آن نیست.
چهار سؤال زیر ممکن است همگی واژهٔ «برداشت» یا «طلا» داشته باشند:
۱. «چطور پولم را برداشت کنم؟»
۲. «قیمت فعلی چقدر است؟»
۳. «برداشت من انجام شد؟»
۴. «اگر این مقدار را وارد کنم، حدوداً چقدر میشود؟»
سؤال اول راهنمای فعلی محصول میخواهد. دومی عدد زنده میخواهد. سومی بدون خواندن (استعلام) حساب همان کاربر جواب ندارد. چهارمی شاید قانون محصول، واحد درست و محاسبهٔ قطعی بخواهد. اگر همه را به یک مستند یا یک پرامپت بدهیم، احتمالاً برای بعضیشان جواب روان میگیریم، اما نمیدانیم آن جواب از کجا آمده و تا چه حد درست است.
از نگاه کاربر هم مسئله فقط دقت نیست. کسی که منتظر پولش است، نمیخواهد برای پیدا کردن یک رکوردی که محصول خودش دارد چند بار شماره و تاریخ وارد کند. در عین حال نمیخواهد agent با حدس خودش بگوید «واریز شد». بنابراین خروجی خوب همیشه یک جواب قطعی نیست. گاهی یکی از این چهار حالت بهترین تجربه است:
- همین حالا جواب بده؛ وقتی راهنمای بررسیشده یا دادهٔ تأییدشده کافی است.
- یک سؤال دقیق بپرس؛ وقتی جواب کاربر مسیر بررسی را عوض میکند.
- بخش معلوم را بگو و حدش را روشن کن؛ مثلاً فروش دیده شده، ولی وضعیت واریز بانکی معلوم نیست.
- راه درست پیگیری را نشان بده؛ وقتی منبع لازم فعلاً در دسترس نیست یا آن اطلاعات را اصلاً نمیدهد.
از همینجا یک معیار ساده برای طراحی agent درمیآید: قبل از نوشتن متن پاسخ بپرسیم کاربر قرار است بعد از خواندن این جمله، چه چیزی را قطعی بداند؟ اگر برای آن چیز evidence نداریم، مشکل را با جملهبندی قشنگ حل نکردهایم.
فلوی قبلی پشتیبانی از چند جزء عمومی مرسوم عبور میکرد (یک فاز بازیابی دانش + یک فاز فراخوانی ابزارها). برای پرسشهای مربوط به یک محصول مالی، لازم بود گفتوگو، دانش محصول، اجازهٔ استعلام حساب و بررسی جواب در یک مرز مشخص کنار هم دیده شوند. داده و قواعد مالی همچنان مال سامانهٔ اصلی محصول است. agent پشتیبانی گفتوگو را پیش میبرد و تصمیم میگیرد برای جواب دادن سراغ کدام نوع evidence برود (احتمالا بتوانیم اسم آن را sub-agent بگذاریم که هر کدام تخصصی مجزایی دارند؛ یکی توضیح دادن را خوب بلد است، یکی استعلام گرفتن را).
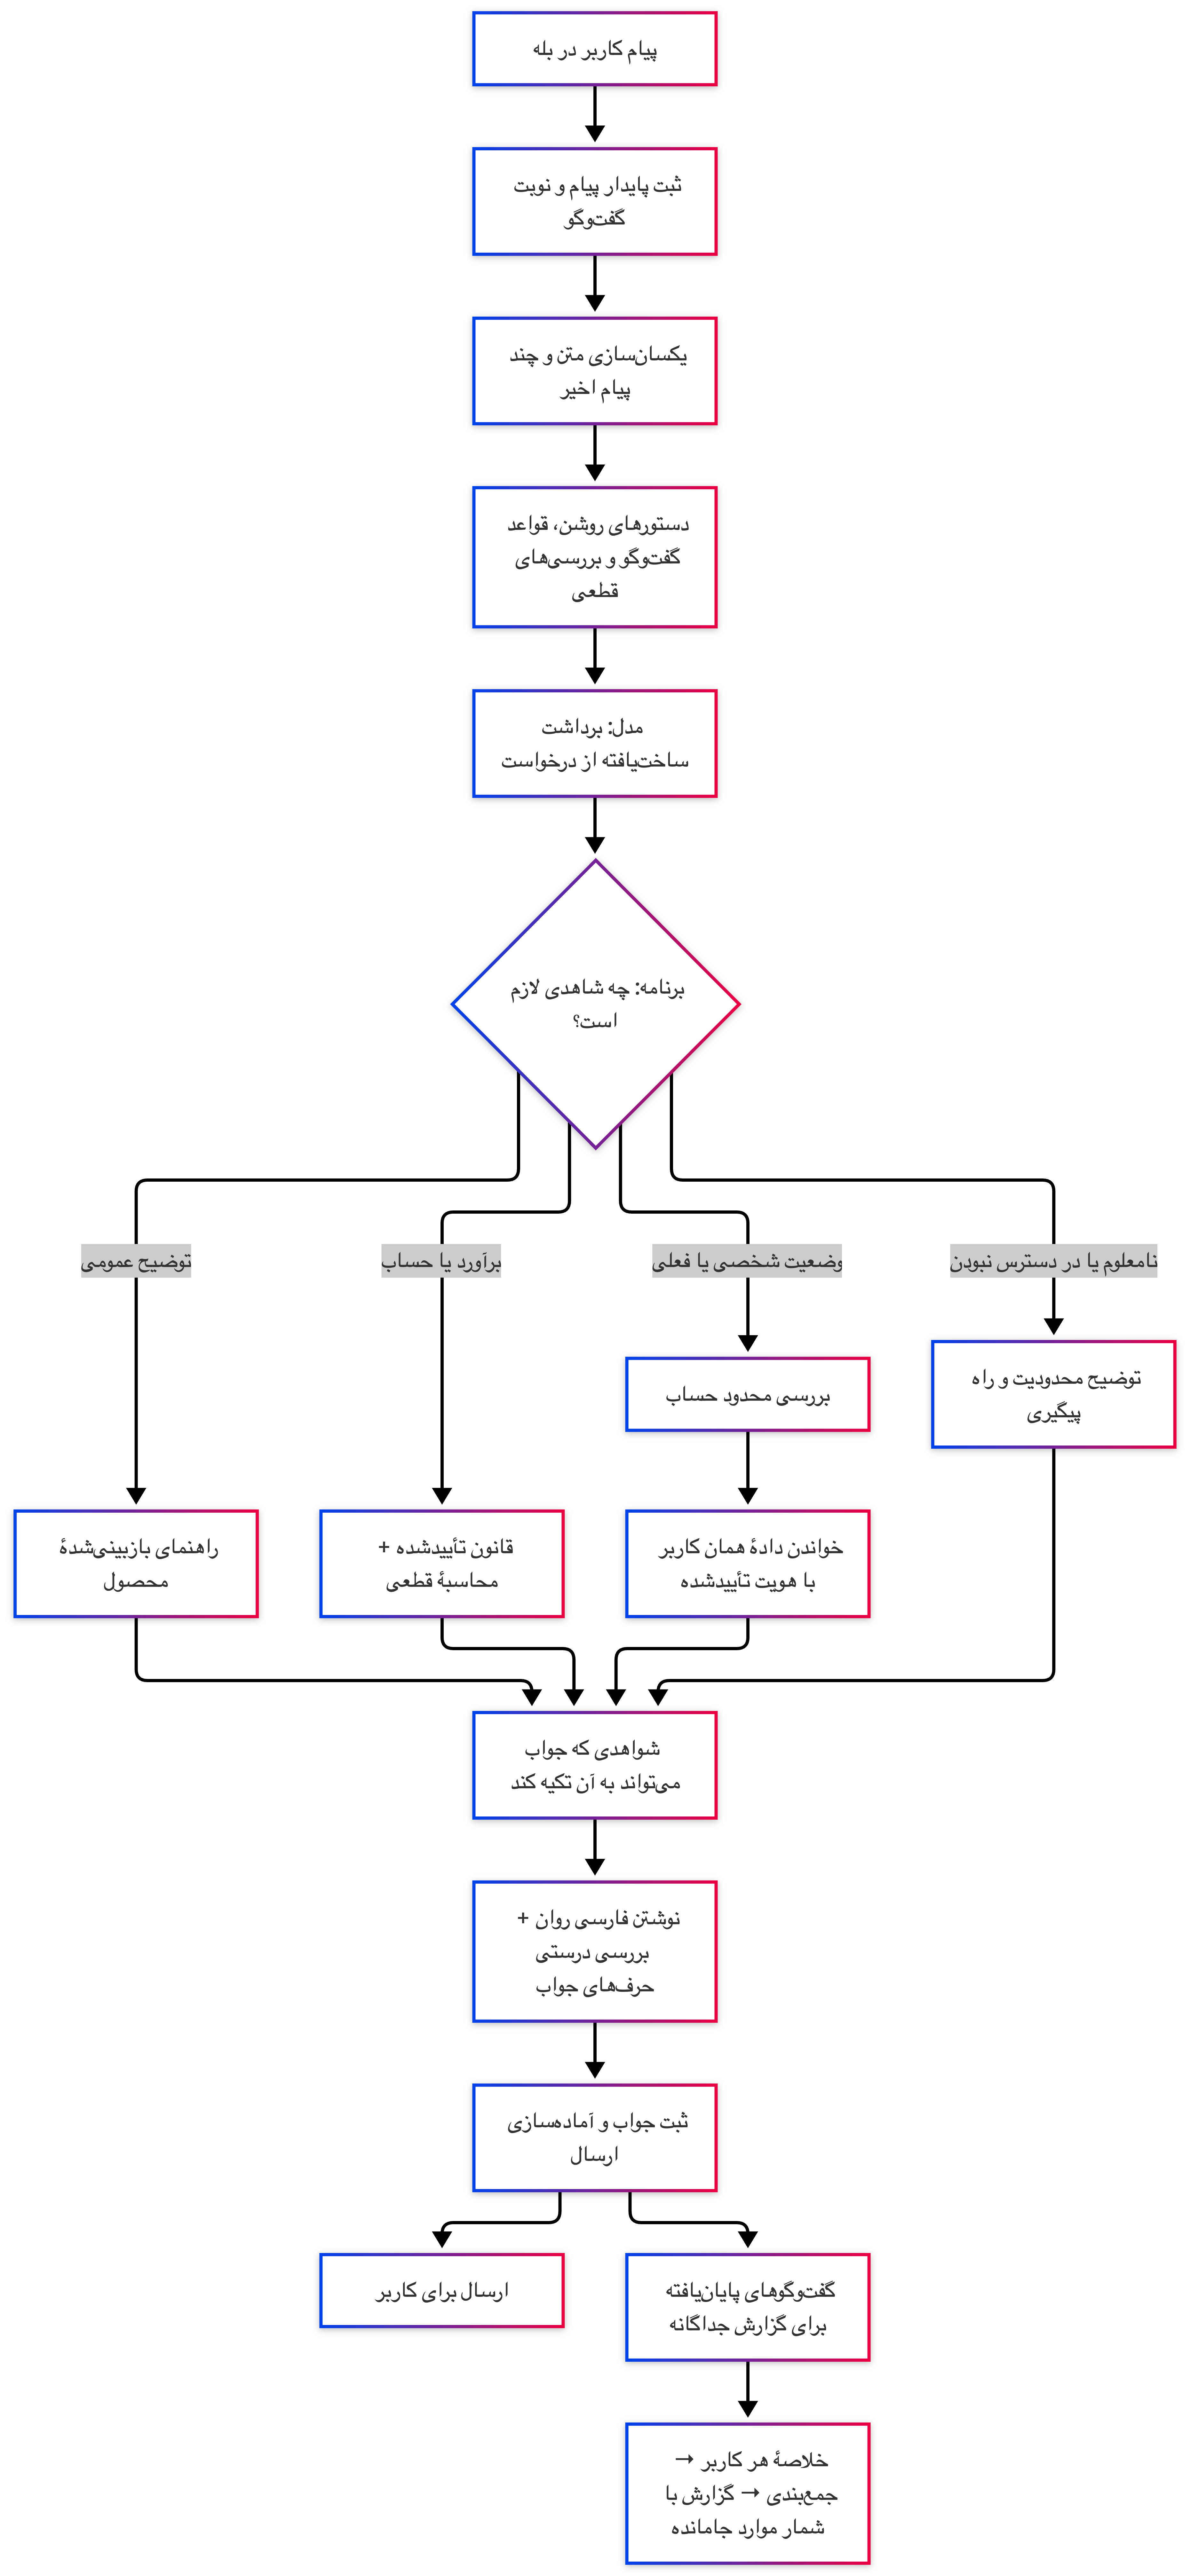
در این شکل، مهمتر از جعبهها این است که چه کسی بین آنها تصمیم میگیرد. مدل میگوید احتمالاً کاربر چه میخواهد یا بعد از دیدن یک نتیجه، خواندن کدام داده مفید است (اصطلاحا intent detection انجام میدهد). برنامه بررسی میکند این برداشت معتبر است یا نه، فلوی مجاز را انتخاب میکند، هویت را به هر خواندن حساب وصل میکند (هویت برای ارسال کنندهی پیام بصورت نرم افزاری استخراج میشود و نه از متن کاربر، پس شما نمیتوانید برای فرزند یا همسرتان یا حتی اکانت دیگرتان درخواست پشتیبانی دهید)، تعداد و زمان بررسی را محدود میکند و حرفهای جواب نهایی را با دادهها میسنجد.
اول مسیر هم به اندازهٔ آخرش مهم است. پیامهای دریافتی قبل از اینکه برنامه از آن نقطهٔ جریان پیامها جلو برود، ذخیره میشوند (turn management). پیامهای نزدیک یک کاربر به ترتیب و در یک نوبت مشخص پردازش میشوند؛ پیام بعدی وارد نوبت بعد میشود. برای «طلا فروختم» و پیام بلافاصلهٔ بعدش «دیروز»، این تفاوت مهم است: توضیح دوم باید در جای درست دیده شود و قطعشدن برنامه نباید آن را گم کند یا دو بار پردازش کند. اگر پردازش دوباره شروع شد، نسخهٔ قدیمیتر کار نباید بعداً جواب خودش را روی نتیجهٔ جدید ثبت کند. گفتوگو فقط یک پرامپت موقتی نیست؛ کاری است که باید بتواند از قطعشدن هم جان سالم ببرد.
به این معنا با یک agent محدود طرفیم، نه یک دستیار همهکاره که هر کاری خواست انجام دهد. در راهنمای ساخت عاملهای مؤثر Anthropic، تفاوت خوبی بین مسیرهای از پیش معلوم (predefined workflows) و عاملی که بر اساس نتیجهٔ هر قدم، قدم بعدی را انتخاب میکند آمده است. تجربهٔ ما ترکیبی از این دو است: قانون دسترسی و انتخاب نوع منبع در برنامه ثابت است؛ در بررسیهایی که قدم بعدی از قبل معلوم نیست، مدل فقط از میان خواندنهای مجاز پیشنهاد میدهد.
قبل از اینکه متنهای قدیمی را به مدل بدهیم، جملههایشان را یکییکی بررسی کردیم. سؤال ما این نبود که «این فایل خوب است یا نه؟» میپرسیدیم «این جمله دربارهٔ چه چیزی حرف میزند و امروز چه کسی میتواند درستبودنش را تأیید کند؟». باید عمر صحت یک جمله دربارهی محصول یا تغییرپذیری آن را در نظر بگیریم.
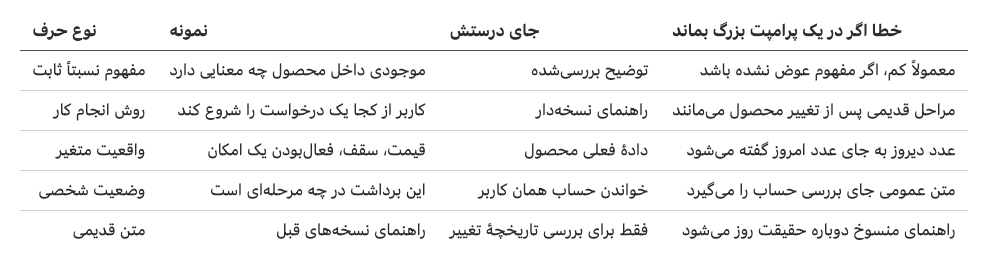
کار RAG نشان میدهد چطور میتوان دانش بیرونی را وارد تولید جواب مدلهای LLM کرد. اما پیدا کردن نزدیکترین پاراگراف کافی نیست: آن پاراگراف شاید قدیمی باشد یا اصلاً نتواند دربارهٔ حساب این فرد چیزی ثابت کند. برای توضیحهای عمومی، راهنماها را در موضوعهای مشخص و قابل بازبینی نگه داشتیم؛ برای عدد و وضعیت متغیر، سراغ منبع فعلی محصول میرویم. این انتخاب از «همهچیز را جستوجو کن و به مدل بسپار» محدودتر است، ولی کنترلپذیرتر هم هست.
حالا فرض کنید مرحلهای از برداشت در محصول عوض میشود. اصلاح خوب فقط تغییر یک جمله نیست. باید سه سؤال نزدیک را هم بررسی کنیم:
- «چطور برداشت کنم؟» باید راهنمای جدید را بگیرد.
- «برداشت خودم چه شد؟» هنوز باید از حساب کاربر خوانده شود.
- «چقدر طول میکشد؟» باید روشن کند منظور زمان معمولِ منتشرشده است یا زمان واقعی یک درخواست مشخص.
سؤال سوم مهم است. «معمولاً در این بازه انجام میشود» و «برداشت شما ساعت دو تمام شد» هر دو دربارهٔ زماناند، اما دومی بدون دادهٔ همان تراکنش قابل گفتن نیست. وقتی هر موضوع مسئول، نسخه و نمونهسؤالهای خودش را دارد، همکار محصول یا پشتیبانی میتواند راهنما را بهتر کند، بدون اینکه ناخواسته مجوز ابزار یا روش محاسبه را عوض کند.
پس نوع مستندات، اعتبار آن، تغییر پذیری، وسعت اثر گذاری و... همگی عواملی هستند که نباید به سادگی از کنار آن عبور کرد.
کاربر مینویسد: «پولش نیومده.» این سه کلمه دقیقاً کدام مشکل را میگویند؟ شاید پول فروش طلا در موجودی داخل برنامه دیده نمیشود؛ شاید منتظر واریز به بانک است؛ شاید در پیام قبلی دربارهٔ محصول پسانداز حرف زده. پیام بعدی «همون دیروزی» هم بدون کمی از گفتوگوی قبل معلوم نیست به چه اشاره دارد.
مدل این زبان کوتاه را به چند فیلد تبدیل میکند: نوع درخواست، محصول احتمالی، موضوع، تاریخ یا مبلغ احتمالی، و ابهامی که اگر رفع نشود مسیر عوض میشود. شکل زیر فقط یک مثال است، نه contract واقعی سرویس:
نوع درخواست: بررسی وضعیت شخصی محصول: طلا موضوع: پول حاصل از فروش زمان احتمالی: دیروز شمارهٔ پیگیری: داده نشده ابهام مهم: مقصد پول
بعد برنامه تصمیم میگیرد چه کند. اطمینان مدل به معنی اجازهٔ دسترسی به حساب نیست. در مسیر فعلی، عامل میتواند بعضی اطلاعات حساب را بخواند، اما در چت معاملهٔ مالی انجام نمیدهد؛ البته شاید در آینده نزدیک به این سمت هم برویم :).
چرا مدل را همان اول وادار نکنیم جواب نهایی را بنویسد؟ چون ممکن است «این کار معمولاً دو روز طول میکشد» را با «برداشت شما در حال واریز است» قاطی کند. اولی یک قانون عمومی است؛ دومی دربارهٔ حساب شخصی حرف میزند. وقتی برداشت مدل به چند فیلد مشخص تبدیل شود، برنامه فرصت دارد مسیر و منبع درست را انتخاب کند.
سؤال تکمیلی هم باید اطلاعات تازهای بیاورد. «لطفاً واضحتر بگویید» اغلب کاربر را جلو نمیبرد. «پول در موجودی داخل برنامه دیده نمیشود یا منتظر واریز به حساب بانکی هستید؟» مسیر بعدی را مشخص میکند. در عوض، همیشه شمارهٔ پیگیری خواستن هم خوب نیست. اگر سوابق اخیر همان کاربر با خواندن مجاز پیدا میشود، میتوان از آن شروع کرد. شماره یا مبلغی که کاربر میدهد فقط جستوجو را محدود میکند؛ چیز دیگری را ثابت نمیکند.
در نمونههای سادهٔ agent ها، ابزار معمولاً یک اسم و چند ورودی دارد. برای پشتیبانی مالی این کافی نیست. قبل از معرفی هر ابزار خواندنی به مدل، باید بدانیم نتیجهٔ آن چه چیزی را ثابت میکند و چه چیزی را نه!
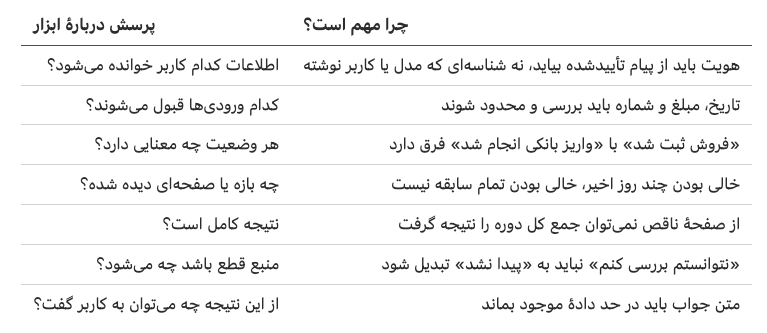
در نوشتهٔ Anthropic دربارهٔ ابزارهای خوب برای عاملها روشن و محدود بودن کار هر ابزار یکی از نکتههای اصلی است. اینجا یک شرط دیگر هم داریم: مدل هیچوقت با نوشتن یک شناسه، اجازهٔ دیدن حساب کسی را نمیگیرد. برنامه هویت تأییدشده را به خواندن داده وصل میکند و مالکیت رکورد هم بررسی میشود.
خروجی خام سرویس (ابزار) را هم کامل به مدل نمیدهیم. شاید دهها فیلد داشته باشد که ربطی به سؤال ندارند. خلاصهٔ نتیجهای که به مدل میدهیم باید وضعیت مربوط، مبلغ و واحد در صورت نیاز، زمان خواندن، بازهٔ جستوجو و کامل یا ناقص بودن آن را نگه دارد. یک نتیجهٔ فرضی میتواند بگوید:
مرحله: درخواست واریز بانکی وضعیت: ارسالشده زمان مشاهده: هنگام همین بررسی بازهٔ جستوجو: دورهای که کاربر دربارهاش پرسید پوشش: کامل برای همین دوره واریز در بانک مقصد: از این منبع ثابت نمیشود
خط آخر به اندازهٔ خود وضعیت مهم است. جلوی پرش از «درخواست ارسال شد» به «پول به بانک رسید» را میگیرد. اگر بازه ناقص باشد، حتی «درخواستی پیدا نشد» هم باید با احتیاط گفته شود. اگر سرویس قطع شده باشد، نتیجه باید «بررسی ممکن نبود» باشد، نه یک فهرست خالی.
برگردیم به سؤال اول: «دیروز طلا فروختم؛ چرا پولش به حساب بانکیام نرسیده؟» شکل زیر فقط مرحلههایی که میتوانیم بررسی کنیم را نشان میدهد؛ قرار نیست هر فروش دقیقاً از یک مسیر یکسان برود!
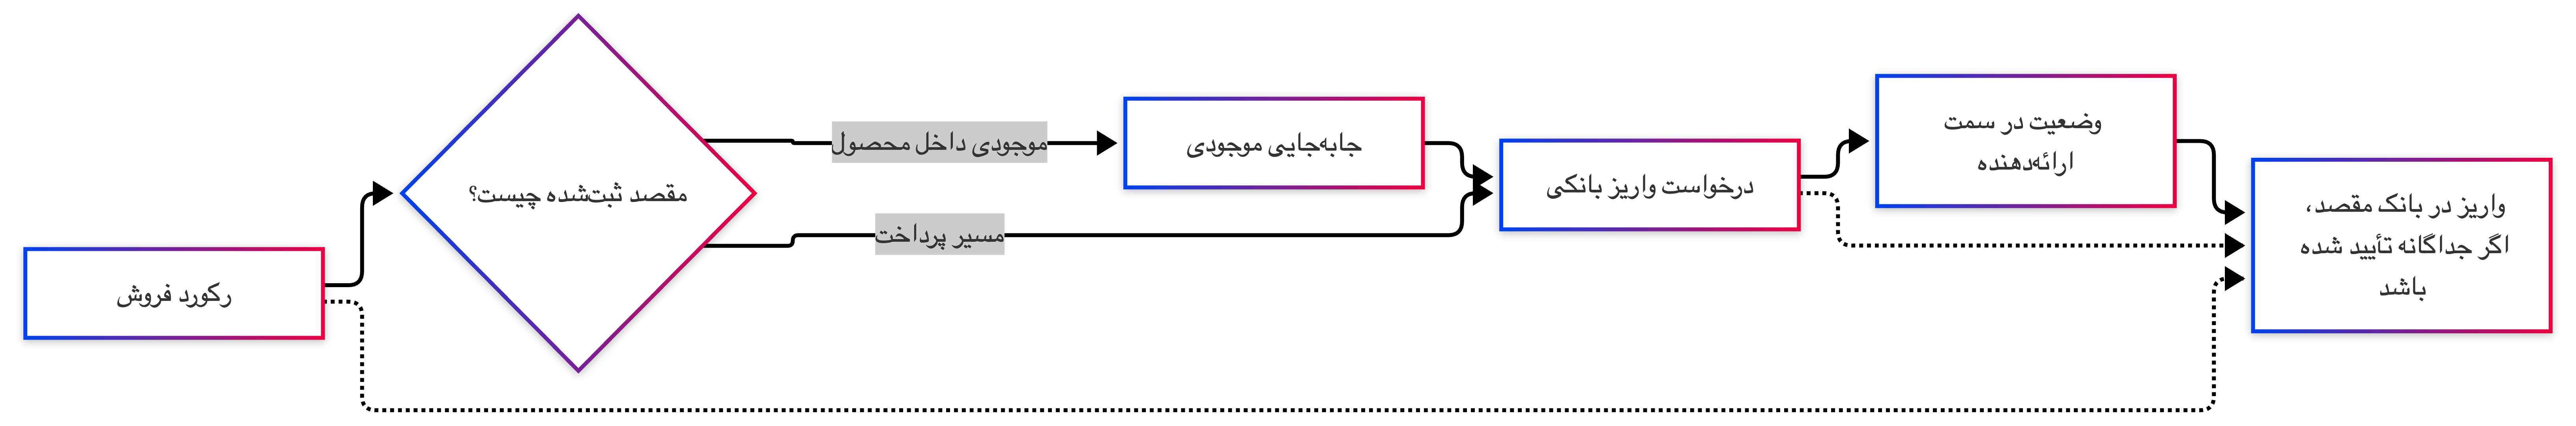
خطوط نقطهچین یعنی رکوردهای مرحلههای قبلی بهتنهایی واریز در بانک مقصد را ثابت نمیکنند. خواندن اول ممکن است فروش متعلق به همین کاربر را پیدا کند. این فقط وجود فروش را ثابت میکند؛ سؤال بانک هنوز باز است. خواندن بعدی به مقصد ثبتشده و دادهای که در دسترس است بستگی دارد. اگر یک بررسی جداگانه و منطبق در سمت ارائهدهنده تأیید کند درخواست واریز ارسال شده، عامل میتواند بگوید ارسال شده. تا وقتی منبعی واریز نهایی در بانک مقصد را ثابت نکرده، نباید بگوید «به حساب شما نشست».
یک جواب فرضیِ درست چنین شکلی دارد: «فروش و درخواست واریز مرتبط را پیدا کردم. اطلاعات موجود نشان میدهد درخواست ارسال شده، اما واریز نهایی در بانک مقصد را تأیید نمیکند.» این متن گزارش یک مشتری واقعی نیست. مهم، ترتیب فکرکردن است: اول چیزهای تأییدشده، بعد حد اطلاعات، بعد قدم بعدی اگر لازم بود. گاهی اوقات گفتن «ندانستن» بهتر از یک پاسخ کذب زیباست!
حالا شرایط را عوض کنیم:
- در چند روز اخیر چیزی پیدا نشد: همان بازه را نام ببریم. نگوییم کاربر هیچوقت چنین درخواستی نداشته.
- فروش پیدا شد، منبع پرداخت قطع است: فروش را بگوییم و روشن کنیم پرداخت را فعلاً نمیتوانیم بررسی کنیم.
- کاربر شمارهای فرستاده: از آن برای محدود کردن جستوجو استفاده کنیم، اما تعلق رکورد را جدا بررسی کنیم.
- دو رکورد محتمل هست: کوچکترین سؤال لازم برای جدا کردنشان را بپرسیم، نه اینکه یکی را حدس بزنیم! رفت و برگشت را تمرین کنیم و agent را برای آن آماده کنیم
- یک مرحلهٔ میانی موفق بوده: همان مرحله را نام ببریم. «درخواست پذیرفته شد» با «بانک واریز کرد» یکی نیست.
در این مسیر، مدل میتواند از نتیجهٔ یک خواندن، خواندن بعدیِ مجاز را پیشنهاد بدهد. برنامه زمان، تعداد تلاش و خواندنهای تکراری را محدود میکند. اگر نتیجهٔ تازهای به دست نمیآید، عامل نباید بیپایان دور خودش بچرخد (مشکل infinite loop). اگر زمان بررسی تمام شد، از شواهد موجود جواب محدود میدهد یا صادقانه میگوید چه چیزی را نتوانسته تأیید کند. ایدهٔ رفتوبرگشت بین مشاهده و قدم بعدی در مقالهٔ ReAct توضیح داده شده؛ در محصول واقعی، حد توقف و معنی هر شاهد باید جدا طراحی شوند.
جواب فقط وقتی خوب نیست که فارسیاش روان باشد. رقم، واحد، تاریخ، کلمهٔ وضعیت و محدودهٔ جستوجو باید با دادهها بخوانند. ممکن است مدل مبلغ را درست کپی کند، اما «ارسال شد» را به «پرداخت شد» تبدیل کند. عدد درست است؛ معنی جمله غلط است.
یک خطا را در یک مثال ساده ببینیم و سپس به مشاهدهی خودمان اشاره کنیم. فرض کنید کاربر مبلغ و مدت را میگوید و یک برآورد میخواهد (اگر ۱۰۰ میلیون تومان را ۳ ماه در حسابپس انداز بله سرمایهگذاری کنم، چقدر سود دریافت میکنم؟). سؤال به راهنمای عمومی پسانداز میرود. قانون مربوط در راهنما هست، اما این مسیر ابزار محاسبه ندارد. مدل خودش در متن حساب میکند؛ عدد معقول به نظر میرسد، ولی بررسی آخر نمیتواند پشتوانهٔ آن را پیدا کند و ردش میکند. افزودن چند پاراگراف به راهنما، ابزار محاسبه به این مسیر اضافه نمیکند. آسانتر کردن پذیرش عدد هم ممکن است فرمول اشتباه را راه بدهد. اصلاح درست این است که سؤال به مسیر برآورد برود، ورودیها و قانون تأییدشده به محاسبهگر (یک ابزار محاسبه) داده شوند، و مدل فقط نتیجه و فرضهای آن را برای کاربر توضیح دهد.
در ارزیابیهای خودمان به الگوی تکراری بالا رسیدیم. سؤال جواب عددی میخواست، اما به مسیری میرفت که دادهٔ لازم یا ابزار محاسبه را نداشت. بررسی نهایی (verifier) عدد را رد میکرد و وسوسه میشدیم بررسی را آسانتر کنیم. چند راه را امتحان کردیم: (۱) پذیرفتن حسابهای بیشتری از روی اعداد راهنما، (۲) گذاشتن اسناد بیشتر در موضوعهای عمومی، (۳) کمتر پرسیدن سؤال تکمیلی و کوتاهکردن جوابهای چندبخشی. هرکدام جایی مشکل داشت: حساب ظاهراً معقول اما نادرست را راه میداد، مسیر اشتباه را درست نمیکرد، ابهام واقعی را نادیده میگرفت یا بخشی از سؤال را بیجواب میگذاشت. تغییرهای ناموفق را نگه نداشتیم و طبق مثال بالا یک روش ترکیبی برای الگوهای چنینی در پیش گرفتیم.
برای توسعهدهنده، درس مهم این است که «مدل توهم زد» تشخیص کافی نیست. اولین اشتباه کجا رخ داده است؟
1. درخواست شخصی (اطلاعاتی درباره خود کاربر)، سؤال عمومی فهمیده شد؟
2. راهنما انتخاب شد در حالی که دادهٔ فعلی لازم بود؟
3. ابزار درست بود ولی فقط بخشی از بازه را دید؟
4. مدل از «ارسال شد» نتیجه گرفت «واریز شد»؟
5. جواب درست آماده شد ولی به کاربر نرسید؟
هرکدام راهحل خودش را دارد. پرامپت بهتر، دادهای را که سامانهٔ اصلی نمیدهد تولید نمیکند. بررسی سختگیرانهتر، سؤال را به ماشین حساب نمیفرستد. ابزارهای بیشتر هم مجوز دیدن حساب دیگران نیستند. برای اولین مجموعهٔ ارزیابی، فقط متن جواب دلخواه را ننویسید؛ مسیر درست و حرفی را که عامل نباید بزند هم ثبت کنید:
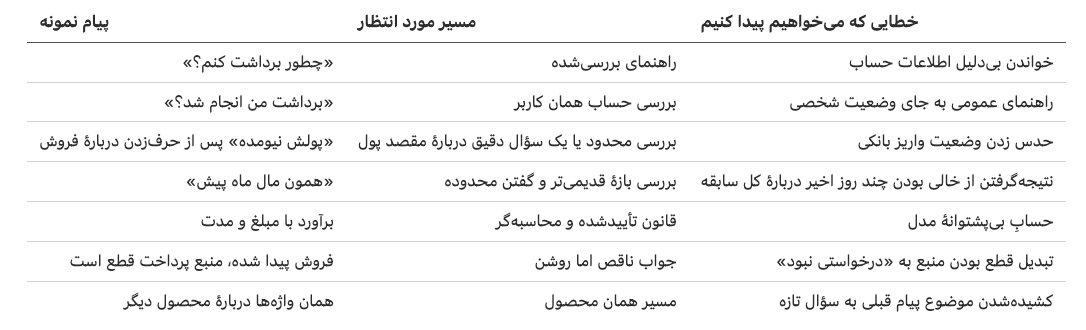
این نمونهها عمداً به هم نزدیکاند. اگر یک تغییر سؤالهای طلا را بهتر کند، اما برداشت پسانداز را به راهنمای طلا بفرستد، بالا رفتن نمرهٔ کلی خبر خوبی نیست.
در ساخت یک مجموعهی ارزیابی خوب برای agent خودتان، کل flowی مورد نظر را قرار دهید و صرفا پیام مطلوب خروجی را بررسی نکنید. یک نمونه از مجموعه ارزیابی ما و اجزای آن:
- sample_id: incident_recent_gold_purchase_status_without_reference family: incident split: development scenario: کاربر وضعیت خرید طلای امروز را بدون شمارهٔ پیگیری میخواهد و تاریخ نسبی هنوز یک رکورد را بهتنهایی مشخص نمیکند. target: پیش از هر پرسش تکراری، خریدهای اخیر را بخواند و وضعیت خرید را از روی شواهد حساب بررسی کند. smoke: true runtime: name: full fixture: in_flight_account_v1 turns: - question: امروز دو میلیگرم طلا خریدم؛ وضعیت خرید چی شد؟ expected: route: read_investigation required_tools: - recent_factors allowed_tools: - recent_factors - factor_inquiry - gold_balance - transaction_history - tehran_calendar expected_points: - بدون درخواست شمارهٔ پیگیری، خریدهای اخیر را برای یافتن مورد درست بررسی میکند. - وضعیت خرید را از روی مراحل پرداخت و انتقال طلا توضیح میدهد. - اگر شواهد چند خرید همسان نشان دهند، همان نامزدها را برای انتخاب روشن میکند. forbidden_phrases: - منظورت کدوم بخشه - شماره پیگیری را بفرست
پشتیبانی خوب همیشه «جواب قطعی» نیست. گاهی یک سؤال دقیق، یک نتیجهٔ ناقص اما تأییدشده، یا گفتنِ روشنِ «فعلاً نمیتوانم این وضعیت را بررسی کنم» مفیدتر است. این کمک میکند بین دو سر بد گیر نکنیم: از کاربر اطلاعاتی را دوباره بپرسیم که محصول خودش دارد، یا بدون evidence جواب مطمئن بدهیم.
برای نوشتن پاسخ، یک چارچوب ساده داریم: اگر جواب معلوم است، همان اول بگوییم؛ مرحلهای را که دیدهایم با زبان عادی نام ببریم؛ چیزی را که هنوز ثابت نشده روشن کنیم؛ فقط اگر واقعاً لازم است سؤال بعدی بپرسیم؛ و اگر منبع در دسترس نیست، راه پیگیری معتبر را نشان بدهیم. این قالبِ ثابت برای همهٔ سؤالها نیست. پاسخ به شکایت، آموزش یک مرحلهٔ محصول و جواب عددی باید لحن و شکل مناسب خودشان را داشته باشند. (multi instruction و multi prompt بودن)
رساندن جواب هم بخشی از تجربه است. جواب پذیرفتهشده و نتیجهٔ آن نوبت گفتوگو ثبت میشوند؛ ارسال پیام جدا از تولید جواب انجام میشود. اگر برنامه پس از آماده شدن جواب قطع شود، میتواند همان جواب را بفرستد، نه اینکه دوباره مدل را با وضعیت شاید تغییرکردهٔ حساب صدا بزند. این کار بین «به جواب رسیدیم» و «پیام به کاربر رسید» فرق میگذارد؛ تفاوتی ساده اما مهم وقتی موضوع پول است مخصوصا وقتی کاربر تقطیع شده تایپ میکند و پیام ارسال میکند.
جوابدادن به یک نفر کافی نیست؛ تیم باید بداند مشکلها کجا تکرار میشوند. یک کار روزانه و جدا، گفتوگوهای روزی را که تمام شده بررسی میکند. پیامهای هر کاربر در همان روز به ترتیب با هم خلاصه میشوند، بعد موضوعهای مهم از این خلاصهها بیرون میآیند و گزارشی با شمار موارد بررسیشده و جامانده ساخته میشود. واحد کار هر کاربر در هر روز است، نه هر پیام. «پولم کجاست؟»، «دیروز بود» و «منظورم بانک بود» سه مشکل مستقل نیستند.
خود «روز» باید تعریف دقیقی داشته باشد: منطقهٔ زمانی، شروع و پایان بازه و کمی فاصله برای گفتوگوهایی که نزدیک نیمهشب تمام میشوند. پس از دریافت گفتوگوهای آن روز، مجموعهٔ ورودی گزارش ثابت میماند. وگرنه اجرای دوباره ممکن است بیسروصدا دربارهٔ نسخهٔ دیگری از همان روز حرف بزند و مقایسهٔ گزارشها بیمعنی شود.
یک پنجرهی زمانی از گفت و گوی کاربران انتخاب می شود (یک روز شمسی تقویمی)، گفتوگوی هر کاربر با دستیار خلاصه و دغدغههای کاربر استخراج شده و دستهبندی میشوند و یک گزارش روزانه از محصول برای تیم ارسال میشود. این باعث میشود که موارد خاص و استثنایی یا نگران کننده شناسایی شده و گزارش شود.
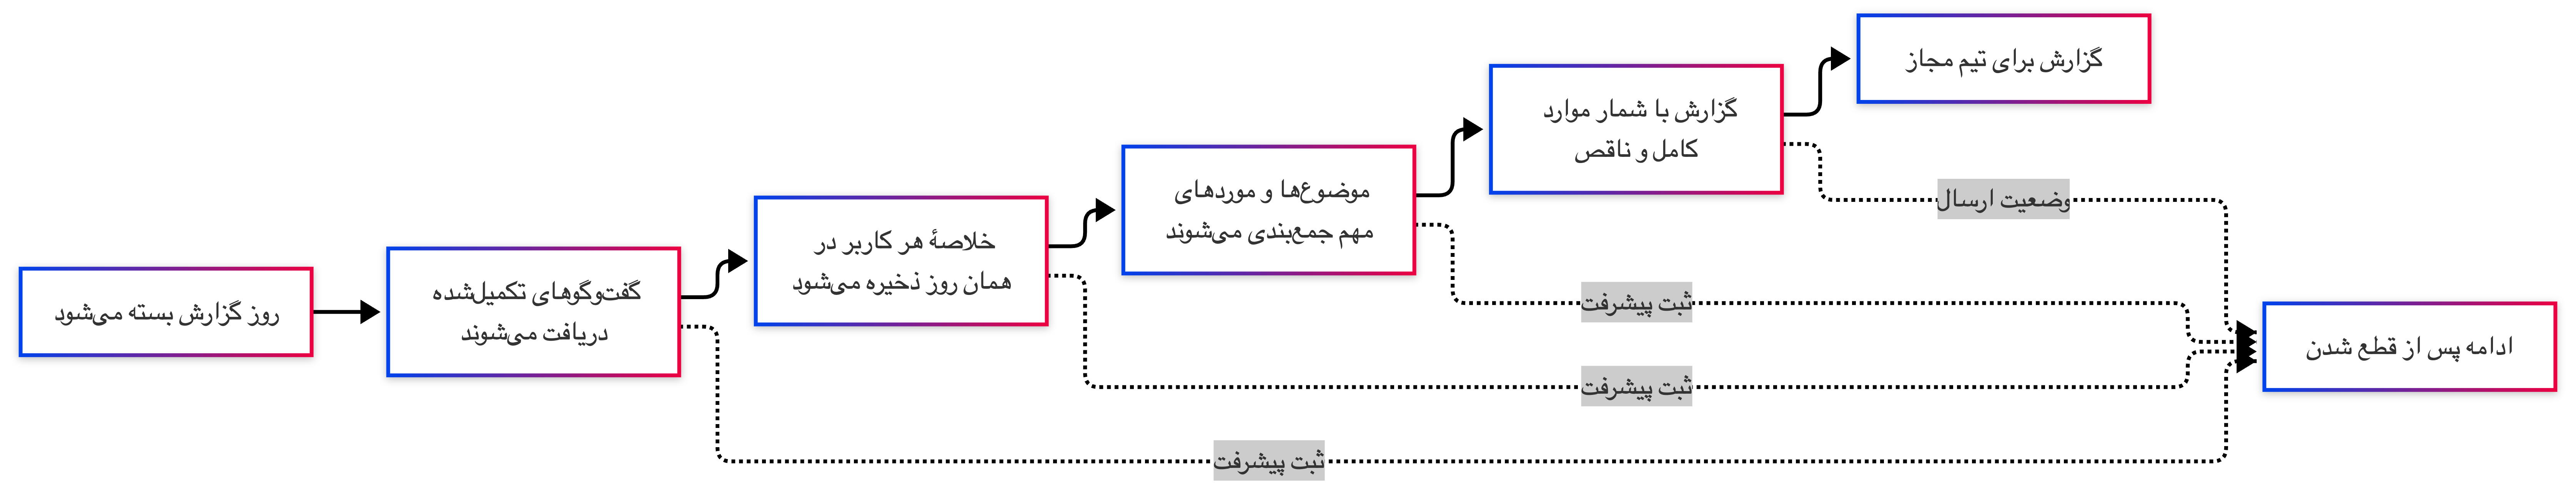
کنار موضوعهای گزارش باید معلوم باشد چند گفتوگو وارد شده، خلاصهٔ چند کاربر آماده شده و چند مورد جا مانده است. برچسبی مثل «کاربر راضی بود» برداشت مدل از متن است، نه پاسخ به نظرسنجی. اگر یک گزارش پنج خطی بسیار خوب به نظر برسد اما گفتوگوهای سخت آن روز را ندیده باشد، ممکن است دقیقاً مسیر اشتباهی به تیم نشان دهد.
یک گزارش روزانه میتواند چقدر کاربردی باشد؟ به اندازهی یک نیروی پشتیبانی که تمام پیامها و چتها را خوانده و یک گزارش آماده کرده است؛ یک نمونهی مشابه از گزارشی که هر روز توسط تیم محصولی دریافت میکند:
📊 گزارش روزانه 1405/00/00 (2026-00-00)
کاربران: 441 | گفتگوها: 1486 | بیپاسخ: 0
رضایت کاربران: X% (Y از 441)
• تسویه و بازگشت وجه را فوری بررسی کنید: چند کاربر پس از فروش طلا وجه نگرفتهاند و در برخی پروندهها وضعیت «تکمیلشده» با «در صف پرداخت» مغایر است. وضعیت دو برداشت ردشده از سوی بانک و یک پرداخت ناموفق از کیف پول بله نیز روشن نشده؛ وصول بانکی را تطبیق دهید و نتیجه را مستقیم اعلام کنید. (user_id=X1) (user_id=X2) (user_id=X3)
• مغایرت دارایی و پرداخت نیاز به بررسی انسانی دارد: کاربری میگوید پول خریدش کسر شده اما پس از سه روز طلا ثبت نشده؛ گزارشهایی از صفرشدن موجودی پسانداز و نامشخصماندن پرداختهای قدیمیتر هم رسیده است. رسیدها و مانده حسابها بررسی شوند. (user_id=X4) (user_id=X5) (user_id=X6)
• در پرسشهای پسانداز، اختلاف سود دریافتی با برآوردها و نبودِ ریز سودهای روزانه و صورتحساب واریزها بیپاسخ ماند. پاسخگو گاهی بهجای محاسبه مبلغ درخواستی فقط نرخ را تکرار کرد؛ ریز محاسبه و مسیر مشاهده سوابق باید روشن شود.
• خطای «کد ملی نامعتبر است» با وجود تصویر فرم رفع نشد و پاسخ بعدی نامرتبط بود. راهنمای تحویل فیزیکی نیز گاهی مسیر نادرست یا تحویل شمش ۵ گرمی را مطرح کرد، درحالیکه حداقل تحویل ۱۰ گرم است؛ این پاسخها اصلاح شوند. (user_id=X7)
• پرسشهای مربوط به قرارداد، ثبت واحدهای پسانداز، بانک نگهدارنده طلا و طرف قرارداد خرید بیپاسخ ماند؛ یک کاربر هم خواست اعتراضش به مسئولان منتقل شود. پاسخ مستند و مسیر ارجاع مشخص لازم است.
کاهش حدود ۵۰ درصدی تیکتها پس از تغییرات پشتیبانی ارزش توجه دارد که حاصل این سیستم agentic پشتیبانی بوده است. نحوه محاسبه این گونه است: یک منهای تعداد تیکتهای دورهٔ بعد تقسیم بر تعداد تیکتهای دورهٔ قبل.
ما این عدد را به یک پرامپت، عامل یا گزارش نسبت نمیدهیم. کنار آن باید بپرسیم: کاربر همان سؤال را دوباره پرسیده؟ جواب تأییدشده یا قدم بعدی روشن گرفته؟ چقدر طول کشیده؟ سؤال به منبع درست رسیده؟ گزارش روزانه چه سهمی از گفتوگوها را دیده؟ اگر تیکت کمتر شود ولی کاربر بارها همان مسئله را به ربات بگوید، شاید فقط راه درخواست کمک سختتر شده باشد.
گزارش روزانه برای پیدا کردن نمونهها عالی است، اما به تنهایی اثر علّی را ثابت نمیکند. فرض کنید عنوان «تأخیر برداشت» در گزارش زیاد شده است. چند گفتوگوی واقعی را میخوانیم و اولین جای مشکل را پیدا میکنیم: راهنما مبهم بوده؟ سؤال شخصی به راهنمای عمومی رفته؟ خواندن حساب قطع بوده؟ «ارسال شد» در جواب به «واریز شد» تبدیل شده؟ یا خود محصول واقعاً تأخیر داشته؟ جملهٔ کاربر در همهٔ این حالتها میتواند «پولم نیومده» باشد؛ کار فنیِ بعدی برای هرکدام فرق دارد.
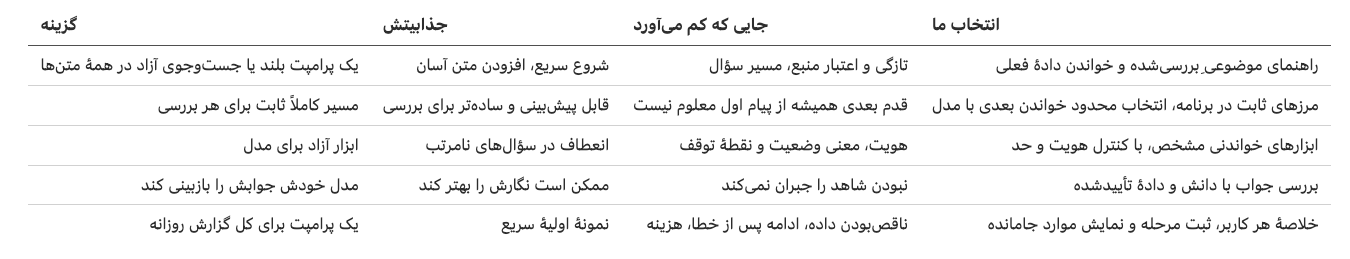
این جدول نسخهٔ واحد برای همهٔ محصولات نیست. یک ربات پرسشوپاسخ ساده شاید به این همه بخش نیاز نداشته باشد. عاملی که اجازهٔ انجام عملیات مالی داشته باشد، برعکس، به تأیید صریح کاربر، جلوگیری از تکرار عملیات و بررسی نتیجهٔ نامطمئن هم نیاز دارد. مسیر گفتوگوی فعلی ما انجام عملیات مالی را به مدل نمیسپارد. اندازهٔ معماری باید با قدرت ادعا و کاری که از عامل میخواهیم هماهنگ باشد.
با ده سؤال شبیه سؤالهای واقعی شروع کنید، نه با انتخاب فریمورک یا معماری عجیبغریب! برای هر سؤال بنویسید قویترین جملهای که عامل حق دارد بگوید چیست و کدام منبع آن را ثابت میکند. کنار هر سؤال چند نمونهٔ نزدیک بگذارید: محصول دیگری با همان واژهها، پیام کوتاه وابسته به قبل، مبلغ بدون واحد، رکورد بیرون از بازهٔ پیشفرض، قطعی منبع و وضعیتی که فقط یک مرحلهٔ میانی را ثابت میکند.
بعد مسیر، قرارداد ابزار و بررسی جواب را برای همین نمونهها تعریف کنید. مسیر انتخابشده، نوع شاهد، محدودهٔ جستوجو و علت رد شدن جواب را ثبت کنید؛ لازم نیست فکر پنهان مدل را ذخیره کنید. هر شکست را از اولین مرحلهٔ اشتباه بررسی کنید، نه فقط از آخرین جمله. هر بار یک بخش را تغییر دهید و سؤالهای نزدیک را هم دوباره ببینید. بعد سراغ گفتوگوهای واقعی بروید و ببینید آیا مردم مجبور شدهاند همان مسئله را دوباره مطرح کنند.
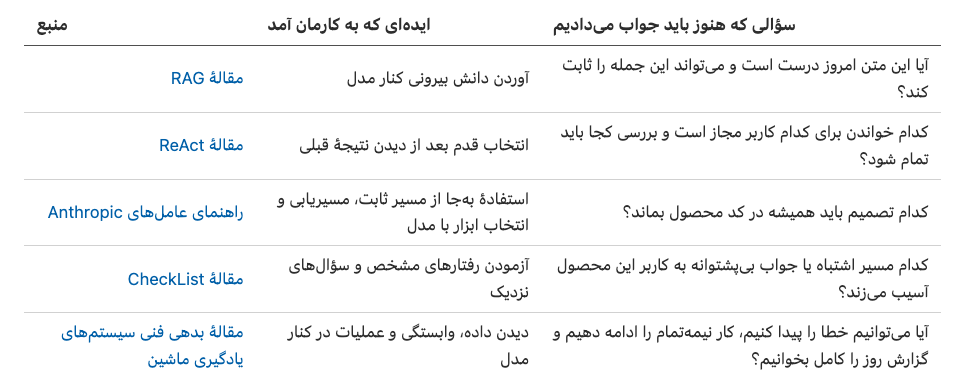
این روش به ایدهٔ آزمون رفتاری CheckList نزدیک است: یک نمرهٔ کلی ممکن است خطایی را پنهان کند که برای کاربر بسیار مهم است. بحث بدهی فنی پنهان در سیستمهای یادگیری ماشین هم یادآوری میکند مدل فقط یک جزء از مجموعهٔ دادهها، وابستگیها و بازخوردهاست. برای ارزیابی خود عاملها نیز راهنمای Anthropic به دیدن نتیجهٔ کار و مسیر رسیدن به آن کمک میکند، نه فقط پسندیدن متن آخر.
این منابع برای بخشهای مختلف کار مفید بودند؛ هیچکدام بهتنهایی نقشهٔ آمادهٔ پشتیبانی یک محصول مالی نیستند.
هدفمان این نبود که دستیار همیشه جواب قطعی بدهد. میخواستیم وقتی شاهد هست، جواب را سریع و روشن بدهد؛ وقتی چیزی معلوم نیست، سؤال مفید بپرسد؛ و وقتی منبعی حد دارد، آن حد را از کاربر و تیم پنهان نکند. همین صداقت فنی است که جواب پشتیبانی را قابلاعتماد میکند.

