
روزانه چند ساعت از زمانتون رو صرف Code Review میکنید؟
و سؤال مهمتر اینه:
آیا کیفیت Review برای همه Pull Requestها یکسانه؟
فرض کنید یک Developer فقط این خط رو تغییر داده:
_repository.GetUser(id)
خود این خط ممکنه کاملاً سالم به نظر برسه.
اما اگر GetUser داخل Repository یک Query ناامن داشته باشه، یا این تغییر باعث نقض معماری پروژه شده باشه، Reviewer فقط با دیدن Diff متوجهش نمیشه.
اینجاست که تفاوت بین یک LLM که Diff رو میخونه و یک Code Review Agent واقعی مشخص میشه.
تو این مقاله یکی از AI Code Reviewerهایی که اخیراً خیلی مورد توجه قرار گرفته رو بررسی میکنم: Open Code Review از Alibaba.
و با هم معماری و جزئیات پیادهسازیش رو مرور میکنیم.
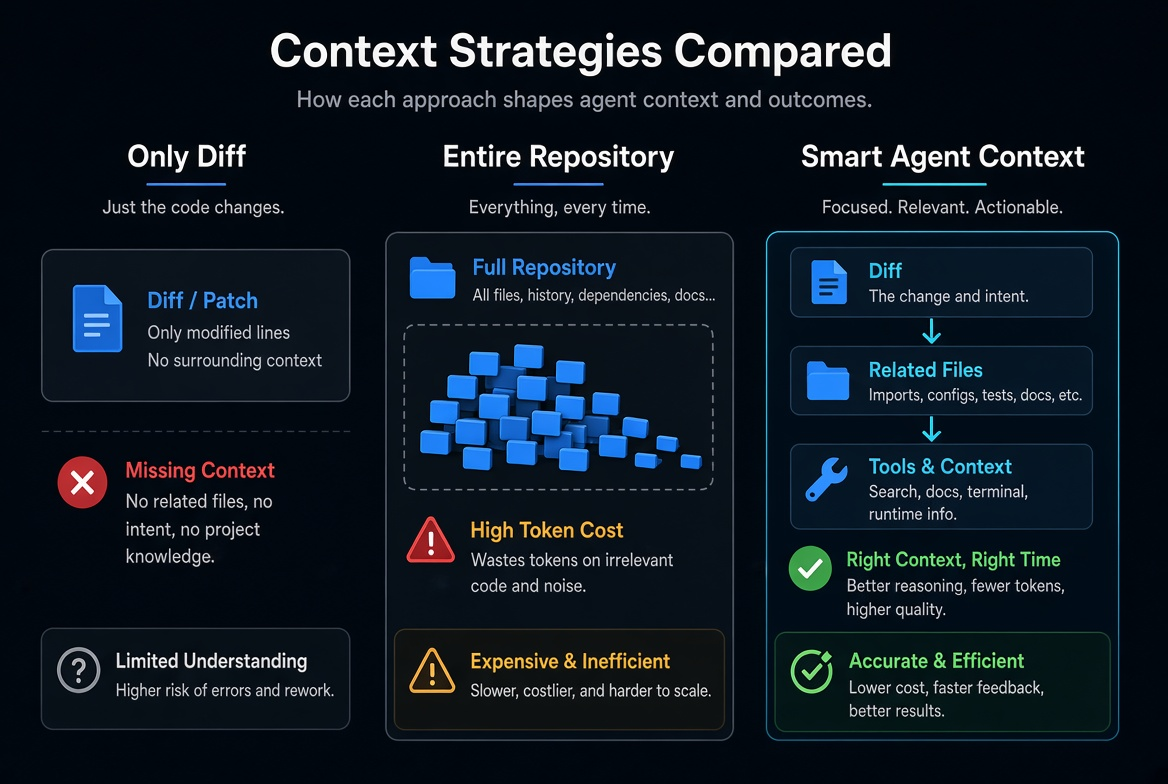
۱. فقط Diff
سریع و ارزان.
اما Context خیلی محدودی داره و dependencyها رو نمیبینه. مدل فقط همون چند خط تغییرکرده رو میبینه و نمیتونه بفهمه که این تغییر چه تأثیری روی بقیه سیستم داره.
۲. کل Repository
در ظاهر کاملترین راهه، ولی برای پروژههای واقعی هم از نظر Token Cost و هم Context Window غیرعملیه. ارسال صدها هزار خط کد به مدل نه منطقیه و نه پایدار.
۳. Context هوشمند (رویکرد Agent)
اینجا Diff فقط نقطه شروعه.
سیستم اول با منطق معمولی مشخص میکنه چه فایلهایی تغییر کردن و کدوم فایلها باید با هم Review بشن.
مثلاً OrderService.cs و OrderRepository.cs میتونن یک Review Unit باشن.
بعد این Unit به یک Agent داده میشه.
Agent کل Repository رو از اول نمیخونه. اگر وسط Review به _repository.GetUser(id) برسه و نیاز داشته باشه بدونه GetUser دقیقاً چطور پیاده شده، با Toolهایی مثل File Read یا Repository Search فایل مرتبط رو پیدا و بررسی میکنه.
یعنی:
Diff مشخص میکنه از کجا شروع کنیم؛ Agent تصمیم میگیره برای فهمیدن، کدوم Context بیشتری لازم داره.
پروژهای که اخیراً روش کار میکردم محدودیتهای infrastructure داشت؛ مجبور بودیم از مدل داخلی سازمان استفاده کنیم.
اول سراغ ابزارهای آماده رفتم، اما بعد این سؤال برام جدی شد:
> اگر خودمون بخوایم یک AI Code Reviewer بسازیم، معماریش باید چی باشه؟
یکی از پروژههایی که بررسی کردم Open Code Review بود.
این ابزار حدود دو سال داخل Alibaba در مقیاس واقعی (دهها هزار Developer و میلیونها نقص شناساییشده) استفاده شده و بعداً متنباز شده.
نکته جالبش برای من این بود که همهچیز رو به LLM نسپرده.
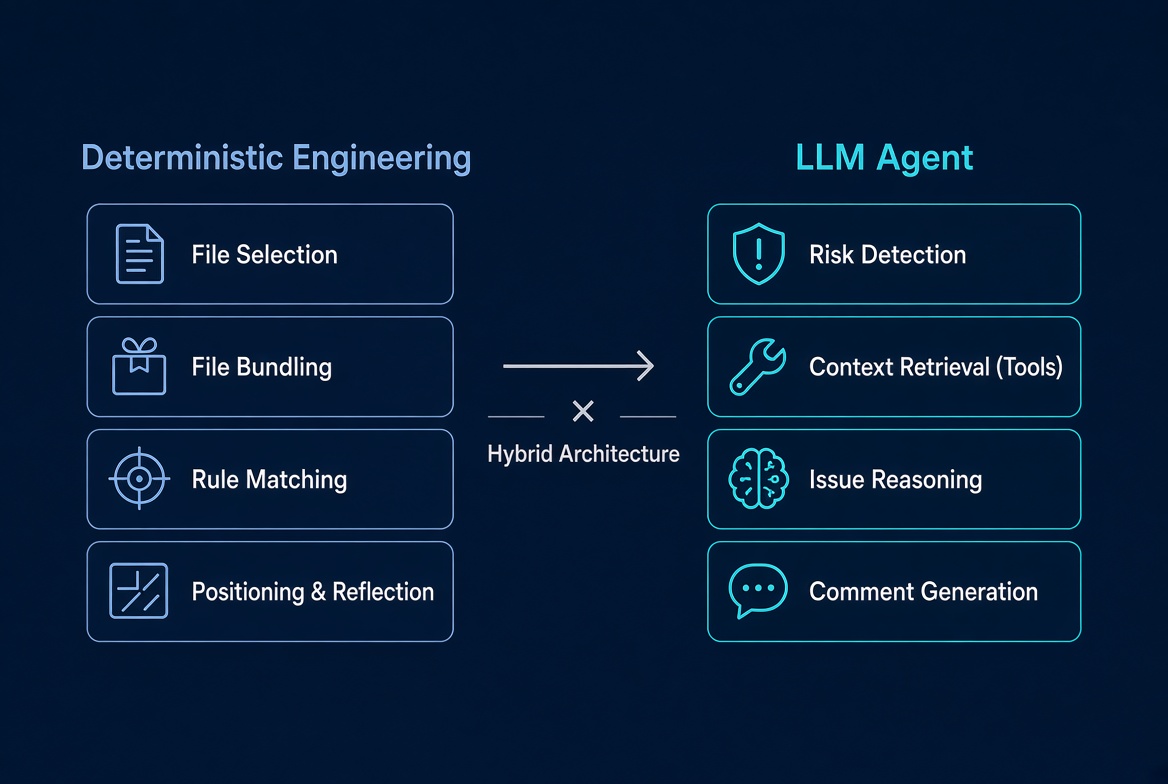
معماریش ترکیبی از این دو بخشه:
Deterministic Engineering + LLM Agent
یعنی هر چیزی که میشه با کد معمولی و قابلاطمینان انجام داد، اصلاً نیازی نیست LLM انجام بده.
LLM فقط جایی وارد میشه که واقعاً به reasoning نیاز داریم.
چرا این معماری رو انتخاب کردن؟
تجربه نشون داده که Agentهای عمومی (مثل Claude Code با Skills) در Code Review مشکلات مشخصی دارن:
- روی Changesetهای بزرگ تنبلی میکنن و بعضی فایلها رو اصلاً بررسی نمیکنن (Incomplete Coverage).
- شماره خط Commentها اغلب جابهجا میشه (Position Drift).
- کیفیت Review با تغییرات کوچک Prompt بهشدت نوسان میکنه (Unstable Quality).
ریشه مشکل اینه که یک معماری کاملاً زبانمحور (Purely Language-driven) هیچ قید سخت (Hard Constraint) روی فرآیند Review نداره.
مدل هم تصمیم میگیره چه فایلی رو ببینه، هم تصمیم میگیره کجا Comment بذاره، هم تصمیم میگیره Ruleها رو چطور اعمال کنه.
نتیجه؟ رفتار غیرقابلپیشبینی.
Open Code Review این مسئولیتها رو از هم جدا کرده:
| بخش | مسئول | چرا؟ |
| انتخاب فایلها | کد معمولی (Deterministic) | نباید فایلی از قلم بیفته |
| گروهبندی فایلهای مرتبط | کد معمولی | Context کنترلشده و قابلمدیریت |
| تطبیق Rule با فایل | کد معمولی | تمرکز مدل روی Ruleهای مرتبط |
| موقعیت دقیق Comment | ماژول جدا (Positioning) | جلوگیری از Drift شماره خط |
| تشخیص مشکل واقعی | LLM Agent | نیاز به reasoning و فهم Context |
| پیدا کردن Context بیشتر | LLM Agent + Tools | تصمیم پویا در حین Review |
جزئیات پیادهسازی معماری
جریان واقعی تقریباً این شکله:
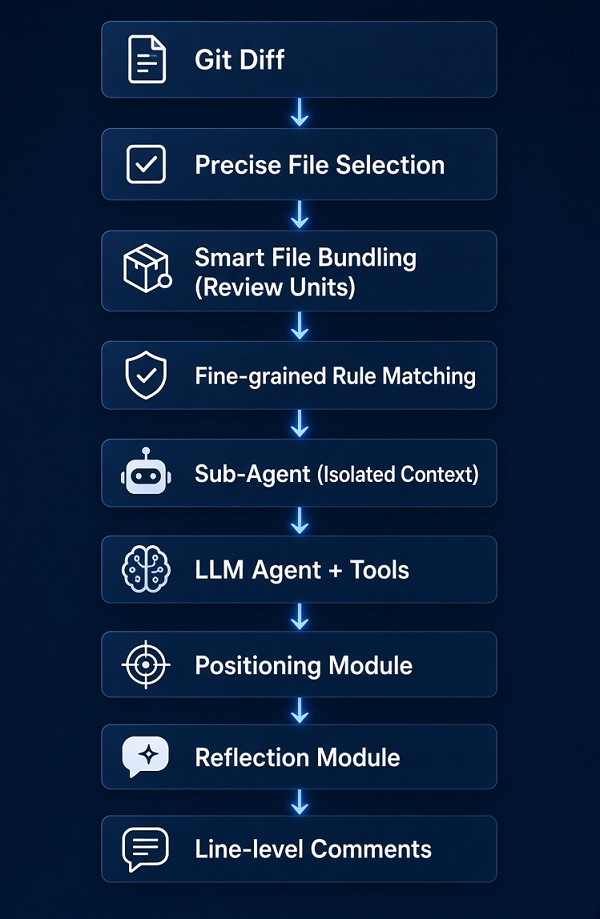
۱. Precise File Selection
سیستم دقیقاً مشخص میکنه کدوم فایلها باید Review بشن و کدومها باید فیلتر بشن (باینری، تست، extensionهای پشتیبانینشده و غیره).
این کار تضمین میکنه هیچ تغییر مهمی از قلم نیفته.
۲. Smart File Bundling
فایلهای مرتبط با هم در یک Review Unit قرار میگیرن.
مثلاً message_en.properties و message_zh.properties با هم بررسی میشن.
هر Unit بهصورت یک Sub-Agent با Context ایزوله اجرا میشه.
این رویکرد Divide-and-Conquer دو مزیت بزرگ داره:
- روی Changesetهای خیلی بزرگ پایدار میمونه.
- بهصورت طبیعی از Concurrent Review پشتیبانی میکنه (چند Sub-Agent همزمان کار میکنن).
۳. Fine-grained Rule Matching
Ruleها بر اساس Path فایل تطبیق داده میشن، نه اینکه همه Ruleها داخل یک Prompt بزرگ بریزن.
مثلاً:
**/*Controller.cs → Controllers نباید مستقیم Repository رو صدا بزنن
**/*Repository.cs → Queryها از نظر SQL Injection و Parameterization بررسی بشن
**/*Mapper.cs → Null Handling و Mapping بررسی بشه
وقتی OrderController.cs تغییر میکنه، اول یک Rule Matcher مشخص میکنه چه Ruleهایی به این فایل مربوط هستن.
بعد فقط همون Ruleها وارد Context مربوط به Agent میشن.
این کار نویز اطلاعاتی رو از منبع کم میکنه و توجه مدل رو متمرکز نگه میداره.
۴. Agent و Toolها
اینجا بخش LLM شروع میشه.
Agent یک Context اولیه داره، ولی محدود به همون Context نیست.
اگر برای تصمیمگیری نیاز داشته باشه، میتونه از Toolهایی مثل:
- Read File
- Search Repository
- Inspect Related Code
استفاده کنه.
مثال واقعی:
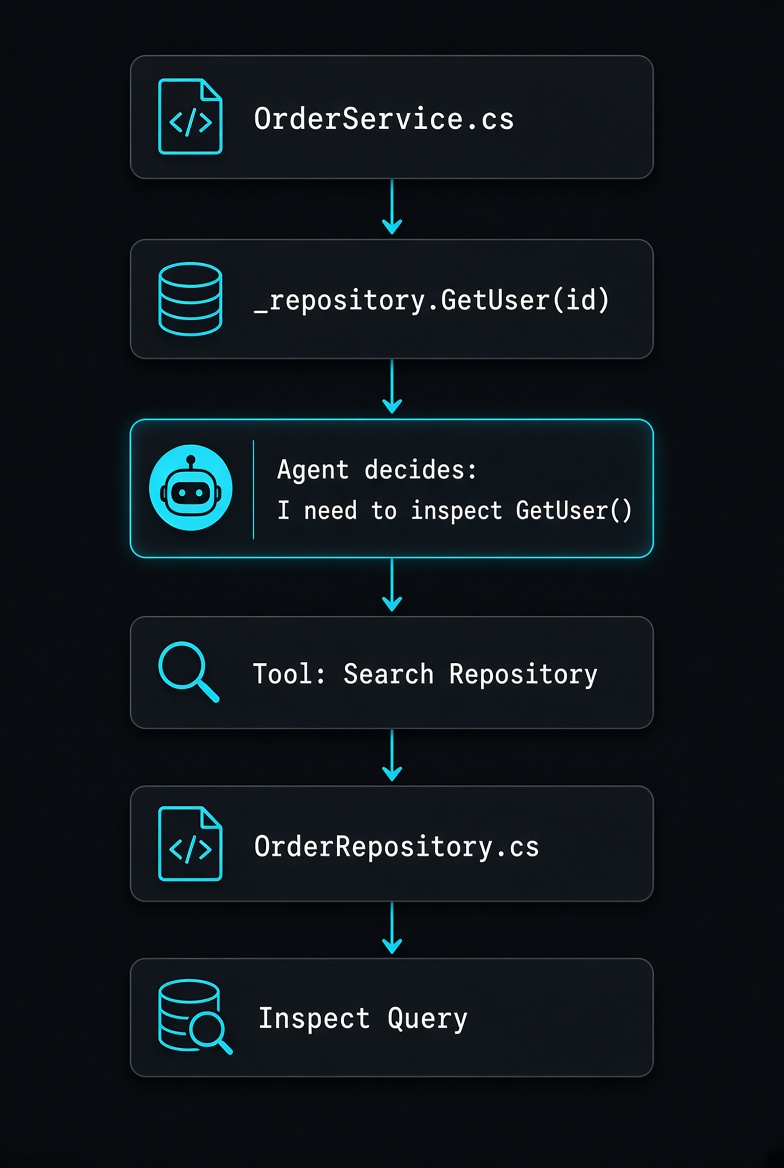
یعنی بهجای اینکه از اول کل Codebase رو به مدل بدیم، اجازه میدیم خود Agent Context موردنیازش رو پیدا کنه.
۵. Positioning و Reflection
یکی از مشکلات رایج Code Review با LLM اینه که مدل مشکل واقعی رو پیدا میکنه، اما خط اشتباهی رو به Developer نشون میده.
Open Code Review یک ماژول جدا برای Positioning داره (با استراتژی سهمرحلهای progressive) و یک ماژول Reflection برای بررسی دوباره محتوا.
این دو لایه بعد از تولید Comment توسط Agent اجرا میشن تا هم موقعیت و هم کیفیت محتوا بهتر بشه.
برای ساختن یک AI Code Reviewer، لازم نیست همهچیز رو به LLM بسپاریم.
اتفاقاً برعکس.
هر چیزی که میتونیم deterministic حل کنیم، بهتره به LLM نسپاریم.
چون LLM در کارهایی که نیاز به تضمین و تکرارپذیری دارن، ذاتاً ضعیفتره.
LLM باید جایی وارد بشه که واقعاً نیاز به reasoning داریم:
- آیا این کد مشکل داره؟
- آیا این Rule در این Context نقض شده؟
- آیا برای تصمیمگیری باید فایل دیگهای رو ببینم؟
- و در نهایت چه چیزی باید به Developer گزارش بشه؟
پس معماری کلی میتونه چیزی شبیه این باشه:
و به نظرم همینجا تفاوت بین یک AI-powered Code Review ساده و یک Code Review Agent واقعی مشخص میشه.
مسئله اصلی فقط این نیست که:
«چطور یک LLM رو به GitLab وصل کنیم؟»
مسئله اینه که:
چطور Context درست، Rule درست و ابزار درست رو در زمان درست در اختیار LLM قرار بدیم؟

