
همانطور که از نام الگوهای غالب بر میآید، الگوهایی هستند که در دادهها فراوان اتفاق میافتند. انواع مختلفی از این قبیل الگوها وجود دارد که شامل مجموعه اقلام تکراری - Frequent itemsets- زیر دنبالههای تکراری - Frequent sub-sequences - (الگوهای دنبالهای - Sequential patterns) و زیر ساختارهای تکراری - Frequent substructures - می باشند. یک مجموعه اقلام تکراری به صورت معمول در یک پایگاه داده تراکنشی نمایان میشود (برای مثال شیر و نان به صورت معمول با هم دیگر به فروش میرسند) الگوهایی مانند این که مشتری ابتدا دوست دارد یک لپتاپ بخرد و بعد از آن یک دوربین دیجیتالی و در انتها یک کارت حافظه، نیز یک زیر دنباله تکراری است. زیر ساختارها منابع زیادی دارند، برای مثال گرافها، درختها، و... که ممکن است با مجموعه اقلام تکراری و زیر دنبالههای تکراری ترکیب شود. در صورتی که یک زیر ساختار تکرار شود، الگوی ساختاری تولید میشود. تحلیل الگوهای تکراری میتواند به کشف روابط همبسته و وابسته جالبی در دادهها بیانجامد.
فرض کنید مدیر بازاریابی شرکت آلالکترونیکس هستید و میخواهید محصولاتی را که به صورت معمول با هم دیگر به فروش میروند، شناسایی کنید (در یک تراکنش). یک قانون که از پایگاه داده تراکنشی شرکت به دست میآید میتواند به صورت زیر باشد.
{اطمینان = 50% ، پشتیبان = 1%} (نرم افزار، X) خرید <= (رایانه، X) خرید
در این جا X، نشان دهنده یک مشتری است. اطمینان - Confidence - یا قطعیت - Certainty - %50 به این معنا است که اگر یک مشتری رایانهای خریداری کند، با احتمال 50% نرم افزاری نیز خریداری میکند. پشتیبان - Support - %1 نیز به این معناست که در 1% کل تراکنشها نرم افزار و رایانه همراه با هم خریداری شدهاند. این قانون وابسته یک خصوصیت را که تکرار میشود، نشان میدهد. قوانین وابستهای که شامل یک پیشبینی کننده هستند، قوانین وابسته یک بعدی نامیده میشوند. با تغییر طرز نوشتن پیشبینی کننده میتوان قانون را به صورت زیر سادهسازی نمود.
{ %50، %1} نرم افزار <= رایانه
حال فرض کنید پایگاه داده ارتباطی شرکت آلالکترونیکس برای این منظور به کار رود. در این حالت ممکن است قانونی به صورت زیر تولید شود:
{%60 = اطمینان، 2% = پشتیبان} (رایانه،X)خرید<=(49000،...،40000،X)درآمد ^(29،...،20،X)سن
این قانون نشان دهنده این است که 2% از مشتریان آلالکترونیکس بین 20 تا 29 سال سن دارند و درآمد آنها نیز بین 40000 دلار تا 49000 دلار است و رایانهای خریداری کردهاند. در نتیجه مشتریانی که در این گروه سنی و درآمد قرار دارند، به احتمال 60% یک رایانه خریداری خواهند کرد. در این حالت یک قوانین وابسته با بیش از یک خصوصیت یا پیشبینی کننده (سن، درآمد و خرید) وجود دارد. به همین علت همانند پایگاه داده چند بعدی، این قانون را میتوان قانون وابسته چند بعدی نامید.
به صورت معمول، در صورتی که یک قانون وابسته حد آستانه اطمینان و پشتیبان را ارضا نکند، کنار گذاشته میشود. تحلیل بیشتر منجر به شناخت قوانین همبسته آماری بین جفتهای خصوصیت - مقدار می شود.
شناسایی مجموعه اقلام تکراری یک حالت بنیادی از شناسایی الگوهای تکراری است. شناسایی الگوهای تکراری، وابسته و همبسته در فصول 6 و 7 توضیح داده خواهد شد. در این دو فصل الگوریتمهای کارا برای این منظور توضیح داده میشوند. شناسایی الگوهای دنبالهای و ساختاری نیز مربوط به مباحث پیشرفته است.
دستهبندی فرآیند شناسایی یک مدل که بتواند دستهها و مفاهیم را تعریف کند، است. مدل با تحلیل دادههای آموزشی (دادههایی که برچسب دسته مشخصی دارند) تولید میشود. سپس از آن برای پیشبینی دادههایی که دارای برچسب دسته نیستند، استفاده میشود.
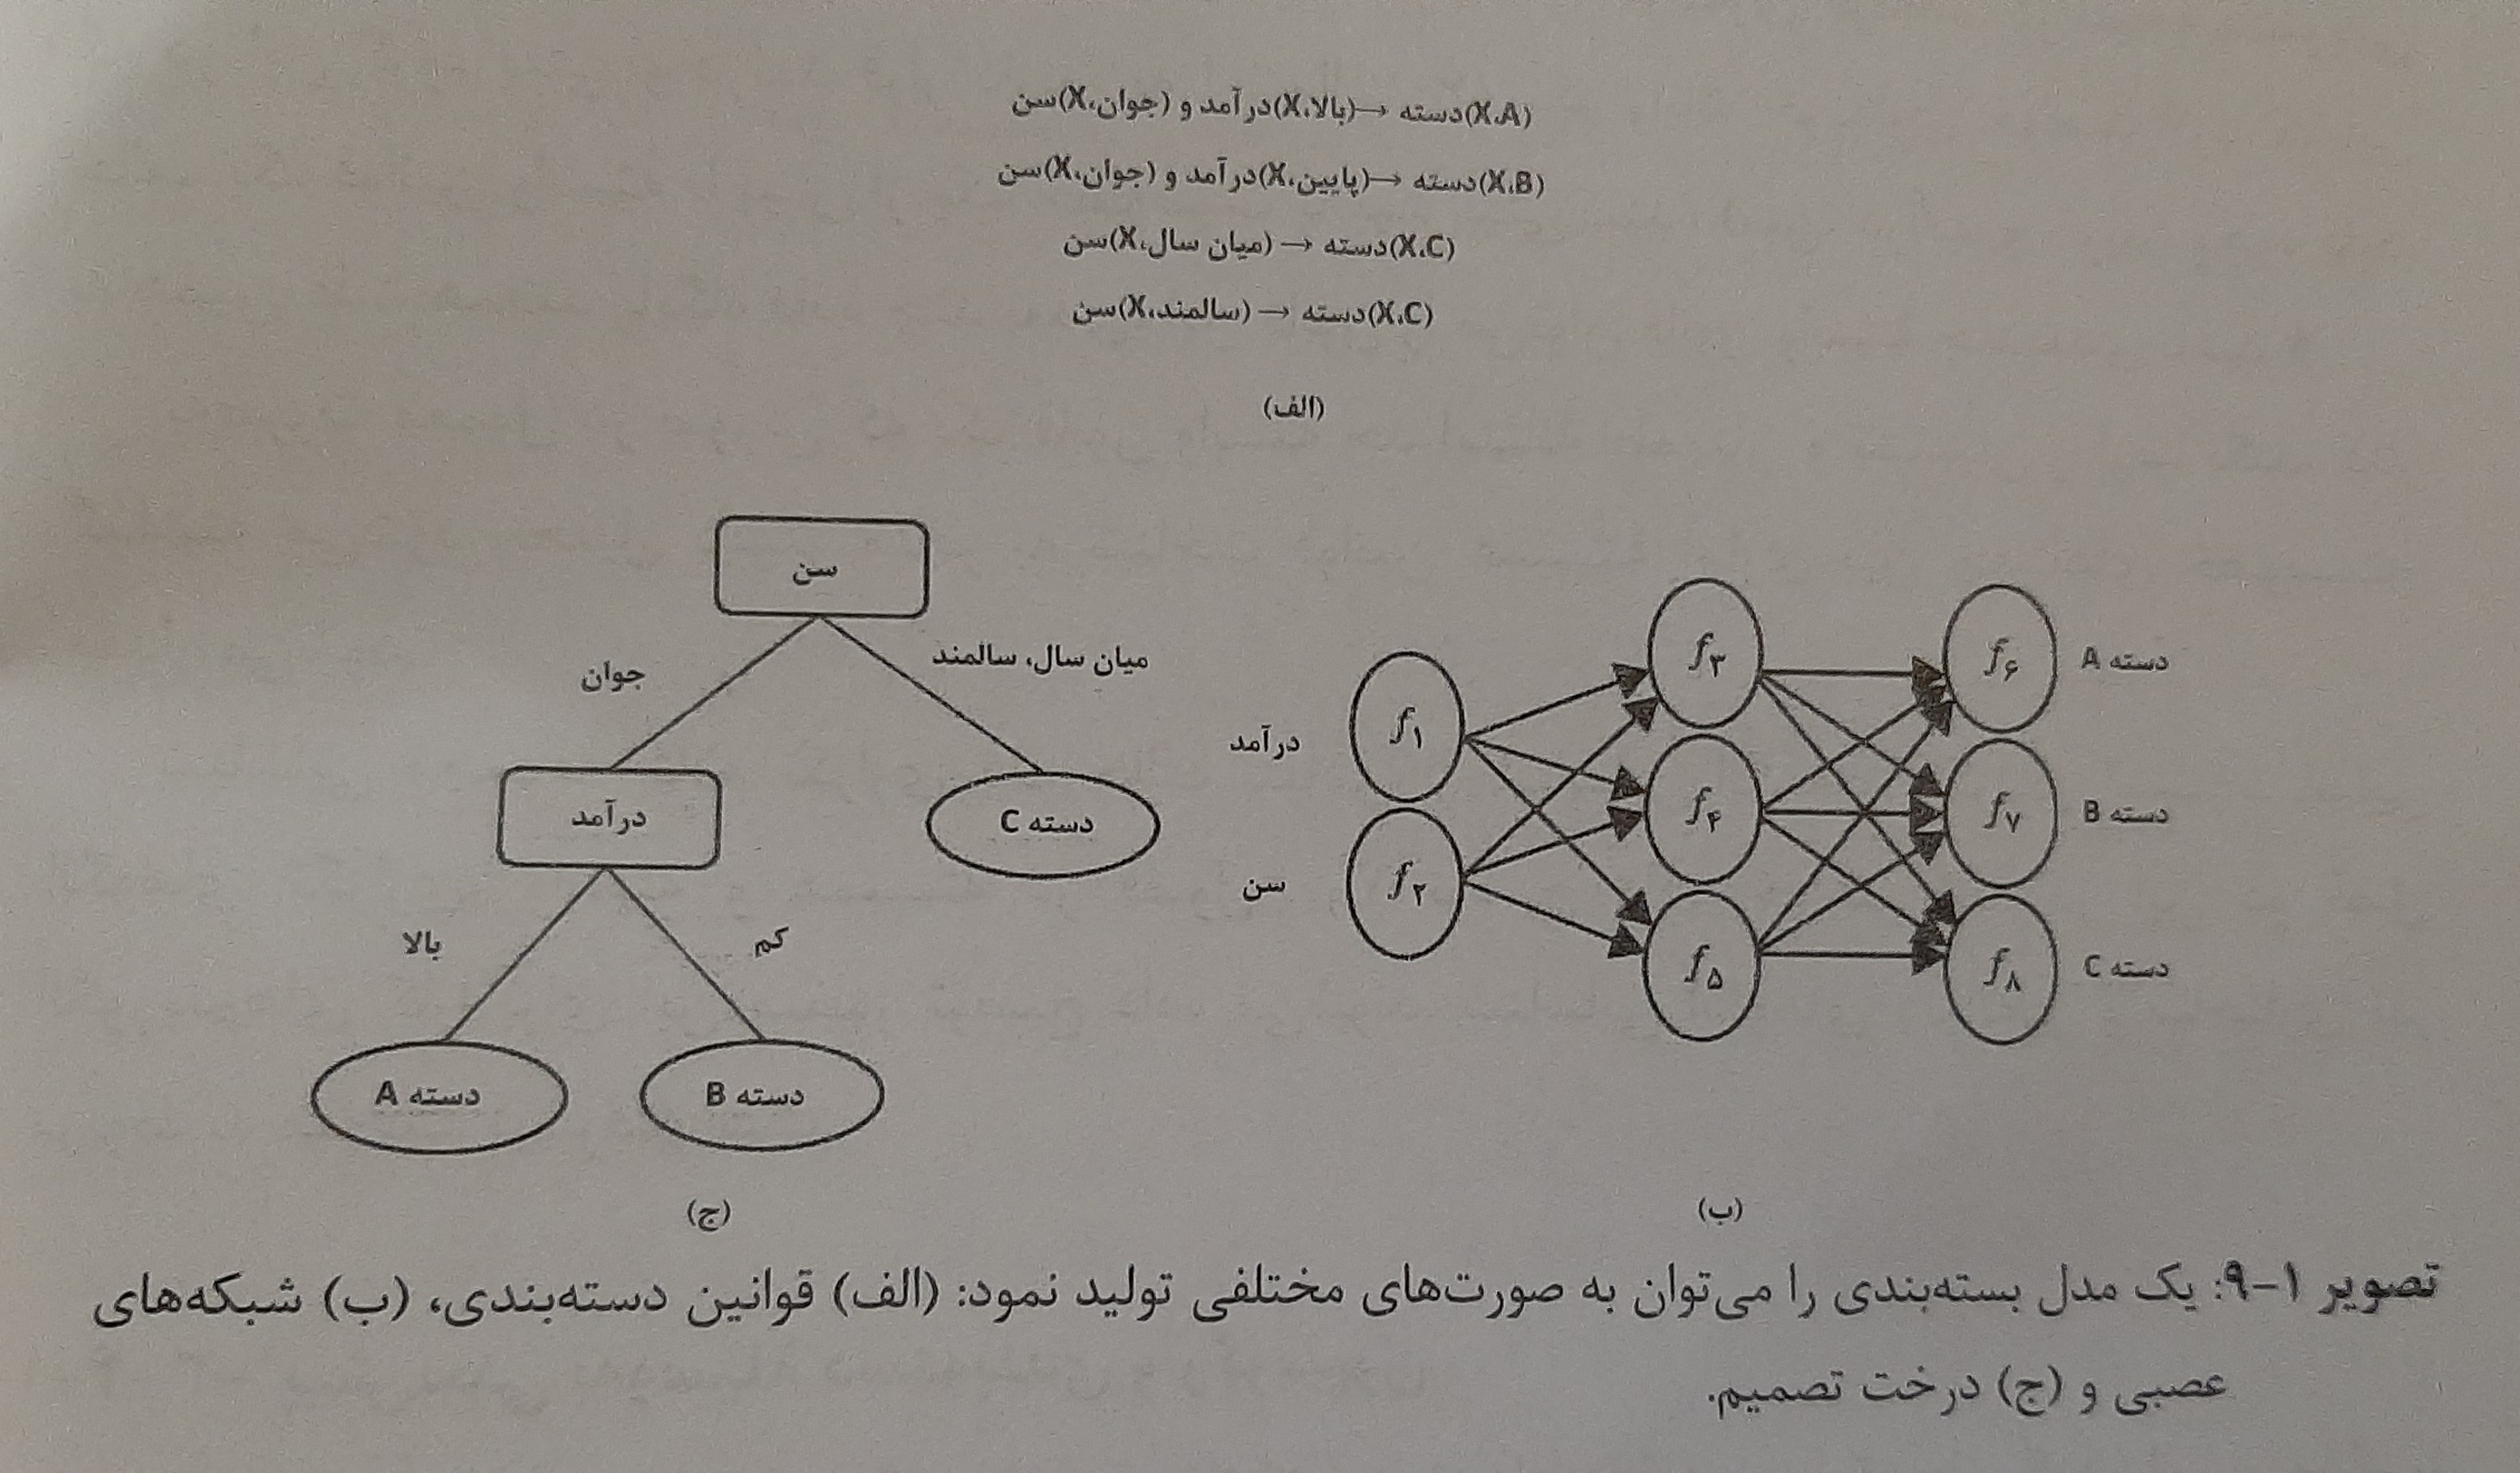
مدل تولید شده چگونه نمایش داده میشود؟ مدل ممکن است به شکلهای مختلفی نمایش داده شود، برای مثال ممکن است با قوانین دستهبندی - Classification Rules - (قوانین اگر - آن گاه)، درختهای تصمیم - Decision Tree - فرمولهای ریاضی و شبکههای عصبی - Neural Network - نمایش داده شوند. یک درخت تصمیم ساختاری درختوار است که هر گره آن نمایانگر یک آزمایش برای مقادیر مختلف یک خصوصیت است، هر شاخه نمایانگر نتیجه آزمایش و هر برگ درخت نشاندهنده دستهها و یا توزیع آنها است. درختهای تصمیم را میتوان به راحتی به قوانین دستهبندی تبدیل نمود. یک شبکه عصبی زمانی که برای دستهبندی به کار میرود مجموعهای از نورونهایی است که کار پردازش وزندهی ارتباطات مابین را انجام میدهند. روشهای مختلف دیگری برای دستهبندی وجود دارد که از آن جمله میتوان به دسته بندی ساده بیزی - Naïve Baysian - ماشینهای بردار پشتیبان - Support Vector Machine - و k همسایه نزدیک - k-nearest neighbor - اشاره نمود.
در حالی که دستهبندی برچسب دادههای طبقهای یا گسسته را پیشبینی میکند، مدلهای رگرسیون برای دادههای پیوسته کاربرد دارند. از رگرسیون بیشتر برای پیش بینی دادههای گم شده پیوسته استفاده میشود تا برچسب دسته دادهها. تحلیل رگرسیون یک روش آماری است که با وجود سایر روشها برای پیشبینی مقادیر پیوسته به کار میرود. همچنین از رگرسیون برای شناسایی روندهای توزیع نیز استفاده میشود.
در برخی مسائل دستهبندی و رگرسیون تحلیل ارتباطات و شناخت خصوصیاتی که بیشترین ارتباط با مسئله را دارند، امری ضروری است. به این ترتیب خصوصیات مرتبط را میتوان انتخاب نمود و خصوصیات غیرمرتبط را از فرآیند تحلیل حذف کرد.
فرض کنید مدیر فروش شرکت آلالکترونیکس هستید و میخواهید تعداد زیادی از کالاها را دستهبندی کنید. این دستهبندی بر مبنای پاسخ مشتریان به پیشنهاد محصولات است و شامل: پاسخ خوب، پاسخ مناسب و بدون پاسخ است. شما قصد دارید مدلی تولید کنید که با استفاده از ویژگیهای محصولات (مانند قیمت، برند، ساخت، نوع و طبقه)، دستهبندی را انجام دهد. مدل دستهبندی تولید شده میبایست تمیزی بین این سه دسته تولید کند و یک تصویر کلی از ساختار پایگاه داده تولید کند.
فرض کنید مدل تولید شده یک درخت تصمیم باشد. درخت تصمیم ممکن است قیمت را به عنوان یک معیار برای جداسازی سه دسته شناسایی کند. همچنین ممکن است این درخت علاوه بر قیمت از خصوصیات دیگری مانند برند و محل ساخت را نیز برای شناسایی بیشتر دستهها از یک دیگر استفاده کند. این درخت تصمیم میتواند به پیشنهادهای فروش بهتر و اثربخشتری در آینده بیانجامد.
حال فرض کنید به جای پیشبینی پاسخگویی برای هر محصول فروشگاه، هدف شما پیشبینی عایدی هر محصول در مدت فروش آینده شرکت با توجه به اطلاعات گذشته فروش هر یک باشد. این کار مثالی از تحلیل رگرسیون است و مدل تولید شده میتواند یک خصوصیت پیوسته و یا ترتیبی را پیشبینی کند.
در فصول 1 و 2 جلد دوم کتاب در مورد دستهبندی توضیحات بیشتری داده خواهد شد. تحلیل رگرسیون نیز خارج از اهداف این کتاب است و برای کسب اطلاعات بیشتر میتوان به منابع معرفی شده در کتاب شناسی این فصل رجوع کرد.

