
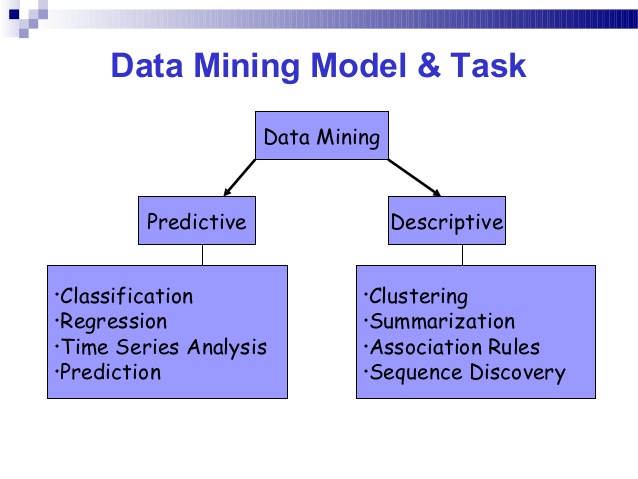
تا اینجا با گونههای متنوع مخازن دادهها و اطلاعاتی که میتوانند مورد دادهکاوی قرار گیرند، آشنا شدیم. حالا میخواهیم با انواع الگوهایی که میتوانند مورد کاوش قرار گیرند، آشنا شویم.
دادهکاوی عملگرهای زیادی دارد. این عملگرها شامل ویژگی و تمایز - Discrimination - کاوش الگوهای تکراری، پیوستگیها و وابستگیها، دستهبندی و رگرسیون، تحلیل خوشهبندی و تحلیل دورافتادگی میشود. عملگرهای دادهکاوی برای پیداکردن انواع الگوهای مشخص در عملیات دادهکاوی استفاده میشوند. این قبیل کاربردها به صورت کلی به دو دسته تقسیم میشوند: توصیفی - Descriptive - و پیشبین - Predictive -. پروژههای کاوش توصیفی، ویژگیهای داده را در یک مجموعه داده هدف توصیف میکنند. پروژههای کاوش پیشبین با استفاده از استقرا روی دادههای در دسترس به انجام پیشبینی میپردازند.
عملگرهای دادهکاوی و انواع الگوهایی که میتوانند کشف کنند در ادامه توضیح داده میشوند. به علاوه اینکه بخش 6-1-4 به موضوع تعریف الگوی جذاب میپردازد.
ورورد اطلاعات ممکن است مبتنی بر دستهها و یا مفاهیم صورت پذیرد. برای مثال در فروشگاههای شرکت آلالکترونیکس دستههای اجناس برای فروش شامل رایانهها و پرینترها است و مفاهیم مشتریان شامل مشتریان ولخرج و مقتصد است. توصیف هر کدام از دستهها و مفاهیم در عین خلاصهبودن میتواند بسیار کارا باشد. این توصیفها را میتوان از 1) ویژگیهای دادهها - Data Characteristic- به واسطه خلاصهسازی دادههای موجود برای دسته مورد مطالعه یا هدف تولید نمود، یا با 2) تمیزکردن دادهها به واسطه مقایسه دستههای هدف با سایر دستهها تولید نمود، و یا این که از 3) ترکیب ویژگیها و تمایز دادهها برای این منظور بهرهبرد.
ویژگیهای دادهها خلاصه ویژگیها و یا خصوصیات کلی دسته هدف است. همچنین برای تولید دادههای مربوط به یک دسته خاص که کاربر مشخص میکند از جستجو استفاده میشود. برای مثال برای بررسی ویژگیهای محصولات نرمافزاری با رشد فروش 10% نسبت به سال قبل، میبایست اطلاعات وابسته به محصولات مورد نظر از پایگاه داده فروش جستجوی SQLگردند.
روشهای مختلفی برای خلاصهسازی دادهها وجود دارد. روشهای ساده خلاصهسازی با استفاده از نمودارها و سنجههای آماری در فصل 2 توضیح داده شدهاند. مکعبهای داده مبتنی بر OLAP در بخش 1-3-2 نیز میتوانند توسط کاربر برای این منظور به کار روند. این فرآیند با جزئیات بیشتر در فصول 4 و 5 توضیح داده شدهاند. روشهای مبتنی بر جهتگیری خصوصیات - Attribute-oriented induction- نیز در فصل 4 با جزئیات بررسی شدهاند، این روشها نیازی به تعامل گام به گام کاربر ندارند.
خروجی ویژگیهای دادهها را میتوان به صورتهای متنوعی نشان داد. برای مثال نمودارهای دایرهای، نمودارهای میلهای، منحنیها، مکعبهای دادههای چند بعدی و جداول چند بعدی. همچنین نتایج توصیف نیز ممکن است به صورت ارتباطات کلی و یا قوانین ویژگی نشان دادهشوند.
ممکن است مدیر ارتباط با مشتریان شرکت آل الکترونیکس چنین هدفی برای دادهکاوی مشخص کند: خلاصهسازی ویژگیهای مشتریانی که بیش از 5000 دلار در سال از شرکت خرید میکنند. نتیجه نمایه کلی چنین مشتریانی است که ممکن است شاغل، دارای سن بین 40 تا 50 سال و رتبه اعتباری عالی باشند. سیستم دادهکاوی باید به مدیر ارتباط با مشتریان اجازه دیدن جزئیات در هر بعدی را دهد. برای مثال رده شغلی این مشتریان با توجه به نوع اشتغال آنها.
مقایسه بین ویژگیها و خصوصیات کلی دادههای دسته هدف با سایر دستهها، تمایز داده است. دستههای هدف و مقایسه توسط کاربر توصیف میشوند و دادههای مرتبط با آنها با استفاده از یک جستجو در پایگاه داده به دست میآیند. برای مثال ممکن است کاربری بخواهد خصوصیات کلی محصولات نرمافزاری که رشد فروش حداقل 10% داشتهاند را با محصولاتی که کاهش فروش حداقل 30% داشتهاند مقایسه کند. روشهایی که برای تمایز دادهها به کار می روند، مشابه روشهای به کار گرفته شده برای ویژگیهای دادهها است.
"خروجی تمایز به چه صورت است؟" شکل خروجی تمایز شبیه خروجی توصیف ویژگیها است با این تفاوت که دارای سنجههای مقایسهای بین دستههای هدف و مقایسهای است. توصیف تمایز به واسطه قوانین تمایز تولید میشود.
ممکن است مدیر ارتباط با مشتریان شرکت آلالکترونیکس بخواهد دو گروه از مشتریان را مقایسه کند: مشتریانی که به صورت معمول محصولات رایانهای خریداری میکنند (برای مثال بیش از دو بار در ماه) و مشتریانی که به ندرت چنین محصولاتی خریداری میکنند (برای مثال کمتر از سه بار در سال). نتیجه این توصیف یک نمایه مقایسهای بین مشتریان است، برای مثال 80% مشتریانی که به صورت معمول محصولات رایانهای خریداری میکنند سنی بین 20 تا 40 سال دارند و دارای تحصیلات دانشگاهی هستند، در حالی که 60% مشتریانی که به ندرت چنین محصولاتی خریداری میکنند افراد سال خورده و یا جوانان بدون تحصیلات دانشگاهی هستند. با تجزیه بیشتر نتایج بر یکی از ابعاد مثل رده شغلی و یا اضافهکردن یک بعد مثل سطح درآمد میتواند به تمایز بیشتر خصوصیات بین دو دسته بیانجامد.
مفاهیم توصیف که شامل تمایز و ویژگی است در فصل 4 توضیح داده میشوند.

