
تصور کنید در سال ۱۹۵۹ هستید. مردی به نام آرتور ساموئل در آزمایشگاههای IBM نشسته و به یک ماشین یاد میدهد که بازی چکرز (draughts) را بهتر از خودش بازی کند. او برنامهای نوشته که نه با قوانین ثابت، بلکه با تجربه بهتر میشود؛ برنامهای که هزاران بازی را با خودش انجام میدهد و از هر شکست چیزی یاد میگیرد. ساموئل این پدیده را «یادگیری ماشین» نامید. آن لحظه، شاید بیسروصدا، یکی از مهمترین چرخشهای تاریخ فناوری بود: برای نخستین بار، ماشین قرار نبود فقط دستورها را اجرا کند؛ قرار بود یاد بگیرد.
امروز، بیش از شش دهه بعد، همان ایده ساده به نیرویی تبدیل شده که پشت گوشی شما، پشت پیشنهادهای نتفلیکس، پشت تشخیص تومور در تصاویر پزشکی، پشت خودروهای خودران و پشت چتباتهایی که با شما گفتگو میکنند، ایستاده است. یادگیری ماشین دیگر یک شاخه دانشگاهی حاشیهای نیست؛ ستون فقرات انقلاب هوش مصنوعی است. اما این انقلاب دقیقاً چطور کار میکند؟ چرا گاهی شگفتانگیز است و گاهی بهطرز خندهداری احمق؟ و چه چیزی آن را از «برنامهنویسی معمولی» جدا میکند؟
این مقاله تلاش میکند به این پرسشها پاسخ بدهد؛ نه با فرمولهای خشک، بلکه با داستان، شهود و لایهبهلایه باز کردن مفاهیم. اگر دانشجوی کارشناسی ارشد باشید، اگر معلم باشید، اگر فقط کنجکاو باشید — این متن برای شماست.
بیایید با یک مثال ساده شروع کنیم. فرض کنید میخواهید برنامهای بنویسید که تشخیص دهد در یک عکس، گربه هست یا نه.
روش سنتی (برنامهنویسی کلاسیک): شما باید قوانین را دستی بنویسید. «اگر دو گوش مثلثی داشت، اگر سبیل داشت، اگر چشمها بیضی بودند…» اما خیلی زود متوجه میشوید که این کار شکست میخورد. گربهها از زوایای مختلف، در نورهای مختلف، با رنگهای مختلف، در حال دویدن یا خوابیده، با نژادهای گوناگون… دیده میشوند. نوشتن قانون برای همه این حالتها غیرممکن است. این همان چیزی است که در ادبیات یادگیری ماشین به آن «شکاف معنایی» (Semantic Gap) میگویند: فاصلهای که بین آنچه ما میبینیم (پیکسلهای خام) و آنچه میفهمیم (مفهوم «گربه») وجود دارد.
روش یادگیری ماشین: بهجای نوشتن قوانین، شما نمونه میدهید. هزاران عکس گربه و هزاران عکس غیرگربه. ماشین خودش الگوها را کشف میکند. شما فقط میگویید «این گربه است»، «این گربه نیست» — و ماشین قانون را استخراج میکند.
این تفاوت را میتوان در یک جمله خلاصه کرد:
در برنامهنویسی سنتی، ما منطق را مینویسیم. در یادگیری ماشین، ما داده میدهیم و منطق را به ماشین میسپاریم تا خودش کشف کند.
این تغییر پارادایم، پیامدهای عمیقی دارد. از یک سو، ماشین میتواند مسائلی را حل کند که هیچ انسانی نمیتواند قانونش را بنویسد (مثل تشخیص چهره یا ترجمه زبان). از سوی دیگر، ما کنترل دقیق را از دست میدهیم — و اینجاست که چالشهای اخلاقی، تفسیرپذیری و «جعبه سیاه» بودن مدلها سر برمیآورد.
یادگیری ماشین یک پدیده یکپارچه نیست؛ خانوادهای از روشهاست. اما تقریباً همه آنها در سه دسته بزرگ جای میگیرند.
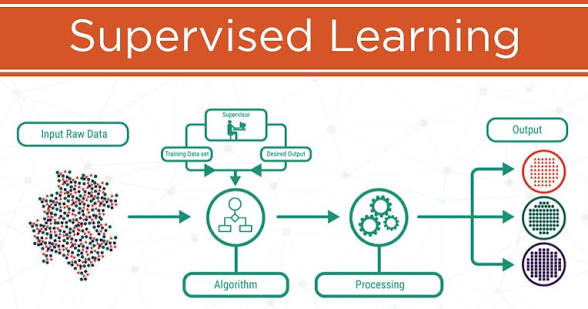
این رایجترین و پرکاربردترین نوع است. در اینجا، دادهها برچسب (label) دارند. یعنی برای هر نمونه، پاسخ درست را میدانیم.
ورودی (X): ویژگیها — مثلاً سن، فشار خون، سطح قند خون.
خروجی (Y): برچسب — مثلاً «بیمار» یا «سالم».
ماشین میآموزد تابعی از X به Y پیدا کند. اگر Y گسسته باشد (دستهبندی)، به آن طبقهبندی (Classification) میگوییم؛ اگر پیوسته باشد (عدد)، رگرسیون (Regression).
مثالهای واقعی: تشخیص سرطان از تصاویر پاتولوژی، پیشبینی قیمت خانه، تشخیص هرزنامه (spam)، پیشبینی احتمال موفقیت یک دانشجو.
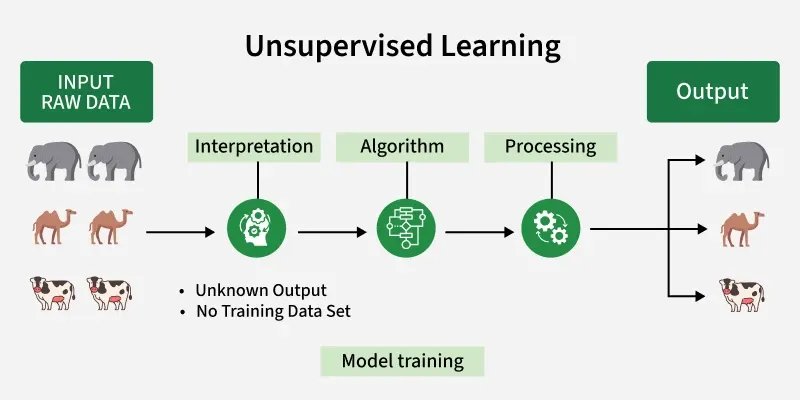
در اینجا هیچ برچسبی وجود ندارد. ماشین فقط داده خام میبیند و باید ساختار پنهان را کشف کند.
خوشهبندی (Clustering): گروهبندی نمونههای شبیه به هم. مثلاً تقسیم مشتریان یک فروشگاه به گروههای رفتاری بدون اینکه از قبل بدانیم چند گروه وجود دارد.
کاهش ابعاد (Dimensionality Reduction): فشردهسازی دادههای پرابعاد به فضایی کوچکتر، در حالی که مهمترین اطلاعات حفظ شود. PCA و t-SNE از مشهورترینها هستند.
این نوع یادگیری، ابزار کاوش است؛ وقتی نمیدانید به دنبال چه هستید و میخواهید داده «خودش را نشان دهد».
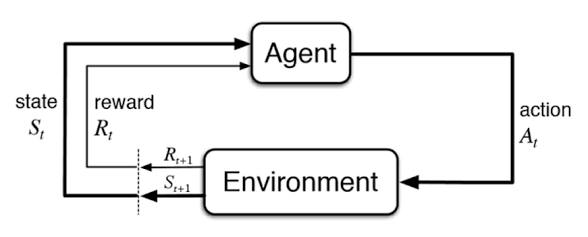
اینجا ماشین یک عامل (agent) است که در یک محیط (environment) عمل میکند و در ازای هر عمل، پاداش یا جریمه میگیرد. هدف: یادگیری سیاستی که مجموع پاداش بلندمدت را بیشینه کند.
این همان چیزی است که پشت AlphaGo (که لی شیدان، قهرمان جهانی گو را شکست داد)، رباتهای بازی، و سیستمهای کنترل خودکار قرار دارد. چالش اصلی اینجاست: معضل اکتشاف در برابر بهرهبرداری (Exploration vs. Exploitation) — آیا باید همان کاری را که میدانم خوب است تکرار کنم، یا چیزهای جدید را امتحان کنم که شاید بهتر باشند؟
حالا برویم به عمق. وقتی میگوییم «ماشین یاد میگیرد»، دقیقاً چه چیزی تغییر میکند؟
هر مدل یادگیری ماشین، مجموعهای از پارامترها (وزنها) دارد. مثلاً در یک مدل خطی ساده:
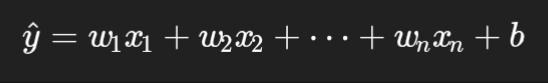
در اینجا wiw_iwi پارامترها هستند و bbb عرض از مبدأ. یادگیری یعنی پیدا کردن مقادیر بهینه برای این پارامترها.
اما «بهینه» یعنی چه؟ اینجاست که تابع هزینه (Cost Function یا Loss Function) وارد میشود. این تابع، میزان خطای مدل را اندازه میگیرد. مثلاً در رگرسیون، رایجترین تابع هزینه، خطای میانگین مربعات (MSE) است:
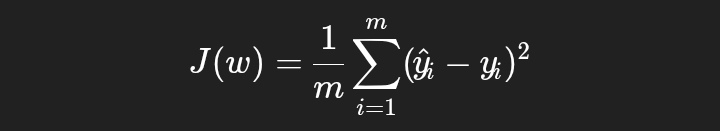
هدف یادگیری: پیدا کردن www که J(w)J(w)J(w) را کمینه کند. به این فرایند، بهینهسازی (Optimization) میگوییم.
تصور کنید در یک دشت تاریک و مهآلود ایستادهاید و میخواهید به پایینترین نقطه برسید، اما چشمانتان بسته است. تنها اطلاعاتی که دارید، شیب زمین زیر پای شماست. چه میکنید؟ در جهت شیب (سراشیبی) قدم برمیدارید. این دقیقاً همان گرادیان نزولی (Gradient Descent) است:
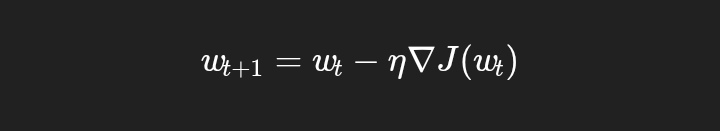
که در آن η\etaη نرخ یادگیری (learning rate) است و ∇J\nabla J∇J گرادیان تابع هزینه. این الگوریتم ساده، ستون فقرات تقریباً تمام یادگیری عمیق مدرن است. نکته ظریف اینجاست: اگر η\etaη خیلی کوچک باشد، یادگیری بینهایت کند میشود؛ اگر خیلی بزرگ باشد، از دره عبور میکنید و هرگز به قعر نمیرسید. تنظیم این پارامتر، یکی از هنرهای اصلی در آموزش مدل است.
وقتی مدل چند لایه میشود (شبکه عصبی)، محاسبه گرادیان بهطرز پیچیدهای دشوار میشود. پسانتشار (Backpropagation) — که در دهه ۸۰ میلادی توسط روملهارت، هینتون و ویلیامز فراگیر شد — راهحلی هوشمندانه است: خطا از لایه خروجی به عقب منتقل میشود و با استفاده از قاعده زنجیرهای (Chain Rule) مشتقات محاسبه میشوند. این الگوریتم، همان چیزی است که وقتی میگوییم «شبکه عصبی آموزش میبیند»، در پسزمینه اجرا میشود.
اگر یادگیری ماشین اینقدر قدرتمند است، چرا هر پروژهای موفق نمیشود؟ پاسخ در چند دام کلاسیک نهفته است.
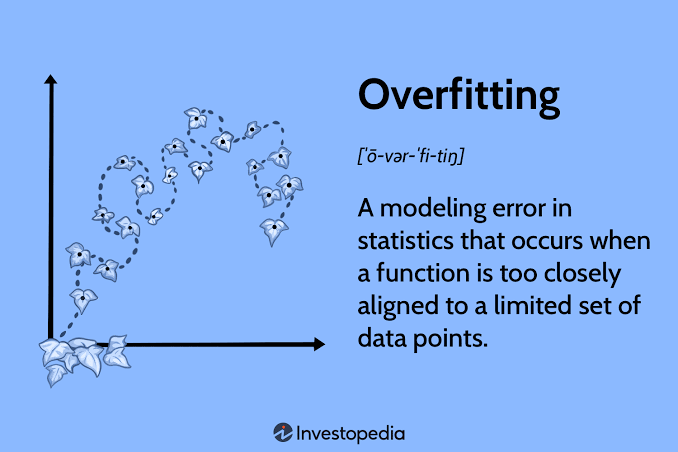
فرض کنید دانشجویی تمام سوالات امتحان سال گذشته را حفظ میکند، اما مفهوم را نمیفهمد. در امتحان سال جدید، با سوالات متفاوت، شکست میخورد. مدلها هم همینطور. بیشبرازش یعنی مدل روی داده آموزشی عملکرد عالی دارد اما روی داده جدید ضعیف است. مدل «نویز» را بهجای «الگو» یاد گرفته.
راهحلها: منظمسازی (Regularization مثل L1/L2)، کاهش پیچیدگی مدل، افزایش داده (Data Augmentation)، Dropout در شبکههای عصبی، و توقف زودهنگام (Early Stopping).
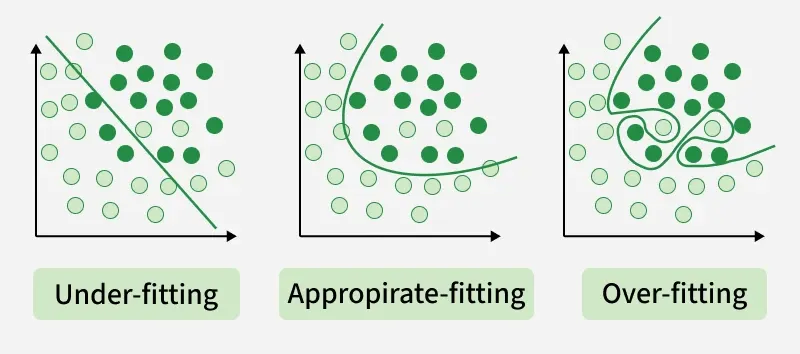
عکس این حالت: مدل آنقدر ساده است که حتی الگوی داده آموزشی را هم نمیتواند یاد بگیرد. مثل تلاش برای توضیح یک رابطه غیرخطی پیچیده با یک خط راست. راهحل: مدل پیچیدهتر، ویژگیهای بهتر، آموزش بیشتر.
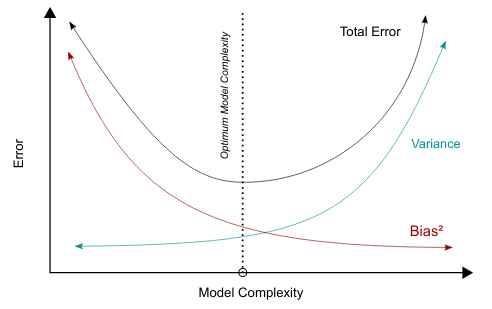
این یکی از عمیقترین مفاهیم در یادگیری ماشین است. سوگیری یعنی مدل بهطور سیستماتیک اشتباه میکند (کمبرازش). واریانس یعنی مدل با تغییر کوچک در داده، بهشدت تغییر میکند (بیشبرازش). هر مدلی باید بین این دو تعادل برقرار کند. مدلهای بسیار ساده سوگیری بالا و واریانس پایین دارند؛ مدلهای بسیار پیچیده برعکس. نقطه شیرین، جایی است که مجموع خطا کمینه شود.
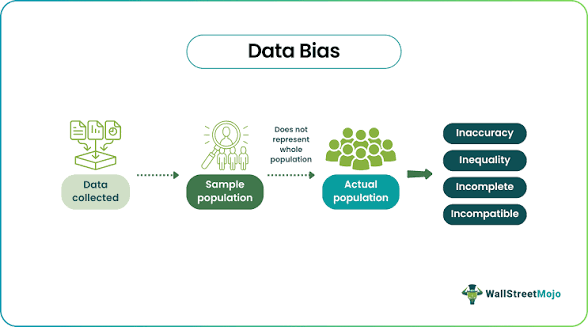
اگر داده آموزشی شما فقط عکس مردان باشد، مدل در تشخیص چهره زنان ضعیف خواهد بود. اگر داده استخدامی شما تاریخاً جانبدارانه باشد، مدل آن جانبداری را تکرار میکند — و حتی تقویت. این یکی از مهمترین چالشهای اخلاقی امروز است: مدلها آینه دادههای ما هستند، و اگر آینه کج باشد، تصویر هم کج است.
پیش از انقلاب عمیق، مدلهای کلاسیک ستون فقرات بودند و هنوز هم در بسیاری از مسائل جدولی (tabular) بهترین انتخاباند:
رگرسیون خطی و لجستیک: پایهای، تفسیرپذیر، سریع.
درخت تصمیم: منطق «اگر-آنگاه» قابل فهم؛ نقطه قوتش شفافیت است.
جنگل تصادفی (Random Forest): ترکیب صدها درخت؛ مقاوم و قدرتمند.
ماشین بردار پشتیبان (SVM): پیدا کردن مرز بهینه با بیشترین حاشیه.
K-نزدیکترین همسایه (KNN): سادهترین شهود: «شبیهترینها را ببین».
XGBoost و LightGBM: قهرمانان مسابقات دادهکاوی؛ در دادههای جدولی اغلب از شبکههای عصبی جلو میزنند.
وقتی داده زیاد و مسئله پیچیده است (تصویر، صدا، متن)، شبکههای عصبی عمیق وارد میشوند. ایده اصلی: لایههای متوالی، هر لایه ویژگیهای انتزاعیتری میسازد. لایه اول لبهها را میبیند، لایه دوم بافتها، لایه سوم اجزا، و لایه آخر مفهوم «گربه».
CNN (شبکههای کانولوشنی): برای تصویر؛ با حفظ ساختار فضایی.
RNN و LSTM: برای دنبالهها (زمان، متن)؛ با حافظه.
Transformer: معماری انقلابی ۲۰۱۷ که با مکانیزم توجه (Attention) همهچیز را تغییر داد و پایه GPT، BERT و مدلهای زبانی بزرگ امروز است.
نکته مهم: یادگیری عمیق جادو نیست. اینها همان گرادیان نزولی و پسانتشار هستند، فقط در مقیاسی عظیم — میلیونها پارامتر، میلیاردها نمونه، و قدرت محاسباتی GPU.
حالا بیایید از نظریه فاصله بگیریم. یادگیری ماشین امروز کجاست؟
پزشکی: تشخیص تومور از MRI، پیشبینی عود بیماری، کشف دارو، تحلیل دادههای ژنومی. (و بله، در حوزهای مثل ناباروری مردان و تحلیل دادههای ژنتیکی مانند HYAL3، یادگیری ماشین میتواند الگوهای پنهان میان واریانتهای ژنی و فنوتیپ را کشف کند — کاری که تحلیل دستی تقریباً غیرممکن است.)
آموزش: سیستمهای تطبیقی که سطح سوال را با دانشآموز تنظیم میکنند؛ تشخیص دانشآموزان در معرض افت تحصیلی.
کشاورزی: پیشبینی عملکرد محصول، تشخیص بیماری گیاه از تصویر برگ.
امنیت: تشخیص تقلب بانکی، شناسایی نفوذ، تحلیل رفتار مشکوک.
زبان: ترجمه، خلاصهسازی، تولید متن، و دستیارهای گفتگو.
اما در کنار این موفقیتها، پرسشهای مهمی هم هست: وقتی مدلی تصمیم پزشکی میگیرد، چه کسی مسئول است؟ وقتی مدلی رزومه را رد میکند، عدالت کجاست؟ تفسیرپذیری (Interpretability) و عدالت (Fairness) امروز بهاندازه دقت مدل مهماند.
اگر این متن شما را ترغیب کرد که یادگیری ماشین را جدی بگیرید، یک نقشه راه عملی:
پیشنیازها: ریاضیات (جبر خطی، آمار و احتمال، حساب دیفرانسیل) و برنامهنویسی پایتون.
کتابخانهها: NumPy، Pandas، Matplotlib، سپس Scikit-learn.
اولین پروژه: یک مسئله طبقهبندی ساده روی داده جدولی (مثل تشخیص دیابت) با Scikit-learn. کل چرخه را طی کنید: پاکسازی داده، تقسیم train/test، آموزش، ارزیابی.
مبانی نظری: درک گرادیان نزولی، تابع هزینه، سوگیری-واریانس. (کتاب «Hands-On Machine Learning» اثر Aurélien Géron نقطه شروع عالی است.)
یادگیری عمیق: PyTorch یا TensorFlow. از یک شبکه ساده شروع کنید، سپس CNN، سپس Transformer.
پروژه واقعی: یک مسئله از حوزه خودتان بردارید — مثلاً تحلیل دادههای ژنومی یا دادههای آموزشی — و کل چرخه را روی آن اجرا کنید. این بهترین معلم است.
فرض کنید به پزشک مراجعه میکنید و او میگوید: «باید تحت عمل جراحی قرار بگیرید.» شما میپرسید: «چرا؟ چه علائمی دیدید؟» و او پاسخ دهد: «نمیدانم، حس درونم اینطور میگوید اما مدل کامپیوتری ما اینطور حکم کرده و من دلیلش را نمیدانم!» آیا به این پزشک یا این سیستم اعتماد میکنید؟ قطعاً خیر.
این همان بحرانی است که امروزه صنعت و دانشگاه با آن دستبهگریباناند: بحران جعبه سیاه (Black Box Problem).
مدلهای عمیق (Deep Learning) و حتی برخی مدلهای پیچیده دیگر مانند جنگلهای تصادفی، میلیونها پارامتر دارند که بهطور غیرخطی در هم تنیدهاند. آنها میتوانند دقیق تشخیص دهند که آیا یک تصویر حاوی سلول سرطانی است یا خیر، اما بهسختی میتوانند بگویند چرا چنین تصمیمی گرفتهاند. در حوزههای حساسی مانند پزشکی، حقوق، امور مالی و سیستمهای نظامی، «دقت بالا» بهتنهایی کافی نیست؛ اعتماد و شفافیت شرط لازم است.
اینجاست که شاخهای جدید و حیاتی به نام هوش مصنوعی توضیحپذیر (Explainable AI - XAI) متولد میشود. ابزارها و تکنیکهایی مانند SHAP (Shapley Additive exPlanations) و LIME (Local Interpretable Model-agnostic Explanations) به ما کمک میکنند تا درون این جعبههای سیاه را ببینیم. آنها به ما میگویند کدام ویژگی یا پیکسل در عکس، بیشترین تأثیر را در تصمیمگیری نهایی مدل داشته است. مثلاً نشان میدهند که مدل در تشخیص یک بیماری، به جای توجه به بافت تومور، به برچسب گوشه اسلاید نگاه میکرده است! بدون XAI، ما ممکن است مدلهایی بسازیم که به دلایل اشتباه، درست کار کنند — و این خطرناکترین شکل فناوری است.
تا چند سال پیش، یادگیری ماشین بیشتر «تحلیلگر» بود: طبقهبندی میکرد، پیشبینی میکرد، تشخیص میداد. اما انقلاب چند سال اخیر، چهره یادگیری ماشین را به کلی دگرگون کرد: از تشخیص به تولید رسیدیم.
در سال ۲۰۱۷، محققان گوگل مقالهای منتشر کردند با عنوانی ساده اما سرنوشتساز: “Attention Is All You Need” (توجه، تمام چیزی است که نیاز دارید). آنها معماری تازهای به نام Transformer معرفی کردند که نیازی به پردازش ترتیبی دادهها (مثل آنچه در مدلهای قدیمیتر RNN دیده میشد) نداشت.
راز این معماری در مکانیزمی به نام توجه خودی (Self-Attention) نهفته است. این مکانیزم به مدل اجازه میدهد هنگام پردازش یک کلمه یا یک بخش از داده، به تمام بخشهای دیگر متن یا تصویر نگاه کند و بفهمد کدام قسمتها با هم بیشترین ارتباط معنایی را دارند. این دقیقاً همان کاری است که ذهن انسان هنگام خواندن یک جمله طولانی انجام میدهد: کلمات پایانی، معنای کلمات ابتدایی را شفاف میکنند.
با ظهور ترنسفورماتورها و مدلهای انتشار (Diffusion Models) در تصاویر، ماشینها دیگر فقط دادهها را دستهبندی نمیکنند؛ آنها شعر میسرایند، کد مینویسند، مولکولهای دارویی جدید طراحی میکنند، نقاشی میکشند و با انسانها گفتگو میکنند. این مدلها با یک هدف ساده اما مقیاسپذیر آموزش دیدهاند: «کلمه بعدی را حدس بزن!» (Next-token prediction). اما وقتی این پیشبینی در مقیاس میلیاردها پارامتر و ترابایتها متن انجام شود، خاصیت نوظهوری (Emergent Behavior) بروز میکند که شبیه به استدلال و خلاقیت به نظر میرسد.
اگر بپرسیم جذابترین مرز یادگیری ماشین کجاست، پاسخ بسیاری از دانشمندان علوم داده، بیوانفورماتیک و زیستشناسی محاسباتی است.
بدن انسان کتابخانهای پیچیده از میلیاردها خط کد ژنتیکی (DNA) است. سالها بود که ژنتیکدانان میدانستند جهشها یا تغییرات خاص در ساختارهای مولکولی (مانند پروتیئنها، آنزیمها یا واریانتهای ژنی) میتوانند به بیماریهای پیچیدهای منجر شوند — از اختلالات متابولیک گرفته تا ناباروریهای با منشاء ناشناخته یا بیماریهای ژنتیکی نادر. اما حجم دادهها آنقدر عظیم بود که تحلیل دستی آنها غیرممکن به نظر میرسید.
اینجاست که یادگیری ماشین وارد میدان میشود:
پیشبینی ساختار پروتئین: مدلهایی مانند AlphaFold که توانستند مسئله ۵۰ ساله پیشبینی ساختار سه بعدی پروتئینها را حل کنند، انقلاب عظیمی در داروسازی و زیستشناسی ایجاد کردند.
تحلیل دادههای چندوجهی (Multi-omics): ترکیب دادههای ژنومی، ترانسکریپتومی و پروتئومی با الگوریتمهای یادگیری ماشین برای یافتن الگوهای پنهان در بروز بیماریها. به عنوان مثال، در بررسی عوامل ژنتیکی مؤثر بر کیفیت اسپرم یا ژنهای کلیدی دخیل در سلامت باروری، الگوریتمهای طبقهبندی میتوانند میان صدها و هزاران واریانت ژنتیکی، آنهایی را که بیشترین همبستگی معنیدار را با پدیدههای بالینی دارند، استخراج کنند — کاری که با روشهای آماری سنتی ماهها یا سالها زمان میبرد.
در این نقطه، یادگیری ماشین دیگر صرفاً یک ابزار کامپیوتری نیست؛ به لنزی تبدیل میشود که با آن میتوانیم عمیقترین رازهای حیات را با وضوحی بیسابقه تماشا کنیم.
اکنون در نقطهای ایستادهایم که مرز بین داستانهای علمی-تخیلی و واقعیت روزمره محو شده است. صحبت از هوش عمومی مصنوعی (Artificial General Intelligence - AGI) — یعنی ماشینی که در تمام حوزهها بتواند به اندازه یا بیشتر از انسان فکر کند و یاد بگیرد — دیگر فقط یک تئوری دانشگاهی نیست؛ مأموریت شرکتهای بزرگ فناوری است.
اما با هر قدمی که به جلو برمیداریم، پرسشهای بنیادینتری مطرح میشوند:
اخلاق و حکمرانی: اگر یک مدل هوش مصنوعی در تشخیص پزشکی اشتباه کند، چه کسی مقصر است؟ برنامهنویس؟ بیمارستان؟ یا خود مدل؟
مالکیت معکری و خلاقیت: وقتی یک مدل هوش مصنوعی شاهکاری هنری خلق میکند یا مقالهای پژوهشی مینویسد، مالک آن کیست؟
انسان در عصر ماشین: اگر ماشینها میتوانند فکر کنند، بنویسند، تحلیل کنند و کد بزنند، نقش انسان چیست؟
پاسخ احتمالاً در بازتعریف نقش خود ماست. ماشینها در «محاسبه»، «تکرار» و «پردازش انبوه داده» بینظیرند؛ اما پرسشگری، شهود فلسفی، خلاقیت اصیل، همدلی و تعیین ارزشها چیزهایی هستند که همچنان در انحصار انسان باقی میمانند. یادگیری ماشین قرار نیست جایگزین انسان شود؛ قرار است آینهای باشد که به ما نشان میدهد چگونه فکر میکنیم، و ابزاری باشد که به ما کمک میکند دورتر، سریعتر و عمیقتر ببینیم.
یادگیری ماشین سفری است بیپایان. از خطوط ساده رگرسیون خطی تا شبکههای عصبی عمیقِ الهامگرفته از مغز، و از مدلهای زبانی تا رازگشایی از کدهای ژنتیکی حیات، این فناوری داستانی از جستجوی انسان برای فهمیدن است. فرقی نمیکند معلم باشید که به دنبال درک الگوهای یادگیری دانشآموزان است، یا پژوهشگری که در آزمایشگاه به دنبال کشف ارتباطات پنهان ژنتیکی است، یا دانشجویی که کنجکاو است بداند پشت پرده این دنیای دیجیتال چه میگذرد؛ فهم یادگیری ماشین یعنی فهم زبانِ تازهی دنیای مدرن.
شاید جذابترین نکته درباره یادگیری ماشین این باشد که در نهایت، درباره ماست. مدلها آینه دادههای ما هستند؛ دادههای ما آینه انتخابها، سوگیریها و اولویتهای ما. وقتی به ماشین یاد میدهیم، در واقع داریم به آن یاد میدهیم که جهان را آنطور که ما دیدهایم ببیند. و این مسئولیت، سبک نیست.
آرتور ساموئل در ۱۹۵۹ نمیدانست که ایدهاش چه راهی را باز میکند. اما یک چیز را میدانست: ماشینی که میتواند از تجربه بیاموزد، قدرتمندتر از ماشینی است که فقط دستور میگیرد. امروز، شش دهه بعد، ما در جهانی زندگی میکنیم که این جمله را هر روز، در هر گوشی، در هر بیمارستان، در هر کلاس درس، بهطور زنده تجربه میکنیم.
یادگیری ماشین فقط یک شاخه فناوری نیست؛ روشی تازه برای فکر کردن درباره دانش است: دانشی که نوشته نمیشود، بلکه آموخته میشود.
دنیایی که در آن، یادگیری دیگر صرفاً یک صفت انسانی نیست؛ بلکه روح جاری در کالبد فناوری است.

