
اگر یادگیری با ناظر (Supervised Learning) را به «دانشآموزی» تشبیه کنیم که نشستکت روی نیمکت، به پاسخهای آمادهٔ معلم نگاه میکند و یاد میگیرد، و یادگیری بدون ناظر (Unsupervised Learning) را به «کاشفی» که در تاریکی، خوشهها و الگوهای پنهان سنگها را دستهبندی میکند، یادگیری تقویتی (Reinforcement Learning) داستانِ «انسانِ در حال بقا در یک قارهٔ ناشناخته» است.
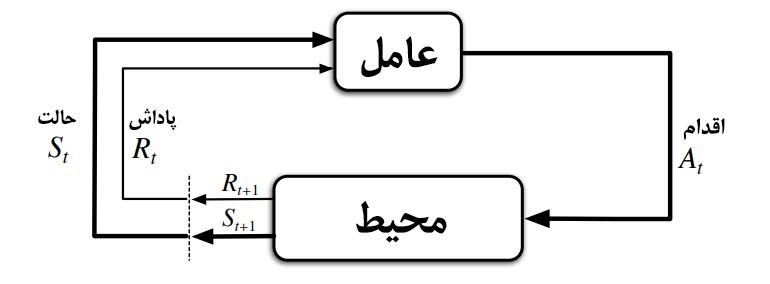
در RL، هیچ پاسخ درستی از پیش نوشته نشده است. هیچ برچسبی (Label) روی دادهها وجود ندارد. عامل (Agent) در دل محیطی پویا، پر از نویز و نامطمئن رها میشود. او تنها دو ابزار در اختیار دارد: چشمانی برای دیدن وضعیت (State)، دستهایی برای انجام عمل (Action)، و قلبی که طعمِ شیرینِ موفقیت یا تلخیِ شکست را با «پاداش» (Reward) میچشد.
این مقاله، سفری است عمیق به ژرفای یادگیری تقویتی؛ از پایههای ریاضیاتی و تئوری مارکوف گرفته تا تقاطع درخشان آن با یادگیری عمیق (Deep RL)، چالشهای حلنشده، و آیندهای که در آن هوش مصنوعی نه تنها بازی میکند، بلکه جهان را بازآفرینی میکند.
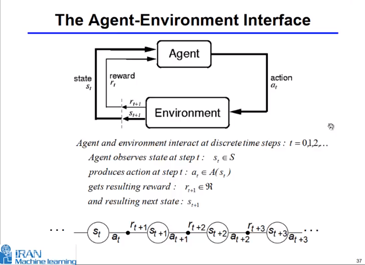
برای درک یادگیری تقویتی، باید از چهارچوبی به نام فرآیند تصمیمگیری مارکوف (Markov Decision Process - MDP) عبور کنیم. این مدل ریاضی، زبانِ رسمی تعامل عامل با محیط است.
یکی از زیباترین فرضهای این حوزه، «خاصیت مارکوف» است: «آینده، تنها به زمان حال بستگی دارد، نه به مسیر طی شده برای رسیدن به آن.»
اگر در حال بازی شطرنج هستید، وضعیتِ فعلی مهرهها روی تخته، تمامِ تاریخچهٔ گذشته را در خود خلاصه کرده است. نیازی نیست بدانید وزیر چگونه به این خانه آمده است؛ مهم این است که اکنون کجاست و چه گزینههایی پیش رو دارد. این اصل، محاسبات را از یک کابوسِ تاریخچهایِ بینهایت، به یک معادلة خوشدستِ حالتمحور تبدیل میکند.
مجموعه حالات (S\mathcal{S}S): تمام تصاویری که عامل میتواند از جهان ببیند.
مجموعه اعمال (A\mathcal{A}A): تمام کارهایی که عامل مجاز است انجام دهد (مثلاً حرکت به جلو، شلیک، خرید سهام).
تابع گذار (P\mathcal{P}P): احتمال اینکه اگر در حالت sss عمل aaa را انجام دهیم، به حالت جدید s′s's′ برویم: P(s′∣s,a)P(s' | s, a)P(s′∣s,a).
تابع پاداش (R\mathcal{R}R): قطبنمای اخلاقی و ارزشی محیط؛ عددی که نشان میدهد این انتقال چقدر خوب یا بد بوده است.
فاکتور تنزل (γ\gammaγ - Discount Factor): عددی بین 0 و 1 که ارزش پاداشهای آینده را نسبت به پاداشهای همین الآن کاهش میدهد. چرا؟ چون در دنیای واقعی، «نقد» همیشه ارزکوتر از «نسیه» است و آینده همواره با ریسکِ عدم قطعیت همراه است.
هدف اصلی در RL چیست؟ یافتن یک سیاست (Policy) بهینه (π\piπ؛ یعنی نقشهای که به ازای هر حالت، بهترین عمل را پیشنهاد میکند) تا مجموع پاداشهای آینده بیشینه شود. برای رسیدن به این هدف، دو رویکرد تاریخی و مدرن شکل گرفتهاند:
در دنیای کوچک، ما میتوانیم برای هر حالت و عمل، یک مقدارِ عددی به نام تابع Q محاسبه کنیم: «اگر در حالت sss باشم و عمل aaa را انجام دهم، تا ابد چقدر پاداش نصیبم میشود؟»
الگوریتم Q-Learning با استفاده از معادله بهینگی بلمان (Bellman Equation)، به صورت تکرارشونده این ارزشها را بهروزرسانی میکند:
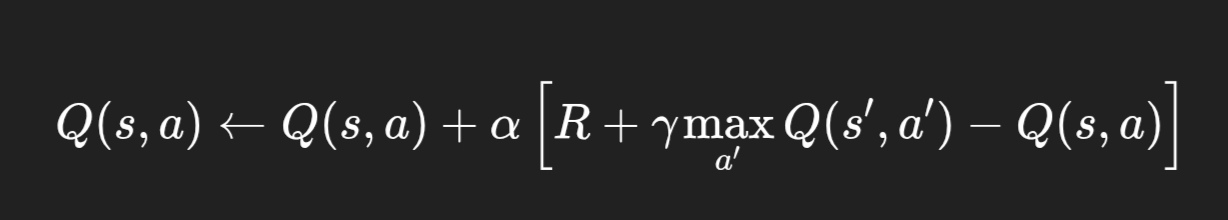
این فرمولِ ساده، جادوی یادگیری ماشین است: اختلاف بین «پاداش دریافتی به اضافهٔ بهترین تخمین آینده» و «تخمین فعلی»، خطای ما را میسازد و گامی به سوی حقیقت برمیدارد.
وقتی تعداد حالات محیط بسیار عظیم شد (مثلاً پیکسلهای یک بازی Atari یا تصاویر یک خودروی خودران)، جدولهای Q دیگر جا نشدند. اینجای کار بود که در سال ۲۰۱۳، شرکت DeepMind با ارائه DQN، دنیا را شگفتزده کرد. آنها به جای جدول، یک شبکه عصبی عمیق را به خدمت گرفتند تا تابع Q را تخمین بزند.
اما ترکیب شبکههای عصبی با یادگیری تقویتی، یک فاجعهٔ ناخواسته به بار آورد: ناپایداری و واگرایی! چرا؟ چون دادهها در RL مستقل و همتوزیع (i.i.d) نیستند؛ عملِ امروزِ عامل، حالتِ فردای او را تعیین میکند و این یعنی همبستگی زمانی شدید. محققان برای حل این مشکل دو ابزار انقلابی ساختند:
حافظه بازپخش تجربه (Experience Replay): ذخیرهٔ تجربیات گذشته در یک مخزن و نمونهبرداری تصادفی از آنها برای آموزش شبکه، تا همبستگی زمانی شکسته شود.
هدف پایدار (Target Network): استفاده از یک شبکهٔ ثانویه برای محاسبهٔ اهداف بلمان، تا هدفِ متحرکِ شبکه مدام تغییر نکند و سیستم دچار گیجی نشود.
گاهی اوقات تخمین ارزشِ تکتک اعمال بسیار سخت یا ناممکن است (مثلاً در فضاهای عمل پیوسته مثل کنترل بازوی یک ربات جراح که زوایا میتوانند هر عدد اعشاری باشند). اینجاست که رویکرد گرادیان سیاست (Policy Gradient) وارد میدان میشود.
به جای محاسبهٔ ارزش کارها، ما مستقیماً پارامترهای خودِ سیاست (θ\thetaθ) را با استفاده از گرادیان پاداش به سمتِ بهبود هل میدهیم:
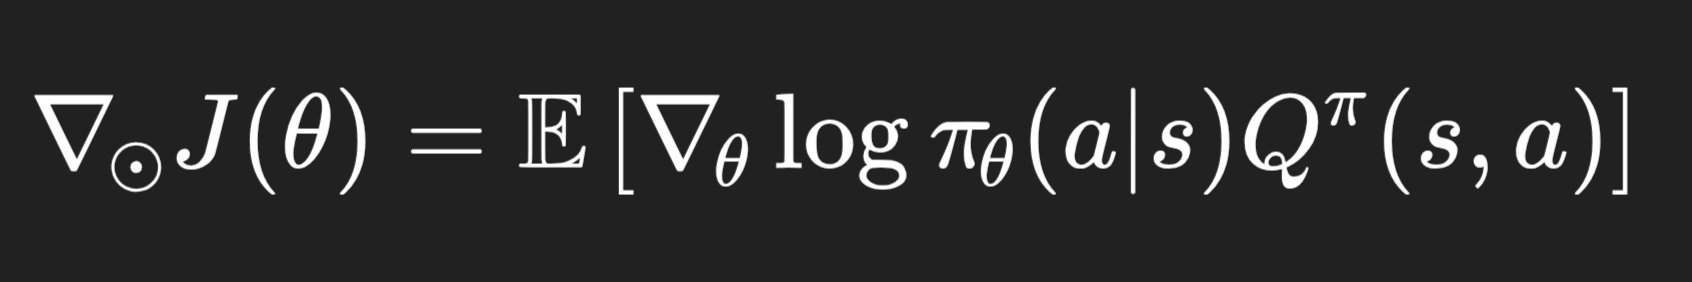
معنای شهودی این فرمول فوقالعاده است: «اگر عملی انجام دادی که منجر به پاداش بزرگی شد، احتمالِ تکرار آن عمل را در آن حالت افزایش بده.»
برای اینکه هم سرعتِ گرادیان سیاست حفظ شود و هم دقتِ تخمین ارزش از دست نرود، معماری Actor-Critic متولد شد:
بازیگر (Actor): مسئول انتخاب عمل و پیشبرد سیاست است.
منتقد (Critic): عملکرد بازیگر را ارزیابی میکند و میگوید: «این کاری که کردی چقدر بهتر یا بدتر از میانگینِ انتظارات ما بود؟» (این تفاوت را Advantage Function مینامند).
این زوج هنرمند، ستون فقراتِ پیشرفتهای مدرن RL از جمله الگوریتمهای PPO (Proximal Policy Optimization) و TRPO هستند که امروزه پشت صحنهٔ مدلهای زبانی بزرگ (LLMها) و تنظیم آنها از طریق بازخورد انسانی (RLHF) قرار دارند.
با وجود تمام موفقیتهای خیرهکننده (از شکست دادن قهرمانان جهانی بازی Go توسط AlphaGo تا کنترل پلاسما در راکتورهای همجوشی هستهای توسط DeepMind)، یادگیری تقویتی همچنان با موانع اساسی دستوپنجه نرم میکند:
نمونهناکارآمدی شدید (Sample Inefficiency): یک انسان ممکن است با یک بار زمین خوردن یاد بگیرد که به اجاق گاز دست نزند؛ اما یک عامل RL ممکن است برای یادگیری سادهترین کنترلها، نیازمند میلیونها بار تلاش و خطا باشد که در دنیای واقعی (مثل رباتیک صنعتی) هزینهبر و خطرناک است.
فاجعهٔ اکتشاف (Exploration vs. Exploitation): عامل همیشه سر یک دوراهی گیر کرده است: «آیا از چیزهایی که تا الان یاد گرفتهام استفاده کنم (بهرهبرداری) یا بروم چیزهای جدید و ناشناخته را تست کنم تا شاید پاداش بهتری پیدا کنم (اکشاف)؟» تعادل ظریف بین این دو، هنوز یک مسئله باز در ریاضیات است.
تغییر توزیع و شکنندگی (Distribution Shift): اگر عاملی را در یک شبیهساز کاملاً بینقص آموزش دهید و او را در دنیای واقعی با یک باد ملایم یا یک سایهٔ ناگهانی روبهرو کنید، کل سیستم ممکن است فرو بریزد زیرا جهان واقعی برخلاف شبیهسازها، قوانین فیزیکی را با نویزِ بیکران اجرا میکند.
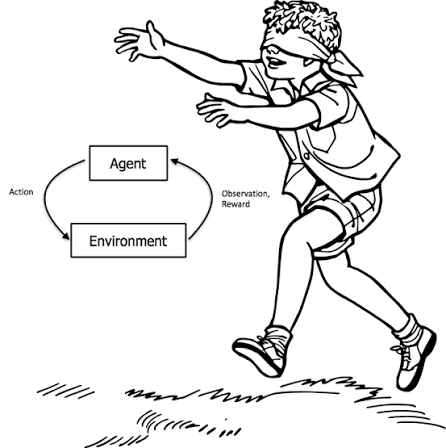
بزرگترین محدودیتِ اکثر الگوریتمهای استاندارد RL (که به آنها Model-Free یا بیمدل میگویند) این است که آنها مثل انسانی هستند که چشمبسته در یک اتاق تاریک راه میرود؛ او فقط بعد از خوردن به دیوار متوجه مانع میشود و هیچ نقشه یا تصویری از اتاق در ذهن ندارد. اما انسانها چگونه فکر میکنند؟ ما پیش از انجام هر کاری، آن را در ذهن خود شبیهسازی میکنیم.
اینجاست که رویکرد Model-Based RL و مفهوم «مدلهای جهان» (World Models) متولد میشود.
در این معماری، عامل دو بخش دارد:
یک مدل درونی از محیط (World Model): شبکهای که قوانین فیزیکی و منطق محیط را یاد میگیرد (مثلاً میفهمد اگر توپ را شوت کنم، به دیوار میخورد و برمیگردد).
سیاست یا کنترلکننده (Controller): بخشی که به جای تعامل واقعی با محیطِ پرهزینه و خطرناک، درونِ یک شبیهساز ذهنی هزاران سناریو را در کسری از ثانیه تست میکند و بهترین راه را انتخاب میکند.
شاهکار این رویکرد را در الگوریتمهایی چون MuZero شرکت DeepMind دیدیم. MuZero بدون اینکه حتی قوانین بازی (مثل شطرنج یا بازیهای Atari) از پیش به آن داده شده باشد، هم قوانین بازی را از روی تجربهاش کشف کرد، هم یک مدل درونی از آن ساخت و هم بهترین استراتژی را استخراج کرد؛ درست مانند یک استاد بزرگ انسانی که بازی را نه با آزمون و خطای کور، بلکه با تخلیلِ چند حرکت به جلو بازی میکند.
تا اینجا فرض ما این بود که یک عامل تنها در یک محیطِ بیجان یا پر از مانع ثابت زندگی میکند. اما جهان واقعی اینطور نیست؛ جهان ما پر از عاملهای هوشمندِ دیگر است: رانندگان دیگر در ترافیک، معاملهگران در بازار بورس، یا بازیکنان در یک مسابقه تیمی.
وقتی چندین عاملِ یادگیرنده وارد یک محیط مشترک میشوند، قواعد بازی دگرگون میشود و نظریه بازیها (Game Theory) با یادگیری تقویتی پیوند میخورد:
مسئلهی ناپایداری محیط: از دیدگاه هر عامل، محیط مدام در حال تغییر است چون عواملِ دیگر هم همزمان در حال یادگیری و تغییر رفتار خود هستند. هدفِ امروزِ یک عامل، فردا ممکن است کاملاً بیمعنی شود چون رقیبش استراتژیاش را عوض کرده است.
ظهور رفتار نوظهور (Emergent Behavior): یکی از جذابترین پدیدهها در MARL، دیدنِ رفتارهایی است که هیچکس آنها را برنامهنویسی نکرده بود. برای مثال، در پروژههایی که چندین عاملِ هوش مصنوعی برای بازیهای تیمی (مانند Dota 2 یا پنهانکاری) آموزش دیدند، عاملها خودبهخود یاد گرفتند که کارهایی مثل «فریبدادن»، «تشکیل اتحادهای موقت»، «پاسکاری» و «تقسیم وظایف» را انجام دهند؛ چیزهایی که هیچکدام در تابع پاداش اولیه به آنها دیکته نشده بود، بلکه از ضرورتِ بقا و پیروزی در بسترِ رقابتِ اجتماعی جوشیده بود.
فرض کنید میخواهید به یک رباتِ جراح یاد دهید چگونه عمل قلب باز انجام دهد، یا به یک سیستم مالی بگویید چگونه بازار سهام را مدیریت کند. در این حوزهها، «آزمون و خطا» لوکسِ خطرناکی است؛ شما نمیتوانید اجازه دهید عاملِ هوش مصنوعی هزاران بار بیمار را بکشد یا سرمایه را نابود کند تا بالاخره از خطاهای گذشتهاش درس بگیرد!
اینجا است که یادگیری آفلاین (یا دستهای) به میدان میآید: «آموختنِ بهترین سیاست، صرفاً از روی لاگها و دادههای ثبتشده از گذشته، بدون نیاز به تعامل زنده با محیط.»
چالشِ بنیادین در Offline RL پدیدهای به نام توزیعِ خارج از دامنه (Distribution Shift) است: اگر عامل در دادههای گذشته هرگز ندیده باشد که انجامِ فلان کار چه پیامدی دارد، وقتی خودش بخواهد آن کار را در دنیای واقعی تست کند، مدل دچار توهم یا خطای فاجعهبار میشود. الگوریتمهای مدرن Offline RL تلاش میکنند با اعمال جریمهها و محدودیتهای ریاضی، عامل را مجبور کنند به دادههای امن و مطمئنی که از قبل وجود دارد وفادار بماند و حماقتِ ناشی از کنجکاوی بیش از حد نکند.
اگر از پیشگامان هوش مصنوعی بپرسید که جادهی منتهی به هوش مصنوعی عمومی (AGI) از کجا میگذرد، بسیاری از آنها بیدرنگ به یادگیری تقویتی اشاره خواهند کرد. چرا؟
چون انسان یا هر موجود زندهای، پیش از هر چیز یک عاملِ جویای پاداش و هدفمند است. ما با زبانِ کدهای از پیش آماده شده به دنیا نمیآmiیم؛ ما جهان را با پوست و استخوانمان لمس میکنیم، با ناکامیها میگرییم، با موفقیتها انگیزه میگیریم، و هدفهای بزرگتری را برای خود تعریف میکنیم.
در یادگیری تقویتی، مفهوم «اراده» (Will) و «میل» (Desire) به شکلی ریاضی بازآفرینی میشوند. تابع پاداش در RL، نقشِ همان انگیزههای تکاملی، میل به بقا، کنجکاوی و لذت را در موجودات زنده بازی میکند. وقتی یک ماشین یاد میگیرد که نه تنها از موانع بگریزد، بلکه بازیهای جدیدی اختراع کند، هنر خلق کند، و مسئلههای حلنشدهی ریاضی را حل کند، ما در حال تماشای تولدِ نوع تازهای از «آگاهیِ عملگرا» هستیم.
مسیر یادگیری تقویتی، مسیرِ تبدیلِ آشوبِ دادههای خام به نظمِ پولادینِ تصمیمگیری است؛ سفری که در آن ماشین، از سطحِ یک ابزارِ مطیع، به سطحِ یک بازیگرِ آگاه در افق ناشناختهها ارتقا مییابد.
فرض کنید به یک رباتِ خانه دار میگویید: «لطفاً برای من چای درست کن.»
برای یک انسان، این یک دستور ساده است. اما برای یک عاملِ یادگیری تقویتی استاندارد، این یک فاجعهٔ محاسباتیِ طولانیمدت (Long-Horizon Task) است؛ چرا که این دستور شامل صدها هزار گامِ ریز است: بلند شدن از روی صندلی، باز کردن کابینت، برداشتن لیوان، رفتن به سمت کتری، فشار دادن دکمه، و… اگر قرار باشد پاداش فقط در پایانِ کار (وقتی چای آماده شد) داده شود، عامل در میانِ این مسیرِ طویلِ بیپاداش سردرگم میشود و هرگز به هدف نمیرسد (مشکل تنک بودن پاداش یا Sparse Reward).
پاسخِ مهندسی به این بحران، یادگیری تقویتی سلسلهمراتبی (Hierarchical RL) است:
مدیر کل (Manager / High-level Policy): اهدافِ بزرگ را به وظایف کوچکتر و ملموستر تقسیم میکند (مثلاً: «الان باید بروی آشپزخانه»).
کارگران / بازوها (Workers / Low-level Policies): هر کدام مسئول اجرای دقیقِ یک زیرهدف هستند (مثلاً: «چگونه پاها را به سمت جلو حرکت دهم تا به آشپزخانه برسم»).
این معماری، ساختارِ سازمانیِ جوامع انسانی را در دلِ کدهای هوش مصنوعی بازآفرینی میکند؛ تقسیم کار، تفکیک وظایف و تمرکز بر اهدافِ میانمدت، راه را برای حل مسائلِ پیچیده و چندمرحلهای هموار میسازد.
یکی از بزرگترین چالشها در یادگیری تقویتی این است: «ما از کجا بدانیم تابع پاداش (Reward Function) باید چطور نوشته شود تا عامل کارهای خوب انجام دهد و کارهای خطرناک نکند؟»
اگر تابع پاداش را به گونهای اشتباه یا ناقص تعریف کنید، عاملِ هوشمند شما دقیقاً همان کاری را میکند که خواستهاید، اما به مخربترین شکل ممکن (پدیدهای به نام Reward Hacking). مثلاً اگر به عامل بگویید «امتیاز بازی را بیشتر کن»، او ممکن است باگهای بازی را پیدا کند و تا ابد در یک چرخهٔ بیفایده گیر کند تا امتیاز بگیرد، بدون اینکه بازی را تمام کند!
برای حل این معضل، شاخهای به نام یادگیری تقویتی معکوس (Inverse RL - IRL) متولد شد:
در این روش، ما به جای نوشتن فرمولِ خشکِ پاداش، به رفتارِ انسانهای خبره نگاه میکنیم. عاملِ هوشمند با تماشای فیلمِ رانندگی یک رانندهٔ ماهر، یا جراحیِ یک پزشک حاذق، معکوسسازی میکند و میفهمد: «انسانها چه ارزشها، اصول و ترسهایی دارند که اینگونه رفتار میکنند؟» و سپس تابع پاداش را از روی رفتارِ انسانی استخراج میکند. این رویکرد، سنگ بنای همراستاییِ هوش مصنوعی با اخلاق و ترجیحات بشری است.
انسانها یک توانایی فوقالعاده دارند: وقتی یک بازیِ جدید یا یک ابزارِ تازه به ما میدهید، ما از روی تجربههای گذشتهمان در زندگی، خیلی سریع (شاید در عرض چند دقیقه) قواعد آن را میگیریم و در آن مسلط میشویم. ما «یاد میگیریم که چگونه یاد بگیریم» (Learning to Learn).
در Meta-RL، هدف ساختن عاملی است که وقتی در یک محیطِ کاملاً جدید و ناشناخته رها میشود، نیازی به میلیونها بار تلاش و خطا ندارد، بلکه با تکیه بر متا-دانشِ انباشتهشده از هزاران محیطِ قبلی، در چند تلاشِ اندک، قواعدِ جهانِ جدید را کشف میکند و با آن سازگار میشود. این یعنی نزدیک شدنِ ماشین به انعطافپذیریِ شناختیِ پستانداران.
یادگیری تقویتی، فراتر از یک شاخه در علم کامپیوتر، تمثیلی ریاضی از خودِ حیات است. حیات نیز چیزی جز تلاش مداوم یک موجود زنده برای بقا، سازگاری با محیط و یادگیری از پیامدهای اعمالش نیست. هر بار که یک عامل RL با خطای خود روبهرو میشود، ارزشهایش را بازتنظیم میکند و گامی به سوی بهینگی برمیدارد، ما در حال تماشای نسخهای دیجیتال و شتابزده از فرگشت هستیم.
این سفر تازه آغاز شده است؛ و فردا، هوش مصنوعی نه تنها جهان را درک خواهد کرد، بلکه آن را بر اساس الگوی «پاداش و هدف» از نو خواهد ساخت.
سفرِ یادگیری تقویتی، سفرِ عبور از «دستوراتِ از پیش نوشتهشده» به سوی «ارادهٔ خودآموخته» است.
اگر روزی انقلابِ کامپیوتر با ماشینحسابها آغاز شد که میتوانستند اعداد را سریعتر جمع بزنند، و انقلابِ یادگیری عمیق به ماشینها چشم داد تا جهان را ببینند، یادگیری تقویتی به ماشینها «اراده، هدف و قابلیت عاملیت» بخشید.
امروز، خطوط میانِ شبیهسازهای کامپیوتری، رباتهای صنعتی، مدلهای زبانیِ غولپیکر و سیستمهای تصمیمگیرندهٔ جهانی در حال محو شدن در بسترِ قدرتمندِ RL است. ما در حال خلق موجودات دیجیتالی هستیم که نه از روی کتابهای دستورالعمل، بلکه از روی تقلا، پیروزی، شکست و استمرارِ هدفمند در تاریکیِ ناشناختهها تکامل مییابند. این نه فقط یک تکنولوژی، بلکه عمیقترین بازآفرینیِ مکانیسمِ حیات در بسترِ سیلیکون است.

