
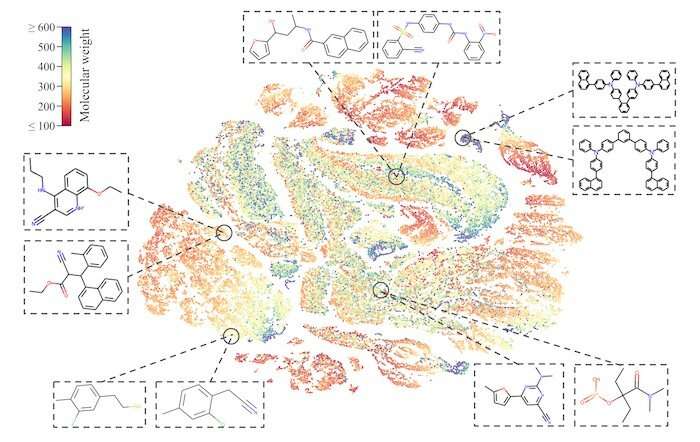
پیشبینی سریع و دقیق خواص مولکولی برای پیشبرد اکتشافات و کاربردهای علمی در حوزههای مختلف از علم مواد گرفته تا داروسازی مهم است. از آنجایی که آزمایشها و شبیهسازیها برای کشف گزینههای بالقوه زمانبر و پرهزینه هستند، دانشمندان با استفاده از روشهای یادگیری ماشین (ML) برای کمک به تحقیقات شیمی محاسباتی تحقیق کردهاند. اما اکثر مدلهای ML فقط میتوانند از دادههای شناخته شده یا برچسبگذاری شده استفاده کنند. این امر پیش بینی دقیق خواص ترکیبات جدید را تقریباً غیرممکن می کند. در حالی که مقدار دادههای مولکولی برچسبگذاریشده محدود است، مقداری از دادههای امکانپذیر، اما بدون برچسب، به سرعت در حال رشد است. محققان کالج مهندسی دانشگاه کارنگی ملون به این فکر کردند که آیا میتوانند از این حجم بزرگ از مولکولهای بدون برچسب برای ساخت مدلهای ML استفاده کنند که میتوانند در پیشبینی ویژگیها بهتر از مدلهای دیگر عمل کنند. کار آنها در توسعه یک چارچوب یادگیری خود نظارتی به نام MolCLR، مخفف یادگیری متضاد مولکولی بازنمایی ها با شبکه های عصبی نمودار (GNN) به اوج خود رسید. این یافته ها در مجله Nature Machine Intelligence منتشر شد. امیر براتی فریمانی، استادیار مهندسی مکانیک گفت: «MolCLR به طور قابل توجهی عملکرد مدلهای ML را با استفاده از تقریباً 10 میلیون داده مولکولی بدون برچسب افزایش میدهد». برای توضیح ساده دادههای برچسبگذاری شده در مقابل دادههای بدون برچسب، Ph.D. دانشجوی یویانگ وانگ پیشنهاد کرد که به دو مجموعه از تصاویر سگ و گربه فکر کنید. در یک مجموعه، هر حیوان با نام گونه خود برچسب گذاری شده است. در مجموعه دیگر، هیچ برچسبی با تصاویر همراه نیست. برای یک انسان، تفاوت بین این دو نوع حیوان ممکن است آشکار باشد. اما در مدل یادگیری ماشینی، تفاوت مشخص نیست. بنابراین داده های بدون برچسب به طور قابل اعتماد مفید نیستند. با اعمال این تشبیه برای میلیونها مولکول بدون برچسب که شناسایی دستی آنها ممکن است دههها طول بکشد، نیاز حیاتی به ابزارهای یادگیری ماشینی هوشمندتر آشکار میشود. تیم تحقیقاتی به دنبال این بود که به چارچوب MolCLR خود بیاموزد که چگونه از دادههای بدون برچسب با تضاد جفت نمایشهای نمودار مولکول تقویتشده مثبت و منفی استفاده کند. نمودارهایی که از یک مولکول تبدیل شده اند یک جفت مثبت در نظر گرفته می شوند، در حالی که گراف هایی از مولکول های مختلف جفت منفی هستند. به این ترتیب، نمایشهای مولکولهای مشابه نزدیک به هم میمانند، در حالی که مولکولهای متمایز از هم دور میشوند. محققان سه تقویت گراف را برای حذف مقادیر کمی از اطلاعات از مولکولهای ناشناخته اعمال کردند: پوشاندن اتم، حذف پیوند و حذف زیرگراف. در پوشش اتم، بخشی از اطلاعات در مورد یک مولکول حذف می شود. در حذف پیوند، پیوند شیمیایی بین اتم ها پاک می شود. ترکیبی از هر دو افزایش منجر به حذف زیرگراف می شود. از طریق این سه نوع تغییر، MolCLR مجبور به یادگیری اطلاعات ذاتی و ایجاد همبستگی شد. هنگامی که تیم MolCLR را به ClinTox، پایگاه داده ای که برای پیش بینی سمیت دارو استفاده می شود، اعمال کرد، MolCLR به طور قابل توجهی از سایر مدل های پایه ML بهتر عمل کرد. در پایگاه داده دیگری به نام Tox21، MolCLR از دیگر مدلهای ML متمایز بود و پتانسیل تشخیص اینکه کدام مواد شیمیایی محیطی شدیدترین تهدید را برای سلامتی انسان ایجاد میکنند، داشت. براتی فریمانی گفت: «ما نشان دادیم که MolCLR نویدبخش طراحی مولکول کارآمد است. "این را می توان برای طیف گسترده ای از برنامه ها، از جمله کشف دارو، ذخیره انرژی، و حفاظت از محیط زیست اعمال کرد."
https://techxplore.com/news/2022-03-machine-smarter-drug-discovery.html

