
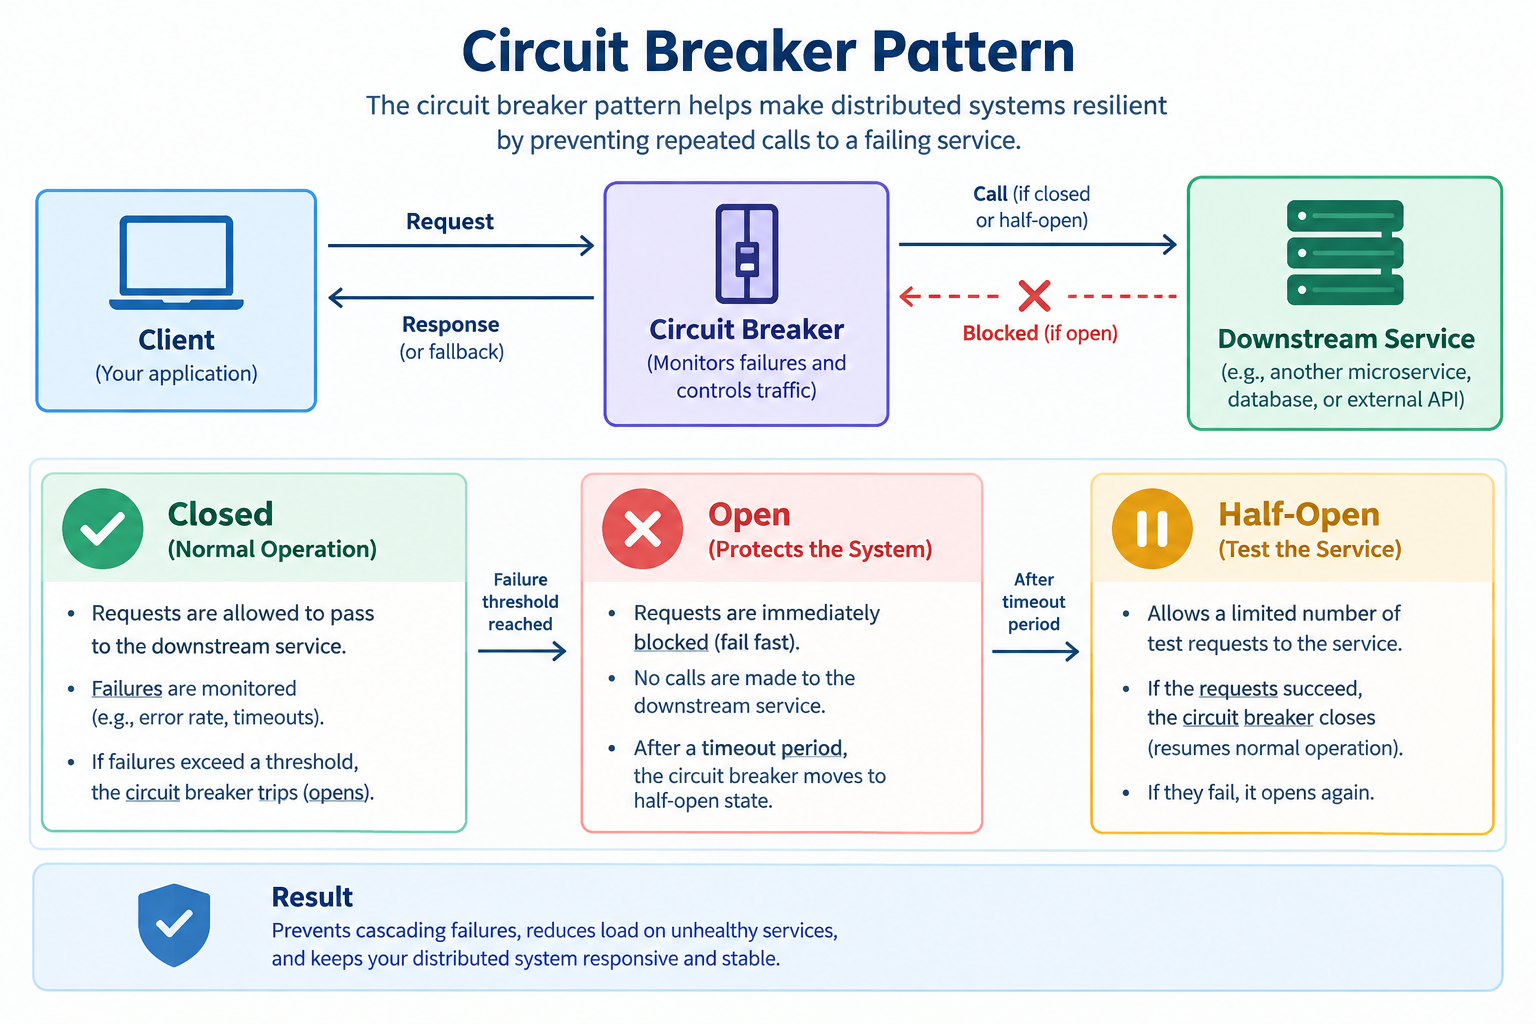
فرض کنید سرویس پرداخت شما از کار افتاده است. در حالت عادی هر درخواست خرید باید چیزی شبیه این مسیر را طی کند:
User ↓ Order Service ↓ Payment Service ↓ Bank
حالا Payment Service از کار افتاده (یا کند شده) و هر درخواست بهجای ۲۰۰ میلیثانیه، ۱۰ ثانیه طول میکشد.
اگر سیستم شما در این شرایط همچنان به ارسال درخواست ادامه دهد، چه اتفاقی میافتد ؟
صف درخواستها بزرگتر میشود، Threadها و Connectionها اشغال میشوند، Timeoutها بیشتر میشوند و سرویسهای دیگری که ظاهرا سالم هستند هم شروع به خطا میکنند. یعنی ممکن است یک سرویس خراب، کل سیستم را از کار بیندازد.
اینجاست که Circuit Breaker وارد بازی میشود. Circuit Breaker به سیستم میگوید:
اگر یک سرویس خارجی بهاندازهی کافی خراب شده، فعلا دیگر به آن درخواست نفرست. سریع Fail کن و اجازه بده سیستم نفس بکشد.
الگوی Circuit Breaker طرحی برای افزایش Resiliency و Reliability در سیستمهای توزیعشده است. ایدهی آن از همان فیوز برق (Circuit Breaker) گرفته شده است. وقتی جریان برق بیش از حد شود، فیوز مدار را قطع میکند تا آسیب بیشتری ایجاد نشود.
در نرمافزار نیز وقتی یک سرویس خارجی دچار خطاهای مکرر میشود، Circuit Breaker جریان درخواستها به آن سرویس را متوقف میکند.
هدف این نیست که سرویس خراب را تعمیر کند. هدف این است که:
از ارسال درخواستهای بیفایده جلوگیری کند.
منابع سرویس خودمان را حفظ کند.
فشار روی سرویس خارجی خراب را کاهش دهد.
جلوی Cascading Failure را بگیرد.
امکان Recovery سرویس خراب را فراهم کند.
در صورت امکان سیستم را با یک رفتار جایگزین همچنان قابل استفاده نگه دارد.
به زبان ساده Circuit Breaker خرابی را حل نمیکند؛ جلوی گسترش خرابی را میگیرد.
در یک برنامهی سادهی Monolith، ممکن است یک تابع را صدا بزنیم:
calculatePrice()
اگر تابع شکست بخورد، معمولا کنترل شرایط سادهتر است. اما در یک سیستم توزیعشده، هر فراخوانی از شبکه عبور میکند:
Service A
    ↓
Service B
    ↓
Service C
    ↓
External API
و برخلاف یک تابع معمولی، یک Remote Call میتواند:
Timeout شود.
Connection را از دست بدهد.
بسیار کند شود.
خطای 5xx بدهد.
Rate Limit شود.
کاملا از دسترس خارج باشد.
مشکل مهمتر این است که شکست یک سرویس خارجی میتواند به سرویسهای دیگر منتقل شود.
برای نمونه:
Payment Service ↓ مشکل دارد ↓ منتظر میماند Order Service ↓ اشغال میشوند Threadها ↓ درخواستها صف میکشند ↓ افزایش پیدا میکند Latency ↓ بالا میرود Error Rate ↓ کل سیستم تحت فشار قرار میگیرد
این همان چیزی است که به آن Cascading Failure میگوییم.
Circuit Breaker یکی از ابزارهایی است که برای جلوگیری از چنین زنجیرهای استفاده میشود.
دو مفهوم مهم در طراحی سیستمهای توزیعشده:
Reliability: یعنی سیستم بتواند در برابر خطاها رفتار قابلاعتماد داشته باشد و پس از Failure بتواند به وضعیت سالم برگردد.
High Availability: یعنی سیستم تا حد امکان در دسترس کاربران باقی بماند، حتی زمانی که بخشی از زیرساخت یا سرویسها دچار مشکل شدهاند.
Circuit Breaker مستقیما باعث نمیشود سرویس خارجی همیشه Available باشد.
اما کمک میکند:
Dependency Failure
       ↓
Circuit Breaker
       ↓
Failure Isolation
       ↓
Graceful Degradation
       ↓
System remains responsive
در واقع Circuit Breaker بخشی از استراتژی Failure Isolation است. بهجای اینکه خرابی یک سرویس را به کل سیستم منتقل کنیم، سعی میکنیم Blast Radius آن را محدود کنیم.
این الگو معمولا بهصورت یک State Machine پیادهسازی میشود و سه وضعیت اصلی دارد:
Closed وضعیت
Open وضعیت
Half-Open وضعیت
در حالت Closed مدار در وضعیت عادی قرار دارد. درخواستها اجازه دارند به سرویسهای خارجی ارسال شوند:
Client
  ↓
Circuit Breaker
  ↓
Payment Service
Circuit Breaker در همین زمان وضعیت درخواستها را بررسی میکند.
برای نمونه:
100 requests
95 success
5 failure
اگر Failureها از آستانهی تعیینشده عبور کنند Circuit به وضعیت OPEN میرود.
نکته مهم
آستانهی Failure الزاما به معنی «۵ درخواست پشت سر هم شکست خورد» نیست.
میتواند بر اساس موارد مختلف تعریف شود:
تعداد خطاها
درصد خطاها
تعداد Timeoutها
تعداد Failure در یک بازه زمانی
ترکیبی از چند Metric
برای نمونه: 50 failures در ۱۰۰ درخواست اخیر، یا Failure Rate > 30% در ۳۰ ثانیه اخیر.
انتخاب آستانه (Threshold) باید بر اساس رفتار واقعی سرویس خارجی و SLOهای سیستم انجام شود.
وقتی Circuit به وضعیت Open میرود، رفتار سیستم کاملا تغییر میکند.
قبل:
Request
  ↓
Circuit Breaker
  ↓
Payment Service
بعد:
Request
  ↓
Circuit Breaker
  ↓
FAIL FAST
یعنی درخواست اصلا به Payment Service ارسال نمیشود. این قسمت مهمترین ایدهی Circuit Breaker است. اگر میدانیم یک سرویس احتمالا خراب است، چرا دوباره آن را صدا بزنیم ؟
در حالت Open درخواست بدون منتظر ماندن برای Network Timeout یا پاسخ سرویس، سریع Fail میشود. این همان مفهوم Fail Fast است. فرض کنید Payment Service در دسترس نیست و Timeout آن 10 ثانیه است. اگر ۱۰۰۰ درخواست همزمان داشته باشیم و همه منتظر Timeout بمانند:
1000 requests × 10 seconds
بخش زیادی از منابع سیستم درگیر انتظار میشوند. اما با Circuit Breaker:
Request
   ↓
Circuit = OPEN
   ↓
Immediate Failure
جلوی ارسال درخواست در مدت بسیار کوتاه گرفته میشود.
در نتیجه:
Threadها کمتر درگیر میشوند.
Connectionها آزاد میمانند.
CPU و Memory کمتر مصرف میشود.
Latency قابلکنترلتر میشود.
فشار روی سرویس خارجی افزایش پیدا نمیکند.
در واقع گاهی سریع Fail کردن بهتر از منتظر ماندن برای یک Failure دیرهنگام است.
اما Open قرار نیست برای همیشه باز بماند. اگر Circuit برای همیشه Open بماند، سیستم هیچوقت متوجه نمیشود که سرویس خارجی دوباره سالم شده است. پس بعد از یک مدت مشخص Circuit وارد حالت HALF-OPEN میشود. این مدت را معمولا با مفهومی مثل Timeout / Recovery Timeout / Cooldown Period مشخص میکنیم.
برای نمونه:
Circuit Open
     ↓
Wait 30 seconds
     ↓
Half-Open
Half-Open یکی از ظریفترین بخشهای Circuit Breaker است. فرض کنید Payment Service دوباره سالم شده است. آیا باید ناگهان تمام درخواستهای منتظر را دوباره به آن ارسال کنیم؟
نه. ممکن است سرویس تازه Recovery شده باشد و هنوز ظرفیت کامل را نداشته باشد. پس Circuit Breaker تعداد محدودی درخواست آزمایشی را به آن سرویس ارسال میکند:
Half-Open
    ↓
5 test requests
    ↓
Success ?
اگر این درخواستها موفق باشند:
HALF-OPEN
     ↓
Successful requests
     ↓
CLOSED
و سیستم دوباره به حالت عادی برمیگردد. اما اگر درخواست آزمایشی دوباره شکست بخورد:
HALF-OPEN
     ↓
Failure
     ↓
OPEN
و Timeout دوباره شروع میشود.
چون Recovery یک سرویس لزوما به معنی Recovery کامل نیست. برای نمونه تصور کنید Payment Service بعد از یک قطعی دوباره بالا آمده، اما فقط توان پاسخگویی به ۲۰ درخواست در ثانیه را دارد. اگر ناگهان ۱۰,۰۰۰ درخواست به آن بفرستیم:
Recovery
   ↓
Traffic Spike
   ↓
Overload
   ↓
Failure Again
یعنی خودمان دوباره سرویس را خراب کردهایم.
Half-Open شبیه یک تست کنترلشده است. یعنی بهجای:
0 request
      ↓
10000 requests
داریم:
0 request
      ↓
چند درخواست آزمایشی
      ↓
بررسی نتیجه
      ↓
افزایش تدریجی ترافیک
تعداد درخواستهای آزمایشی باید بر اساس نوع سیستم انتخاب شود و لزوما یک عدد ثابت برای همهی معماریها وجود ندارد.
فرض کنید یک فروشگاه اینترنتی داریم:
User
 ↓
Order Service
 ↓
Payment Service
 ↓
Bank Gateway
در حالت عادی:
Order Service
      ↓
Circuit Breaker
      ↓
Payment Service
  ↓
Bank
همهچیز خوب است.
مرحله اول: خرابی شروع میشود. Bank Gateway دچار مشکل میشود، در نتیجه Payment Service شروع به Timeout دادن میکند.
Payment Request
      ↓
Timeout
Circuit Breaker این Failureها را ثبت میکند.
مرحله دوم: آستانهی Failure رد میشود. برای نمونه:
100 requests
40 failures
و Policy ما میگوید:
Failure Rate > 30% → OPEN
پس Circuit باز میشود.
مرحله سوم: درخواستها Fail Fast میشوند. حالا درخواست جدید:
User
 ↓
Order Service
 ↓
Circuit = OPEN
 ↓
Immediate Failure
یعنی دیگر Payment Service را صدا نمیزنیم.
مرحله چهارم: سیستم وارد حالت Degraded میشود. حالا باید تصمیم بگیریم با کاربر چه کنیم. برای نمونه:
پرداخت در حال حاضر در دسترس نیست. لطفاً چند دقیقه دیگر دوباره تلاش کنید.
یا ممکن است بتوانیم:
سفارش را موقتا Pending کنیم.
عملیات را وارد Queue کنیم.
از یک Payment Provider جایگزین استفاده کنیم.
اطلاعات غیرحیاتی را از Cache برگردانیم.
اینجاست که مفهوم Fallback اهمیت پیدا میکند.
Fallback یعنی «اگر مسیر اصلی شکست خورد، آیا مسیر جایگزین معناداری داریم ؟»
برای نمونه:
Primary Payment Provider
          ↓
        FAILED
          ↓
Secondary Payment Provider
اما Fallback همیشه وجود ندارد. برای نمونه برای پرداخت نمیتوانیم صرفا یک پاسخ جعلی موفقیتآمیز برگردانیم. بنابراین Fallback باید با Business Logic سازگار باشد.
این دو الگو گاهی با هم اشتباه گرفته میشوند.
Retry میگوید:
این درخواست شکست خورده؛ شاید اگر دوباره تلاش کنم موفق شود.
Circuit Breaker میگوید:
این سرویس خارجی چند بار پشت سر هم شکست خورده؛ فعلا دیگر به آن درخواست نده.
Retry برای Transient Failureها بسیار مفید است.
برای نمونه:
Network glitch
Temporary timeout
Temporary throttling
اما اگر سرویس خارجی واقعا Down باشد، Retry بیش از حد میتواند مشکل را شدیدتر کند.
فرض کنید ۱۰۰۰ درخواست داریم. اگر هر درخواست شکست بخورد، ۳ بار Retry میکنیم. یعنی:
1000 original requests + 3000 retries = 4000 requests
یعنی دقیقا در زمانی که سرویس Down یا Overloaded است، بار بیشتری به آن وارد میکنیم.
حالا فرض کنید سرویس A به B و B به C وابسته است:
A → B → C
C خراب میشود. B درخواستها را Retry میکند. A هم درخواستهای خود را Retry میکند.
در نتیجه:
C Failure
   ↓
B Retries
   ↓
A Retries
   ↓
More traffic
   ↓
C becomes even more overloaded
   ↓
More failures
   ↓
Cascading Failure
این همان چیزی است که به آن Retry Storm گفته میشود.
پس Retry را حذف کنیم ؟
نه. مساله Retry نیست؛ Retry بدون کنترل مشکلساز است. یک معماری مقاوم معمولا از ترکیبی از این مفاهیم استفاده میکند: برای نمونه:
Request
   ↓
Timeout
   ↓
Retry
   ↓
Exponential Backoff + Jitter
   ↓
Circuit Breaker
نکته مهم این است که Retry باید فقط برای خطاهایی انجام شود که احتمال موفقیت مجدد دارند. برای مثال retry کردن خطای 503 Service Unavailable ممکن است منطقی باشد، اما retry کردن 401 Unauthorized معمولا چیزی را حل نمیکند.
فرض کنید ۱۰,۰۰۰ درخواست همزمان شکست خوردهاند. اگر همه دقیقا یک ثانیه بعد دوباره تلاش کنند:
1 sec
  ↓
10,000 requests
دوباره یک Spike ایجاد میشود.
اما در Exponential Backoff، فاصلهی Retry افزایش پیدا میکند:
1s
2s
4s
8s
...
اما حتی این هم میتواند مشکل داشته باشد، یعنی اگر همه دقیقا در همان زمان Retry کنند، دوباره Spike داریم.
اینجاست که Jitter وارد میشود. یعنی یک مقدار تصادفی به زمان انتظار اضافه کنیم:
1.2s
1.8s
2.4s
3.1s
...
در نتیجه درخواستها در طول زمان پخش میشوند.
فرض کنید این درخواست را داریم:
POST /payments
درخواست به Payment Service ارسال شده است و پرداخت واقعا انجام شده، اما پاسخ به دلیل مشکل Network به Client نرسیده است. Client چه میبیند؟
Timeout
حالا اگر بدون طراحی مناسب Retry کنیم:
POST /payments
ممکن است پرداخت دوم هم انجام شود.
یعنی:
Request #1 → Payment successful

Response lost
   ↓
Retry
   ↓
Request #2 → Payment successful again
اینجاست که Idempotency اهمیت پیدا میکند. با استفاده از یک Idempotency Key (برای نمونه payment_id = ABC123) میتوانیم مشخص کنیم اگر همان عملیات دوباره ارسال شد، سرویس تشخیص دهد که این عملیات قبلا پردازش شده است.
در نتیجه:
Retry
  ↓
Same Idempotency Key
  ↓
Same logical operation
  ↓
No duplicate side effect
بنابراین هرجا Retry داریم، باید بپرسیم آیا این Operation واقعا قابل Retry است ؟
پیادهسازی Circuit Breaker فقط قرار دادن یک شرط ساده در کد نیست. چند پارامتر مهم باید مشخص شوند.
۱. آستانه Failure: چه مقدار Failure باعث Open شدن Circuit شود ؟
برای نمونه:
Failure Rate > 50%
Threshold خیلی پایین ممکن است باعث شود Circuit با خطاهای موقتی بیش از حد باز شود.
Threshold خیلی بالا هم ممکن است زمانی Circuit را باز کند که سیستم شما قبلا آسیب دیده است.
۲. Timeout: بعد از Open شدن، چه مدت صبر کنیم ؟
برای نمونه:
30 seconds
Timeout خیلی کوتاه:
Open
  ↓
Half-Open
  ↓
Failure
  ↓
Open
  ↓
Half-Open
...
Timeout خیلی طولانی نیز ممکن است باعث شود سیستم مدت زیادی حتی پس از Recovery سرویس، درخواستها را به آن ارسال نکند.
۳. تعداد درخواستهای Half-Open: وقتی Circuit وارد Half-Open شد، چند درخواست اجازهی عبور داشته باشند ؟
برای نمونه:
1 request
یا:
5 requests
یا درصد محدودی از Traffic. هرچه تعداد بیشتر باشد، Recovery سریعتر ارزیابی میشود و فشار بیشتری به سرویس خارجی وارد میشود.
۴. چه Failureهایی Circuit را باز کنند ؟ همهی خطاها نباید یکسان باشند.
برای نمونه:
Timeout → مهم
503 → مهم
Connection Error → مهم
401 → احتمالا نه
400 → احتمالا نه
اگر برای هر خطایی Circuit را باز کنیم، ممکن است کل سرویس خارجی را خارج از دسترس فرض کنیم.
هیچ الگویی رایگان نیست. Circuit Breaker هم پیچیدگیهایی ایجاد میکند.
از جمله مزایای این الگو میتوان به موارد زیر اشاره کرد:
جلوگیری از Cascading Failure
کاهش فشار روی سرویس خارجی خراب
Fail Fast
کاهش مصرف منابع
کمک به Graceful Degradation
افزایش Resilience
امکان Recovery کنترلشده
از جمله معایب این الگو میتوان به موارد زیر اشاره کرد:
افزایش Complexity
نیاز به Monitoring
نیاز به تنظیم Thresholdها
احتمال False Positive
احتمال False Negative
نیاز به مدیریت State
نیاز به طراحی Fallback
دشوارتر شدن Debugging
برای نمونه اگر آستانه بیش از حد حساس باشد:
Temporary Failure
      ↓
Circuit Opens
      ↓
Requests rejected
در حالی که سرویس مقصد واقعا Down نبوده است. از طرف دیگر اگر آستانه خیلی بزرگ باشد:
Dependency is failing
      ↓
Circuit still Closed
      ↓
More failures
      ↓
More resource consumption
پس تنظیم Circuit Breaker یک Trade-off است، نه یک عدد جادویی.
معمولا Circuit Breaker نزدیک به جایی قرار میگیرد که Remote Call انجام میشود:
Order Service
     ↓
Circuit Breaker
     ↓
Payment Service
اما در معماریهای بزرگتر میتوان قابلیت Circuit Breaking را در لایههای دیگری نیز پیاده کرد؛ برای نمونه در:
Application سطح
API Gateway
مزیت Service Mesh این است که میتواند برخی قابلیتهای تابآوری (Resilience) را بدون قرار دادن منطق مشابه در تکتک سرویسها مدیریت کند. اما این هم Trade-off دارد. هرچه تابآوری را بیشتر به زیرساخت منتقل کنیم، Application Code سادهتر میشود؛ ولی در مقابل Debugging و درک رفتار واقعی سیستم ممکن است پیچیدهتر شود.
خیر. Circuit Breaker برای هر نوع سرویس خارجیای لازم نیست. اگر یک Operation بسیار سریع است:
function calculateTax()
استفاده از Circuit Breaker احتمالا فقط پیچیدگی را اضافه میکند.
اما وقتی با:
Remote API
دیتابیس
External Provider
Third-party سرویسهای
سروکار داریم، ارزش بررسی و استفاده از آن بیشتر میشود.
یکی از اشتباهات رایج این است که تصور کنیم Circuit Breaker = Resiliency است، در حالی که Circuit Breaker فقط یکی از ابزارهاست. یک سیستم مقاوم ممکن است ترکیبی از این الگوها باشد:
     ┌─────────────┐
     │   Timeout   │
     └──────┬──────┘
            ↓
     ┌─────────────┐
     │    Retry    │
     └──────┬──────┘
            ↓
┌───────────────────────┐
│ Exponential Backoff   │
│       + Jitter        │
└───────────┬───────────┘
            ↓
    ┌─────────────┐
    │   Circuit   │
    │   Breaker   │
    └──────┬──────┘
           ↓
    ┌─────────────┐
    │  Fallback   │
    └─────────────┘
در کنار اینها، مفاهیمی مانند:
نیز میتوانند بخشی از طراحی Resiliency باشند.
داشتن Circuit Breaker بدون Observability تقریبا مثل داشتن چراغ هشدار بدون نگاه کردن به داشبورد است.
ما در حداقلیترین حالت باید بتوانیم مواردی مانند اینها را مشاهده کنیم:
Circuit State وضعیت
Failure Rate
Success Rate
Timeout Rate
Open Count
Half-Open Attempts
Recovery Time
Fallback Rate
Request Latency
همچنین تغییر وضعیت Circuit میتواند یک Event مهم برای Monitoring و Alerting باشد.
برای نمونه:
Circuit: CLOSED → OPEN
باید بتواند در Monitoring سیستم دیده شود، چون ممکن است نشاندهندهی یک حادثه جدی در سرویسهای خارجی باشد.
یک نکته مهم: هدف Circuit Breaker «کم کردن Error» نیست. ممکن است بعد از فعال کردن Circuit Breaker، تعداد Errorهایی که کاربر دریافت میکند حتی بیشتر شود. اما این الزاما بد نیست. فرض کنید بدون Circuit Breaker:
1000 requests
    ↓
1000 timeout
    ↓
10 seconds each
    ↓
Thread exhaustion
    ↓
Entire service becomes unhealthy
با Circuit Breaker:
1000 requests
    ↓
Circuit OPEN
    ↓
1000 fast failures
    ↓
Dependency protected
    ↓
Main service remains responsive
در حالت دوم هنوز Failure داریم، اما کنترل شده است. هدف Circuit Breaker این نیست که Failure را ناپدید کند، هدفش این است که Failure را به یک Failure قابلکنترل تبدیل کند.
این تفاوت، یکی از مهمترین اصول طراحی سیستمهای توزیعشده است.
Circuit Breaker یک الگوی Resiliency برای زمانی است که سیستم ما به یک سرویس خارجی یا Remote Service وابسته است و احتمال Failure یا Timeout وجود دارد.
این الگو با سه وضعیت اصلی کار میکند:
CLOSED ↓ درخواستها عبور میکنند
OPEN ↓ میشوند Fail Fast درخواستها
HALF-OPEN
  ↓
Recovery چند درخواست آزمایشی برای بررسی
اگر سرویس خارجی سالم باشد:
Closed
اگر Failureها از آستانه عبور کنند:
Closed → Open
پس از گذشت Timeout:
Open → Half-Open
و اگر Recovery موفق باشد:
Half-Open → Closed
در غیر این صورت:
Half-Open → Open
وقتی یک سرویس خارجی خراب است، ادامه دادن به درخواستهای بیشتر همیشه نشانهی Resiliency نیست؛ گاهی بهترین کاری که سیستم میتواند انجام دهد این است که از ایجاد درخواستهای جدید جلوگیری کند.
Circuit Breaker در کنار Timeout، Retry محدود، Exponential Backoff، Jitter، Fallback و Idempotency میتواند جلوی تبدیل شدن یک Failure کوچک به یک قطعی بزرگ را بگیرد.
فرض کنید Payment Service شما Down شده و ۱۰,۰۰۰ درخواست پرداخت در هر دقیقه دریافت میکنید.
کدام رفتار را ترجیح میدهید؟
۱. هر درخواست 3 بار Retry شود
۲. بعد از عبور Failure Rate از Threshold، Circuit باز شود و درخواستها Fail Fast شوند
۳. Retry + Exponential Backoff + Circuit Breaker
طراحی همین تصمیمهای کوچک است که تفاوت بین یک سرویس معمولی و یک سیستم واقعا Resilient را مشخص میکند.
منابع برای مطالعه بیشتر:
AWS — Using the Circuit Breaker Pattern with Step Functions and DynamoDB
AWS Builders’ Library — Making retries safe with idempotent APIs
Top Strategies to Improve Reliability in Distributed Systems
Understanding Retries, Exponential Backoffs, and Circuit Breakers in Distributed Systems
What Are False Positives and Negatives in Software Testing ?
Distributed Systems and Microservices: Guide to Streamline Software Architectures
Health Checks and Graceful Degradation in Distributed Systems

